專為新一代 AI 技術打造
Tensor Processing Unit (TPU) 是與開放軟體共同設計的自訂加速器,可支援整個 AI 生命週期,包括前沿訓練、大規模推論,以及代理式 AI 的多步驟推論資料需求。
採用 AI Hypercomputer
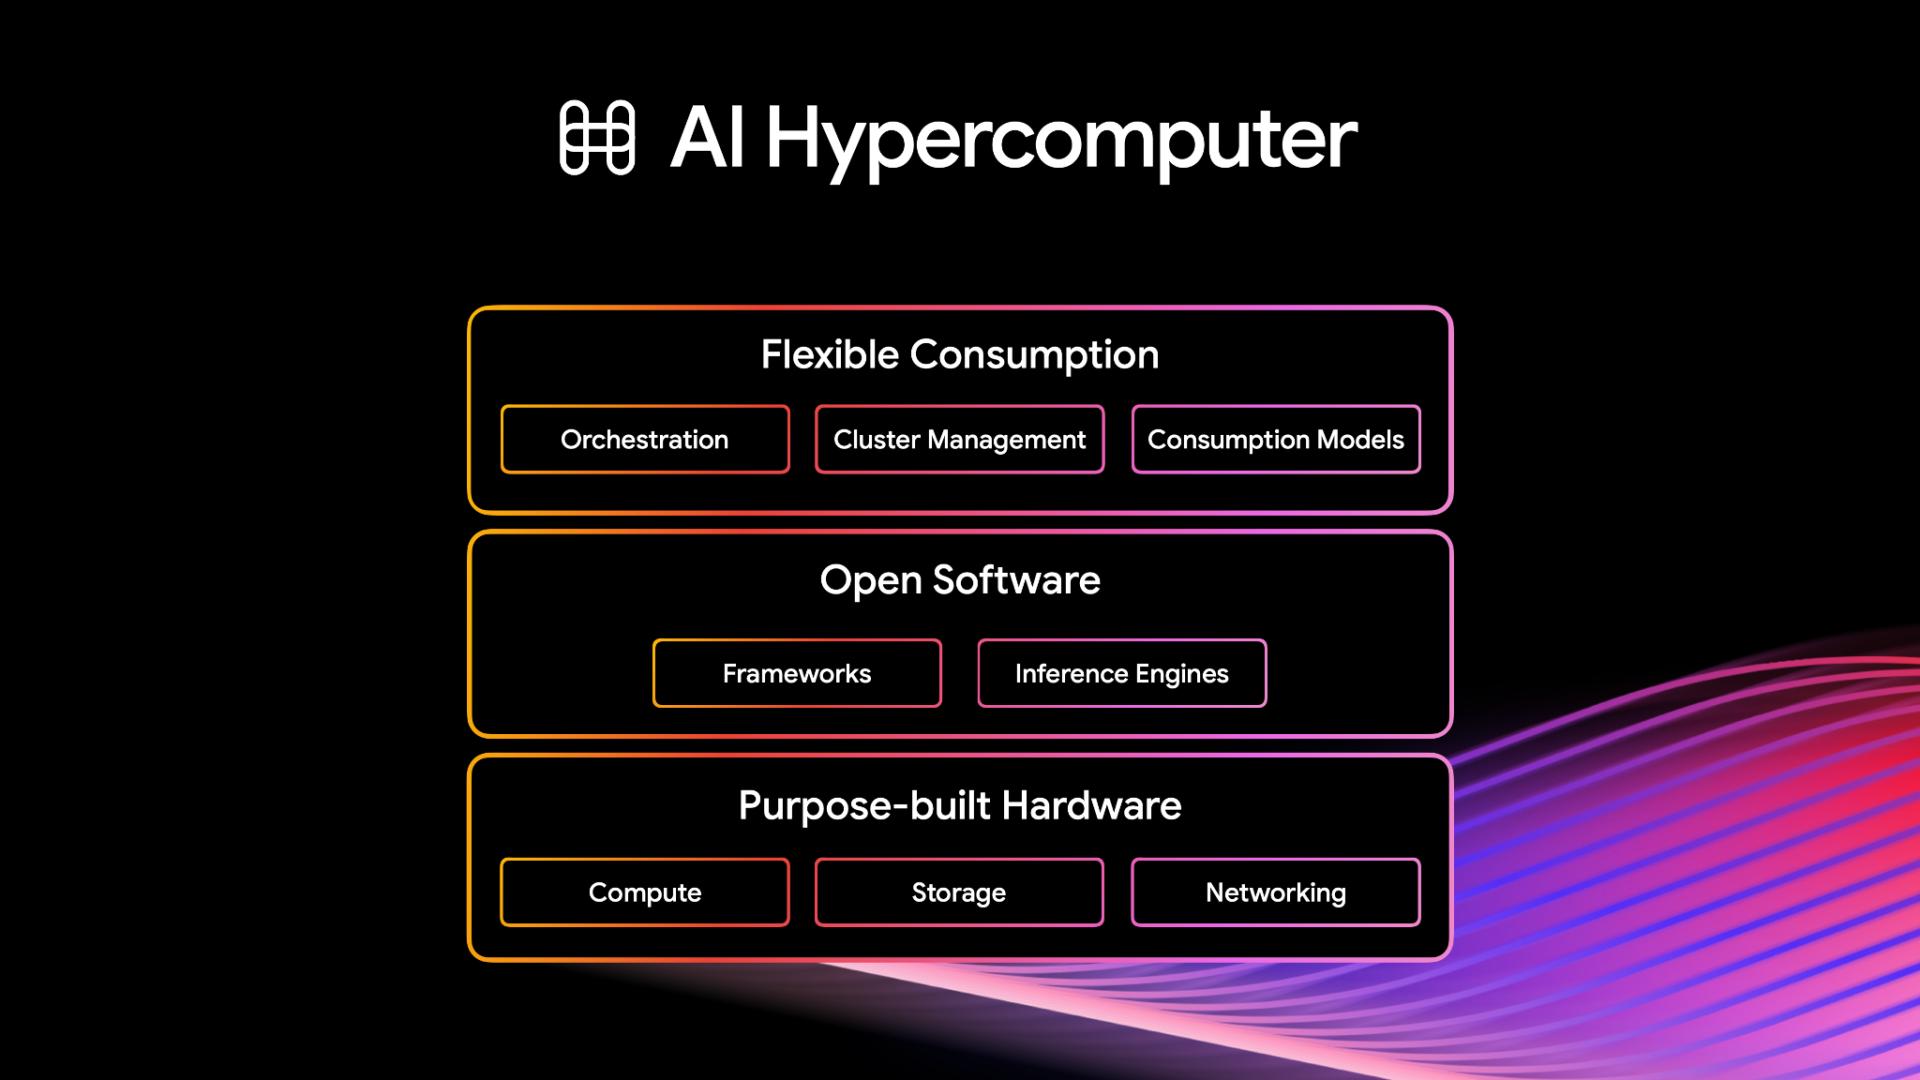
TPU 由 Google Cloud 的 AI Hypercomputer 提供支援,這項突破性架構結合專用硬體、開放式軟體和彈性計費模式。
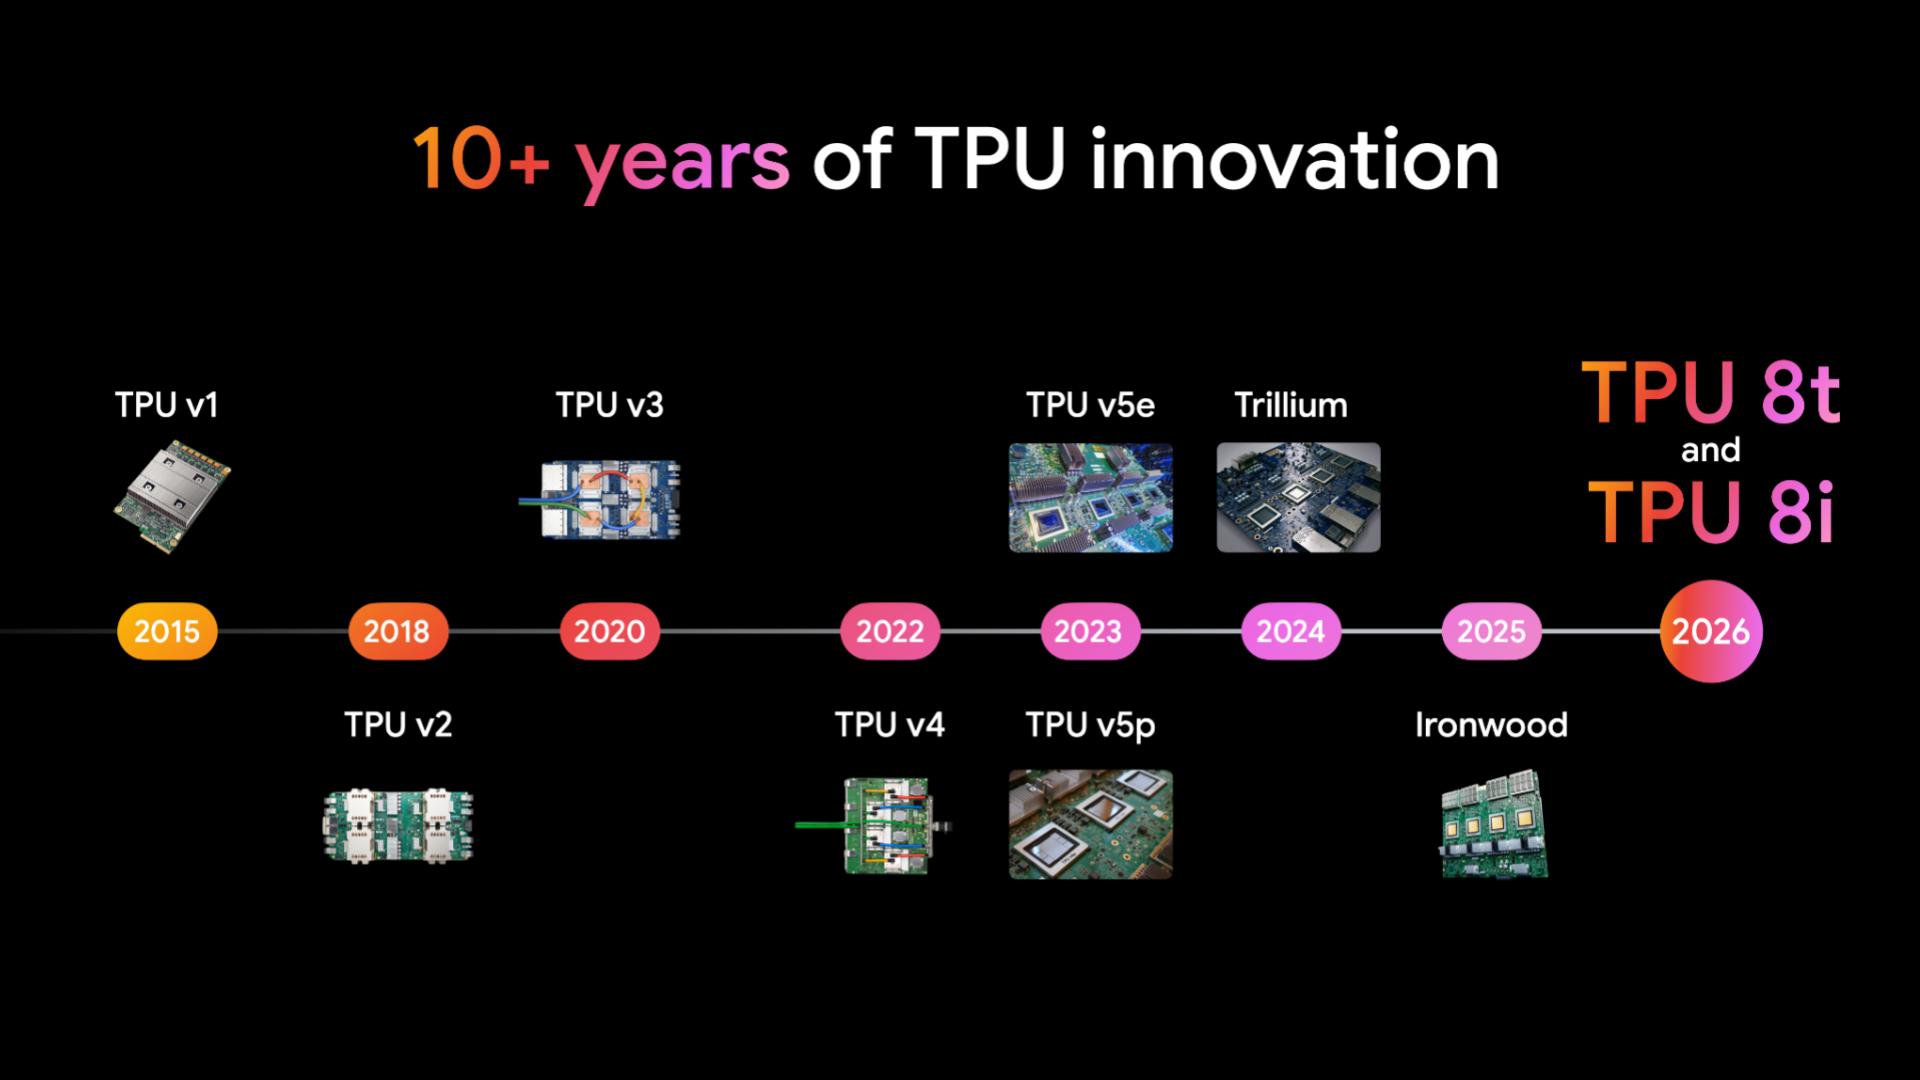
Tensor Processing Unit (TPU) 十年成就
TPU 專為進階 AI 工作負載打造,從大型語言模型、程式碼生成到智慧代理,統統都能輕鬆應對。TPU 是 Gemini 和 Google 旗艦產品 (包括搜尋、相簿和地圖) 的核心引擎,這些產品擁有數十億使用者。
優點
開放、彈性且可靠的作業
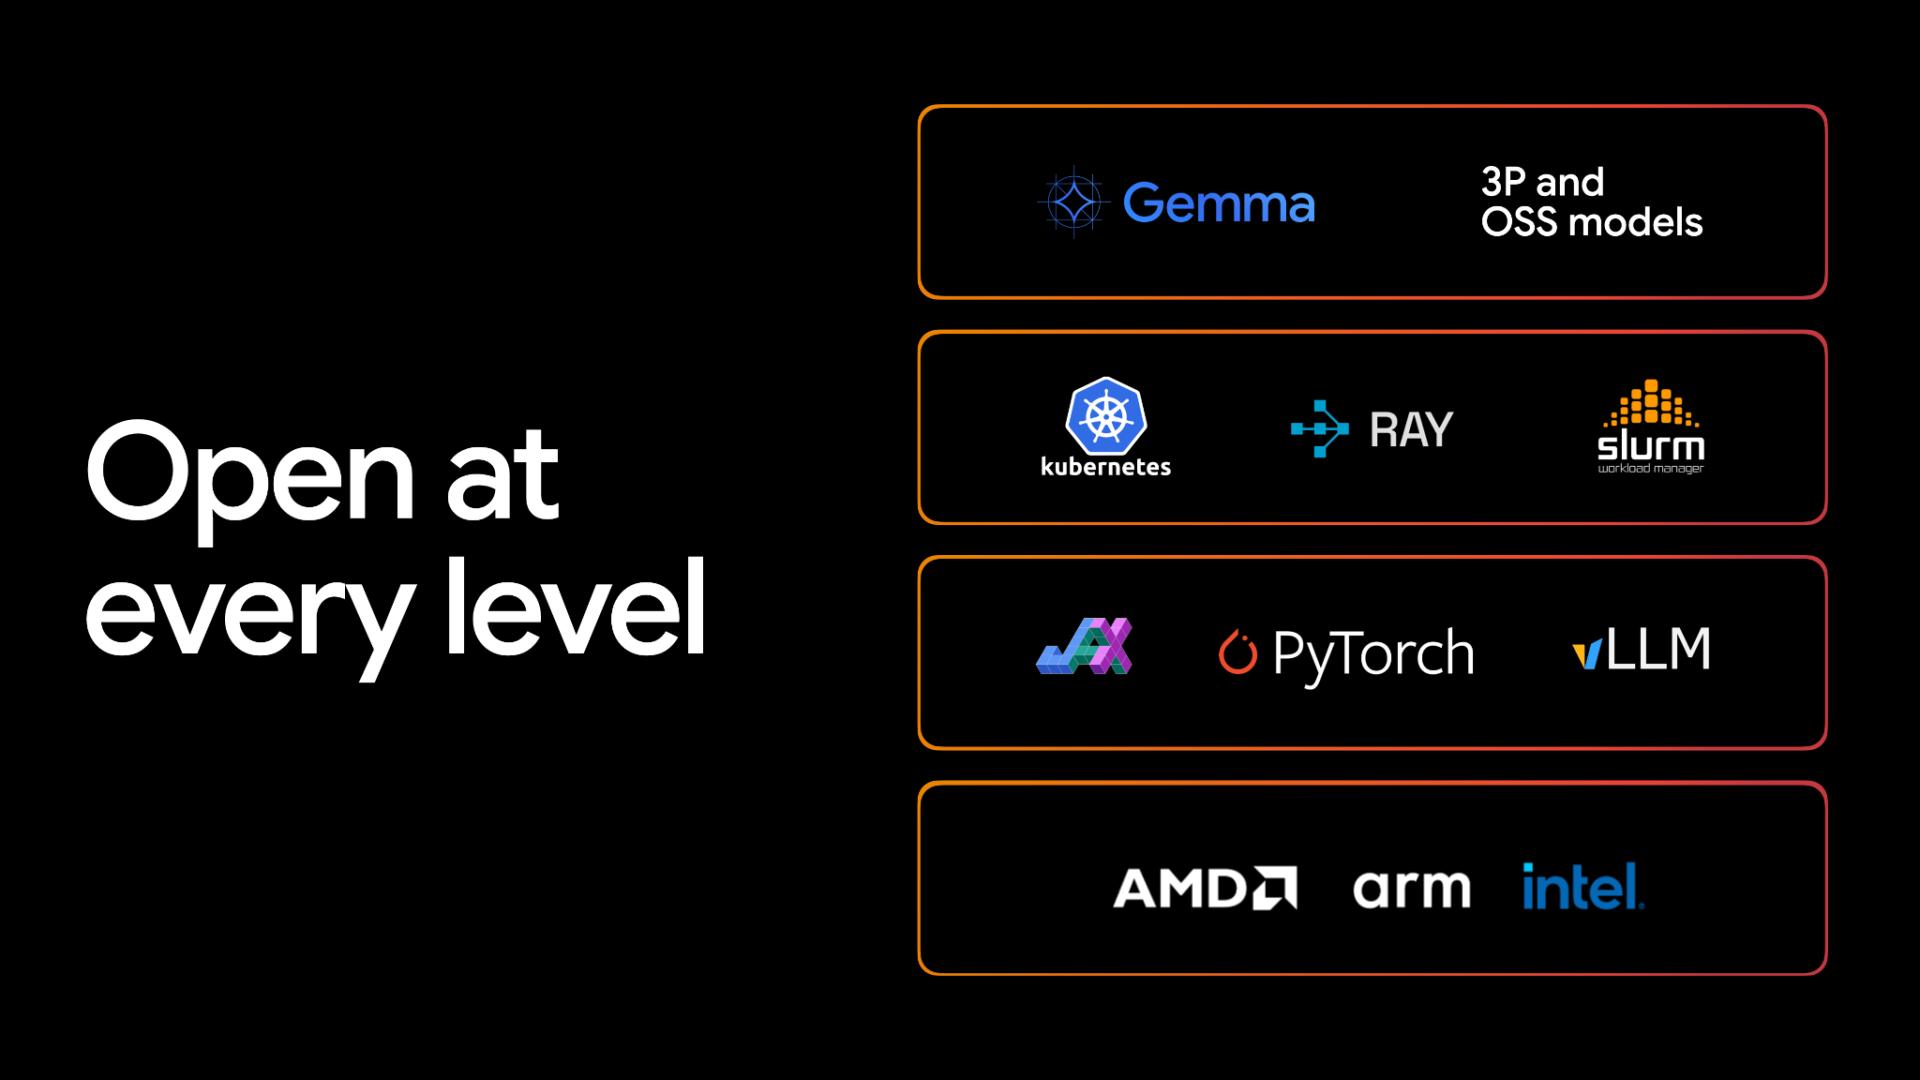
使用熟悉的程式庫和工具,在開放生態系統中進行建構。TPU 原生支援 PyTorch 和 JAX,效能優異,並支援 vLLM 引擎,可快速推論。透過 Google Kubernetes Engine (GKE),在全域叢集中可靠地管理及擴充這些部署作業。
效能不打折
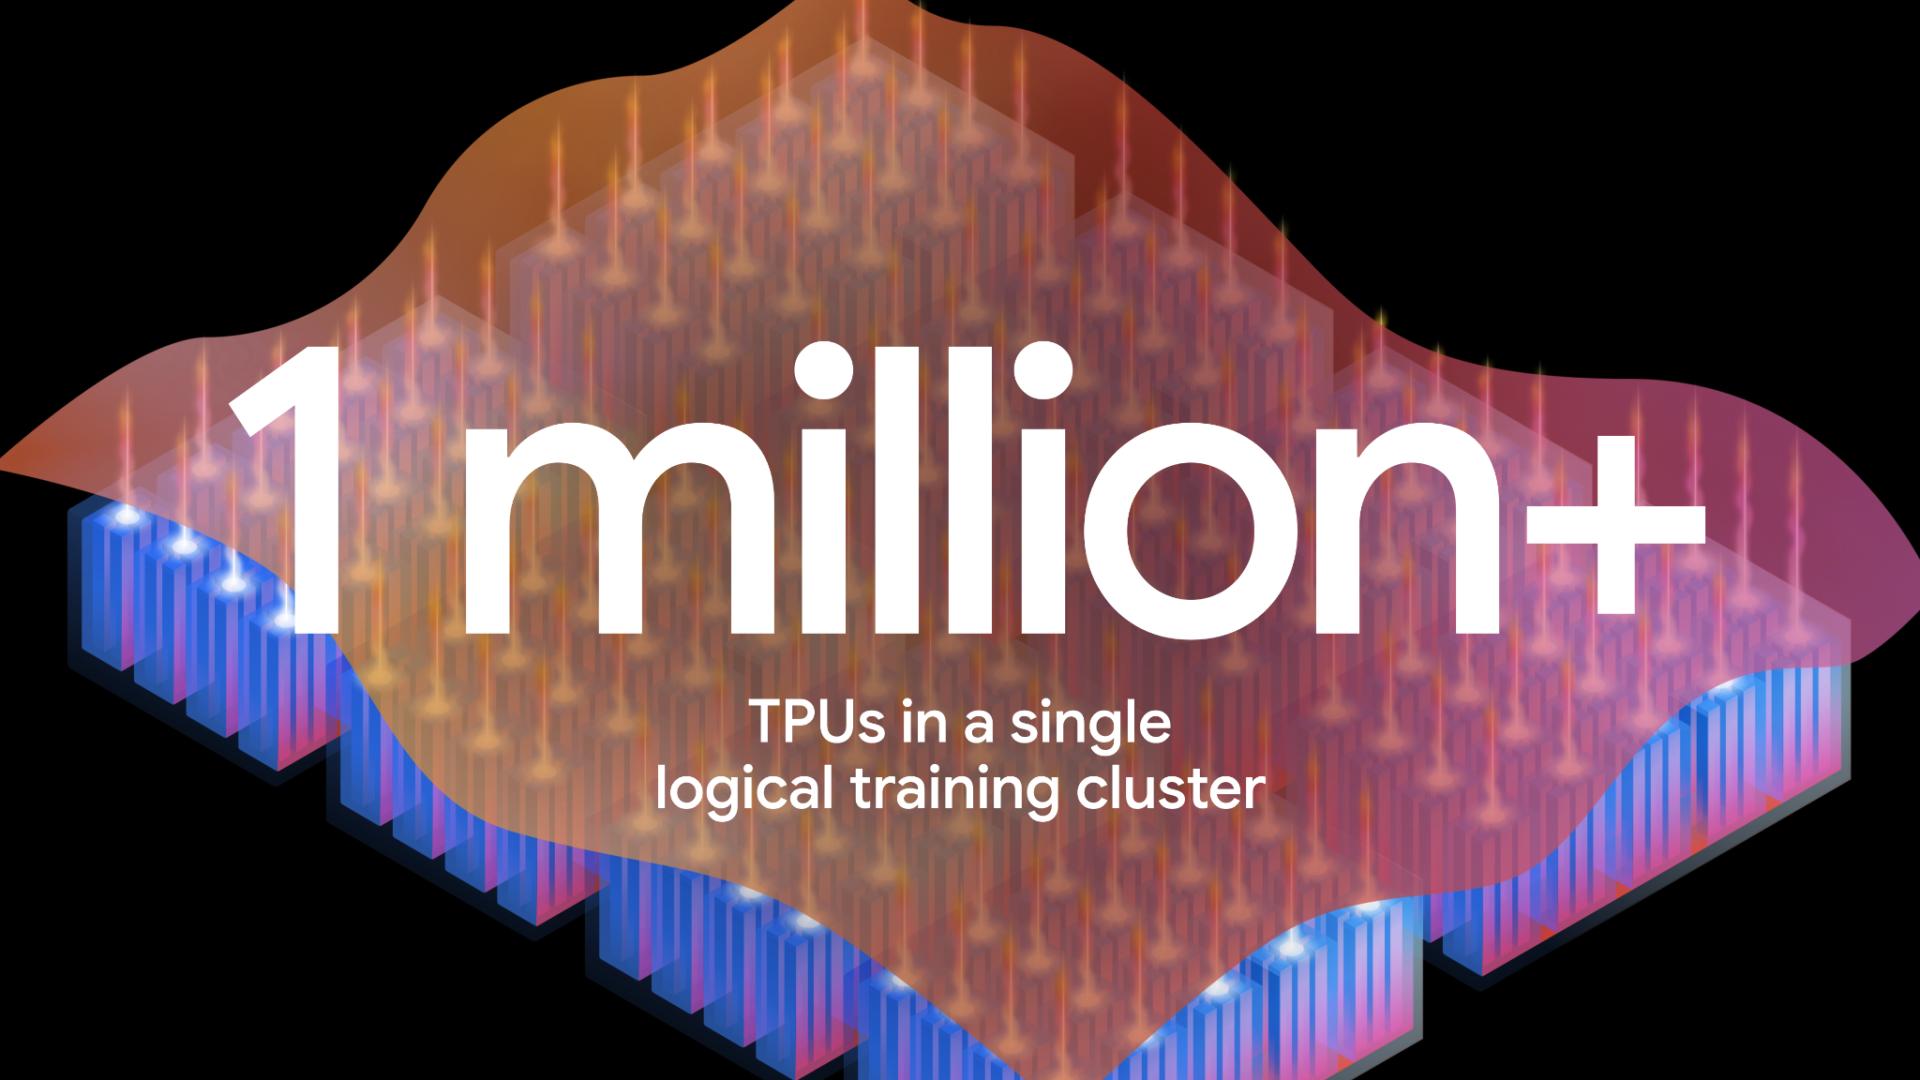
將前沿模型的訓練時間從數月縮短至數週。單一叢集最多可容納 100 萬個 TPU 晶片,能盡量提高有效處理量,確保幾乎每個運算週期都用於主動學習。
優點
開放、彈性且可靠的作業
使用熟悉的程式庫和工具,在開放生態系統中進行建構。TPU 原生支援 PyTorch 和 JAX,效能優異,並支援 vLLM 引擎,可快速推論。透過 Google Kubernetes Engine (GKE),在全域叢集中可靠地管理及擴充這些部署作業。
效能不打折
將前沿模型的訓練時間從數月縮短至數週。單一叢集最多可容納 100 萬個 TPU 晶片,能盡量提高有效處理量,確保幾乎每個運算週期都用於主動學習。
TPU 8t
TPU 8t 專為大規模預先訓練和嵌入密集型工作負載而打造,單一 Superpod 可容納 9,600 個晶片,每個 Pod 的運算效能幾乎是前一代的 3 倍,可提供前沿模型需要的高密度運算。
即將推出。
TPU 8i
TPU 8i 經過最佳化調整,適合用於後訓練和推論作業。與前幾代產品相比,這款晶片在大型 MoE 模型的低延遲推論方面,每單位費用的推論效能提升 80%。
即將推出。
Ironwood - 第 7 代
TPU 8t
TPU 8t 專為大規模預先訓練和嵌入密集型工作負載而打造,單一 Superpod 可容納 9,600 個晶片,每個 Pod 的運算效能幾乎是前一代的 3 倍,可提供前沿模型需要的高密度運算。
即將推出。
TPU 8i
TPU 8i 經過最佳化調整,適合用於後訓練和推論作業。與前幾代產品相比,這款晶片在大型 MoE 模型的低延遲推論方面,每單位費用的推論效能提升 80%。
即將推出。
Ironwood - 第 7 代
TPU 軟體堆疊
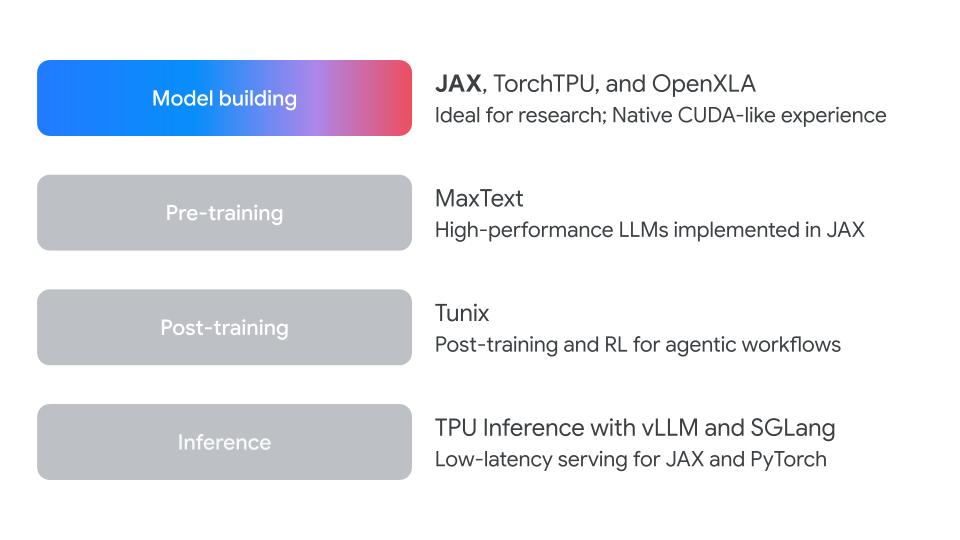
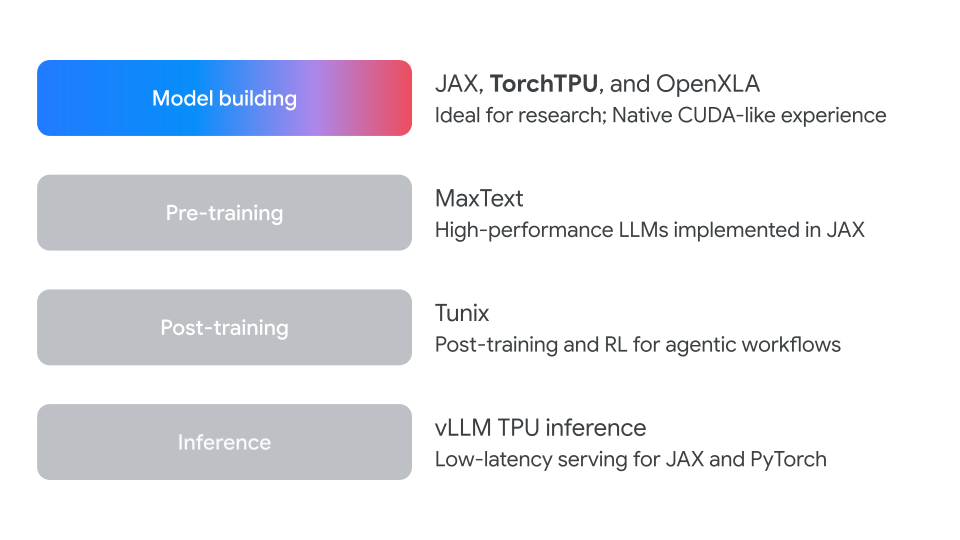
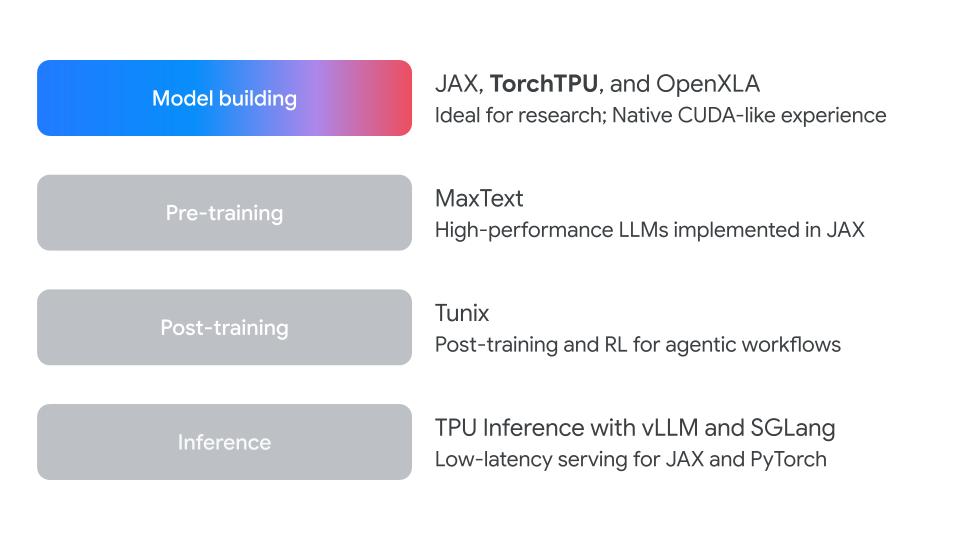
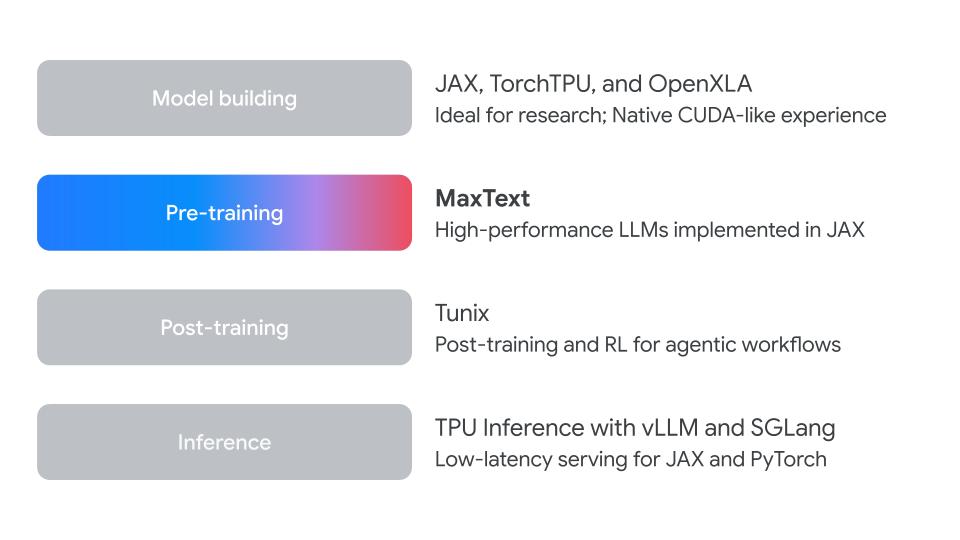
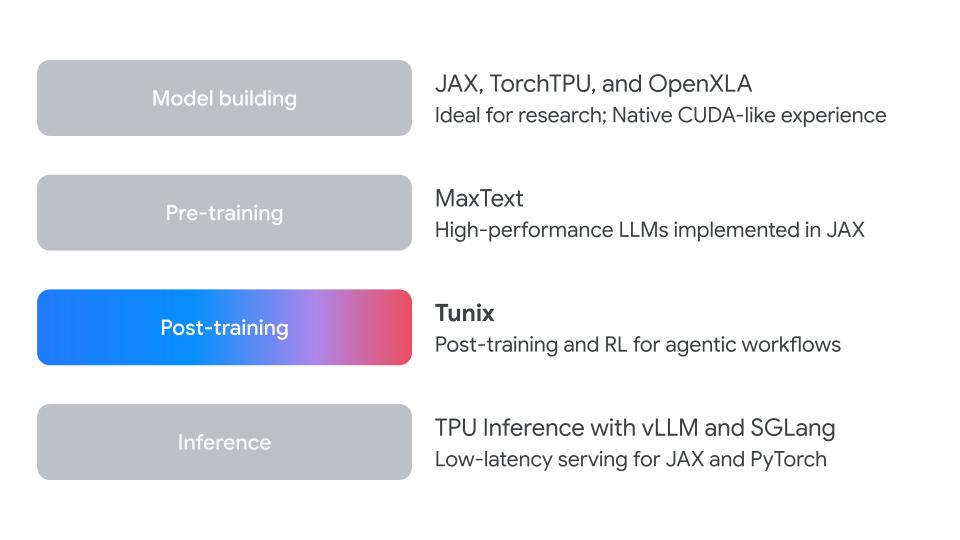
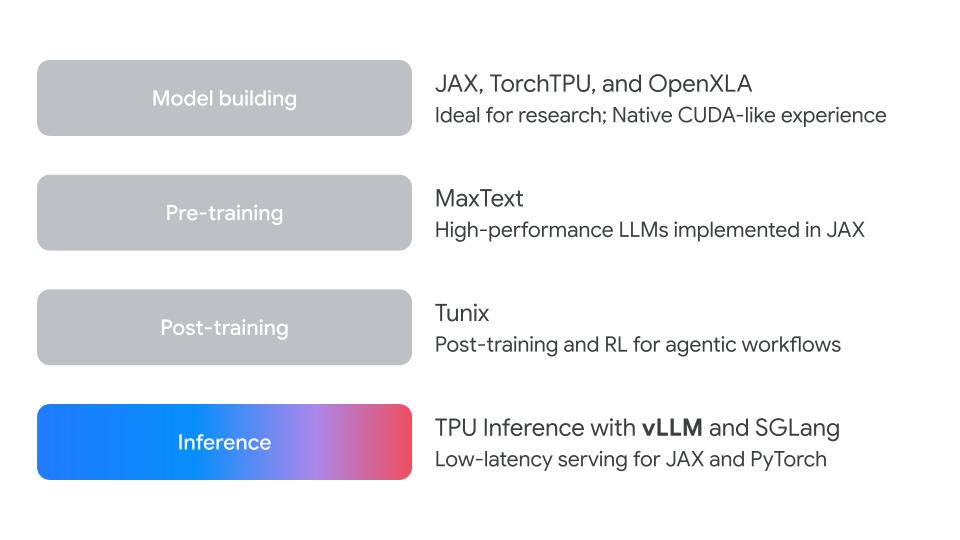
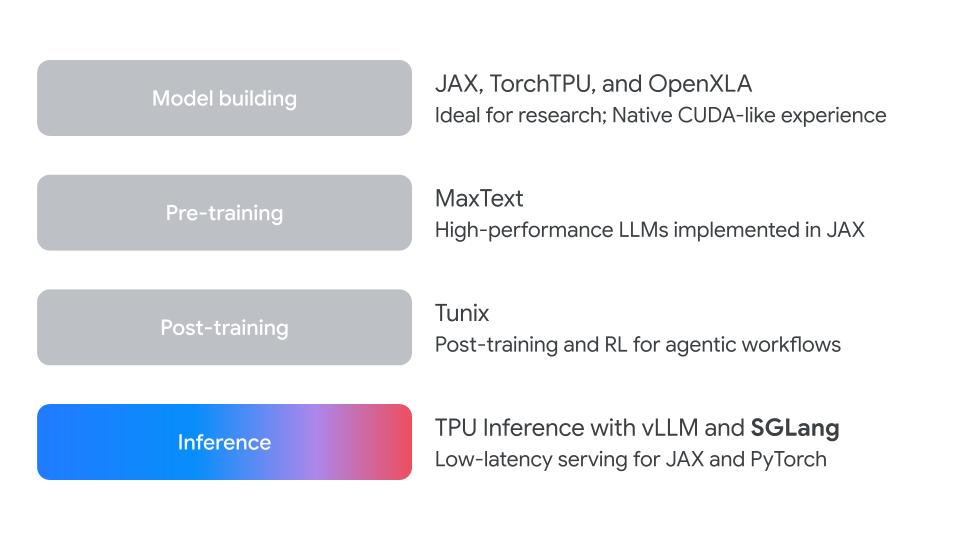
TPU 軟體堆疊經過精心設計,可彌補高階機器學習程式碼與自訂晶片之間的差距,充分發揮原始硬體效率。
JAX
在 TPU 上以接近原生硬體的速度編譯複雜的數學運算。這個開放原始碼程式庫適用於數值運算和自動微分,可透過明確的裝置網格,輕鬆擴充至大規模分散式 TPU 叢集。
TorchTPU 和 PyTorch
使用標準語法,直接在 TPU 上執行 PyTorch 工作負載。TorchTPU 是開放原始碼的 PyTorch 後端,專為 TPU 設計。您可以使用現有的程式碼和工具,在 Cloud TPU 上訓練、微調及提供模型,不必變更 PyTorch 語意或學習 TPU 專屬 API。
OpenXLA
減少編譯瓶頸,充分發揮 TPU 硬體的高度效能。這款開放原始碼機器學習編譯器會自動融合運算並最佳化記憶體用量,消除 TPU 後端線性代數運算的框架負擔。
MaxText
大幅縮短大規模基礎模型的訓練時程。這個以 JAX 為基礎的參考實作項目提供可高度擴充的現成藍圖,能在 TPU 上預先訓練 LLM 時,達到硬體使用率高峰。
Tunix
在 TPU 基礎架構上簡化 LLM 後訓練和對齊作業。這個輕量級開放原始碼 JAX 程式庫提供可擴充的監督式微調 (SFT) 和強化學習 (RL) 工作流程,能有效將原始模型轉變為可用於正式環境的代理程式。
vLLM
盡可能提高供應並行,降低即時 TPU 推論的營運成本。這個高處理量開放原始碼引擎採用 PagedAttention 之類的記憶體管理技術,能夠消除浪費,在 TPU 架構上提供高效 LLM 服務。支援在 Cloud TPU 執行 JAX 和 PyTorch 模型的推論作業。
SGLang
大型語言模型的快速供應架構,具備 Cloud TPU 最佳化後端執行功能。
TPU 為創新者提供強大助力
其他資源
- 執行大規模 AI 預先訓練工作負載縮短大規模基礎模型的預先訓練時程。TPU 8t 可在單一 Pod 中提供高效能運算能力,並使用 Virgo Network 擴充。這項架構結合快速儲存空間存取功能和 Axion 支援的 NUMA 隔離技術,可提高有效處理量,確保運算週期用於建構有效模型,而不是在資料移轉或硬體重設期間閒置。Ironwood TPU 訓練開發人員指南
- 有效率的後訓練和強化學習透過密集的後續訓練工作流程,將基礎模型建構為智慧型代理程式。第 8 代 TPU 系統能快速處理持續強化學習試驗,獎勵最佳推論路徑,不會像前幾代產品一樣出現週期延遲。這項技術可讓您有效微調世界模型,讓代理程式在模擬環境中修正推論方式,再於現實世界中執行。MaxText 後續訓練
- 大規模執行低延遲 AI 推論工作負載打破推論的記憶體牆瓶頸。TPU 8i 擴充了晶片內建 SRAM 和高頻寬記憶體,可將高容量的 KV 快取完全儲存在晶片上。這項架構使用 SparseCore-Collectives Acceleration Engine (SC-CAE) 卸載全域通訊工作,大幅降低晶片延遲,讓主要運算核心專注於生成純正低延遲的符記。運用 Google Cloud 加快 AI 推論速度
- Virgo Network:Google 的水平擴展 AI 資料中心網狀架構Virgo Network 是可水平擴展的網狀架構,專為滿足現代 AI 工作負載的極端需求而設計。這項技術採用高基數交換器,可增加每個交換器的通訊埠數量,進而減少網路層,並採用扁平的雙層無阻塞拓撲。閱讀公告文章
- 在 TPU 上執行兆級參數模型時,可享有叢集層級的可靠性十多年來,Google 一直大規模營運 Tensor Processing Unit (TPU) 叢集,其可靠性符合現代 AI 工作負載的架構需求。在這篇網誌中,我們將介紹 Google Cloud TPU 的叢集層級可靠性框架,這個框架著重於 superpod 層級的整體效能,也是 Google 內部用來建構全球最先進 AI 模型的框架。閱讀文章
- 運用 TPU 設計永續 AI深入探索 TPU 效率和生命週期排放量。我們在硬體碳效率方面取得重大進展,同時也快速提升 AI 模型和演算法設計。閱讀文章
技術應用實例
- 執行大規模 AI 預先訓練工作負載縮短大規模基礎模型的預先訓練時程。TPU 8t 可在單一 Pod 中提供高效能運算能力,並使用 Virgo Network 擴充。這項架構結合快速儲存空間存取功能和 Axion 支援的 NUMA 隔離技術,可提高有效處理量,確保運算週期用於建構有效模型,而不是在資料移轉或硬體重設期間閒置。Ironwood TPU 訓練開發人員指南
- 有效率的後訓練和強化學習透過密集的後續訓練工作流程,將基礎模型建構為智慧型代理程式。第 8 代 TPU 系統能快速處理持續強化學習試驗,獎勵最佳推論路徑,不會像前幾代產品一樣出現週期延遲。這項技術可讓您有效微調世界模型,讓代理程式在模擬環境中修正推論方式,再於現實世界中執行。MaxText 後續訓練
- 大規模執行低延遲 AI 推論工作負載打破推論的記憶體牆瓶頸。TPU 8i 擴充了晶片內建 SRAM 和高頻寬記憶體,可將高容量的 KV 快取完全儲存在晶片上。這項架構使用 SparseCore-Collectives Acceleration Engine (SC-CAE) 卸載全域通訊工作,大幅降低晶片延遲,讓主要運算核心專注於生成純正低延遲的符記。運用 Google Cloud 加快 AI 推論速度
文章
- Virgo Network:Google 的水平擴展 AI 資料中心網狀架構Virgo Network 是可水平擴展的網狀架構,專為滿足現代 AI 工作負載的極端需求而設計。這項技術採用高基數交換器,可增加每個交換器的通訊埠數量,進而減少網路層,並採用扁平的雙層無阻塞拓撲。閱讀公告文章
- 在 TPU 上執行兆級參數模型時,可享有叢集層級的可靠性十多年來,Google 一直大規模營運 Tensor Processing Unit (TPU) 叢集,其可靠性符合現代 AI 工作負載的架構需求。在這篇網誌中,我們將介紹 Google Cloud TPU 的叢集層級可靠性框架,這個框架著重於 superpod 層級的整體效能,也是 Google 內部用來建構全球最先進 AI 模型的框架。閱讀文章
- 運用 TPU 設計永續 AI深入探索 TPU 效率和生命週期排放量。我們在硬體碳效率方面取得重大進展,同時也快速提升 AI 模型和演算法設計。閱讀文章

常見問題
什麼是 Tensor Processing Unit (TPU)?
TPU 是 Google 開發的客製化特殊應用積體電路 (ASIC),專為加速機器學習和人工智慧工作負載而設計。TPU 經過最佳化調整,能高效處理大量矩陣乘法與張量運算,這些是類神經網路的基本建構模塊,可支援從大型語言模型到複雜推論代理的各類應用。
TPU 架構如何運作?
TPU 的核心是專門的矩陣乘法單元 (MXU),可同時處理大量矩陣運算。TPU 採用「收縮陣列」架構,資料讀取一次後即可持續流經數千個算術邏輯單元 (ALU),累積運算結果,無需反覆讀寫記憶體。此外,TPU 也支援降低精確度的算術運算 (例如 16 位元或 8 位元浮點數),每秒可執行數百萬次運算,同時維持 AI 模型所需的準確率。
Cloud TPU 支援哪些機器學習框架?
Cloud TPU 原生支援頂尖的機器學習框架,主要包括 TensorFlow、PyTorch 和 JAX,並提供高效能。以這些框架編寫的程式碼會由加速線性代數 (XLA) 編譯器編譯,自動將運算圖最佳化,在底層 TPU 硬體上有效率地執行。
哪種類型的工作負載最適合 TPU?
TPU 非常適合需要大量平行矩陣運算的深度學習工作。強烈建議使用這些工具:
- 以矩陣運算為主的模型
- 訓練執行時間長達數週或數月才能收斂
- 大型基礎模型和大型語言模型 (LLM)
- 需要超大型嵌入的工作負載,例如進階推薦引擎
- 持續強化學習和低延遲、高容量的推論
什麼是 TPU Pod 和配量?
TPU Pod 是由 TPU 晶片組成的大型實體叢集,透過專用高速網路 (例如 Google 的光學電路交換或 Virgo 網路) 相互連接。單一超級 Pod 可包含數千個互連晶片,而「配量」則是可租用的 Pod 專屬子集。有了這種網路架構,開發人員幾乎不必修改程式碼,就能在大量運算資源中擴充 AI 工作負載,有效將整個配量視為單一機器運作。
在 TPU 訓練情境中,機器學習的「有效處理量」是指什麼?
Goodput是指基礎架構實際用於主動訓練模型的時間,不包含閒置時間。訓練龐大的基礎模型需要協調數千個晶片,因此資料傳輸延遲、硬體重設或檢查點作業都很容易造成運算週期的浪費。Cloud TPU 經過精心設計,可透過高頻寬互連網路和最佳化記憶體快取,盡可能提高有效處理量,確保付費的運算週期直接用於推動模型進展。
TPU 如何大規模處理自動化調度管理?
使用者可以透過 Google Kubernetes Engine (GKE) 和 Cluster Director,確保可靠性、全面監控及管理。透過 TPU 專用 GKE,客戶能在雲端原生生態系統中運作,使用推論閘道進行負載平衡,並將部署規模擴充至多達 130,000 個 GKE 節點。
目前 TPU 的推論軟體生態是什麼樣貌?
Cloud TPU 主要透過熱門的開放原始碼服務引擎 vLLM 和 SGLang,支援高處理量、低延遲的 LLM 服務:
- vLLM:透過 vllm-tpu 套件與 Cloud TPU 整合,提供 JAX 模型,並透過 vllm-torchtpu 提供 Torch 模型。
- SGLang:使用專屬的 JAX 後端 (sglang-jax) 和獨立的 Torch 後端 (sglang-torch),提供高效能 TPU 服務。
這兩項專案都提供經過最佳化的套件專屬程式庫,專為 TPU 硬體量身打造,可大幅提高服務效率。如需設定指南,請參閱 Cloud TPU 推論說明文件。











