专为下一代 AI 设计
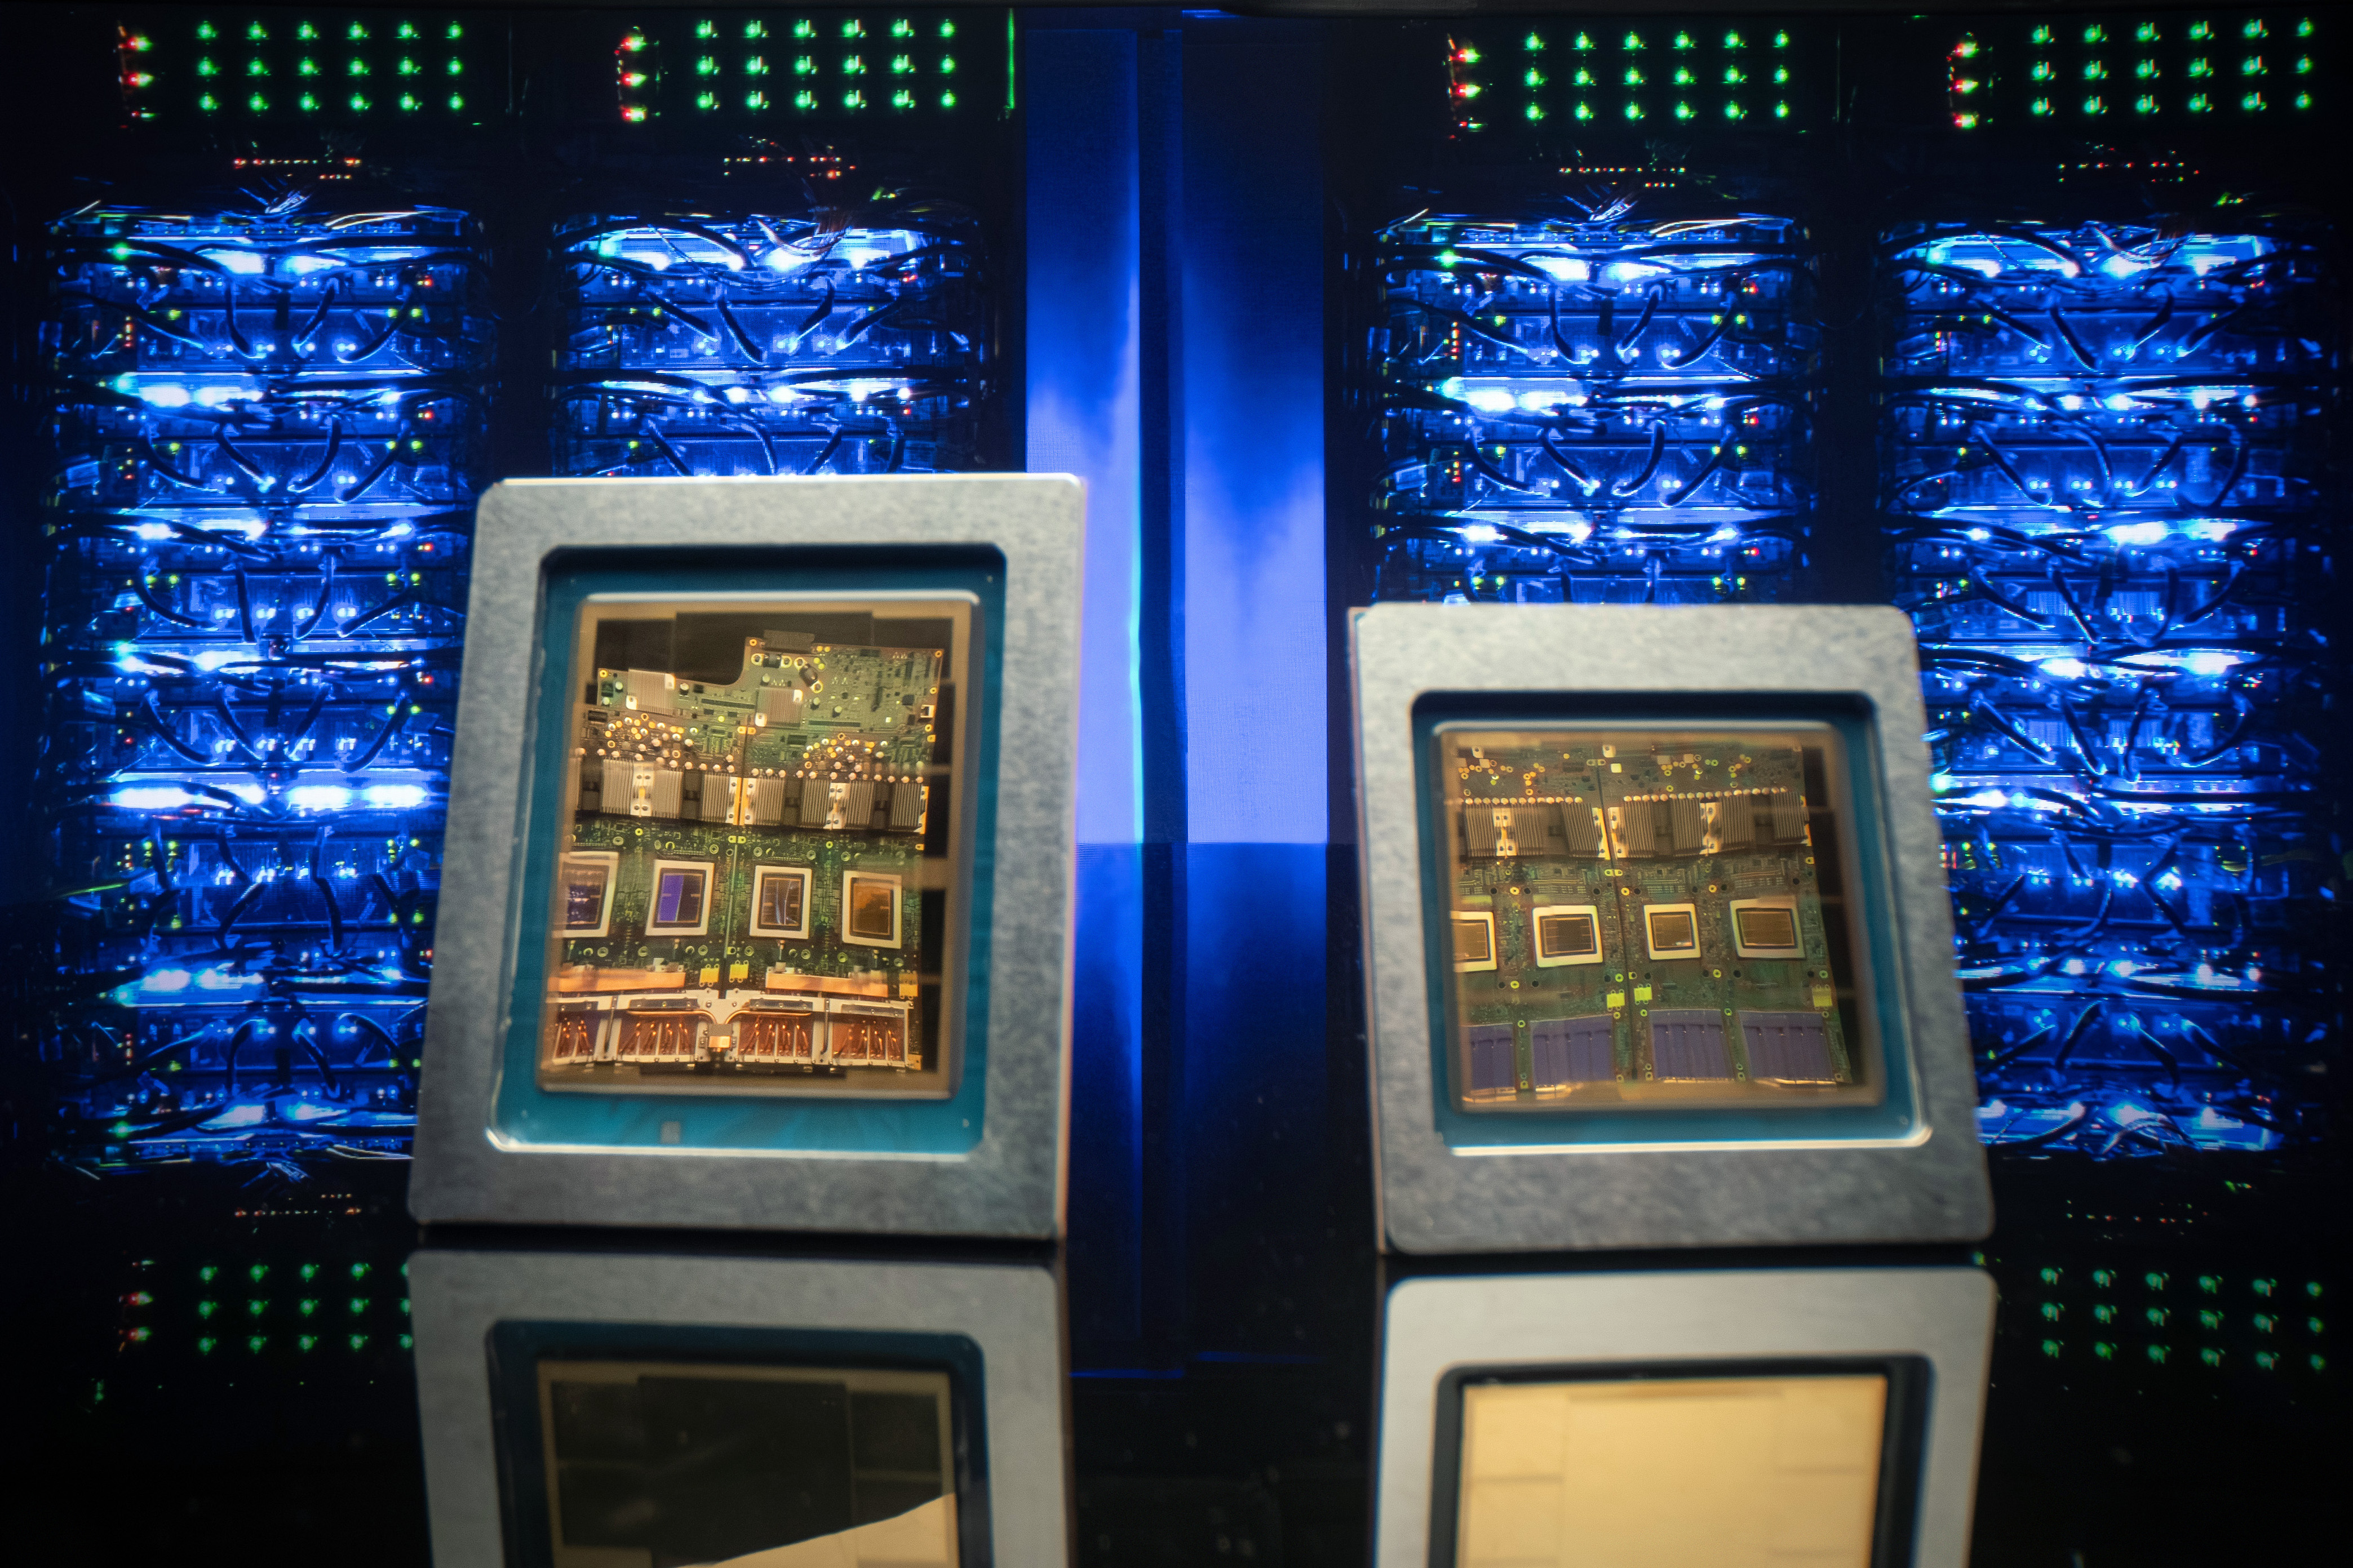
张量处理单元 (TPU) 是与开放软件协同设计的定制加速器,可为整个 AI 生命周期提供支持,涵盖前沿训练、大规模推理,以及智能体 AI 的多步推理数据需求。
由 AI Hypercomputer 提供支持
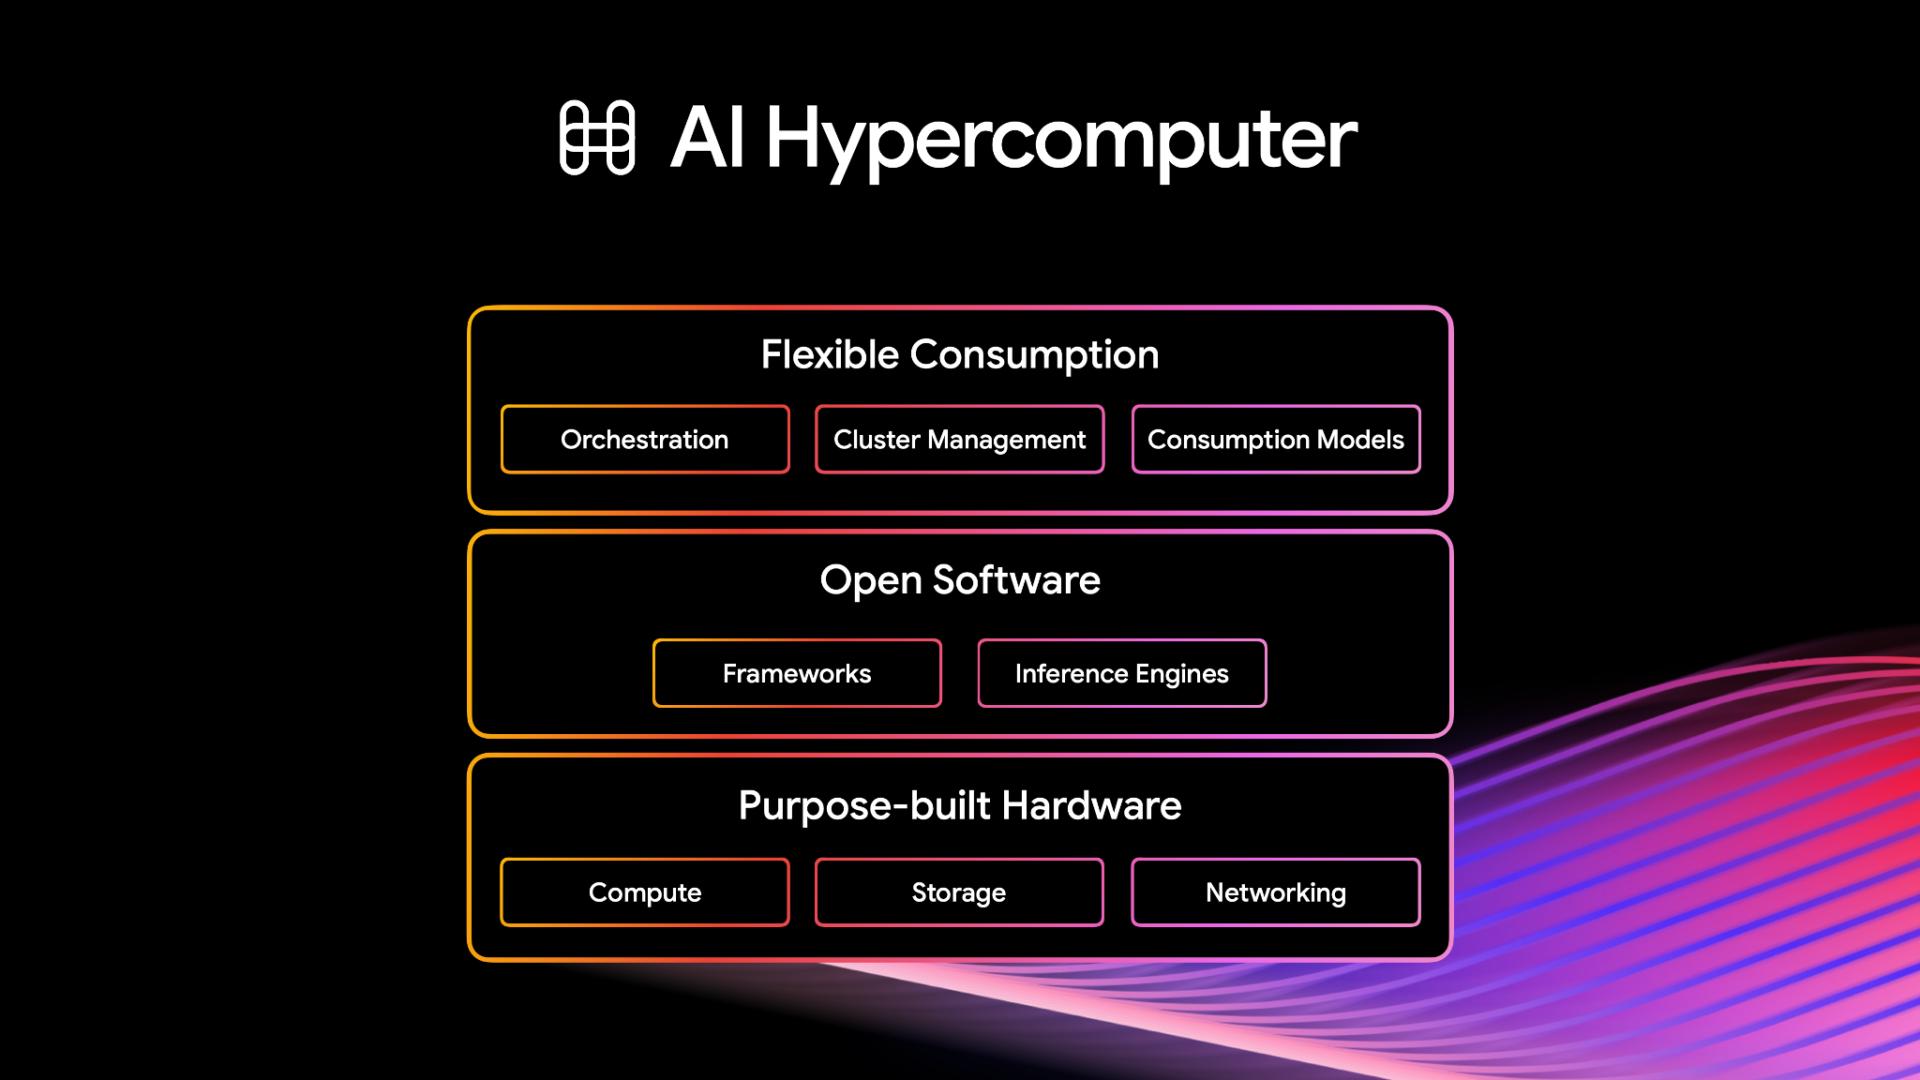
TPU 由 Google Cloud 的 AI Hypercomputer 提供支持,这是一种突破性的架构,它将专用硬件、开源软件和灵活的使用模式融为一体。
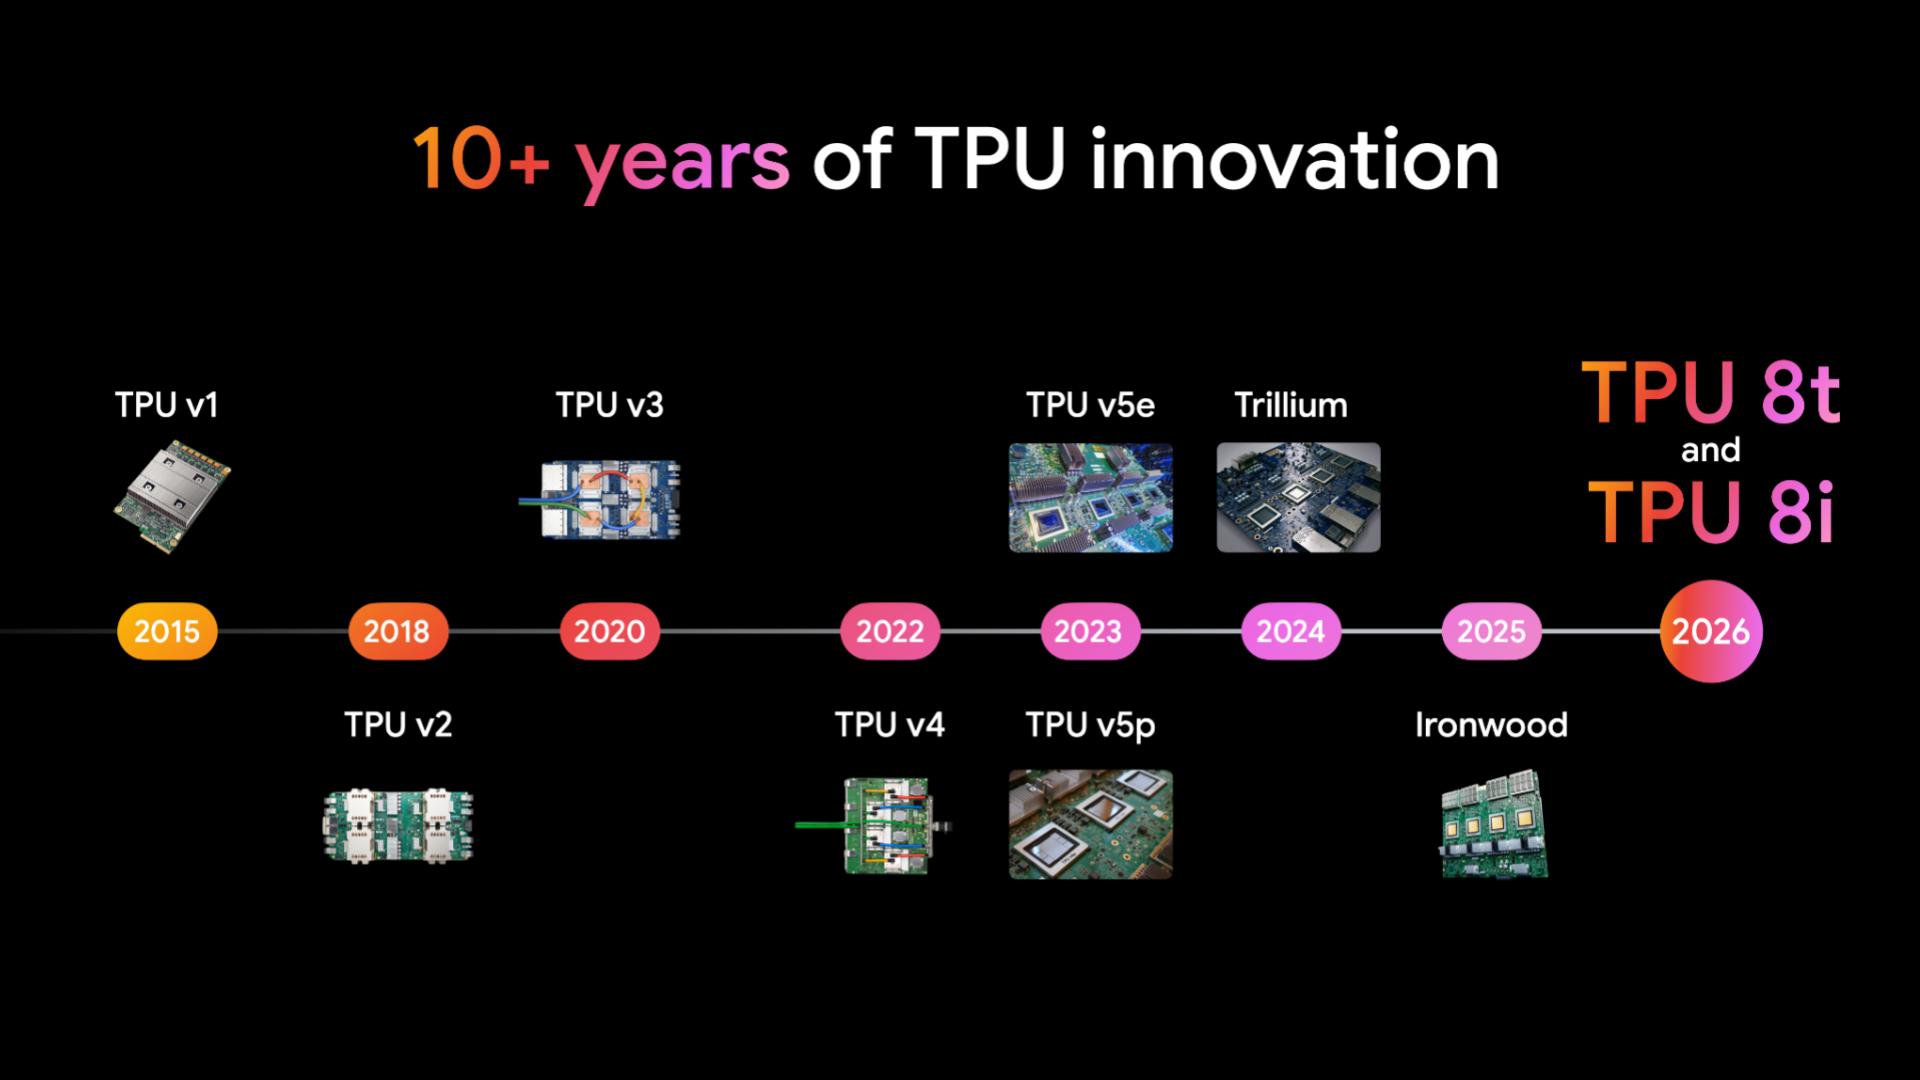
张量处理单元 (TPU) 的十年发展历程
TPU 专为高级 AI 工作负载而构建,涵盖大语言模型、代码生成以及智能体等各类场景。它们是 Gemini 和 Google 旗舰级十亿用户产品的幕后引擎,包括 Google 搜索、Google 相册和 Google 地图。
优势
开放、灵活、可靠的运营
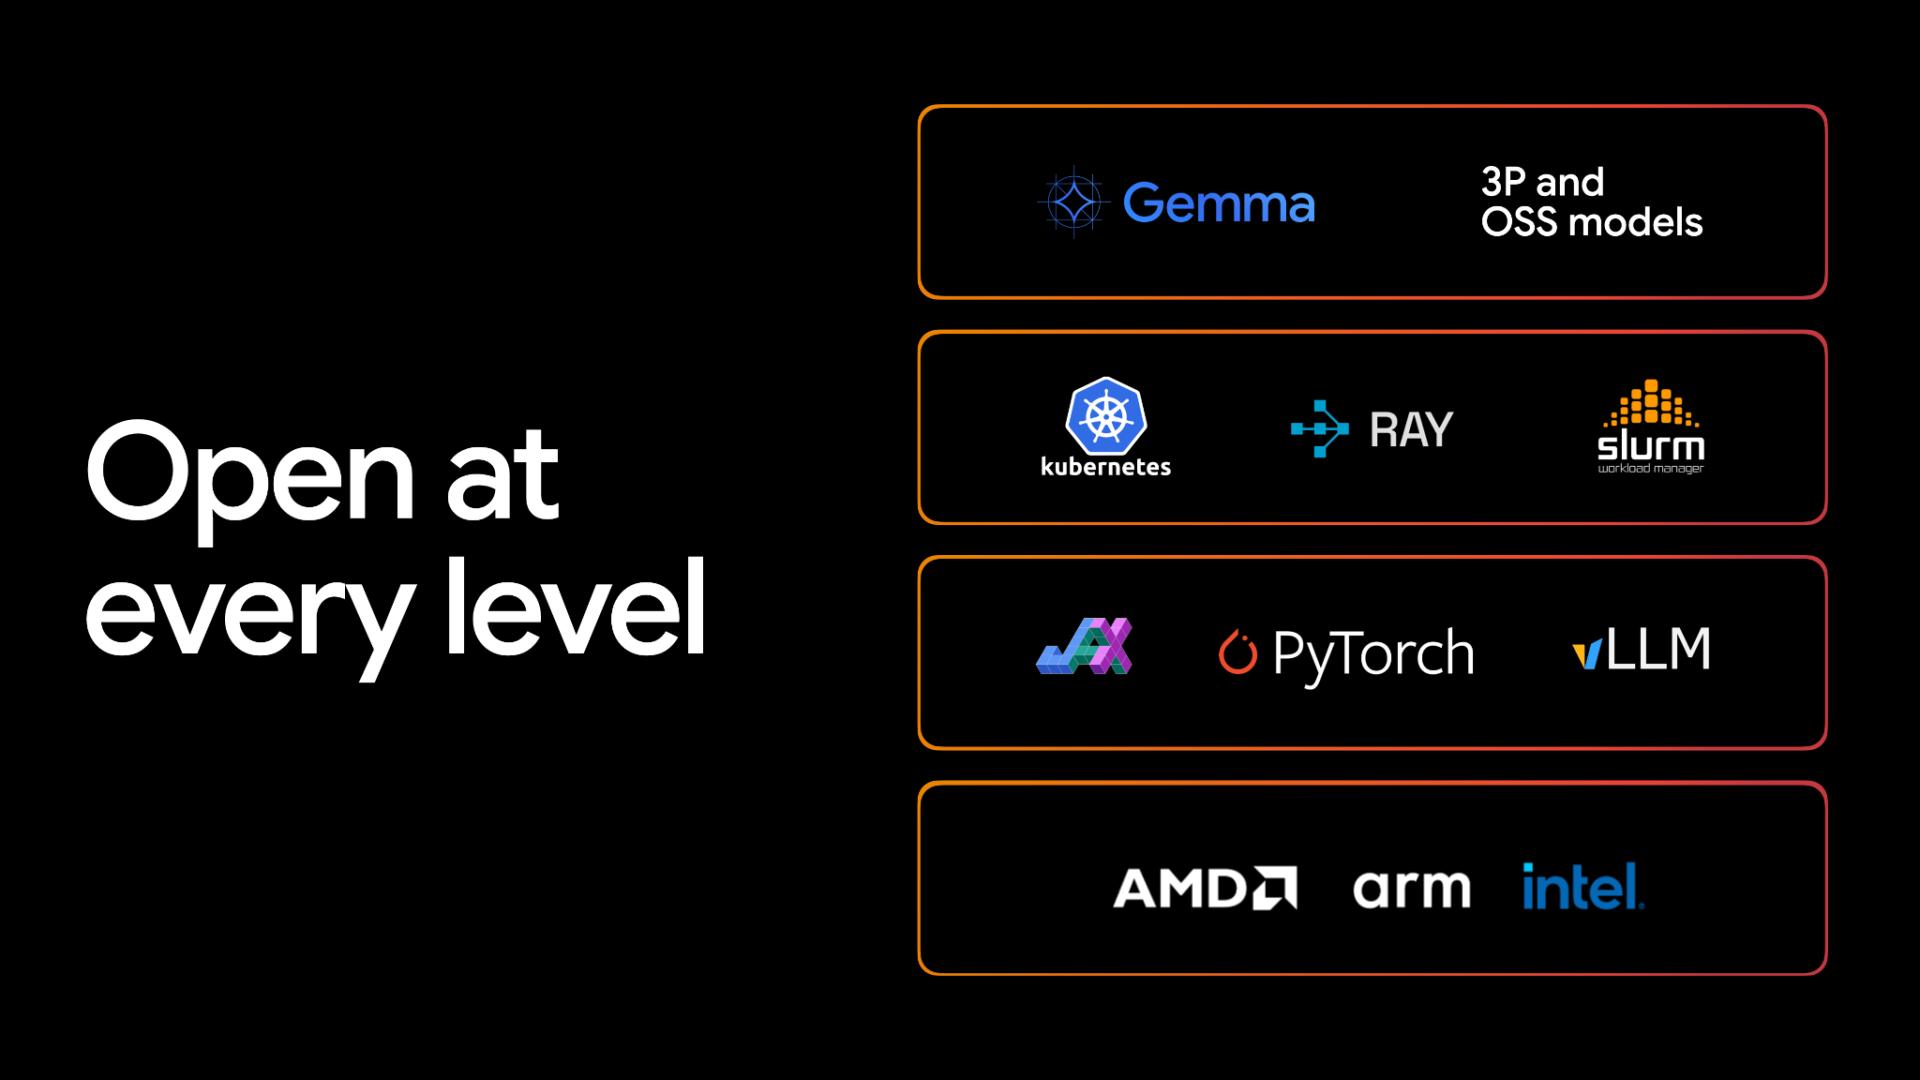
利用熟悉的库和工具,在开放式生态系统中构建应用。TPU 为 PyTorch 和 JAX 提供原生、高性能支持,并支持 vLLM 引擎以实现快速推理。使用 Google Kubernetes Engine (GKE) 可在全球集群中可靠地管理和扩缩这些部署。
性能卓越,自由无阻
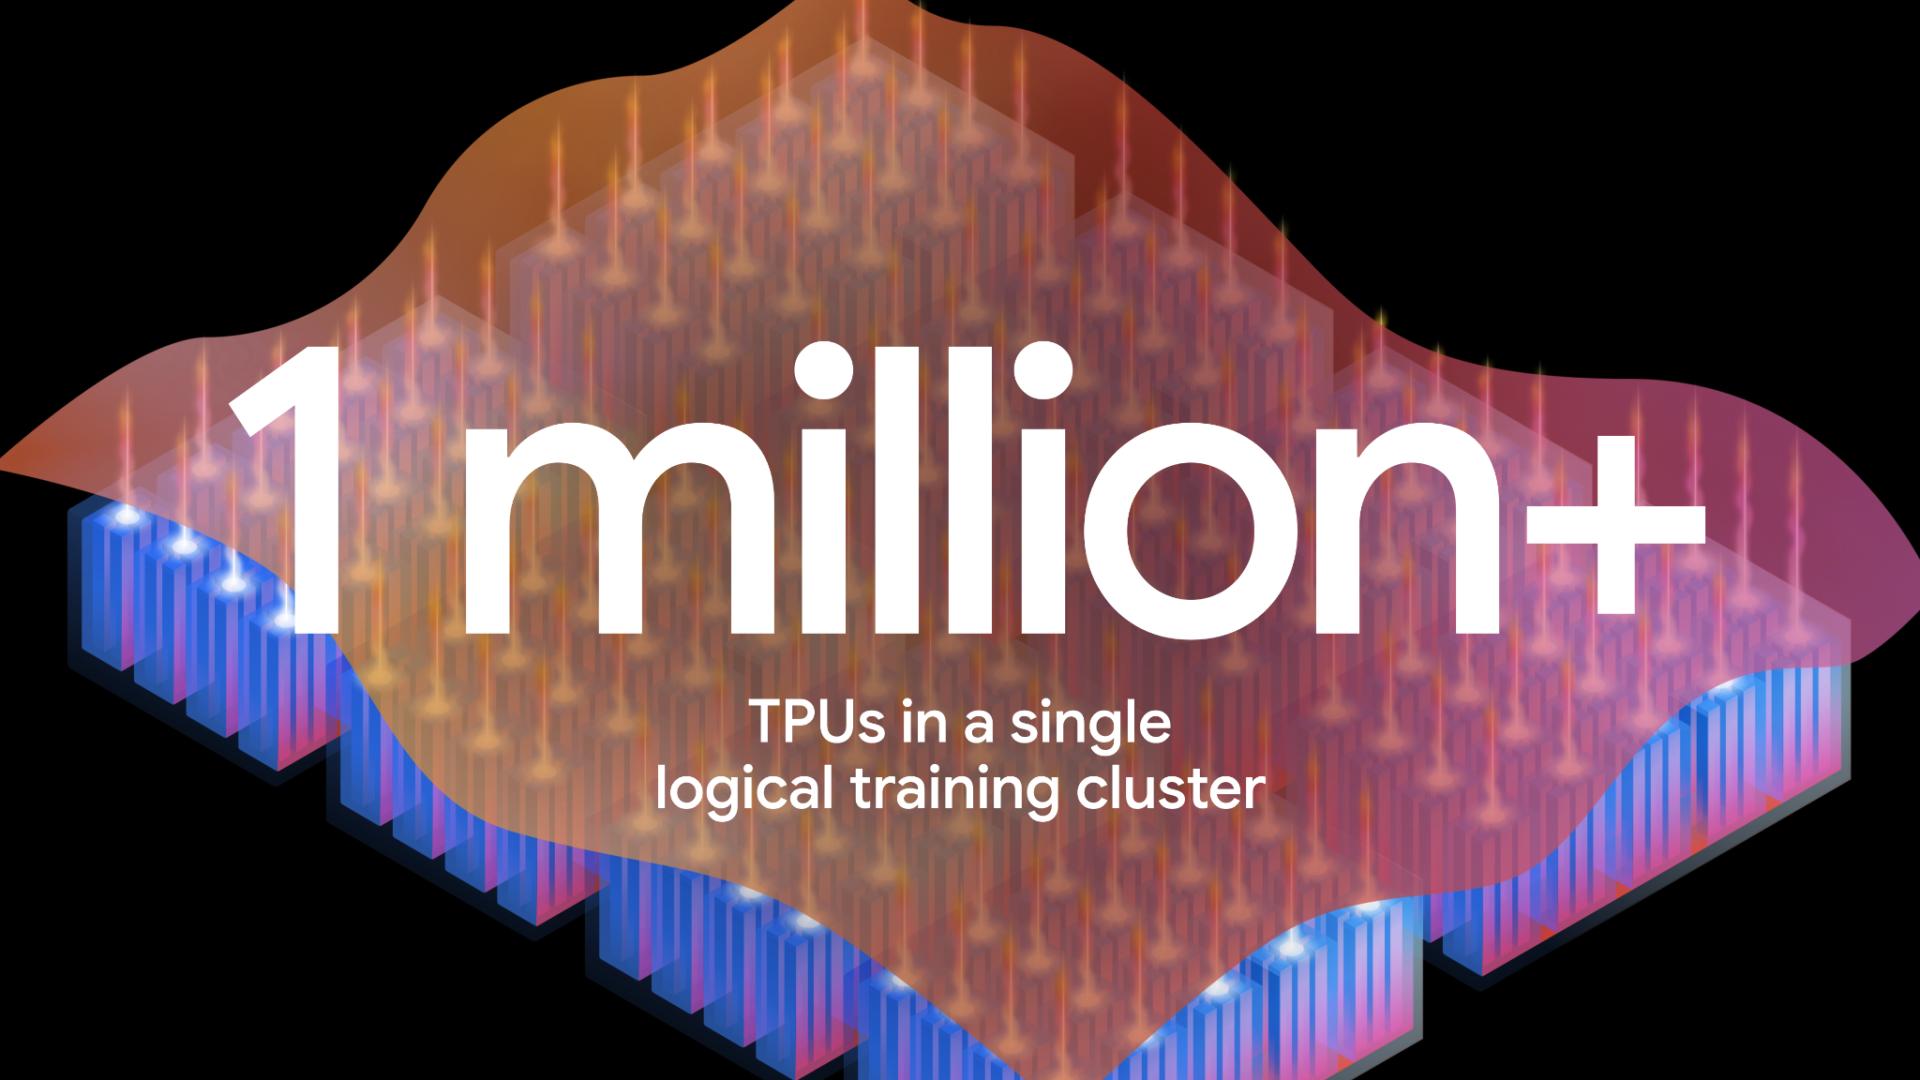
将前沿模型的训练时间从数月缩短至数周。单个集群中最多可容纳 100 万个 TPU 芯片,TPU 可最大限度地提高有效吞吐量,确保几乎每个计算周期都用于主动学习。
优势
开放、灵活、可靠的运营
利用熟悉的库和工具,在开放式生态系统中构建应用。TPU 为 PyTorch 和 JAX 提供原生、高性能支持,并支持 vLLM 引擎以实现快速推理。使用 Google Kubernetes Engine (GKE) 可在全球集群中可靠地管理和扩缩这些部署。
性能卓越,自由无阻
将前沿模型的训练时间从数月缩短至数周。单个集群中最多可容纳 100 万个 TPU 芯片,TPU 可最大限度地提高有效吞吐量,确保几乎每个计算周期都用于主动学习。
TPU 8t
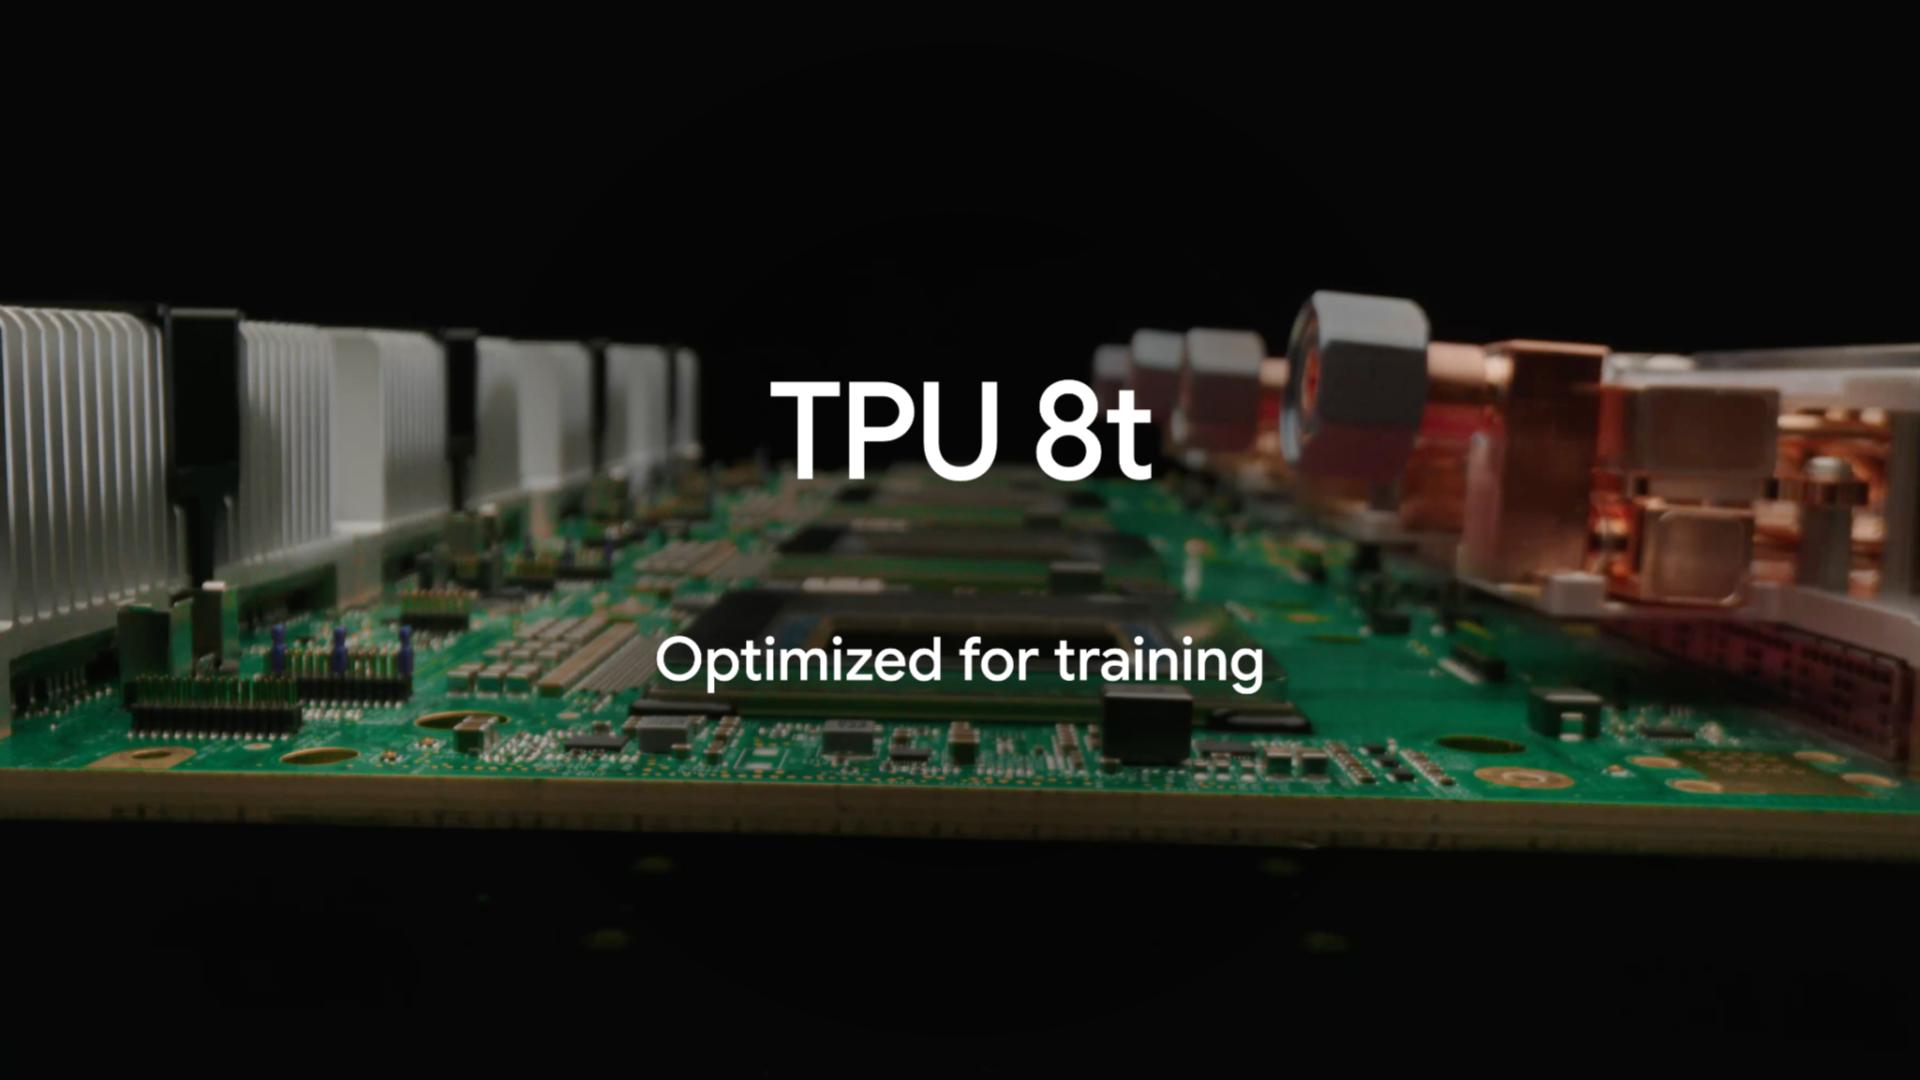
TPU 8t 专为大规模预训练和嵌入密集型工作负载而构建,单个 Superpod 中包含 9,600 个芯片,能为前沿模型提供所需的高密度计算能力,每个 Pod 的计算性能几乎是上一代的 3 倍。
即将推出。
TPU 8i
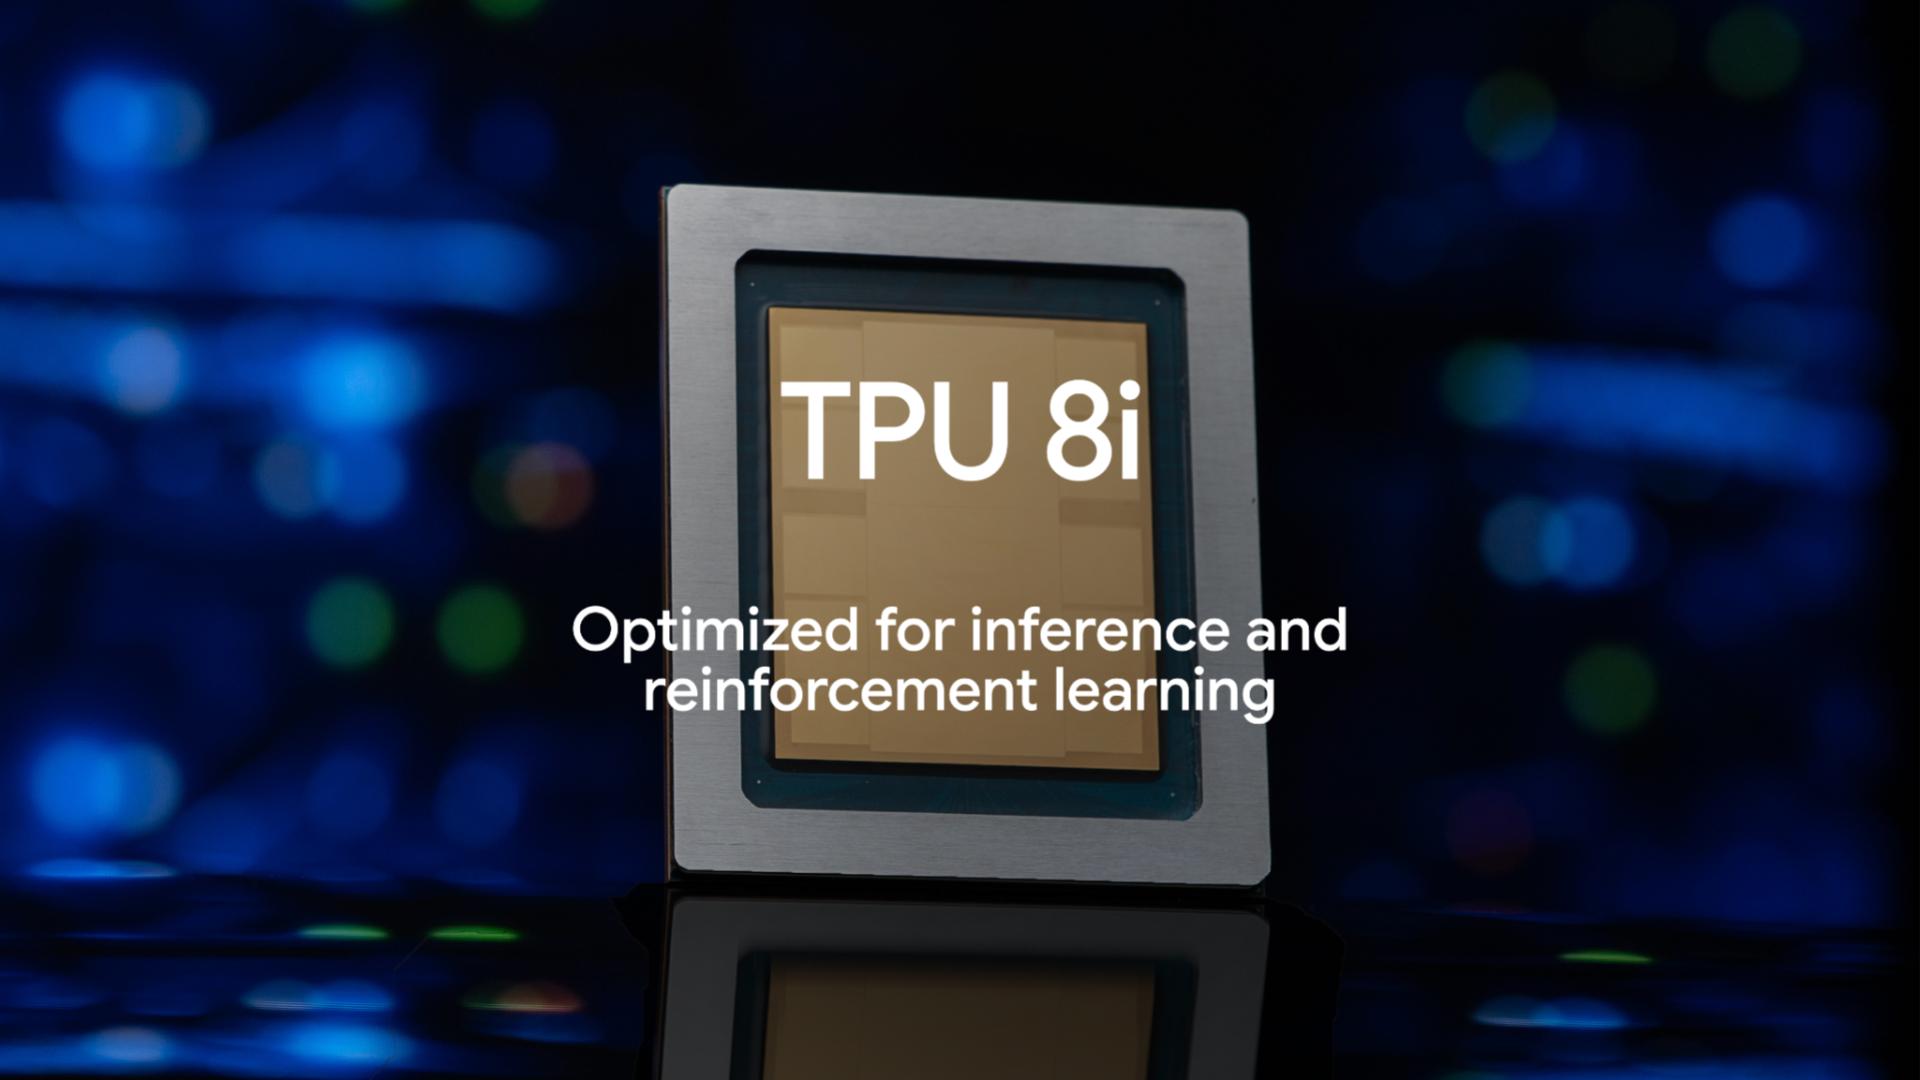
TPU 8i 针对训练后和推理进行了优化,与上一代相比,其性价比提高了 80%,可助力大型 MoE 模型实现低延迟推理。
即将推出。
Ironwood - 第 7 代
TPU 8t
TPU 8t 专为大规模预训练和嵌入密集型工作负载而构建,单个 Superpod 中包含 9,600 个芯片,能为前沿模型提供所需的高密度计算能力,每个 Pod 的计算性能几乎是上一代的 3 倍。
即将推出。
TPU 8i
TPU 8i 针对训练后和推理进行了优化,与上一代相比,其性价比提高了 80%,可助力大型 MoE 模型实现低延迟推理。
即将推出。
Ironwood - 第 7 代
TPU 软件栈
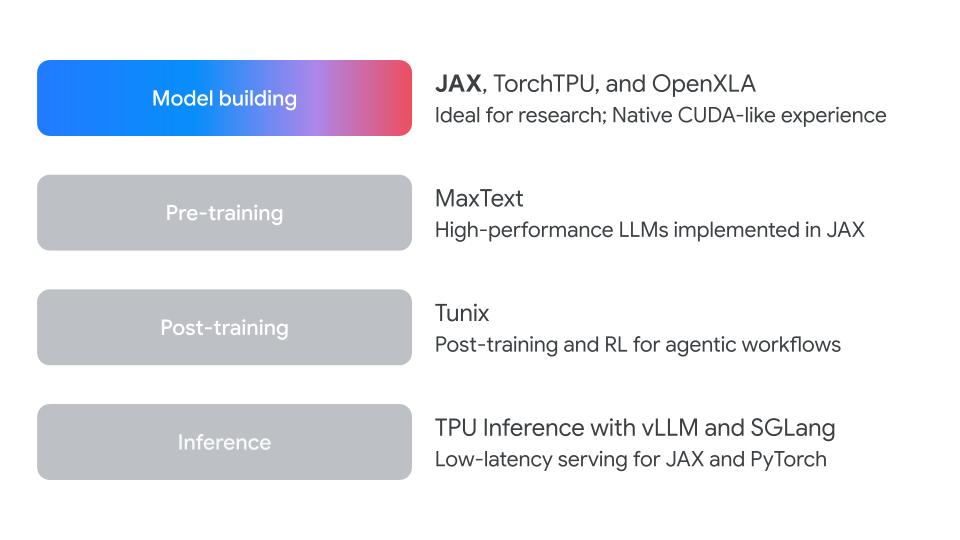
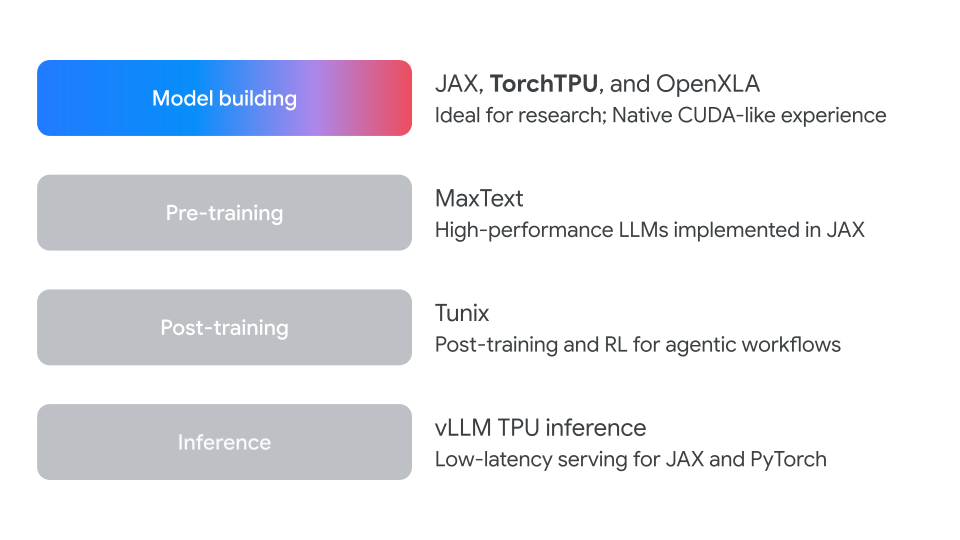
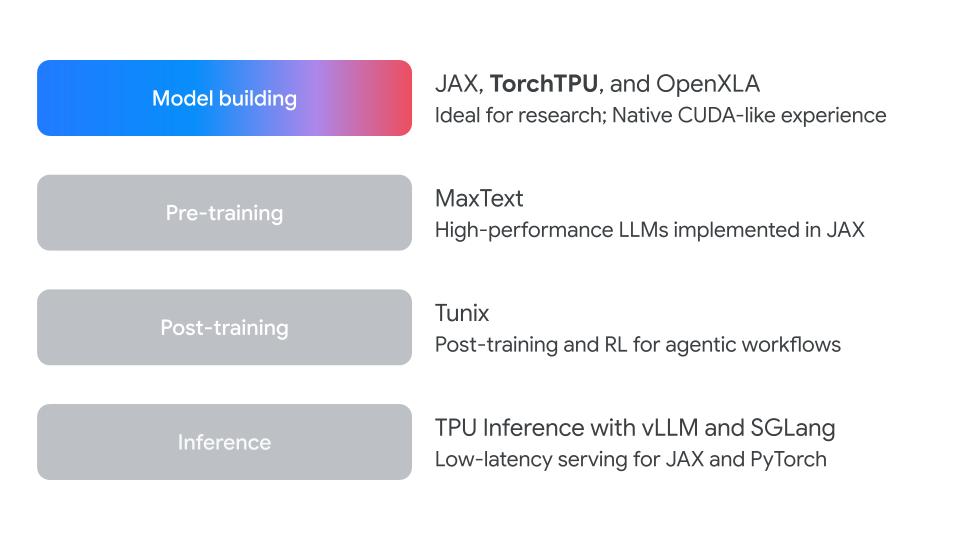
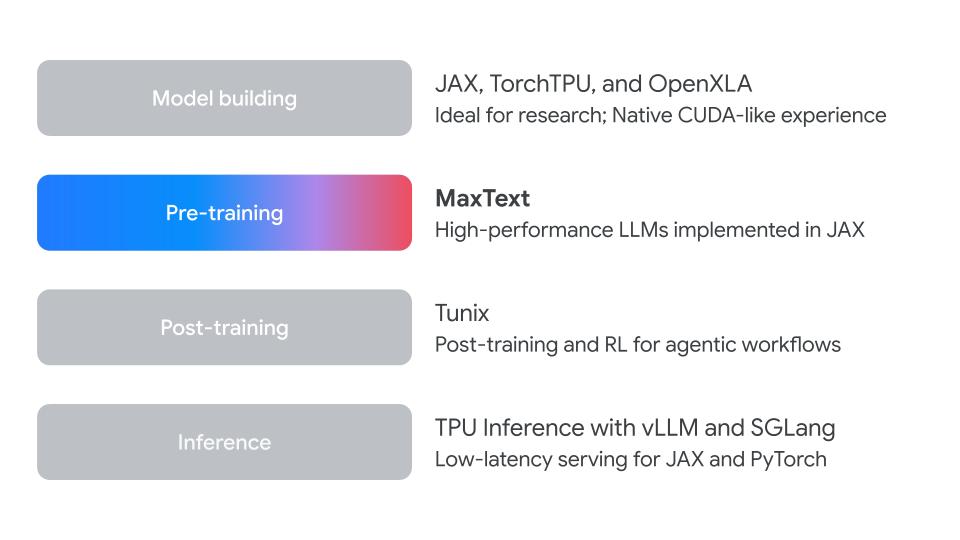
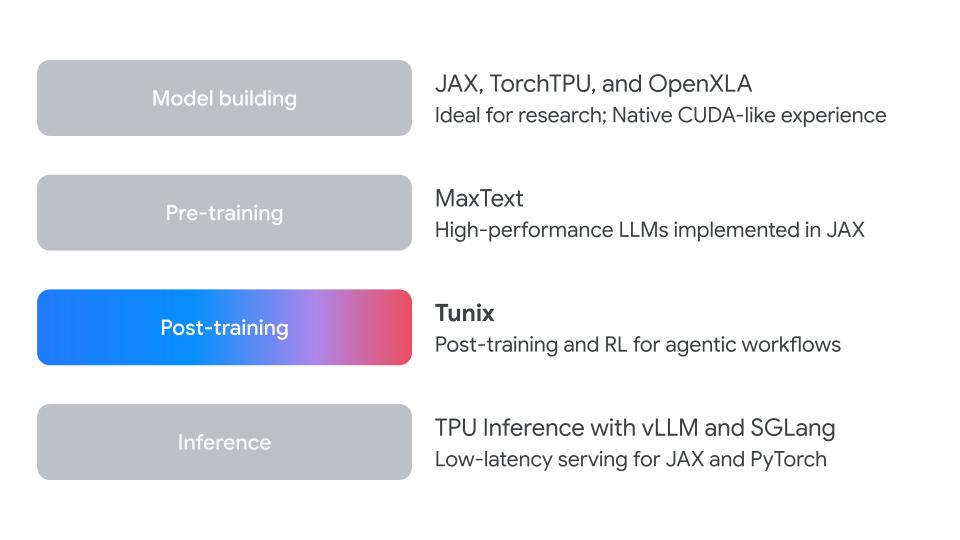
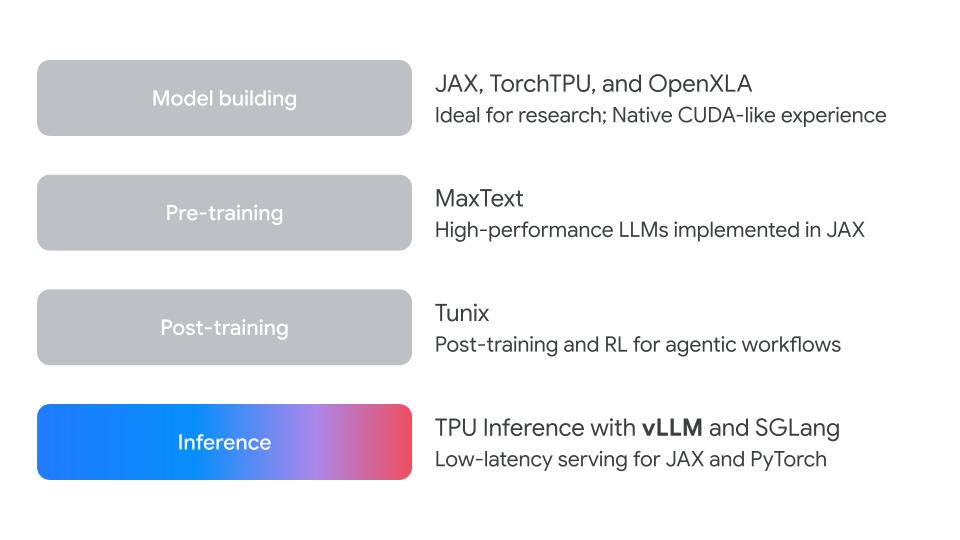
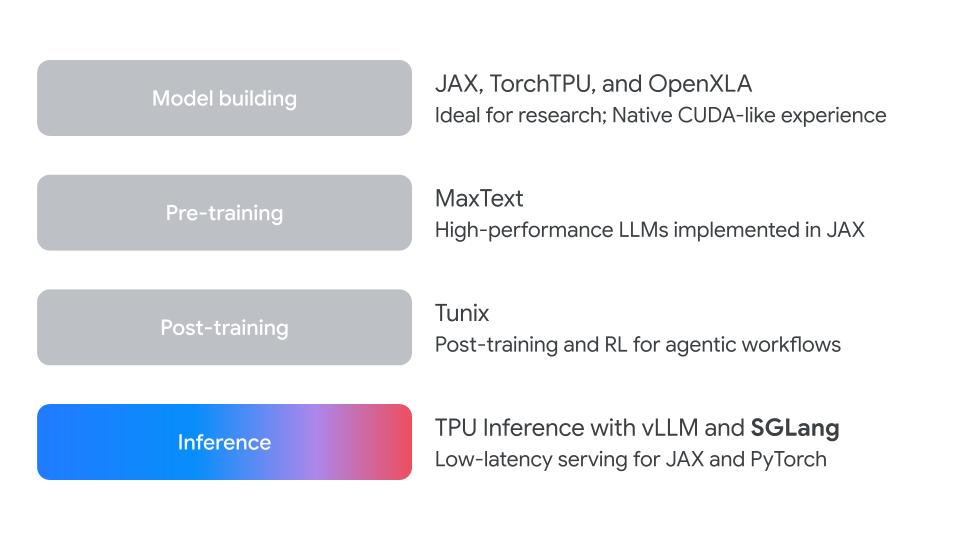
TPU 软件堆栈旨在衔接高级机器学习代码与定制芯片,从而实现硬件原始效率的最大化。
JAX
在 TPU 上以接近原生硬件的速度编译复杂的数学运算。这个用于数值计算和自动微分的开源库使用显式设备网格,可以轻松地跨大规模分布式 TPU 集群进行扩缩。
TorchTPU 和 PyTorch
使用标准语法直接在 TPU 上运行 PyTorch 工作负载。TorchTPU 是一个适用于 TPU 的开源 PyTorch 后端。它让您可以使用现有的代码和工具在 Cloud TPU 上训练、微调模型并提供推理服务,而无需更改 PyTorch 语义或学习 TPU 专用 API。
OpenXLA
减少编译瓶颈,充分释放 TPU 硬件的高性能。这款开源机器学习编译器可自动融合算子、优化内存用量并消除框架开销,从而在 TPU 后端执行线性代数计算。
MaxText
大幅缩短超大型基础模型的训练时间。这种基于 JAX 的参考实现提供了一个高度可伸缩的开箱即用蓝图,可在 TPU 上进行 LLM 预训练期间实现硬件的峰值利用率。
Tunix
简化 TPU 基础设施上的 LLM 训练后和对齐流程。这个轻量级的开源 JAX 库提供可伸缩的工作流,用于监督式微调 (SFT) 和强化学习 (RL),可高效地将原始模型转化为可用于生产用途的智能体。
vLLM
最大化提升推理服务并发能力,并有效降低实时 TPU 推理的运维成本。这个高吞吐量的开源引擎利用 PagedAttention 等内存管理技术来减少空间浪费,并在 TPU 架构上提供高效的 LLM 推理服务。 支持在 Cloud TPU 上对 JAX 和 PyTorch 模型进行推理。
SGLang
适用于大语言模型的高性能推理服务框架,专为 Cloud TPU 深度优化后端执行效能。
TPU 正在赋能创新者
其他资源
- 运行大规模 AI 训练工作负载缩短大型基础模型的预训练时间。TPU 8t 在单个 Pod 内提供高性能计算能力,并使用 Virgo 网络进行扩缩。该架构与快速存储访问和 Axion 驱动的 NUMA 隔离相结合,实现了高有效吞吐量,确保计算周期用于主动模型构建,而不会在数据传输或硬件重置期间闲置。面向开发者的 Ironwood TPU 训练指南
- 高效的训练后强化学习通过密集型训练后工作流,将基础模型构建为智能体。第 8 代 TPU 系统可快速处理连续的强化学习试验,奖励最佳推理路径,而不会像前几代系统那样出现周期延迟。这让您可以高效地对世界模型进行微调,让智能体能够在模拟环境中完善推理,然后再在真实环境中执行。MaxText 训练后
- 大规模低延迟 AI 推理工作负载打破推理内存墙。TPU 8i 扩展了片上 SRAM 和高带宽内存,可将高容量 KV 缓存完全托管在芯片上。通过使用 SparseCore-Collectives 加速引擎 (SC-CAE) 分流全局通信任务,这种架构可显著缩短片上延迟时间,使主计算核心能够专注于纯粹的低延迟 token 生成。利用 Google Cloud 加快 AI 推理速度
- Virgo Network:Google 的横向扩容 AI 数据中心架构Virgo Network 是一种横向扩容架构,旨在满足现代 AI 工作负载的极端要求。它基于高基数交换机构建,允许每个交换机使用更多端口,从而减少网络层,并采用扁平的两层无阻塞拓扑。阅读公告文章
- TPU 上万亿参数模型的集群级可靠性十多年来,Google 一直在大规模运行张量处理单元 (TPU) 集群,实现了满足现代 AI 工作负载架构要求的可靠性。在这篇博客中,我们将介绍 Google Cloud TPU 的集群级可靠性框架,该框架专注于超级 Pod 级别的总体性能,也是 Google 内部用于构建全球最先进 AI 模型的框架。阅读文章
- 利用 TPU 设计可持续的 AI深入了解 TPU 效率和生命周期排放。我们在硬件碳效率方面的显著改进与 AI 模型和算法设计的快速进步相得益彰。阅读文章
技术应用场景
- 运行大规模 AI 训练工作负载缩短大型基础模型的预训练时间。TPU 8t 在单个 Pod 内提供高性能计算能力,并使用 Virgo 网络进行扩缩。该架构与快速存储访问和 Axion 驱动的 NUMA 隔离相结合,实现了高有效吞吐量,确保计算周期用于主动模型构建,而不会在数据传输或硬件重置期间闲置。面向开发者的 Ironwood TPU 训练指南
- 高效的训练后强化学习通过密集型训练后工作流,将基础模型构建为智能体。第 8 代 TPU 系统可快速处理连续的强化学习试验,奖励最佳推理路径,而不会像前几代系统那样出现周期延迟。这让您可以高效地对世界模型进行微调,让智能体能够在模拟环境中完善推理,然后再在真实环境中执行。MaxText 训练后
- 大规模低延迟 AI 推理工作负载打破推理内存墙。TPU 8i 扩展了片上 SRAM 和高带宽内存,可将高容量 KV 缓存完全托管在芯片上。通过使用 SparseCore-Collectives 加速引擎 (SC-CAE) 分流全局通信任务,这种架构可显著缩短片上延迟时间,使主计算核心能够专注于纯粹的低延迟 token 生成。利用 Google Cloud 加快 AI 推理速度
文章
- Virgo Network:Google 的横向扩容 AI 数据中心架构Virgo Network 是一种横向扩容架构,旨在满足现代 AI 工作负载的极端要求。它基于高基数交换机构建,允许每个交换机使用更多端口,从而减少网络层,并采用扁平的两层无阻塞拓扑。阅读公告文章
- TPU 上万亿参数模型的集群级可靠性十多年来,Google 一直在大规模运行张量处理单元 (TPU) 集群,实现了满足现代 AI 工作负载架构要求的可靠性。在这篇博客中,我们将介绍 Google Cloud TPU 的集群级可靠性框架,该框架专注于超级 Pod 级别的总体性能,也是 Google 内部用于构建全球最先进 AI 模型的框架。阅读文章
- 利用 TPU 设计可持续的 AI深入了解 TPU 效率和生命周期排放。我们在硬件碳效率方面的显著改进与 AI 模型和算法设计的快速进步相得益彰。阅读文章

常见问题解答
什么是张量处理单元 (TPU)?
TPU 是 Google 开发的定制设计的应用专用集成电路 (ASIC)。它们是专为加速机器学习和人工智能工作负载而从头开始构建的。TPU 专为繁重的矩阵乘法和张量运算进行了优化 - 这些运算构成了神经网络的基本智能模块,为从大语言模型到复杂推理智能体等各类应用提供支持。
TPU 架构的工作原理是什么?
TPU 的核心是专门的矩阵乘法单元 (MXU),可同时处理大量矩阵运算。TPU 采用“脉动阵列”架构,只需读取一次数据,即可让数据在数千个算术逻辑单元 (ALU) 中持续流动,并不断累积结果,而无需频繁地对内存进行读写操作。它们还支持低精度算法(如 16 位或 8 位浮点),从而在不牺牲 AI 模型所需精度的情况下,实现每秒数百万次的计算。
Cloud TPU 支持哪些机器学习框架?
Cloud TPU 为领先的机器学习框架(主要是 TensorFlow、PyTorch 和 JAX)提供原生的高性能支持。使用这些框架编写的代码由加速线性代数 (XLA) 编译器编译,该编译器会自动优化计算图,以便在底层 TPU 硬件上高效运行。
哪些类型的工作负载最适合 TPU?
TPU 擅长处理需要大规模并行矩阵运算的深度学习任务,特别适用于以下场景:
- 由矩阵计算主导的模型
- 需要数周或数月才能收敛的训练
- 大型基础模型和大语言模型 (LLM)
- 具有超大嵌入的工作负载,例如高级商品推荐引擎
- 持续强化学习和高容量、低延迟推理
什么是 TPU Pod 和切片?
TPU Pod 是一个由 TPU 芯片组成的庞大物理集群,这些芯片通过专用高速网络(例如 Google 的光路交换或 Virgo 网络)连接在一起。单个超级 Pod 可以包含数千个互连芯片。“切片”是 Pod 的一个较小的专用子集,您可以租用它。这种网络架构使开发者能够以极少甚至无需更改代码的方式,在大量计算资源上扩展其 AI 工作负载,从而有效地将整个切片作为一个统一的机器来运行。
在 TPU 训练的背景下,什么是机器学习“有效吞吐量”?
Goodput 是指基础设施主动训练模型所花费的实际有效时间,而不是空闲时间。训练超大规模基础模型涉及跨数千个芯片的复杂编排,这意味着计算周期很容易因数据传输延迟、硬件重置或检查点保存而白白浪费。Cloud TPU 旨在通过高带宽互连和优化的内存缓存最大限度地提高有效吞吐量,从而确保付费计算周期直接促进模型改进。
如何大规模处理 TPU 的编排?
用户可以使用 Google Kubernetes Engine (GKE) 和 Cluster Director 来支持可靠性、全面监控和管理。通过利用 GKE for TPU,客户可以在云原生生态系统中运行,该生态系统具有用于负载均衡的 Inference Gateway,并且能够将部署扩展到多达 13 万个 GKE 节点。
当前适用于 TPU 的推理软件生态格局如何?
Cloud TPU 主要通过 vLLM 和 SGLang 等热门开源推理引擎,为 LLM 提供高吞吐量、低延迟的服务支持:
- vLLM:通过 vllm-tpu 软件包与 Cloud TPU 集成,为 JAX 模型提供推理服务;并通过 vllm-torchtpu 为 Torch 模型提供推理服务。
- SGLang:利用其专用的 JAX 后端 (sglang-jax) 和独立的 Torch 后端 (sglang-torch) 提供高性能的 TPU 推理服务。
这两个开源项目均提供了专为 TPU 硬件量身打造的特定优化库,从而最大化提升推理部署效能。如需查看设置指南,请参阅 Cloud TPU 推理文档。











