Progettato per l'AI di nuova generazione
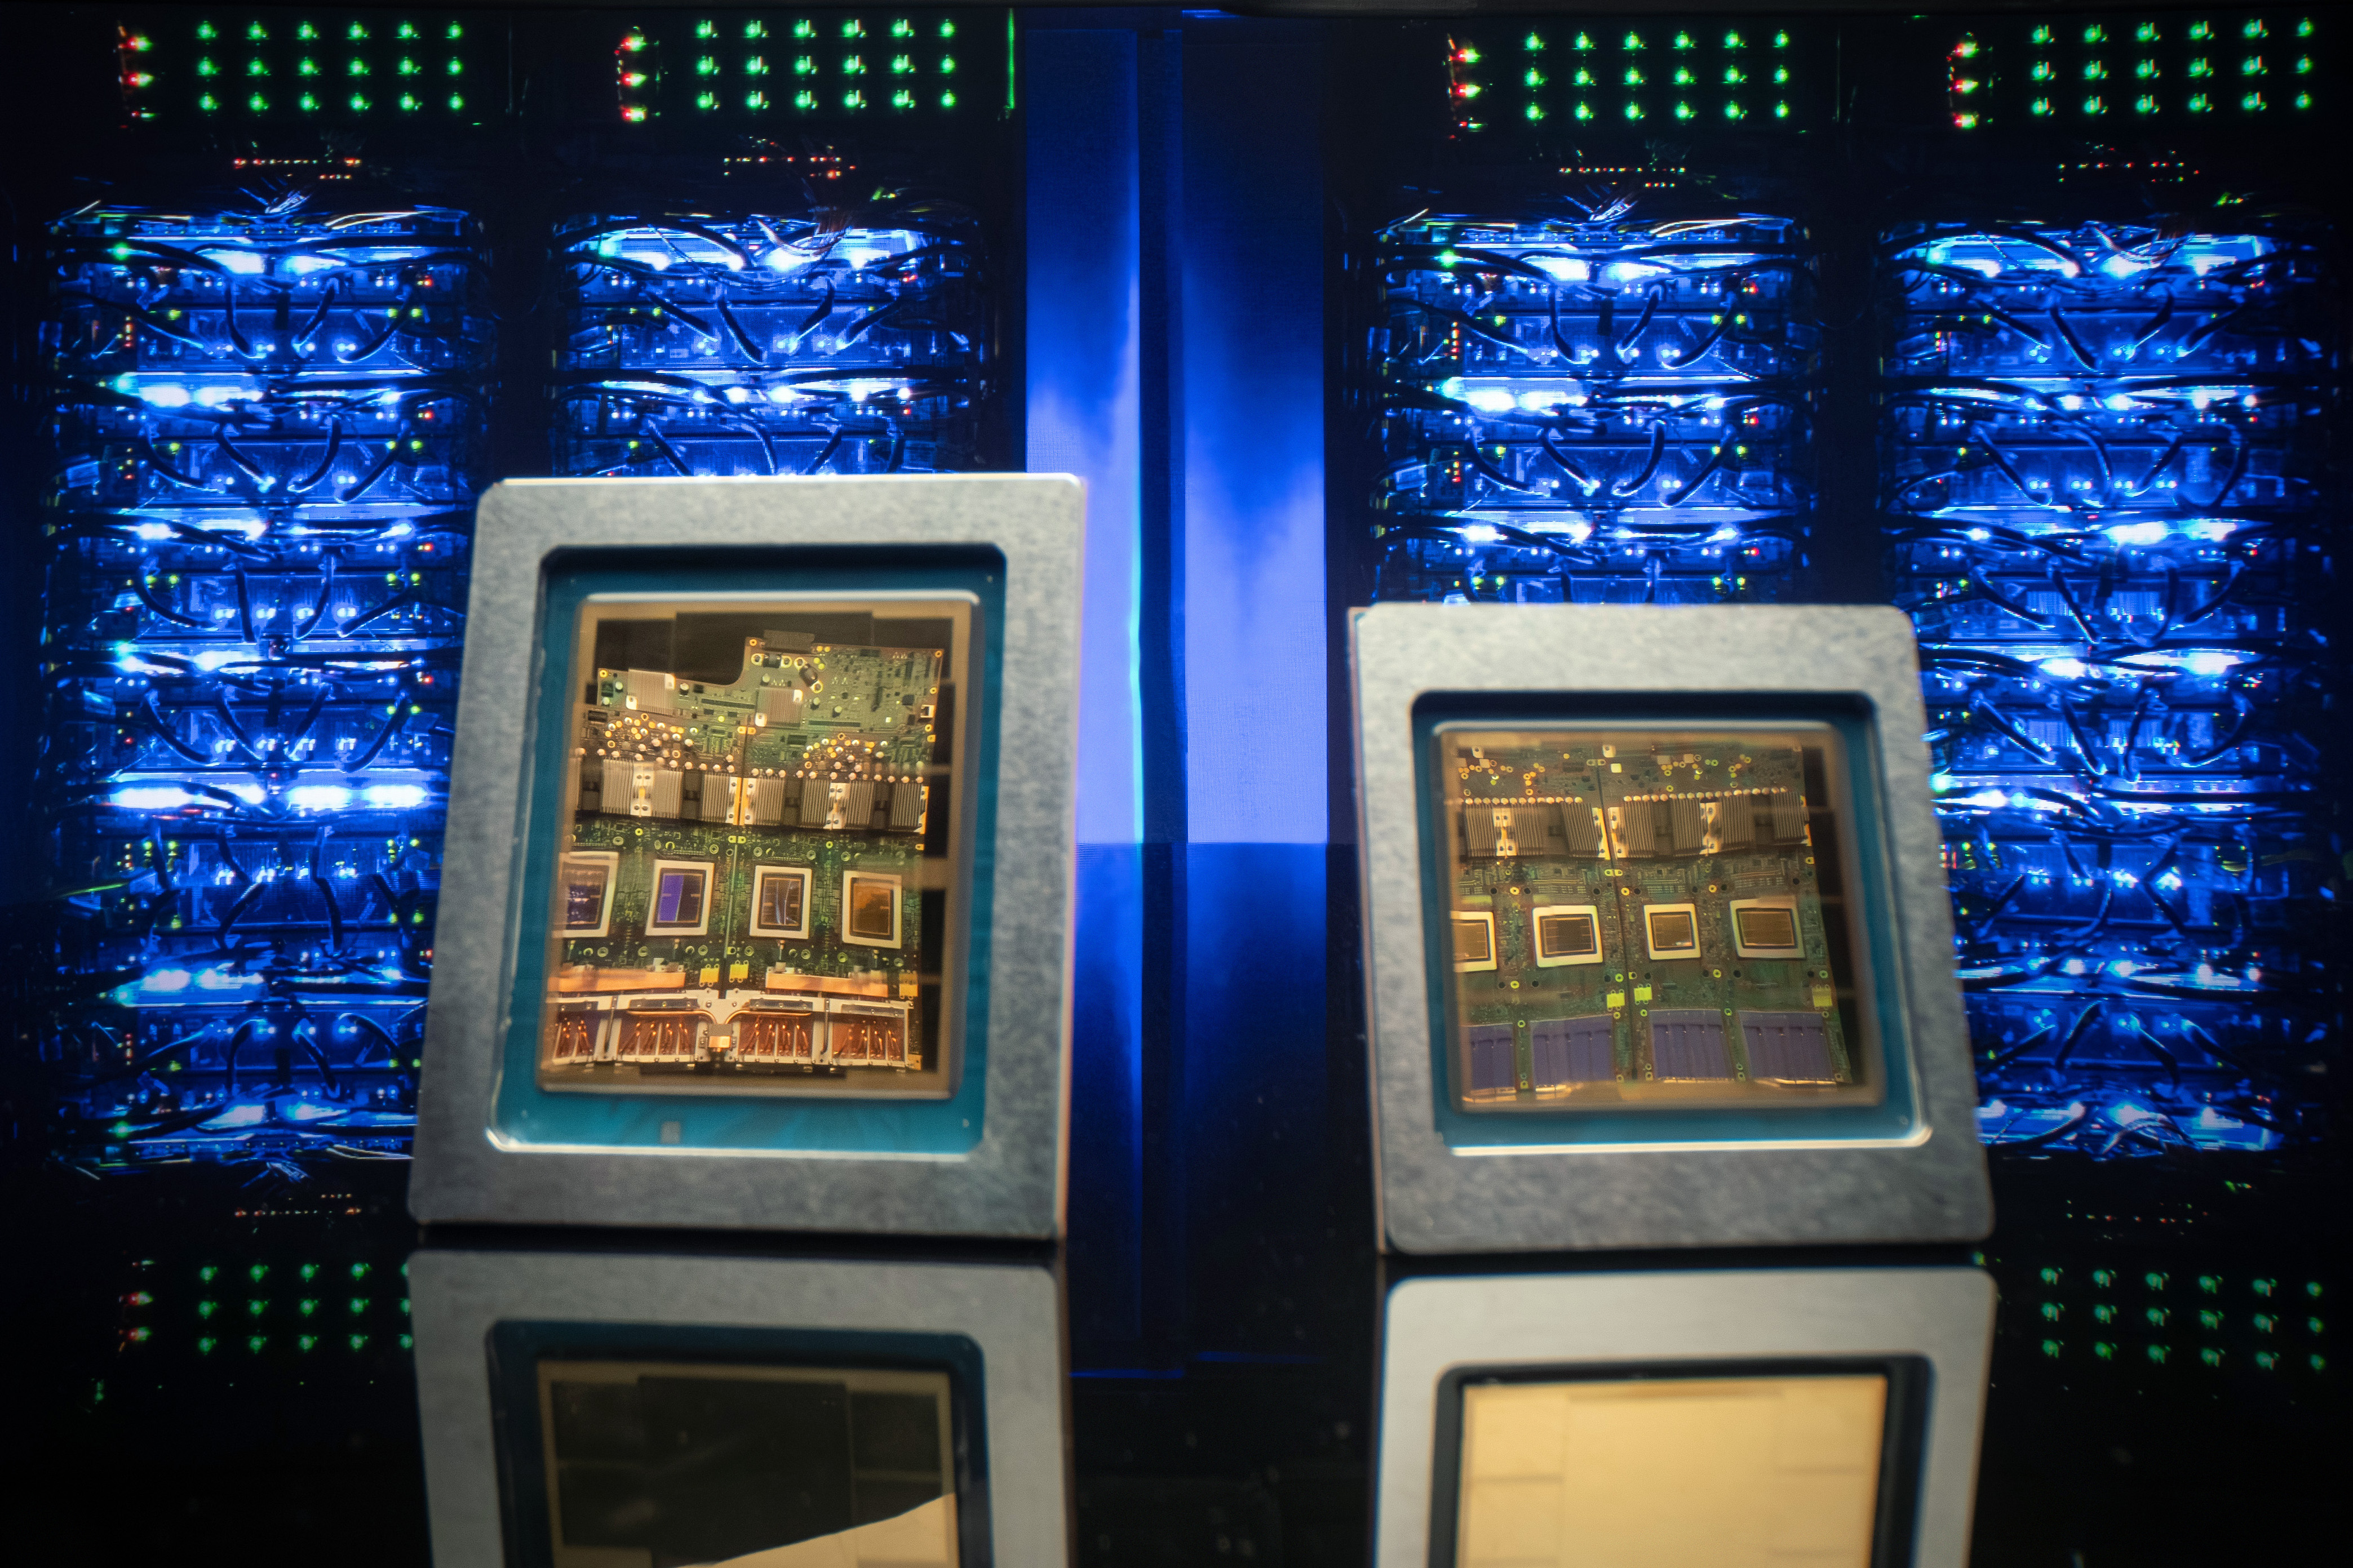
Le Tensor Processing Unit (TPU) sono acceleratori personalizzati progettati insieme a software open per alimentare l'intero ciclo di vita dell'AI, dall'addestramento all'inferenza su larga scala fino alle richieste di dati di ragionamento multi-step dell'AI agentica.
Basato su AI Hypercomputer
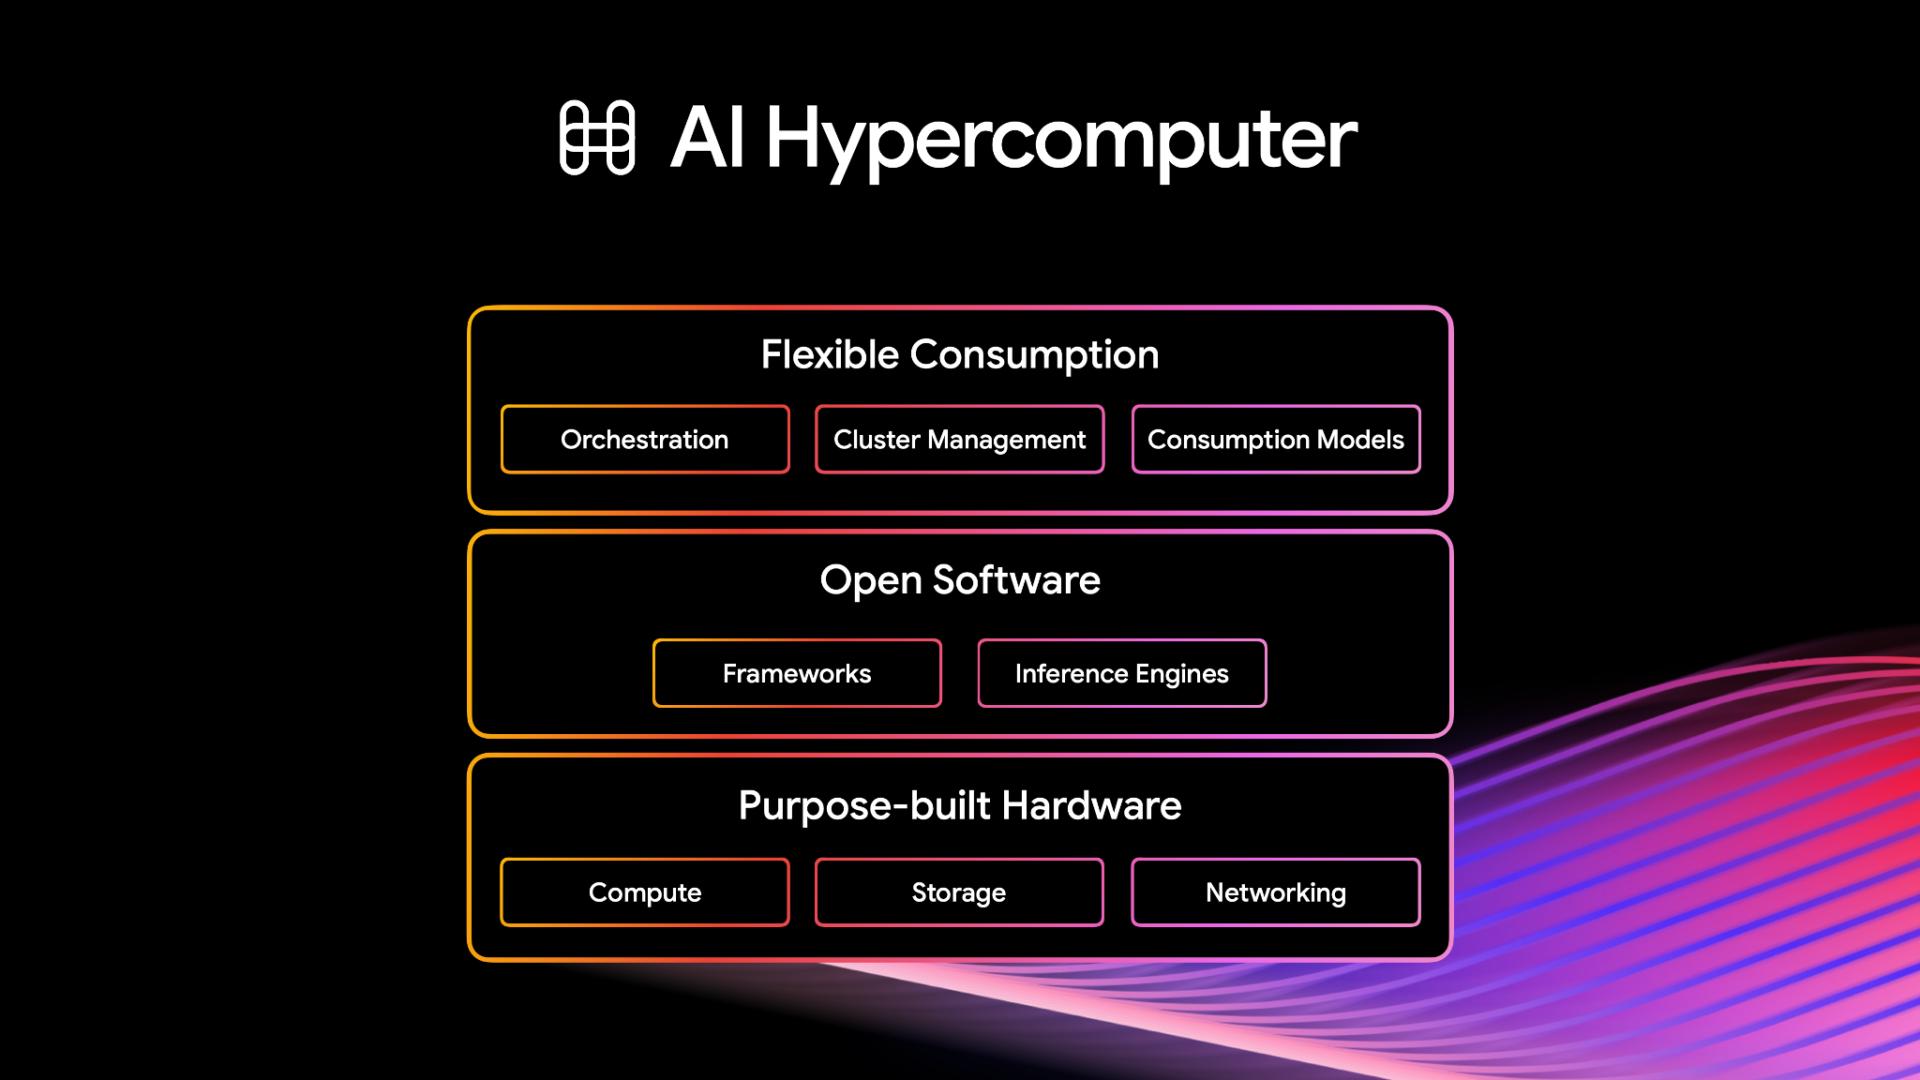
Le TPU sono basate su AI Hypercomputer di Google Cloud, un'architettura innovativa che combina hardware appositamente progettato, software aperto e modelli di consumo flessibili.
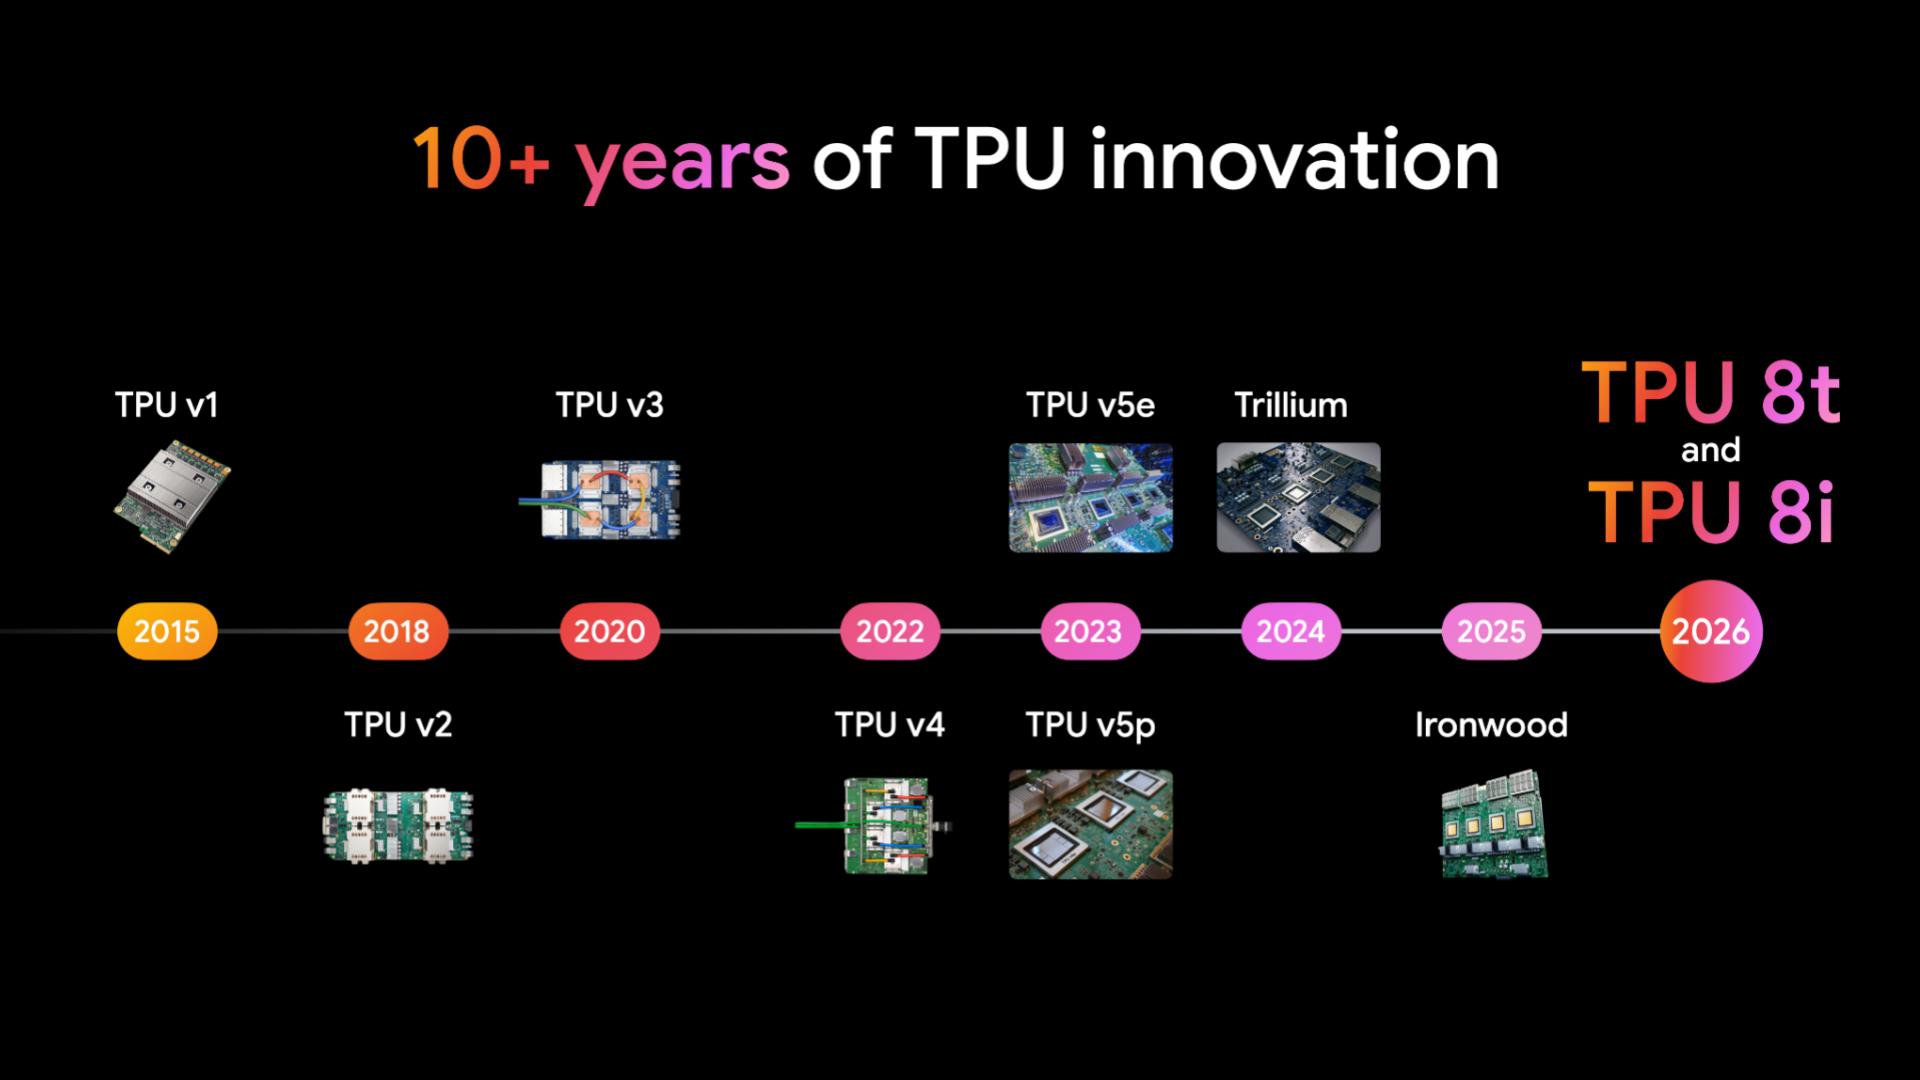
Un decennio di Tensor Processing Unit (TPU)
Le TPU sono progettate appositamente per workload di AI avanzati, dai modelli linguistici di grandi dimensioni alla generazione di codice, fino agli agenti intelligenti. Sono il motore di Gemini e dei prodotti di punta di Google con miliardi di utenti, tra cui la Ricerca, Foto e Maps.
Vantaggi
Operazioni aperte, flessibili e affidabili
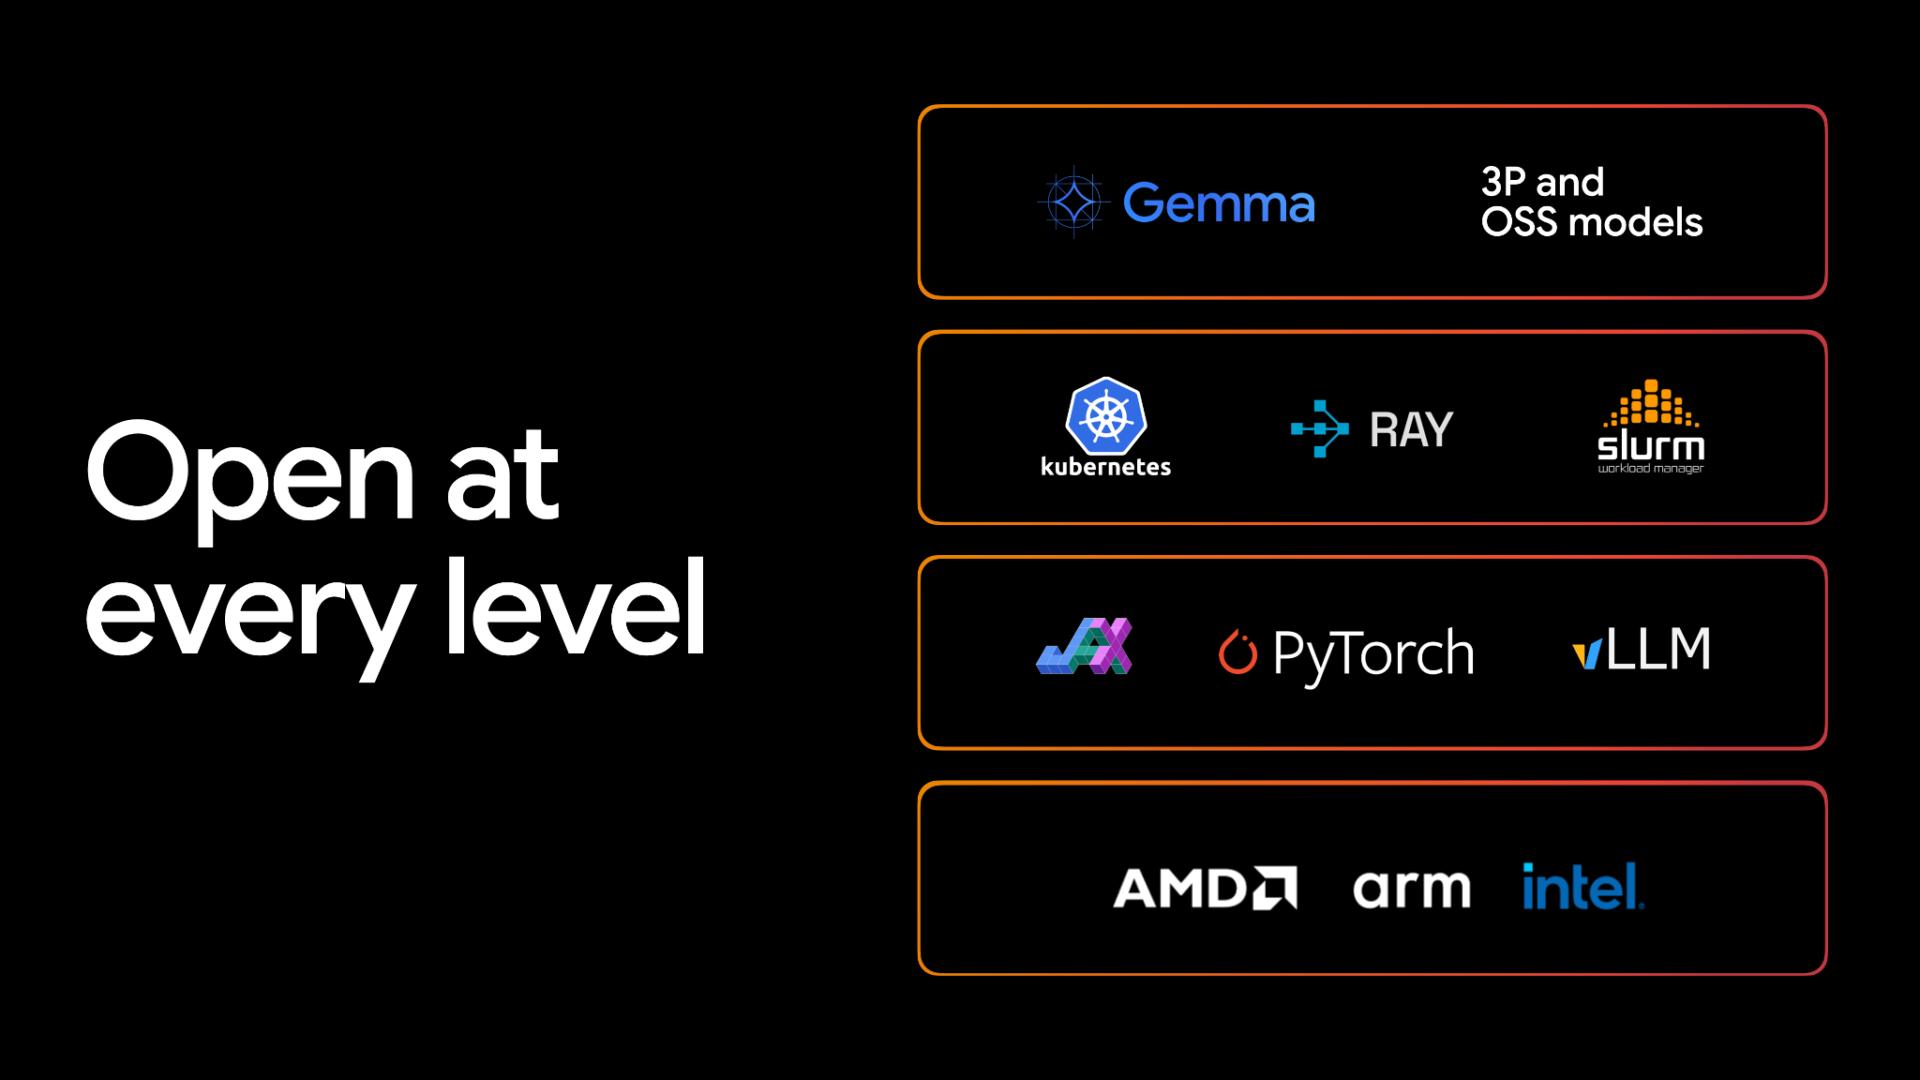
Crea su un ecosistema aperto utilizzando librerie e strumenti familiari. Le TPU forniscono supporto nativo e ad alte prestazioni per PyTorch e JAX e supportano il motore vLLM per un'inferenza rapida. Gestisci e scala questi deployment in modo affidabile tra cluster globali con Google Kubernetes Engine (GKE).
Prestazioni senza compromessi
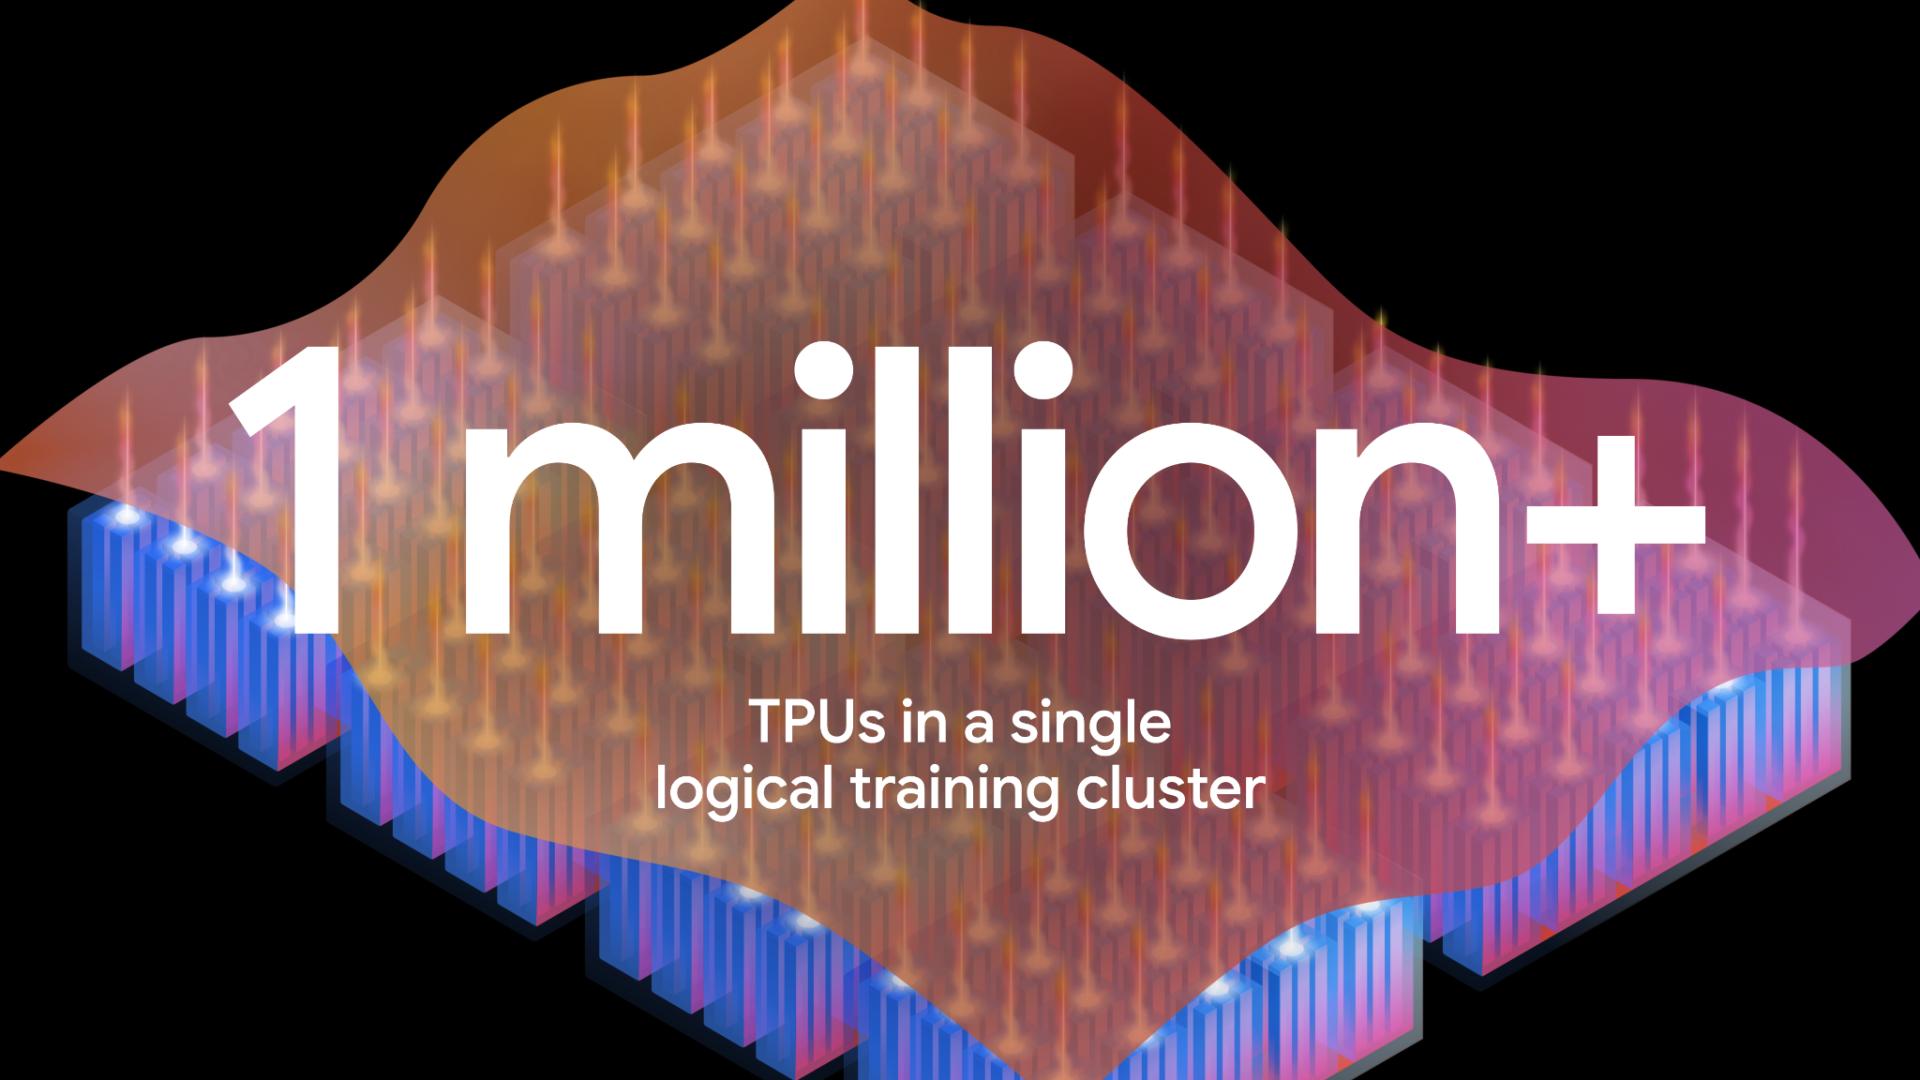
Trasforma mesi di addestramento in settimane per i modelli di frontiera. Con un massimo di 1 milione di chip TPU in un singolo cluster, le TPU massimizzano il goodput, garantendo che quasi ogni ciclo di calcolo sia destinato all'apprendimento attivo.
Vantaggi
Operazioni aperte, flessibili e affidabili
Crea su un ecosistema aperto utilizzando librerie e strumenti familiari. Le TPU forniscono supporto nativo e ad alte prestazioni per PyTorch e JAX e supportano il motore vLLM per un'inferenza rapida. Gestisci e scala questi deployment in modo affidabile tra cluster globali con Google Kubernetes Engine (GKE).
Prestazioni senza compromessi
Trasforma mesi di addestramento in settimane per i modelli di frontiera. Con un massimo di 1 milione di chip TPU in un singolo cluster, le TPU massimizzano il goodput, garantendo che quasi ogni ciclo di calcolo sia destinato all'apprendimento attivo.
TPU 8t
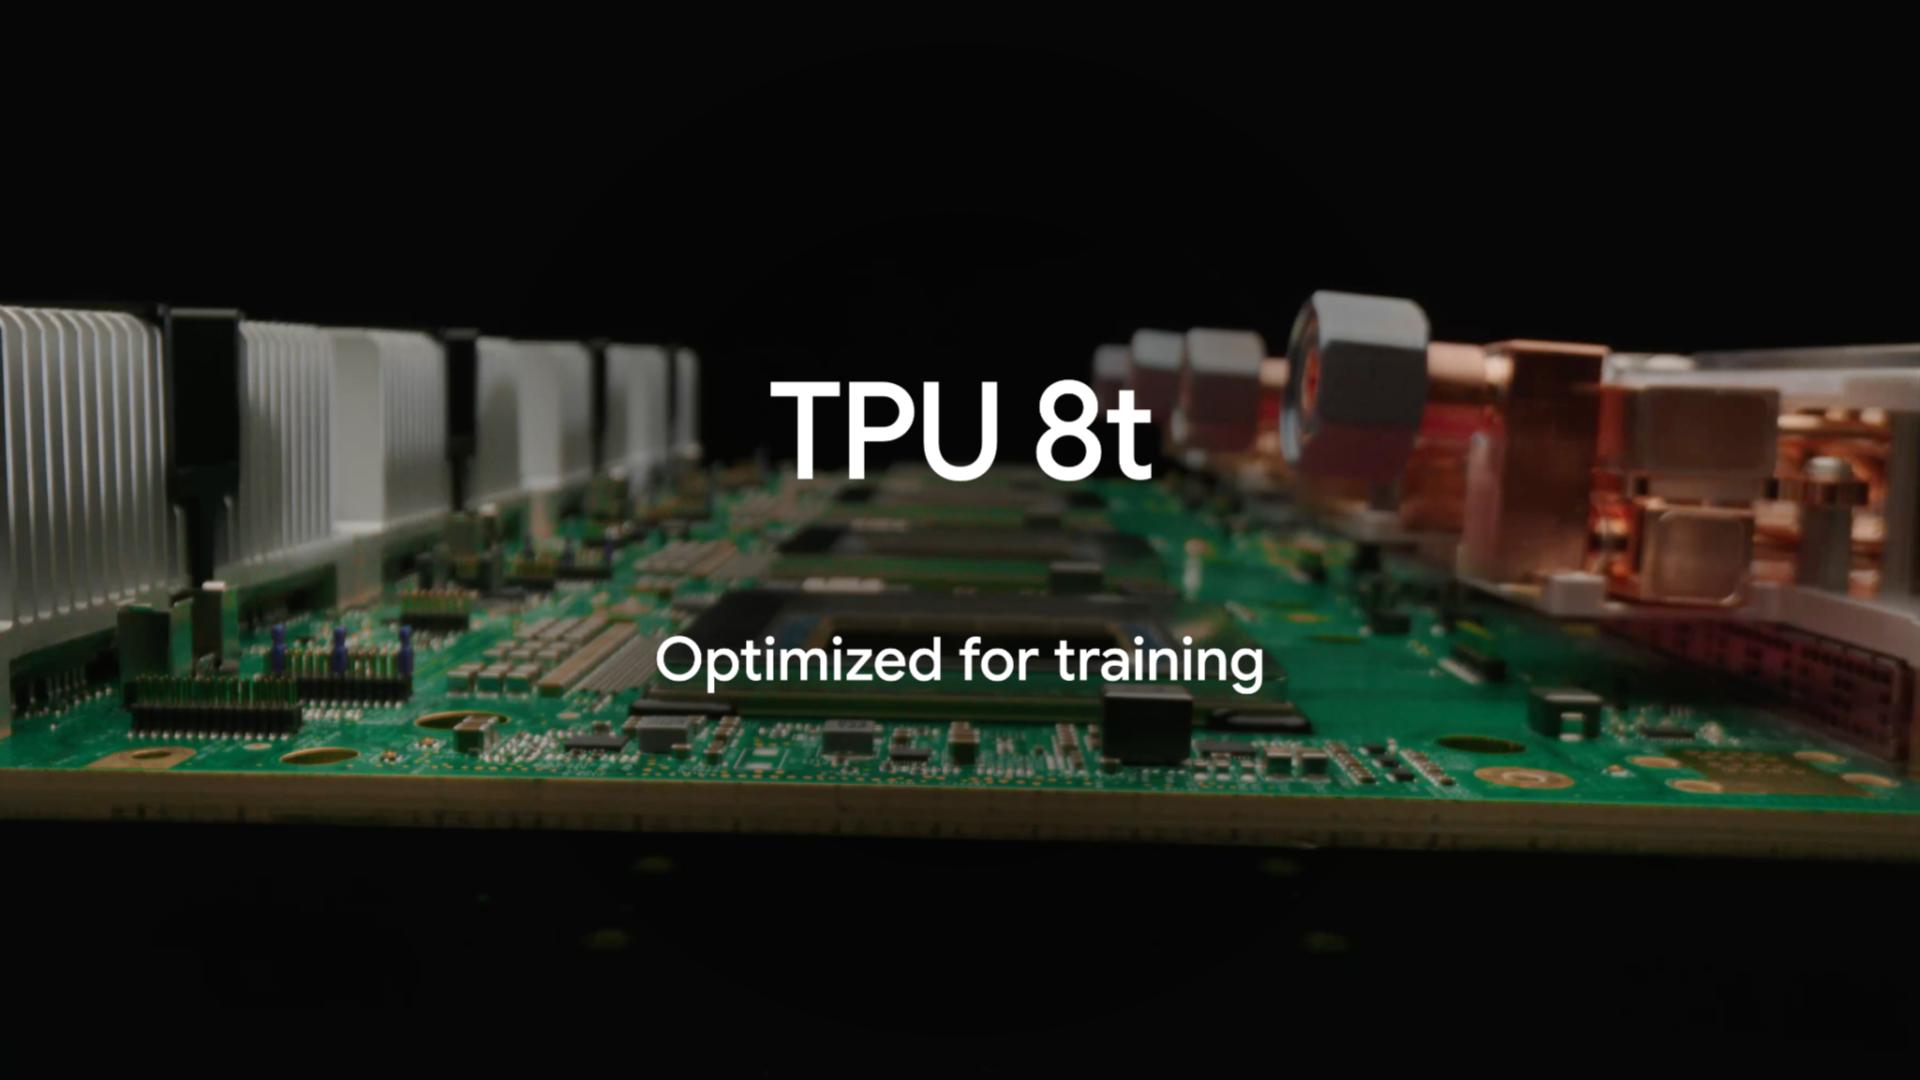
TPU 8t è progettato per pre-addestramento su larga scala e carichi di lavoro con molti embedding su una scala di 9600 chip in un singolo superpod, offrendo il computing ad alta densità richiesto per i modelli di frontiera con prestazioni di computing per pod quasi 3 volte superiori rispetto alla generazione precedente.
Disponibile a breve.
TPU 8i
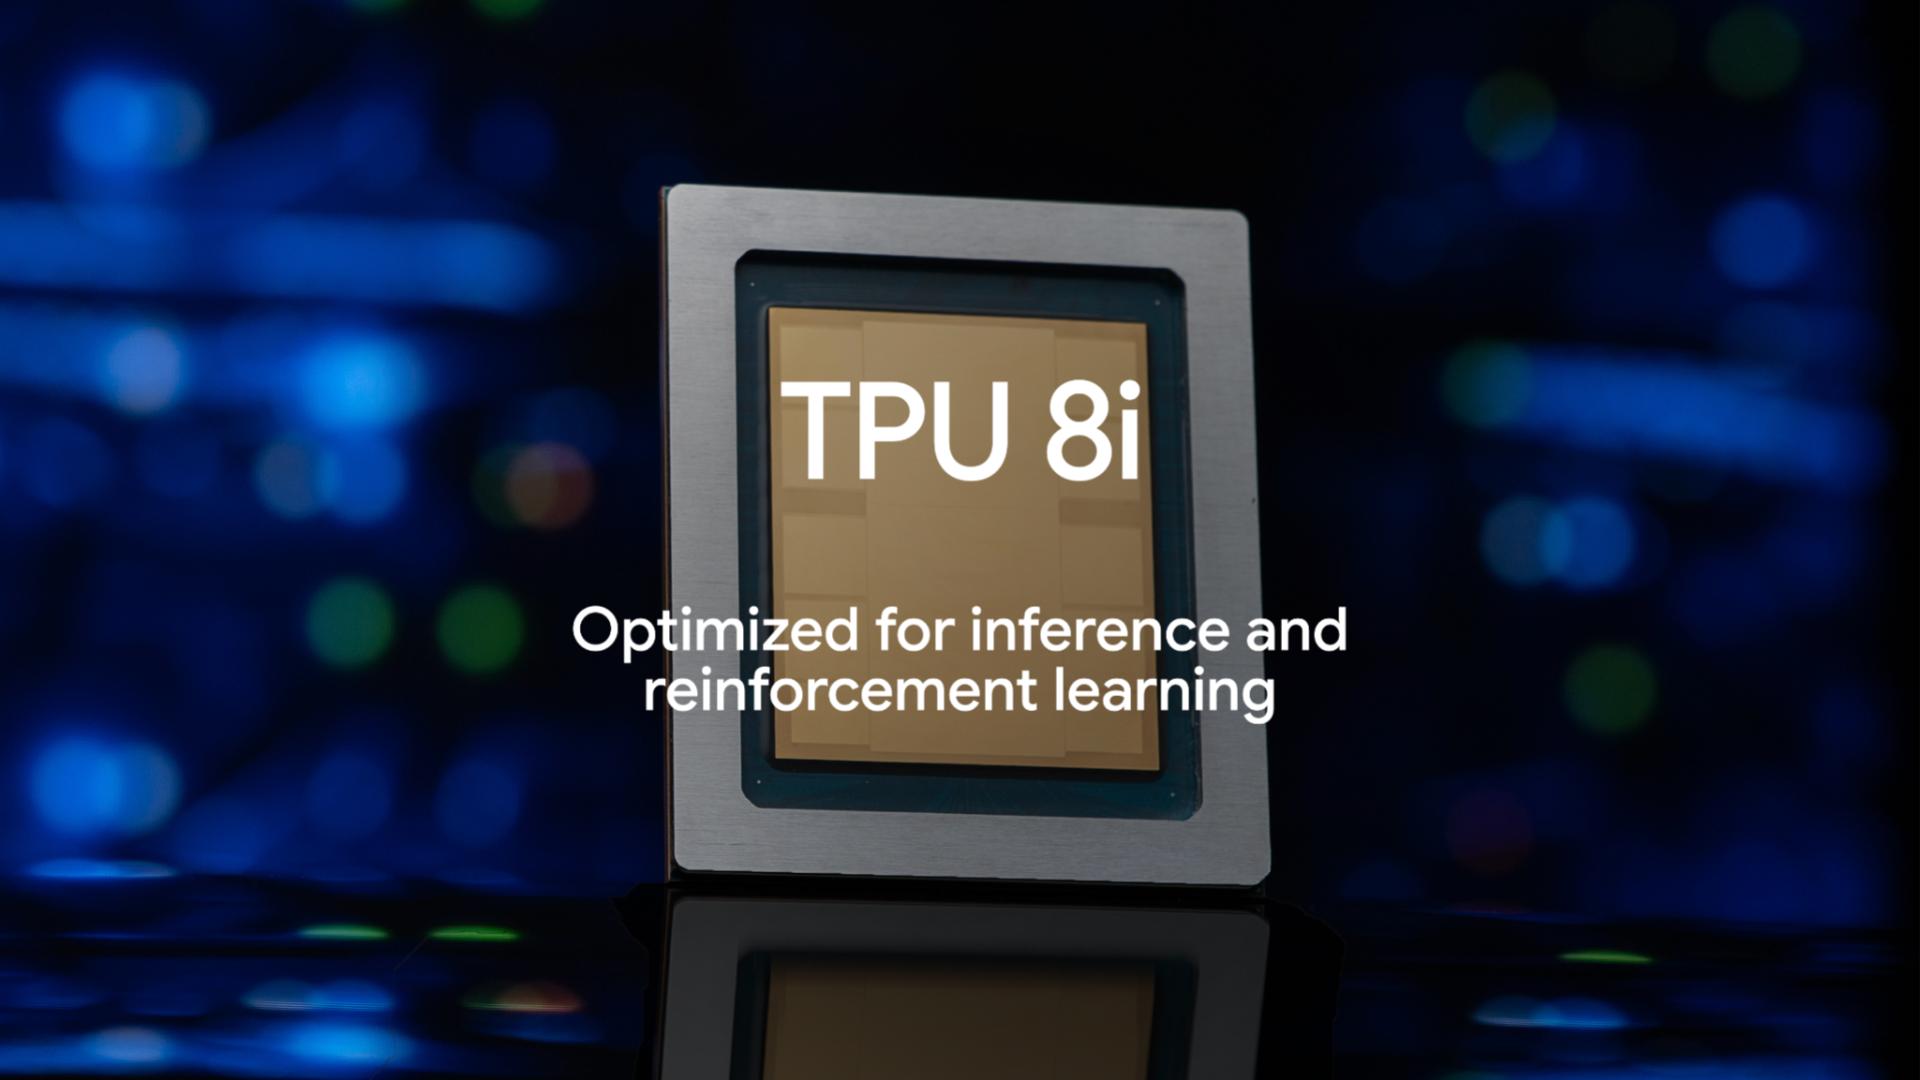
TPU 8i è ottimizzata per la post-formazione e l'inferenza. Offre un miglioramento dell'80% delle prestazioni per dollaro rispetto alle generazioni precedenti per l'inferenza a bassa latenza per modelli MoE di grandi dimensioni.
Disponibile a breve.
Ironwood - 7ª generazione
TPU di settima generazione a efficienza energetica progettata per addestramento, ragionamento e inferenza su larga scala. Dispone di 9216 chip raffreddati a liquido per pod,offre 42, 5 ExaFlops e prestazioni per chip 4 volte migliori rispetto a Trillium.
Generalmente disponibile.
Trillium - 6ª generazione
TPU di sesta generazione con efficienza energetica e prestazioni di calcolo di picco migliorate per l'addestramento e l'inferenza. Funziona con un'efficienza energetica superiore del 67% e offre prestazioni di calcolo di picco per chip 4,7 volte superiori rispetto alla precedente generazione di TPU v5e.
Generalmente disponibile.
Stack software TPU
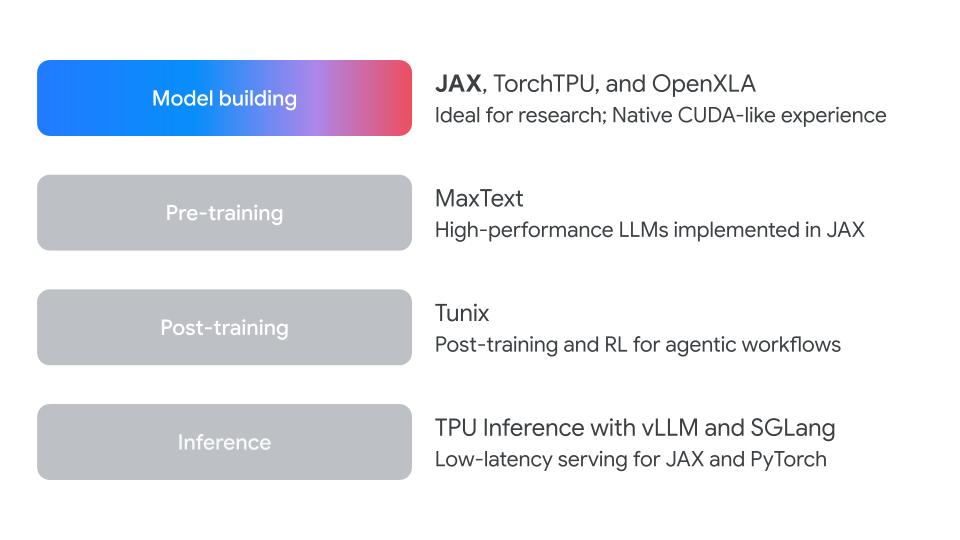
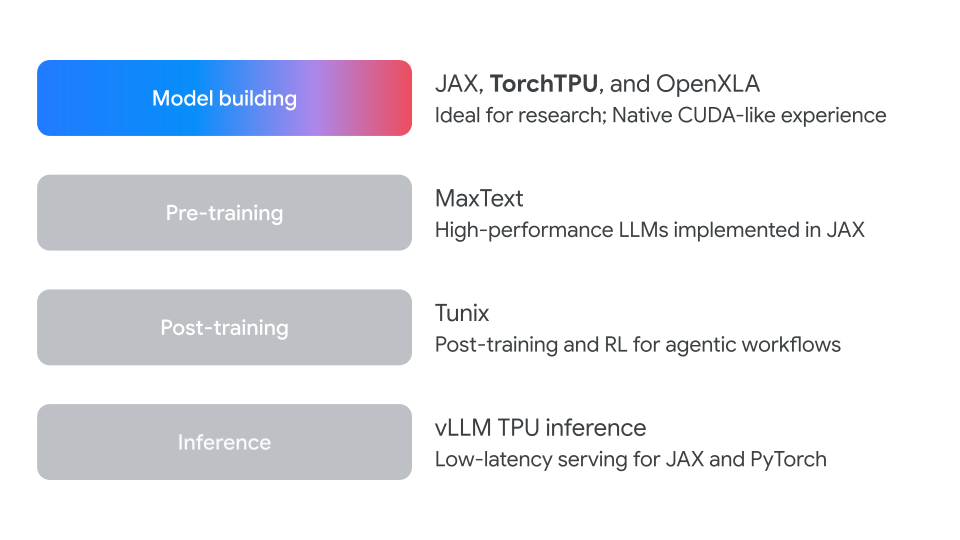
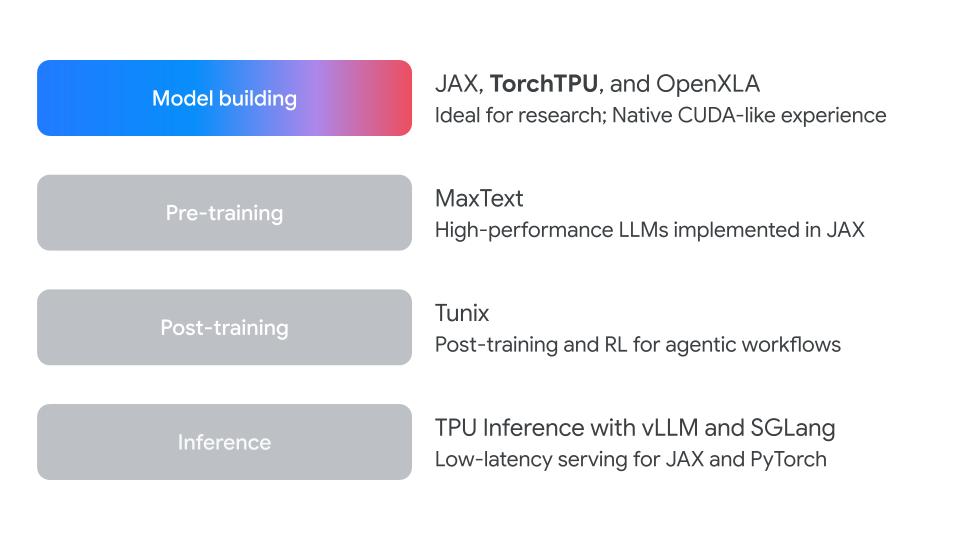
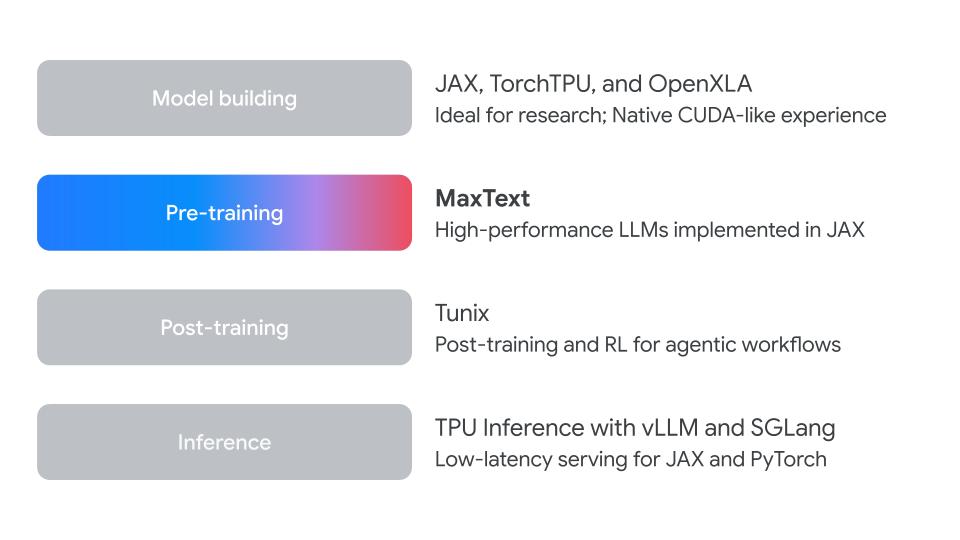
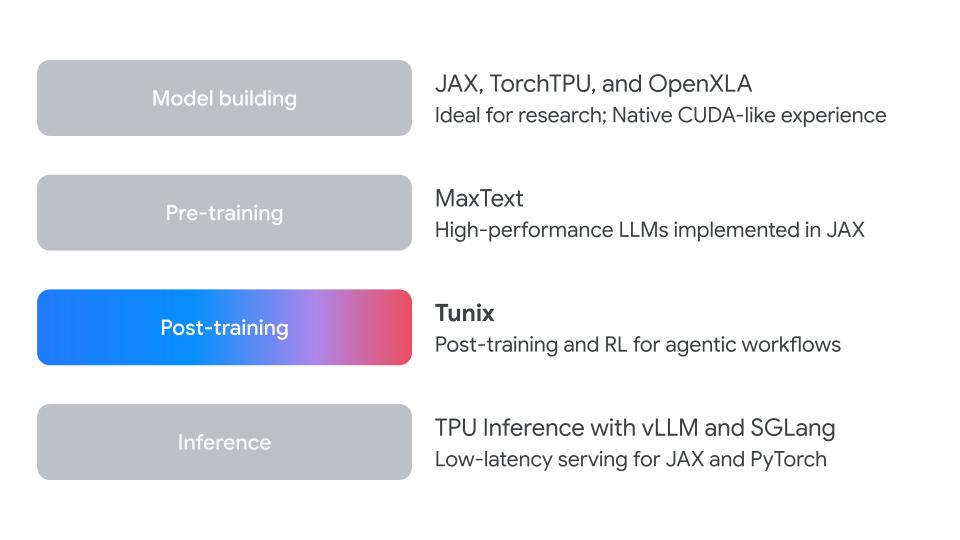
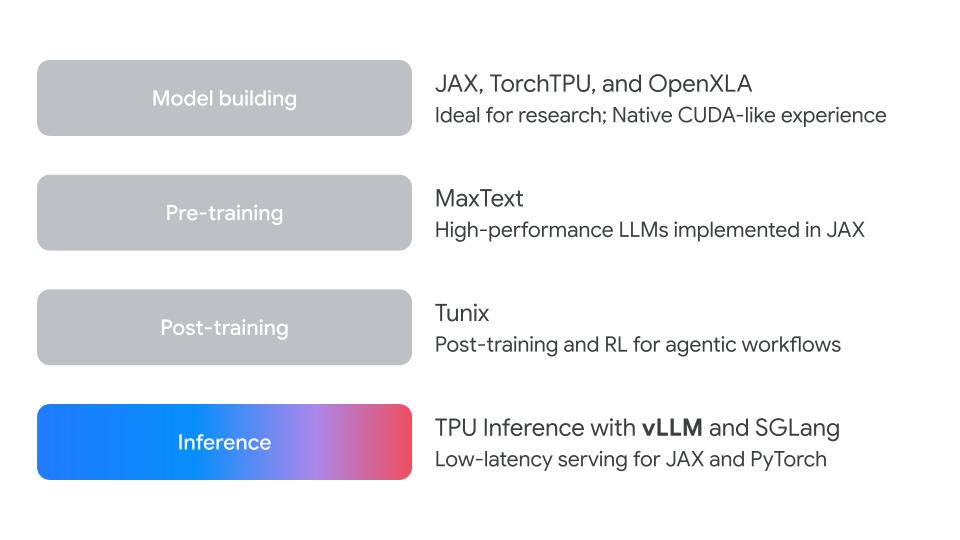
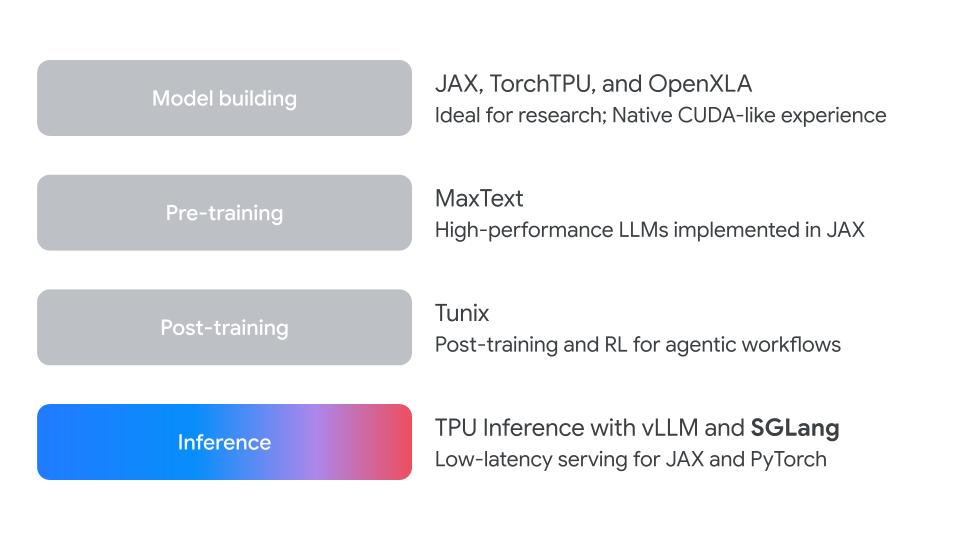
Lo stack software TPU è progettato per colmare il divario tra il codice di machine learning di alto livello e il silicio personalizzato per ottimizzare l'efficienza dell'hardware non elaborato.
JAX
Compila operazioni matematiche complesse a una velocità hardware quasi nativa sulle TPU. Questa libreria open source per il calcolo numerico e la differenziazione automatica si adatta facilmente a enormi cluster TPU distribuiti utilizzando una mesh di dispositivi esplicita.
TorchTPU e PyTorch
Esegui i workload PyTorch direttamente sulle TPU utilizzando la sintassi standard. TorchTPU è un backend PyTorch open source per TPU. Ti consente di addestrare, perfezionare e pubblicare modelli su Cloud TPU con il codice e gli strumenti che già utilizzi, senza modificare la semantica di PyTorch o imparare un'API specifica per TPU.
OpenXLA
Riduci i colli di bottiglia della compilazione per ottenere prestazioni elevate dall'hardware TPU. Questo compilatore di machine learning open source fonde automaticamente le operazioni, ottimizza la memoria utilizzata ed elimina l'overhead del framework per i calcoli di algebra lineare nei backend TPU.
MaxText
Riduci drasticamente i tempi di addestramento per i foundation model di grandi dimensioni. Questa implementazione di riferimento basata su JAX fornisce un progetto altamente scalabile e pronto all'uso per ottenere il massimo utilizzo dell'hardware durante il pre-addestramento degli LLM sulle TPU.
Tunix
Semplifica la post-formazione e l'allineamento degli LLM sull'infrastruttura TPU. Questa libreria JAX open source leggera offre workflow scalabili per il fine-tuning supervisionato (SFT) e il reinforcement learning (RL) per trasformare in modo efficiente i modelli non elaborati in agenti pronti per la produzione.
vLLM
Massimizza la contemporaneità di pubblicazione e riduci i costi operativi per l'inferenza TPU in tempo reale. Questo motore open source a throughput elevato sfrutta tecniche di gestione della memoria come PagedAttention per eliminare gli sprechi e offrire un'erogazione di LLM altamente efficiente sull'architettura TPU. Inferenza supportata per i modelli JAX e PyTorch su Cloud TPU.
SGLang
Framework di pubblicazione rapida per modelli linguistici di grandi dimensioni con esecuzione backend ottimizzata per Cloud TPU.
Le TPU supportano gli innovatori
Risorse aggiuntive
- Esegui workload per il pre-addestramento dell'AI su larga scalaRiduci le tempistiche di pre-addestramento per i foundation model di grandi dimensioni. TPU 8t fornisce potenza di calcolo ad alte prestazioni all'interno di un singolo pod e si scala utilizzando la rete Virgo. Abbinata a un accesso rapido allo spazio di archiviazione e all'isolamento NUMA basato su Axion, l'architettura raggiunge un goodput elevato, garantendo che i cicli di calcolo vengano impiegati per la creazione di modelli attivi anziché rimanere inattivi durante il trasferimento dei dati o i reset dell'hardware.Guida per gli sviluppatori all'addestramento con le TPU Ironwood
- Post-addestramento e apprendimento per rinforzo efficientiIntegra i modelli di base in agenti intelligenti attraverso flussi di lavoro di post-addestramento intensivi. L'ottava generazione del sistema TPU elabora rapidamente prove di apprendimento per rinforzo continuo, premiando i migliori percorsi di ragionamento senza i ritardi di ciclo comuni alle generazioni precedenti. In questo modo, puoi ottimizzare in modo efficiente i modelli del mondo, consentendo agli agenti di perfezionare il loro ragionamento in ambienti simulati prima di eseguirlo nel mondo reale.Post-addestramento MaxText
- Workload di inferenza AI a bassa latenza su larga scalaSupera il limite della memoria di inferenza. La TPU 8i espande la SRAM on-chip e la memoria ad alta larghezza di banda, ospitando cache KV ad alta capacità interamente su silicio. Utilizzando lo SparseCore-Collectives Acceleration Engine (SC-CAE) per l'offload delle attività di comunicazione globali, questa architettura riduce significativamente la latenza on-chip, liberando i core di calcolo principali per la generazione di token pura e a bassa latenza.Accelera l'inferenza AI con Google Cloud
- Virgo Network, la struttura di data center AI scale-out di GoogleVirgo Network è un fabric scale-out progettato per i requisiti estremi dei moderni workload di AI. Basato su switch ad alta radice che riducono i livelli di rete consentendo più porte per switch, utilizza una topologia non bloccante piatta a due livelli.Leggi l'articolo dell'annuncio
- Affidabilità a livello di cluster per modelli con trilioni di parametri su TPUDa oltre un decennio, Google gestisce cluster di Tensor Processing Unit (TPU) su larga scala, raggiungendo un'affidabilità che soddisfa i requisiti architetturali dei moderni carichi di lavoro di AI. In questo blog, presentiamo il nostro framework di affidabilità a livello di cluster per le TPU di Google Cloud, che si concentra sulle prestazioni collettive a livello di superpod e che utilizziamo internamente in Google per creare i modelli di AI più avanzati al mondo.Leggi l'articolo
- Progettare un'AI sostenibile con le TPUApprofondisci l'efficienza delle TPU e le emissioni del ciclo di vita. I nostri significativi miglioramenti nell'efficienza del carbonio dell'hardware si aggiungono ai rapidi progressi nella progettazione di modelli e algoritmi di AI.Leggi l'articolo
- Introduzione a Cloud TPUConsulta la documentazione di Cloud TPU per un'introduzione alle Tensor Processing Unit (TPU).rivedi la documentazione
- Architettura TPULa documentazione seguente descrive i componenti chiave dell'architettura cloud TPU.rivedi la documentazione
- Ricette TPURicette TPU Istruzioni per riprodurre un carico di lavoro specifico sulle TPU di Google Cloud.Leggi la guida
Casi d'uso tecnici
- Esegui workload per il pre-addestramento dell'AI su larga scalaRiduci le tempistiche di pre-addestramento per i foundation model di grandi dimensioni. TPU 8t fornisce potenza di calcolo ad alte prestazioni all'interno di un singolo pod e si scala utilizzando la rete Virgo. Abbinata a un accesso rapido allo spazio di archiviazione e all'isolamento NUMA basato su Axion, l'architettura raggiunge un goodput elevato, garantendo che i cicli di calcolo vengano impiegati per la creazione di modelli attivi anziché rimanere inattivi durante il trasferimento dei dati o i reset dell'hardware.Guida per gli sviluppatori all'addestramento con le TPU Ironwood
- Post-addestramento e apprendimento per rinforzo efficientiIntegra i modelli di base in agenti intelligenti attraverso flussi di lavoro di post-addestramento intensivi. L'ottava generazione del sistema TPU elabora rapidamente prove di apprendimento per rinforzo continuo, premiando i migliori percorsi di ragionamento senza i ritardi di ciclo comuni alle generazioni precedenti. In questo modo, puoi ottimizzare in modo efficiente i modelli del mondo, consentendo agli agenti di perfezionare il loro ragionamento in ambienti simulati prima di eseguirlo nel mondo reale.Post-addestramento MaxText
- Workload di inferenza AI a bassa latenza su larga scalaSupera il limite della memoria di inferenza. La TPU 8i espande la SRAM on-chip e la memoria ad alta larghezza di banda, ospitando cache KV ad alta capacità interamente su silicio. Utilizzando lo SparseCore-Collectives Acceleration Engine (SC-CAE) per l'offload delle attività di comunicazione globali, questa architettura riduce significativamente la latenza on-chip, liberando i core di calcolo principali per la generazione di token pura e a bassa latenza.Accelera l'inferenza AI con Google Cloud
Articoli
- Virgo Network, la struttura di data center AI scale-out di GoogleVirgo Network è un fabric scale-out progettato per i requisiti estremi dei moderni workload di AI. Basato su switch ad alta radice che riducono i livelli di rete consentendo più porte per switch, utilizza una topologia non bloccante piatta a due livelli.Leggi l'articolo dell'annuncio
- Affidabilità a livello di cluster per modelli con trilioni di parametri su TPUDa oltre un decennio, Google gestisce cluster di Tensor Processing Unit (TPU) su larga scala, raggiungendo un'affidabilità che soddisfa i requisiti architetturali dei moderni carichi di lavoro di AI. In questo blog, presentiamo il nostro framework di affidabilità a livello di cluster per le TPU di Google Cloud, che si concentra sulle prestazioni collettive a livello di superpod e che utilizziamo internamente in Google per creare i modelli di AI più avanzati al mondo.Leggi l'articolo
- Progettare un'AI sostenibile con le TPUApprofondisci l'efficienza delle TPU e le emissioni del ciclo di vita. I nostri significativi miglioramenti nell'efficienza del carbonio dell'hardware si aggiungono ai rapidi progressi nella progettazione di modelli e algoritmi di AI.Leggi l'articolo
Documentazione
- Introduzione a Cloud TPUConsulta la documentazione di Cloud TPU per un'introduzione alle Tensor Processing Unit (TPU).rivedi la documentazione
- Architettura TPULa documentazione seguente descrive i componenti chiave dell'architettura cloud TPU.rivedi la documentazione
- Ricette TPURicette TPU Istruzioni per riprodurre un carico di lavoro specifico sulle TPU di Google Cloud.Leggi la guida

Domande frequenti
Che cos'è una Tensor Processing Unit (TPU)?
Le TPU sono circuiti integrati specifici per le applicazioni (ASIC) progettati su misura e sviluppati da Google. Sono progettate appositamente da zero per accelerare i carichi di lavoro di machine learning e intelligenza artificiale. Le TPU sono ottimizzate specificamente per la moltiplicazione di matrici pesanti e le operazioni sui tensori che fungono da elementi costitutivi fondamentali delle reti neurali, alimentando tutto, dai modelli linguistici di grandi dimensioni agli agenti di ragionamento complessi.
Come funziona l'architettura TPU?
Il cuore di una TPU è un'unità di moltiplicazione a matrice (MXU) specializzata che elabora enormi quantità di operazioni con matrici contemporaneamente. Le TPU utilizzano un'architettura "systolic array" che legge i dati una sola volta e li fa fluire continuamente attraverso migliaia di unità logiche aritmetiche (ALU), accumulando risultati senza la necessità di leggere e scrivere costantemente nella memoria. Supportano anche l'aritmetica a precisione ridotta (come la rappresentazione in virgola mobile a 16 bit o 8 bit), consentendo milioni di calcoli al secondo senza sacrificare l'accuratezza richiesta per i modelli di AI.
Quali framework di machine learning sono supportati dalle Cloud TPU?
Le Cloud TPU offrono un supporto nativo ad alte prestazioni per i principali framework di machine learning, principalmente TensorFlow, PyTorch e JAX. Il codice scritto in questi framework viene compilato dal compilatore Accelerated Linear Algebra (XLA), che ottimizza automaticamente il grafico computazionale per essere eseguito in modo efficiente sull'hardware TPU sottostante.
Quali tipi di workload sono più adatti alle TPU?
Le TPU eccellono nelle attività di deep learning che richiedono operazioni parallele su matrici di grandi dimensioni. Sono altamente consigliati per:
- Modelli dominati da calcoli matriciali
- Esecuzioni di addestramento che richiedono settimane o mesi per convergere
- Modelli di base di grandi dimensioni e modelli linguistici di grandi dimensioni (LLM)
- Workload con incorporamenti di dimensioni molto grandi, come i motori di consigli avanzati
- Apprendimento per rinforzo continuo e inferenza ad alto volume e bassa latenza
Cosa sono i pod e le slice TPU?
Un pod di TPU è un enorme cluster fisico di chip TPU collegati tra loro tramite una rete specializzata ad alta velocità (come la rete Optical Circuit Switching o Virgo di Google). Un singolo superpod può contenere migliaia di chip interconnessi. Una "slice" è un sottoinsieme più piccolo e dedicato di un pod che puoi affittare. Questa architettura di rete consente agli sviluppatori di scalare i propri carichi di lavoro di AI su enormi quantità di calcolo con poche o nessuna modifica al codice, gestendo in modo efficace l'intera sezione come una singola macchina unificata.
Che cos'è il "goodput" di ML nel contesto dell'addestramento TPU?
Il Goodput si riferisce al tempo effettivo e produttivo che l'infrastruttura dedica all'addestramento attivo del modello, anziché all'inattività. L'addestramento di modelli di base di grandi dimensioni comporta un'orchestrazione complessa su migliaia di chip, il che significa che i cicli di calcolo possono essere facilmente sprecati a causa di ritardi nel trasferimento dei dati, ripristini dell'hardware o creazione di checkpoint. Le Cloud TPU sono progettate per massimizzare il goodput attraverso interconnessioni a larghezza di banda elevata e memorizzazione nella cache ottimizzata, garantendo che i cicli di calcolo a pagamento contribuiscano direttamente all'avanzamento del modello.
Come viene gestita l'orchestrazione su larga scala per le TPU?
Gli utenti possono supportare l'affidabilità, il monitoraggio completo e la gestione utilizzando Google Kubernetes Engine (GKE) e Cluster Director. Sfruttando GKE per TPU, i clienti operano in un ecosistema cloud-native dotato di Inference Gateway per il bilanciamento del carico e della capacità di scalare i deployment fino a 130.000 nodi GKE.
Qual è l'attuale panorama del software di inferenza per TPU?
Le Cloud TPU supportano l'erogazione di LLM ad alto throughput e bassa latenza principalmente attraverso i più diffusi motori di erogazione open source: vLLM e SGLang:
- vLLM: si integra con Cloud TPU tramite il pacchetto vllm-tpu per gestire i modelli JAX e vllm-torchtpu per i modelli Torch.
- SGLang: offre un servizio TPU ad alte prestazioni utilizzando il suo backend JAX dedicato (sglang-jax) e uno separato per Torch (sglang-torch).
Entrambi i progetti forniscono librerie ottimizzate e specifiche per i pacchetti, su misura per l'hardware TPU, al fine di massimizzare l'efficienza di pubblicazione. Per le guide alla configurazione, consulta la documentazione sull'inferenza di Cloud TPU.











