メダリオン アーキテクチャとは
メダリオン アーキテクチャは、データレイクまたはレイクハウスでデータを整理するために使用されるデータ設計パターンです。その主な役割は、さまざまな段階を経ながら、データの品質と構造を改善していくことです。このフレームワークでは、データを積み上げてひとつの巨大な山にするのではなく、レイヤに分割します。レイヤごとに価値を高めることで、データの信頼性を向上させ、ビジネス上の意思決定に活用しやすくします。
これは、特定のソフトウェアではなく、論理的なフレームワークです。チームが ACID(原子性、一貫性、独立性、永続性)トランザクションを確保しながらデータ パイプラインを管理できるように設計されています。データがこのような検証階層を経ることで、企業は、大量の未加工の情報を扱う場合でも、情報が正確かつ安全であると確信できます。
メダリオン アーキテクチャと従来のデータ ウェアハウジング
従来、データ ウェアハウスでは「スキーマオンライト」のアプローチが使用されていました。つまり、データを保存する前に、データの構造を完全に定義する必要がありました。これにより整理はできましたが、多くの場合、処理が遅く柔軟性に欠けていました。データ形式が少しでも変更されると、エンジニアが手動で修正するまでシステム全体が停止する可能性があります。
メダリオン アーキテクチャは、元データレイヤで「スキーマオンリード」を採用する最新のレイクハウス パラダイムに従っています。これにより、データは未加工の形式で即座に保存されます。データのビジネス価値が明確になったときにのみ、構造に配慮すればよいのです。これは、企業がデータを収集し、後でその使用方法を正確に決定できる、より柔軟な作業方法です。
メダリオン アーキテクチャの 3 つのレイヤ
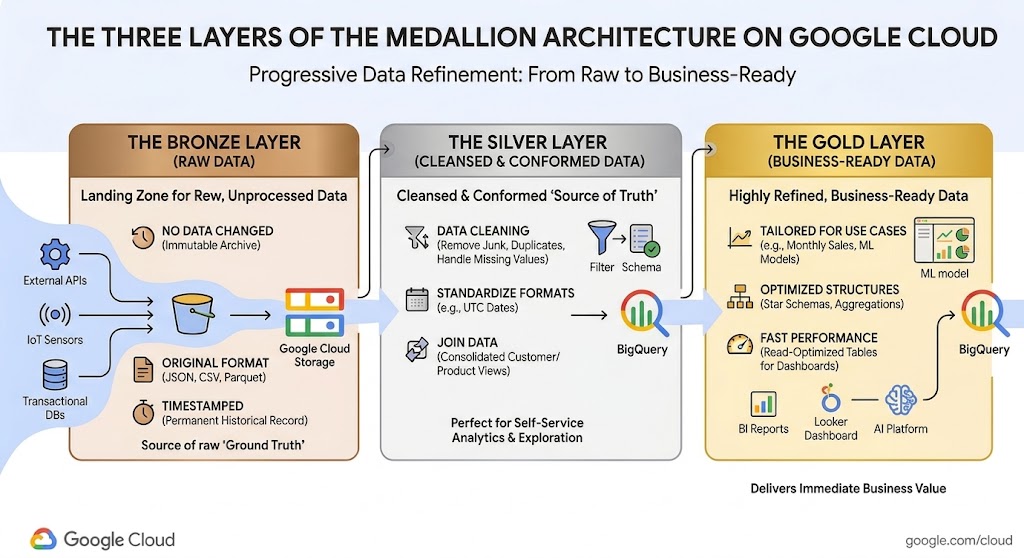
メダリオン アーキテクチャでは、データはブロンズ、シルバー、ゴールドの 3 つの主要なステージを川のように流れます。データは、ステージを移動するにつれて、よりクリーンで整理されたものになります。この設定により、エンジニアは早い段階で間違いを修正でき、さまざまなユーザーがそれぞれのタスクに適したバージョンのデータを利用できます。
ブロンズレイヤ(元データ)
ブロンズレイヤは、すべての受信データのランディング ゾーンです。ここでは、ウェブ API、IoT センサー、トランザクション データベースなどのソースから得られた未加工かつ未処理の情報を保存します。ここではデータを変更せず、JSON、CSV、Parquet などの元の形式のまま保持します。
エンジニアは通常、これらのファイルにタイムスタンプを追加して、到着時刻を示します。ブロンズレイヤは、永続的な履歴アーカイブとして機能します。後で計算を間違えた場合は、いつでもこの元データに戻ってやり直すことができます。これにより、ビジネス オペレーションの「グラウンド トゥルース」を失うことがなくなります。
シルバーレイヤ(クレンジングおよび適合化されたデータ)
シルバー レイヤは「信頼できる情報源」と考えることができます。この段階では、ブロンズレイヤのデータが徹底的にクリーニングされます。エンジニアはツールを使用して、ジャンクを除外したり、重複するレコードを削除したり、欠損値を修正したりします。また、すべての日付が同じパターンに従っていることを確認するなど、形式を標準化します。
シルバー レイヤは、さまざまなデータセットを結合して、「顧客」や「商品」などのコアビジネス アイテムを明確に表示します。このレイヤはセルフサービス分析に最適です。ほとんどの人が使用できるほどクリーンですが、1 つの特定のレポートに限定されることなく、幅広い質問に回答できるほど詳細です。
ゴールドレイヤ(ビジネス対応データ)
ゴールド レイヤには、最も精製されたデータが含まれています。この情報は、月次売上レポートや顧客離れの予測を行う ML モデルなど、特定のビジネスニーズに合わせて調整されます。ゴールドレイヤでは、未加工のリストではなく、高速な読み取りのために最適化された「スタースキーマ」またはテーブルがよく使用されます。
このデータはすでに集計、計算されているため、ダッシュボードに非常に迅速に読み込まれます。データ サイエンティストは、ゴールドテーブルを使用して「地域ごとの 1 日のアクティブ ユーザー数」を確認できます。数百万の未加工の行を自分で結合する必要はありません。これは、企業に即座に価値をもたらすように設計された最終的なプロダクトです。
メダリオン アーキテクチャの主なメリット
階層化されたアプローチを使用することで、チームはより迅速に作業を進め、大きな損害をもたらすミスのリスクを軽減できます。データの処理方法に関する明確なロードマップが提供されるため、会社が成長するにつれてシステム全体の管理が容易になります。
データ品質の向上
データ品質の向上
データ パイプラインを個別のステップに分割することで、デバッグが大幅に簡素化されます。ダッシュボードに誤った数値が表示された場合、エンジニアはまずシルバーレイヤを確認できます。シルバーデータが正しい場合、エラーはゴールド変換ロジックにあることがわかります。この分離により、チームはバグを数時間ではなく数分で発見して修正できるため、データフローの安定性と信頼性を維持できます。
タイムトラベルと再現性
タイムトラベルと再現性
ブロンズレイヤに完全な履歴を保持することで、組織はいつでもデータプロセス全体を再実行できます。これは、ビジネスルールが変更された場合に役立ちます。たとえば、財務チームが「利益」の計算方法を変更した場合、古いデータをすべて再処理して新しいルールに合わせることができます。この「タイムトラベル」は監査にも役立ちます。過去の任意の時点のデータがどのようなものであったかを正確に証明できるからです。
データアクセスの民主化
データアクセスの民主化
企業内のさまざまな人が、さまざまな種類のデータを必要としています。データ サイエンティストは、複雑な AI モデルをトレーニングするために、ブロンズレイヤの元データを必要とすることがよくあります。一方、ビジネス アナリストは、グラフ作成のために、ゴールドレイヤから無駄を取り除き完成した数値だけを取得したがっています。メダリオン アーキテクチャにより、誰もが互いに邪魔することなく、必要な特定のレイヤにアクセスできます。
メダリオン アーキテクチャを実装する方法
このアーキテクチャを構築するには、ストレージとコンピューティング ツール間でデータを移動するための明確な計画が必要です。信頼できるパイプラインを構築するには、次の 4 つのステップに従います。
ステップ 1: ブロンズへの取り込み
まず、ソースからスケーラブルなストレージ領域にデータを移動するための自動化されたパイプラインを設定します。リアルタイム データには Dataflow などのツールを、日次更新にはバッチ読み込みを使用できます。ここでの目標は、データを変更せずに「バケット」にダンプすることです。これにより、移行中に情報が失われたり、誤って変更されたりすることがなくなります。 |
まず、ソースからスケーラブルなストレージ領域にデータを移動するための自動化されたパイプラインを設定します。リアルタイム データには Dataflow などのツールを、日次更新にはバッチ読み込みを使用できます。ここでの目標は、データを変更せずに「バケット」にダンプすることです。これにより、移行中に情報が失われたり、誤って変更されたりすることがなくなります。
ステップ 2: シルバーへの変換
次に、Apache Spark や SQL などの処理エンジンを使用して、未加工のブロンズデータをクリーンアップします。このステップでは、データ品質ルールを適用します。たとえば、すべてのタイムスタンプを UTC などの標準タイムゾーンに変換したり、ユーザーリストからテスト アカウントを削除したりします。多くのチームは、これらの結果を Delta Lake や Apache Iceberg などのオープン テーブル形式に書き込み、データを整理して検索可能な状態にしています。 |
次に、Apache Spark や SQL などの処理エンジンを使用して、未加工のブロンズデータをクリーンアップします。このステップでは、データ品質ルールを適用します。たとえば、すべてのタイムスタンプを UTC などの標準タイムゾーンに変換したり、ユーザーリストからテスト アカウントを削除したりします。多くのチームは、これらの結果を Delta Lake や Apache Iceberg などのオープン テーブル形式に書き込み、データを整理して検索可能な状態にしています。
ステップ 3: ゴールドへの集計
シルバーレイヤでデータがクリーンになったら、専用の SQL クエリを作成してゴールド テーブルを構築できます。これらのクエリは、さまざまなテーブルを結合して、「カテゴリ別の収益」などの特定の指標を作成します。これらのデータは、Looker などの可視化ツールに直接接続できる、パフォーマンスの高いビューに保存されることがよくあります。 |
シルバーレイヤでデータがクリーンになったら、専用の SQL クエリを作成してゴールド テーブルを構築できます。これらのクエリは、さまざまなテーブルを結合して、「カテゴリ別の収益」などの特定の指標を作成します。これらのデータは、Looker などの可視化ツールに直接接続できる、パフォーマンスの高いビューに保存されることがよくあります。
ステップ 4: オーケストレーションとガバナンス
最後に、これらのステップを自動的に実行するためのスケジュールを設定する手段が必要です。Google Cloud Managed Service for Apache Airflow などのツールを使用すると、ジョブのタイミングを管理できます。また、厳格なセキュリティ ポリシーを適用する必要があります。たとえば、ゴールド レイヤは誰でも読み取れるようにする一方で、シルバー レイヤとゴールドレイヤのデータの書き込みや変更は、承認された一部のサービス アカウントのみに許可するといったことが可能です。 |
最後に、これらのステップを自動的に実行するためのスケジュールを設定する手段が必要です。Google Cloud Managed Service for Apache Airflow などのツールを使用すると、ジョブのタイミングを管理できます。また、厳格なセキュリティ ポリシーを適用する必要があります。たとえば、ゴールド レイヤは誰でも読み取れるようにする一方で、シルバー レイヤとゴールドレイヤのデータの書き込みや変更は、承認された一部のサービス アカウントのみに許可するといったことが可能です。
Google Cloud でメダリオン アーキテクチャを構築する
Google Cloud には、メダリオン アーキテクチャの実装を容易にする強力なツールセットが用意されています。これらのサービスは、スケーリングとセキュリティの重い作業を処理するため、チームはデータから分析情報を得ることに集中できます。
 Cloud Storageこのサービスは、あらゆる形式の元データに対して低コストで耐久性の高いストレージを提供することで、ブロンズ ランディング ゾーンとして機能します。
 BigQueryこのサーバーレス ウェアハウスは、シルバーレイヤとゴールドレイヤのエンジンとして機能し、高速な SQL クエリを実行してデータをクリーンアップし、集計します。
 Google Cloud レイクハウスデータレイクとデータ ウェアハウスの両方で、Apache Iceberg などのオープン テーブル形式を、統合されたガバナンスで管理できます。
- Managed Service for Apache Sparkデータがメダリオン レイヤ間を移動する際に、オープンソースの Apache Spark を使用してデータを処理、クリーニング、変換するフルマネージド サービス。
- Dataflowストリーミング データをリアルタイムで処理し、情報が作成されるとすぐにその情報をアーキテクチャ レイヤに移動します。
- Dataformこのツールを使用すると、アナリストは SQL を使用して、シルバーデータをゴールドに変換する複雑なデータ変換を構築し、スケジュール設定できます。
開始にあたりサポートが必要な場合
お問い合わせ信頼できるパートナーと連携する
パートナーを探すもっと見る
すべてのプロダクトを見る