메달리온 아키텍처란 무엇인가요?
메달리온 아키텍처는 데이터 레이크 또는 레이크하우스에서 데이터를 구성하는 데 사용되는 데이터 설계 패턴입니다. 주요 작업은 데이터가 여러 단계를 거치면서 데이터의 품질과 구조를 개선하는 것입니다. 하나의 거대한 데이터 더미 대신 데이터를 여러 레이어로 나눕니다. 각 레이어는 더 많은 가치를 더하여 비즈니스 의사 결정에 더 안정적이고 사용하기 쉬운 데이터를 만듭니다.
특정 소프트웨어가 아닌 논리적 프레임워크입니다. 팀이 ACID(원자성, 일관성, 격리, 내구성) 트랜잭션을 보장하면서 데이터 파이프라인을 관리할 수 있도록 설계되었습니다. 기업은 이러한 검증 계층을 통해 데이터를 이동시켜 방대한 양의 원시 정보를 처리할 때도 정보가 정확하고 안전하다는 것을 신뢰할 수 있습니다.
메달리온 아키텍처와 기존 데이터 웨어하우징 비교
과거에는 기존 데이터 웨어하우스가 '쓰기 시 스키마' 접근방식을 사용했습니다. 즉, 데이터를 저장하기 전에 데이터의 구조를 완벽하게 정의해야 했습니다. 이러한 방식은 체계적이었지만 종종 느리고 경직되었습니다. 데이터 형식이 약간만 변경되어도 엔지니어가 수동으로 수정할 때까지 전체 시스템이 작동하지 않을 수 있습니다.
메달리온 아키텍처는 원시 데이터 레이어에서 '읽기 시 스키마'를 수용하는 최신 레이크하우스 패러다임을 따릅니다. 이를 통해 데이터가 원시 형태로 즉시 저장됩니다. 데이터의 비즈니스 가치가 명확해지면 구조만 신경쓰면 됩니다. 이는 기업이 지금 데이터를 수집하고 나중에 정확히 어떻게 사용할지 결정할 수 있는 보다 유연한 작업 방식입니다.
메달리온 아키텍처의 세 가지 레이어
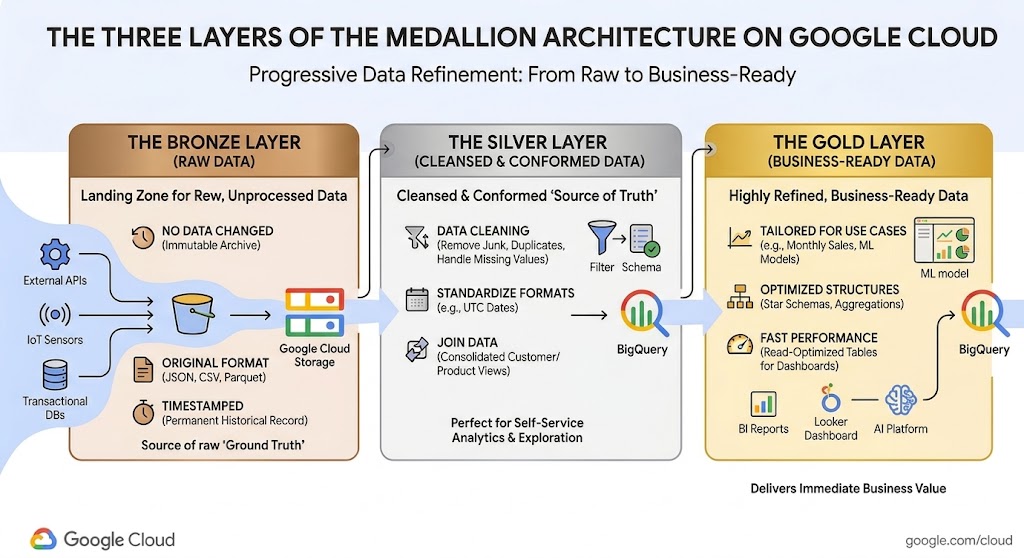
메달리온 아키텍처에서 데이터는 브론즈, 실버, 골드의 세 가지 주요 단계를 거치며 강물처럼 흐릅니다. 데이터는 한 단계에서 다음 단계로 이동하면서 더 정리되고 정제됩니다. 이러한 설정 덕분에 엔지니어는 실수를 조기에 수정할 수 있으며, 다양한 사용자는 특정 작업에 적합한 버전의 데이터를 사용할 수 있습니다.
브론즈 레이어(원시 데이터)
브론즈 레이어는 모든 수신 데이터의 시작 영역입니다. 웹 API, IoT 센서, 트랜잭션 데이터베이스와 같은 소스에서 가져온 처리되지 않은 원시 정보를 저장하는 곳입니다. 여기서는 데이터를 변경하지 않고 JSON, CSV, Parquet 등의 원래 형식으로 유지합니다.
엔지니어는 일반적으로 이러한 파일에 타임스탬프를 추가하여 도착 시간을 표시합니다. 브론즈 레이어는 영구적인 이전 기록 보관소 역할을 합니다. 나중에 계산에 실수가 있었다는 것을 알게 되면 언제든지 이 원시 데이터로 돌아가서 다시 시작할 수 있습니다. 비즈니스 운영의 '기준이 되는 사실'을 절대 놓치지 않도록 보장합니다.
실버 레이어(정리 및 표준화된 데이터)
실버 레이어를 '정보 소스'라고 생각하면 됩니다. 이 단계에서는 브론즈 레이어의 데이터를 철저하게 정리합니다. 엔지니어는 도구를 사용하여 정크를 필터링하고, 중복 레코드를 삭제하고, 누락된 값을 수정합니다. 또한 모든 날짜가 동일한 패턴을 따르도록 하는 등 형식을 표준화합니다.
실버 레이어는 '고객' 또는 '제품'과 같은 핵심 비즈니스 항목을 명확하게 파악할 수 있도록 다양한 데이터 세트를 결합합니다. 이 레이어는 셀프서비스 분석에 적합합니다. 대부분의 사용자가 사용할 수 있을 만큼 깔끔하면서도 하나의 특정 보고서에 국한되지 않고 다양한 질문에 답할 수 있을 만큼 충분히 상세합니다.
골드 레이어(비즈니스용 데이터)
골드 레이어에는 가장 정제된 데이터가 포함되어 있습니다. 이 정보는 월간 판매 보고서 또는 고객 이탈을 예측하는 머신러닝 모델과 같은 특정 비즈니스 요구사항에 맞게 조정됩니다. 골드 레이어는 원시 목록 대신 종종 '별표 스키마' 또는 빠른 읽기를 위해 최적화된 테이블을 사용합니다.
이 데이터는 이미 집계되고 계산되었기 때문에 대시보드에 매우 빠르게 로드됩니다. 데이터 과학자는 수백만 개의 원시 행을 직접 조인할 필요 없이 골드 테이블을 사용하여 '리전별 일일 활성 사용자'를 확인할 수 있습니다. 이는 회사에 즉각적인 가치를 제공하도록 설계된 최종 제품입니다.
메달리온 아키텍처의 주요 이점
다층적인 접근방식을 사용하면 팀이 더 빠르게 움직일 수 있고 비용이 많이 드는 실수를 저지를 위험을 줄일 수 있습니다. 데이터 처리 방법에 대한 명확한 로드맵을 제공하므로 회사가 성장함에 따라 전체 시스템을 더 쉽게 관리할 수 있습니다.
증분 데이터 품질
증분 데이터 품질
데이터 파이프라인을 개별 단계로 나누면 디버깅이 훨씬 간단해집니다. 대시보드에 잘못된 숫자가 표시되면 엔지니어는 먼저 실버 레이어를 확인할 수 있습니다. 실버 데이터가 올바르다면 오류가 골드 변환 로직에 있다는 것을 알 수 있습니다. 이러한 격리를 통해 팀은 몇 시간이 아닌 몇 분 만에 버그를 찾아 수정하여 데이터 흐름을 안정적이고 신뢰할 수 있게 유지할 수 있습니다.
시간 이동 및 재현 가능성
시간 이동 및 재현 가능성
조직은 브론즈 레이어에 전체 기록을 보관하여 언제든지 전체 데이터 프로세스를 다시 실행할 수 있습니다. 비즈니스 규칙이 변경되는 경우에 유용합니다. 예를 들어 재무팀에서 '이익'을 계산하는 방식을 변경하는 경우 모든 이전 데이터를 다시 처리하여 새 규칙에 맞출 수 있습니다. 이러한 '시간 이동'은 감사에도 도움이 됩니다. 과거의 어느 시점에서든 데이터가 정확히 어떤 모습이었는지 증명할 수 있기 때문입니다.
데이터 액세스 범용화
데이터 액세스 범용화
회사 내의 다양한 사람들에게는 다양한 유형의 데이터가 필요합니다. 데이터 과학자는 복잡한 AI 모델을 학습시키기 위해 브론즈 레이어의 원시 데이터를 원하는 경우가 많습니다. 한편 비즈니스 분석가는 차트를 작성하기 위해 골드 레이어에서 정리된 최종 수치만 원합니다. 메달리온 아키텍처를 사용하면 서로 방해하지 않고 필요한 특정 레이어에 액세스할 수 있습니다.
메달리온 아키텍처를 구현하는 방법
이 아키텍처를 빌드하려면 스토리지와 컴퓨팅 도구 간에 데이터를 이동하기 위한 명확한 계획이 필요합니다. 이 4단계를 따르면 안정적인 파이프라인을 설정할 수 있습니다.
1단계: 브론즈로 수집
먼저 소스에서 확장 가능한 스토리지 영역으로 데이터를 이동하는 자동화된 파이프라인을 설정합니다. 실시간 데이터에는 Dataflow와 같은 도구를 사용하거나 일일 업데이트에는 일괄 로드를 사용할 수 있습니다. 여기서 목표는 데이터를 변경하지 않고 '버킷'에 덤프하는 것입니다. 이렇게 하면 데이터 이동 중에 정보가 누락되거나 실수로 변경되지 않습니다. |
먼저 소스에서 확장 가능한 스토리지 영역으로 데이터를 이동하는 자동화된 파이프라인을 설정합니다. 실시간 데이터에는 Dataflow와 같은 도구를 사용하거나 일일 업데이트에는 일괄 로드를 사용할 수 있습니다. 여기서 목표는 데이터를 변경하지 않고 '버킷'에 덤프하는 것입니다. 이렇게 하면 데이터 이동 중에 정보가 누락되거나 실수로 변경되지 않습니다.
2단계: 실버로 변환
다음으로 Apache Spark 또는 SQL과 같은 처리 엔진을 사용하여 원시 브론즈 데이터를 정리합니다. 이 단계에서는 데이터 품질 규칙을 적용합니다. 모든 타임스탬프를 UTC와 같은 표준 시간대로 변환하거나 사용자 목록에서 테스트 계정을 삭제할 수 있습니다. 많은 팀이 이러한 결과를 Delta Lake 또는 Apache Iceberg와 같은 개방형 테이블 형식으로 작성하여 데이터를 체계적으로 정리하고 검색 가능하게 유지합니다. |
다음으로 Apache Spark 또는 SQL과 같은 처리 엔진을 사용하여 원시 브론즈 데이터를 정리합니다. 이 단계에서는 데이터 품질 규칙을 적용합니다. 모든 타임스탬프를 UTC와 같은 표준 시간대로 변환하거나 사용자 목록에서 테스트 계정을 삭제할 수 있습니다. 많은 팀이 이러한 결과를 Delta Lake 또는 Apache Iceberg와 같은 개방형 테이블 형식으로 작성하여 데이터를 체계적으로 정리하고 검색 가능하게 유지합니다.
3단계: 골드로 집계
실버 레이어에서 데이터가 정리되면 특화된 SQL 쿼리를 만들어 골드 테이블을 빌드할 수 있습니다. 이러한 쿼리는 서로 다른 테이블을 조인하여 '카테고리별 수익'과 같은 특정 측정항목을 생성합니다. 이러한 데이터는 Looker와 같은 시각화 도구에 직접 연결할 수 있는 고성능 뷰에 저장되는 경우가 많습니다. |
실버 레이어에서 데이터가 정리되면 특화된 SQL 쿼리를 만들어 골드 테이블을 빌드할 수 있습니다. 이러한 쿼리는 서로 다른 테이블을 조인하여 '카테고리별 수익'과 같은 특정 측정항목을 생성합니다. 이러한 데이터는 Looker와 같은 시각화 도구에 직접 연결할 수 있는 고성능 뷰에 저장되는 경우가 많습니다.
4단계: 조정 및 거버넌스
마지막으로 이러한 단계가 자동으로 실행되도록 예약하는 방법이 필요합니다. Google Cloud Managed Service for Apache Airflow와 같은 도구는 작업의 타이밍을 관리할 수 있습니다. 엄격한 보안 정책도 적용해야 합니다. 예를 들어 모든 사용자가 골드 레이어를 읽을 수 있도록 허용하되, 실버 및 골드 등급의 데이터를 작성하거나 변경할 수 있는 권한은 몇몇 승인된 서비스 계정에만 부여합니다. |
마지막으로 이러한 단계가 자동으로 실행되도록 예약하는 방법이 필요합니다. Google Cloud Managed Service for Apache Airflow와 같은 도구는 작업의 타이밍을 관리할 수 있습니다. 엄격한 보안 정책도 적용해야 합니다. 예를 들어 모든 사용자가 골드 레이어를 읽을 수 있도록 허용하되, 실버 및 골드 등급의 데이터를 작성하거나 변경할 수 있는 권한은 몇몇 승인된 서비스 계정에만 부여합니다.
Google Cloud에서 메달리온 아키텍처 빌드
Google Cloud는 메달리온 아키텍처를 간단하게 구현할 수 있는 강력한 도구 모음을 제공합니다. 이러한 서비스는 확장 및 보안과 관련된 복잡한 작업을 처리하므로 팀은 데이터에서 인사이트를 얻는 데 집중할 수 있습니다.
 Cloud Storage이 서비스는 모든 형식의 원시 데이터에 대해 저렴하고 내구성이 뛰어난 스토리지를 제공하여 브론즈 시작 영역 역할을 합니다.
 BigQuery이 서버리스 웨어하우스는 실버 및 골드 레이어의 엔진 역할을 하며 빠른 SQL 쿼리를 실행하여 데이터를 정리하고 집계합니다.
 Google Cloud 레이크하우스통합 거버넌스를 통해 데이터 레이크와 웨어하우스 전반에서 Apache Iceberg와 같은 개방형 테이블 형식을 관리할 수 있습니다.
- Managed Service for Apache Spark오픈소스 Apache Spark를 사용하여 메달리온 레이어 간에 이동하는 데이터를 처리, 정리, 변환하는 완전 관리형 서비스입니다.
- Dataflow스트리밍 데이터를 실시간으로 처리하여 정보가 생성되는 즉시 아키텍처 레이어로 이동하도록 보장합니다.
- Dataform이 도구를 사용하면 분석가가 SQL을 사용하여 실버 데이터를 골드 데이터로 전환하는 복잡한 데이터 변환을 빌드하고 예약할 수 있습니다.