Che cos'è l'architettura medallion?
L'architettura medallion è un modello di progettazione dei dati utilizzato per organizzare i dati in un data lake o in una lakehouse. Il suo compito principale è migliorare la qualità e la struttura dei dati man mano che passano attraverso diverse fasi. Invece di avere un unico enorme insieme di dati, questo framework li suddivide in strati. Ogni strato aggiunge più valore, rendendo i dati più affidabili e più facili da usare per le decisioni aziendali.
Si tratta di un framework logico piuttosto che di un software specifico. È progettato per aiutare i team a gestire le pipeline di dati garantendo al contempo transazioni ACID (atomicità, coerenza, isolamento e durabilità). Spostando i dati attraverso questi livelli di convalida, le aziende possono avere la certezza che le loro informazioni siano accurate e sicure, anche quando si tratta di enormi quantità di informazioni non elaborate.
Architettura Medallion e data warehousing tradizionale
In passato, i data warehouse tradizionali utilizzavano un approccio "schema-on-write". Ciò significava che dovevi definire perfettamente la struttura dei tuoi dati prima di poterli salvare. Sebbene questo approccio garantisse l'organizzazione, spesso risultava lento e rigido. Se il formato dei dati cambiava leggermente, l'intero sistema poteva smettere di funzionare finché un tecnico non lo riparava manualmente.
L'architettura medallion segue il moderno paradigma lakehouse, che adotta lo "schema-on-read" nel livello dei dati non elaborati. Ciò consente ai dati di arrivare immediatamente nella loro forma non elaborata. Ti preoccupi della struttura solo quando il valore aziendale dei dati diventa chiaro. È un modo di lavorare più flessibile che consente alle aziende di raccogliere i dati ora e decidere esattamente come utilizzarli in seguito.
I tre livelli dell'architettura medallion
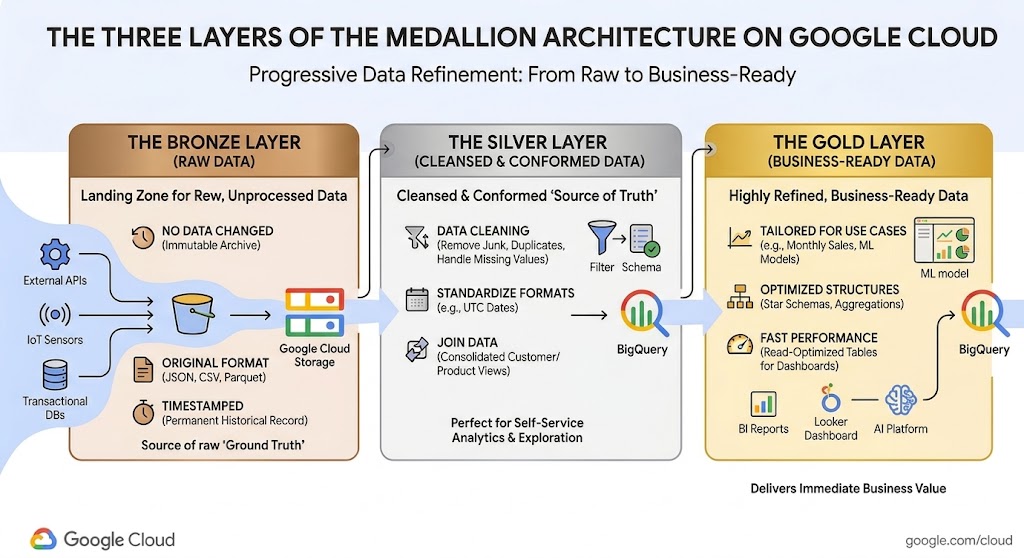
In un'architettura a medaglioni, i dati scorrono come un fiume attraverso tre fasi principali: bronzo, argento e oro. Man mano che passa da una fase all'altra, i dati diventano più puliti e organizzati. Questa configurazione consente agli ingegneri di correggere gli errori in anticipo e fornisce a diversi utenti la versione corretta dei dati per le loro attività specifiche.
Il livello bronze (bronzo) (dati non elaborati)
Il livello bronze è la zona di destinazione per tutti i dati in entrata. È qui che vengono archiviate le informazioni non elaborate provenienti da fonti come API web, sensori IoT o database transazionali. Qui non modifichi i dati, li mantieni nel loro formato originale, come JSON, CSV o Parquet.
Gli ingegneri di solito aggiungono un timestamp a questi file per mostrare quando sono arrivati. Il livello bronzeo funge da archivio storico permanente. Se in seguito commetti un errore nei calcoli, puoi sempre tornare a questi dati non elaborati e ricominciare da capo. Ti assicura di non perdere mai la "verità di base" delle tue operazioni aziendali.
Il livello silver (argento) (dati puliti e conformi)
Considera lo strato silver come la tua "fonte attendibile". In questa fase, i dati dello strato bronze vengono puliti a fondo. Gli ingegneri utilizzano strumenti per filtrare i dati inutili, rimuovere i record duplicati e correggere i valori mancanti. Inoltre, standardizzano i formati, ad esempio assicurandosi che ogni data segua lo stesso schema.
Il livello silver unisce diversi set di dati per creare una visione chiara degli elementi aziendali principali, come "clienti" o "prodotti". Questo livello è perfetto per l'analisi self-service. È abbastanza semplice da usare per la maggior parte delle persone, ma è comunque abbastanza dettagliato da rispondere a un'ampia varietà di domande senza limitarsi a un solo report specifico.
Il livello gold ()oro (dati pronti per l'uso aziendale)
Lo strato gold contiene i dati più raffinati. Queste informazioni sono personalizzate per esigenze aziendali specifiche, come un report sulle vendite mensili o un modello di machine learning che prevede l'abbandono dei clienti. Invece di elenchi non elaborati, il livello gold utilizza spesso "schemi a stella" o tabelle ottimizzate per una lettura rapida.
Poiché questi dati sono già aggregati e calcolati, vengono caricati molto rapidamente nelle dashboard. Un data scientist potrebbe utilizzare una tabella gold per visualizzare gli "Utenti attivi giornalieri per regione" senza dover unire milioni di righe non elaborate. È il prodotto finale progettato per fornire valore immediato all'azienda.
Vantaggi principali dell'architettura medallion
L'utilizzo di un approccio a strati aiuta i team a muoversi più velocemente e riduce il rischio di commettere errori costosi. Fornisce una roadmap chiara su come devono essere gestiti i dati, il che rende l'intero sistema più facile da gestire man mano che l'azienda cresce.
Qualità dei dati incrementale
Qualità dei dati incrementale
La suddivisione delle pipeline di dati in passaggi distinti semplifica notevolmente il debug. Se una dashboard mostra un numero errato, un tecnico può controllare prima lo strato silver. Se i dati silver sono corretti, sanno che l'errore si trova nella logica di trasformazione gold. Questo isolamento aiuta i team a trovare e correggere i bug in pochi minuti anziché in ore, mantenendo il flusso di dati costante e affidabile.
Spostamento cronologico e riproducibilità
Spostamento cronologico e riproducibilità
Mantenendo una cronologia completa nel livello bronze, le organizzazioni possono rieseguire l'intero processo di dati ogni volta che lo desiderano. Questo è utile se le regole aziendali cambiano. Ad esempio, se il team finanziario cambia il modo in cui calcola il "profitto", puoi rielaborare tutti i tuoi vecchi dati in modo che corrispondano alla nuova regola. Questo "viaggio nel tempo" è utile anche per gli audit, in quanto puoi dimostrare esattamente come apparivano i dati in qualsiasi momento del passato.
Accesso ai dati democratizzato
Accesso ai dati democratizzato
Persone diverse in un'azienda hanno bisogno di tipi di dati diversi. I data scientist spesso vogliono i dati non elaborati dello strato bronze per addestrare modelli di AI complessi. Nel frattempo, gli analisti aziendali vogliono solo i numeri puliti e finiti dello strato gold per i loro grafici. L'architettura a medaglione consente a tutti di accedere al livello specifico di cui hanno bisogno senza ostacolarsi a vicenda.
Come implementare un'architettura medallion
La creazione di questa architettura richiede un piano chiaro per lo spostamento dei dati tra gli strumenti di archiviazione e di calcolo. Puoi seguire questi quattro passaggi per configurare una pipeline affidabile.
Passaggio 1: importazione in bronze (bronzo)
Innanzitutto, configura pipeline automatizzate per spostare i dati dalle tue origini in un'area di archiviazione scalabile. Puoi utilizzare strumenti come Dataflow per i dati in tempo reale o i carichi in batch per gli aggiornamenti giornalieri. L'obiettivo è quello di scaricare i dati in "bucket" senza modificarli. In questo modo, nessuna informazione viene persa o alterata accidentalmente durante il trasferimento. |
Innanzitutto, configura pipeline automatizzate per spostare i dati dalle tue origini in un'area di archiviazione scalabile. Puoi utilizzare strumenti come Dataflow per i dati in tempo reale o i carichi in batch per gli aggiornamenti giornalieri. L'obiettivo è quello di scaricare i dati in "bucket" senza modificarli. In questo modo, nessuna informazione viene persa o alterata accidentalmente durante il trasferimento.
Passaggio 2: trasformazione in silver (argento)
Quindi, utilizza un motore di elaborazione come Apache Spark o SQL per pulire i dati non elaborati di livello bronze. Durante questo passaggio, applichi le regole di qualità dei dati. Ad esempio, potresti convertire tutti i timestamp in un fuso orario standard, come l'UTC, o rimuovere gli account di prova dagli elenchi di utenti. Molti team scrivono questi risultati in formati di tabella aperti come Delta Lake o Apache Iceberg, che aiutano a mantenere i dati organizzati e ricercabili. |
Quindi, utilizza un motore di elaborazione come Apache Spark o SQL per pulire i dati non elaborati di livello bronze. Durante questo passaggio, applichi le regole di qualità dei dati. Ad esempio, potresti convertire tutti i timestamp in un fuso orario standard, come l'UTC, o rimuovere gli account di prova dagli elenchi di utenti. Molti team scrivono questi risultati in formati di tabella aperti come Delta Lake o Apache Iceberg, che aiutano a mantenere i dati organizzati e ricercabili.
Passaggio 3: Aggregazione al gold (oro)
Una volta che i dati sono puliti nel livello silver, puoi creare query SQL specializzate per creare le tue tabelle gold. Queste query uniscono tabelle diverse per creare metriche specifiche, come "Entrate per categoria". Questi dati vengono spesso archiviati in viste ad alte prestazioni che possono essere collegate direttamente a uno strumento di visualizzazione come Looker. |
Una volta che i dati sono puliti nel livello silver, puoi creare query SQL specializzate per creare le tue tabelle gold. Queste query uniscono tabelle diverse per creare metriche specifiche, come "Entrate per categoria". Questi dati vengono spesso archiviati in viste ad alte prestazioni che possono essere collegate direttamente a uno strumento di visualizzazione come Looker.
Passaggio 4: orchestrazione e governance
Infine, è necessario un modo per programmare questi passaggi in modo che avvengano automaticamente. Strumenti come Google Cloud Managed Service for Apache Airflow possono gestire la tempistica dei tuoi job. Dovresti anche applicare criteri di sicurezza rigorosi. Ad esempio, potresti consentire a tutti di leggere il livello gold, ma solo a pochi account di servizio autorizzati dovrebbe essere consentito di scrivere o modificare i dati nei livelli silver e gold. |
Infine, è necessario un modo per programmare questi passaggi in modo che avvengano automaticamente. Strumenti come Google Cloud Managed Service for Apache Airflow possono gestire la tempistica dei tuoi job. Dovresti anche applicare criteri di sicurezza rigorosi. Ad esempio, potresti consentire a tutti di leggere il livello gold, ma solo a pochi account di servizio autorizzati dovrebbe essere consentito di scrivere o modificare i dati nei livelli silver e gold.
Creazione di un'architettura medallion su Google Cloud
Google Cloud offre un potente set di strumenti che semplificano l'implementazione di un'architettura a medaglioni. Questi servizi si occupano delle attività più pesanti di scalabilità e sicurezza, in modo che il tuo team possa concentrarsi sull'ottenimento di insight dai dati.
 Cloud StorageQuesto servizio funge da zona di destinazione bronze (bronzo) fornendo un'archiviazione durevole a basso costo per i dati non elaborati in qualsiasi formato.
 BigQueryQuesto data warehouse serverless funge da motore per i livelli silver e gold, eseguendo query SQL veloci per pulire e aggregare i dati.
 Lakehouse di Google CloudConsente di gestire formati di tabelle aperte come Apache Iceberg sia nel data lake che nel data warehouse con una governance unificata.
- Managed Service for Apache SparkServizio completamente gestito che utilizza Apache Spark open source per elaborare, pulire e trasformare i dati mentre si spostano tra i livelli medaglione.
- DataflowElabora i flussi di dati in tempo reale, garantendo che le informazioni vengano spostate nei livelli architetturali non appena vengono create.
- DataformQuesto strumento aiuta gli analisti a utilizzare SQL per creare e pianificare le complesse trasformazioni dei dati che trasformano i dati silver in dati gold.
Vuoi trasformare i tuoi dati in un asset aziendale affidabile?
Inizia oggi stesso a creare la tua architettura a strati con BigQuery.
Hai bisogno di aiuto per iniziare?
Contatta il team di venditaCollabora con un partner di fiducia
Trova un partnerContinua la navigazione
Visualizza tutti i prodotti