Qu'est-ce que l'architecture en médaillon ?
L'architecture en médaillon est un modèle de conception de données utilisé pour organiser les données dans un lac de données ou un lakehouse. Son job principal consiste à améliorer la qualité et la structure des données à mesure qu'elles passent par les différentes étapes. Plutôt que de laisser les données s'accumuler, ce framework les organise en couches. Chaque couche ajoute de la valeur, ce qui rend les données plus fiables et plus faciles à utiliser pour prendre des décisions commerciales.
Il s'agit d'un framework logique, et non d'un logiciel spécifique. Il est conçu pour aider les équipes à gérer les pipelines de données tout en garantissant des transactions ACID (atomicité, cohérence, isolation et durabilité). En faisant transiter les données par ces niveaux de validation, les entreprises peuvent s'assurer que leurs informations sont exactes et sécurisées, même lorsqu'elles traitent d'énormes quantités de données brutes.
Architecture en médaillon et entreposage de données traditionnel
Par le passé, les entrepôts de données traditionnels utilisaient une approche de type "schéma à l'écriture". Vous deviez donc définir parfaitement la structure de vos données avant de pouvoir les enregistrer. Bien que cette approche ait permis de maintenir l'ordre, elle était souvent lente et rigide. Si le format de vos données changeait légèrement, l'ensemble du système pouvait cesser de fonctionner jusqu'à ce qu'un ingénieur le corrige manuellement.
L'architecture en médaillon suit le paradigme moderne du lakehouse, qui adopte le "schéma à la lecture" dans la couche de données brutes. Cela permet aux données d'arriver immédiatement sous leur forme brute. Vous ne vous souciez de la structure que lorsque la valeur commerciale des données devient évidente. Cette approche plus flexible permet aux entreprises de collecter des données dès maintenant et de décider exactement comment les utiliser plus tard.
Les trois couches de l'architecture en médaillon
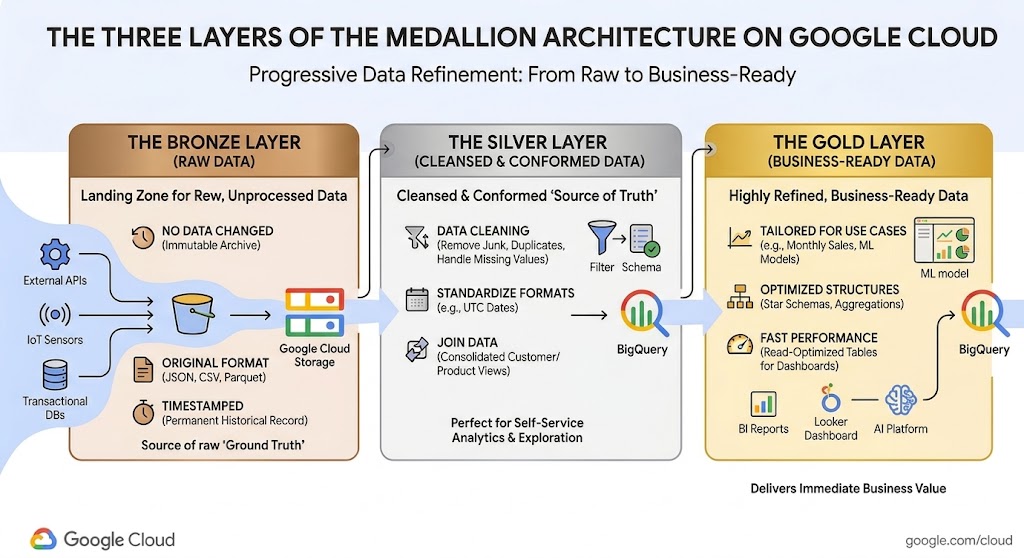
Dans une architecture en médaillon, les données circulent comme un fleuve à travers trois étapes principales : bronze, argent et or. À mesure qu'elles passent d'une étape à l'autre, les données deviennent plus propres et mieux organisées. Cette configuration permet aux ingénieurs de corriger les erreurs rapidement et de fournir aux différents utilisateurs la version de données adaptée à leurs tâches spécifiques.
La couche Bronze (données brutes)
La couche Bronze est la zone où convergent toutes les données entrantes. C'est là que vous stockez les informations brutes non traitées provenant de sources telles que les API Web, les capteurs IoT ou les bases de données transactionnelles. Vous ne modifiez pas les données à cette étape. Vous les conservez dans leur format d'origine, comme JSON, CSV ou Parquet.
Les ingénieurs ajoutent généralement un code temporel à ces fichiers pour indiquer leur date d'arrivée. La couche Bronze sert d'archive historique permanente. Si vous faites une erreur dans vos calculs, vous pouvez toujours revenir à ces données brutes et recommencer. Vous êtes ainsi certain de ne jamais perdre de vue la "vérité de terrain" de vos activités commerciales.
La couche Argent (données nettoyées et mises en conformité)
Considérez la couche Argent comme votre "source de vérité". À cette étape, les données de la couche Bronze sont nettoyées en profondeur. Les ingénieurs utilisent des outils pour filtrer les données indésirables, supprimer les enregistrements en double et corriger les valeurs manquantes. Ils standardisent également les formats, par exemple en s'assurant que toutes les dates suivent le même modèle.
La couche Silver joint différents ensembles de données pour créer une vue claire des éléments clés de l'entreprise, comme les "clients" ou les "produits". Cette couche est idéale pour l'analyse en libre-service. Elle est suffisamment propre pour la plupart des utilisateurs, mais aussi suffisamment détaillée pour répondre à un large éventail de questions sans se limiter à un seul rapport spécifique.
La couche or (données métier prêtes à l'emploi)
La couche Or contient les données les plus affinées. Ces informations sont adaptées à des besoins spécifiques de l'entreprise, comme un rapport mensuel sur les ventes ou un modèle de machine learning qui prédit la perte de clients. Au lieu de listes brutes, la couche Gold utilise souvent des schémas en étoile ou des tables optimisées pour une lecture rapide.
Ces données étant déjà agrégées et calculées, elles se chargent très rapidement dans les tableaux de bord. Un data scientist peut utiliser une table Gold pour consulter les "utilisateurs actifs par jour et par région" sans avoir à joindre lui-même des millions de lignes brutes. C'est le produit final conçu pour apporter une valeur immédiate à l'entreprise.
Principaux avantages de l'architecture en médaillon
Une approche par couches permet aux équipes d'avancer plus vite et de réduire le risque de commettre des erreurs coûteuses. Elle fournit une feuille de route claire sur la façon dont les données doivent être traitées, ce qui facilite la gestion de l'ensemble du système à mesure que l'entreprise se développe.
Amélioration progressive de la qualité des données
Amélioration progressive de la qualité des données
Décomposer les pipelines de données en étapes distinctes simplifie considérablement le débogage. Si un tableau de bord affiche un nombre incorrect, un ingénieur peut d'abord vérifier la couche argent. Si les données argent sont correctes, ils savent que l'erreur se situe dans la logique de transformation des données or. Cette isolation permet aux équipes de trouver et de corriger les bugs en quelques minutes plutôt qu'en quelques heures, ce qui assure un flux de données stable et fiable.
Fonctionnalité temporelle et reproductibilité
Fonctionnalité temporelle et reproductibilité
En conservant un historique complet dans la couche bronze, les entreprises peuvent réexécuter l'intégralité de leur processus de données quand elles le souhaitent. Cela est utile si les règles métier changent. Par exemple, si l'équipe financière modifie la façon dont elle calcule les bénéfices, vous pouvez retraiter toutes vos anciennes données pour qu'elles correspondent à la nouvelle règle. Ce "voyage dans le temps" facilite également les audits, car vous pouvez prouver exactement à quoi ressemblaient les données à n'importe quel moment dans le passé.
Accès démocratisé aux données
Accès démocratisé aux données
Les différents collaborateurs d'une entreprise ont besoin de différents types de données. Les data scientists ont souvent besoin des données brutes de la couche Bronze pour entraîner des modèles d'IA complexes. Les analystes commerciaux, quant à eux, veulent simplement les chiffres finaux et épurés de la couche Gold pour leurs graphiques. L'architecture en médaillon permet à chacun d'accéder à la couche spécifique dont il a besoin sans se gêner mutuellement.
Implémenter une architecture en médaillon
Pour créer cette architecture, il faut un plan clair pour déplacer les données entre les outils de stockage et de calcul. Vous pouvez suivre ces quatre étapes pour configurer un pipeline fiable.
Étape 1 : Ingestion vers la couche bronze
Commencez par configurer des pipelines automatisés pour déplacer les données de vos sources vers une zone de stockage évolutive. Vous pouvez utiliser des outils comme Dataflow pour les données en temps réel ou les chargements par lot pour les mises à jour quotidiennes. L'objectif est de transférer les données dans des "buckets" sans les modifier. Cela permet de s'assurer qu'aucune information n'est perdue ou modifiée accidentellement pendant le transfert. |
Commencez par configurer des pipelines automatisés pour déplacer les données de vos sources vers une zone de stockage évolutive. Vous pouvez utiliser des outils comme Dataflow pour les données en temps réel ou les chargements par lot pour les mises à jour quotidiennes. L'objectif est de transférer les données dans des "buckets" sans les modifier. Cela permet de s'assurer qu'aucune information n'est perdue ou modifiée accidentellement pendant le transfert.
Étape 2 : Transformation vers la couche argent
Utilisez ensuite un moteur de traitement tel qu'Apache Spark ou SQL pour nettoyer les données brutes de la zone bronze. À cette étape, vous appliquez des règles de qualité des données. Vous pouvez convertir tous les codes temporels dans un fuseau horaire standard (par exemple, UTC) ou retirer les comptes de test de vos listes d'utilisateurs. De nombreuses équipes écrivent ces résultats dans des formats de table ouverts comme Delta Lake ou Apache Iceberg, ce qui permet de maintenir les données parfaitement organisées et faciles à explorer. |
Utilisez ensuite un moteur de traitement tel qu'Apache Spark ou SQL pour nettoyer les données brutes de la zone bronze. À cette étape, vous appliquez des règles de qualité des données. Vous pouvez convertir tous les codes temporels dans un fuseau horaire standard (par exemple, UTC) ou retirer les comptes de test de vos listes d'utilisateurs. De nombreuses équipes écrivent ces résultats dans des formats de table ouverts comme Delta Lake ou Apache Iceberg, ce qui permet de maintenir les données parfaitement organisées et faciles à explorer.
Étape 3 : Agrégation vers la couche or
Une fois les données nettoyées dans la couche argent, vous pouvez créer des requêtes SQL spécialisées pour créer vos tables or. Ces requêtes joignent différentes tables pour créer des métriques spécifiques, telles que "Revenu par catégorie". Ces données sont souvent stockées dans des vues hautes performances qui peuvent être directement connectées à un outil de visualisation tel que Looker. |
Une fois les données nettoyées dans la couche argent, vous pouvez créer des requêtes SQL spécialisées pour créer vos tables or. Ces requêtes joignent différentes tables pour créer des métriques spécifiques, telles que "Revenu par catégorie". Ces données sont souvent stockées dans des vues hautes performances qui peuvent être directement connectées à un outil de visualisation tel que Looker.
Étape 4 : Orchestration et gouvernance
Enfin, vous avez besoin d'un moyen de planifier ces étapes pour qu'elles se produisent automatiquement. Des outils comme Google Cloud Managed Service pour Apache Airflow peuvent gérer le calendrier de vos jobs. Vous devez également appliquer des règles de sécurité strictes. Par exemple, vous pouvez autoriser tout le monde à lire la couche Or, mais seuls quelques comptes de service autorisés doivent pouvoir écrire ou modifier des données dans les couches Argent et Or. |
Enfin, vous avez besoin d'un moyen de planifier ces étapes pour qu'elles se produisent automatiquement. Des outils comme Google Cloud Managed Service pour Apache Airflow peuvent gérer le calendrier de vos jobs. Vous devez également appliquer des règles de sécurité strictes. Par exemple, vous pouvez autoriser tout le monde à lire la couche Or, mais seuls quelques comptes de service autorisés doivent pouvoir écrire ou modifier des données dans les couches Argent et Or.
Créer une architecture en médaillon sur Google Cloud
Google Cloud propose un ensemble d'outils performants qui facilitent la mise en œuvre d'une architecture en médaillon. Ces services gèrent les aspects complexes de l'évolutivité et de la sécurité, ce qui permet à votre équipe de se concentrer sur l'extraction d'insights à partir de vos données.
 Cloud StorageCe service fait office de zone de destination bronze en fournissant un stockage durable et peu coûteux pour les données brutes dans n'importe quel format.
 BigQueryCet entrepôt sans serveur sert de moteur pour vos couches argent et or, en exécutant des requêtes SQL rapides pour nettoyer et agréger les données.
 Lakehouse Google CloudIl vous permet de gérer les formats de tables ouverts comme Apache Iceberg dans votre lac de données et votre entrepôt de données avec une gouvernance unifiée.
- Managed Service pour Apache SparkService entièrement géré qui utilise Apache Spark Open Source pour traiter, nettoyer et transformer les données à mesure qu'elles passent d'une couche de médaillon à l'autre.
- DataflowIl traite les flux de données en temps réel, ce qui garantit que les informations sont transférées vers vos couches architecturales dès leur création.
- DataformCet outil aide les analystes à utiliser SQL pour créer et planifier les transformations de données complexes qui transforment les données "argent" en données "or".
Prêt à transformer vos données en un atout commercial fiable ?
Commencez à créer votre architecture en couches avec BigQuery dès aujourd'hui.
Vous avez besoin d'aide pour démarrer ?
Contacter le service commercialFaites appel à un partenaire de confiance
Trouver un partenairePoursuivez vos recherches
Voir tous les produits