功能
适用于 Slurm 和 Kubernetes 的托管式基础设施服务
您可以通过以下两种方式访问 Cluster Director 功能:
- 对于使用 Slurm 或自定义编排器的作业,直接通过控制平面、API 或 CLI 进行访问。这种统一的环境还与 Google Kubernetes Engine (GKE) 集成,为您提供了一个功能强大的界面,可用于创建和管理 Slurm 集群和 Kubernetes 集群。
- 在 GKE 或 Compute Engine 内部进行访问。在这些情况下,您可以在自己熟悉的环境中访问 Cluster Director 功能。
简化作业调度
Cluster Director 开箱即提供容错且高度可扩缩的作业调度。控制器节点由系统为您管理。您可以轻松配置集群的登录节点,包括机器类型、源映像和启动磁盘大小。
直观的集群管理
使用控制平面轻松创建、更新和删除您的集群。它还允许您将集群部署在新建的专用 VPC 网络或现有网络上,简化了您的网络配置流程。在存储方面,您可以创建并挂接新的 Filestore 或 Google Cloud Managed Lustre 实例,也可以连接到现有的 Cloud Storage 存储桶。
拓扑感知布置
为了最大限度地提高性能,Cluster Director 与 Google 的网络拓扑进行了深度集成。这可确保集群内的虚拟机在物理位置上紧邻,从而降低网络延迟,这对高度同步的分布式训练工作负载至关重要。
全方位监测和分析洞见
Cluster Director 集成了可观测性信息中心,可清晰展示集群的健康状况、利用率和性能,让您在一个地方就能快速了解系统的行为并诊断问题。该信息中心能够轻松扩展到数万个虚拟机。
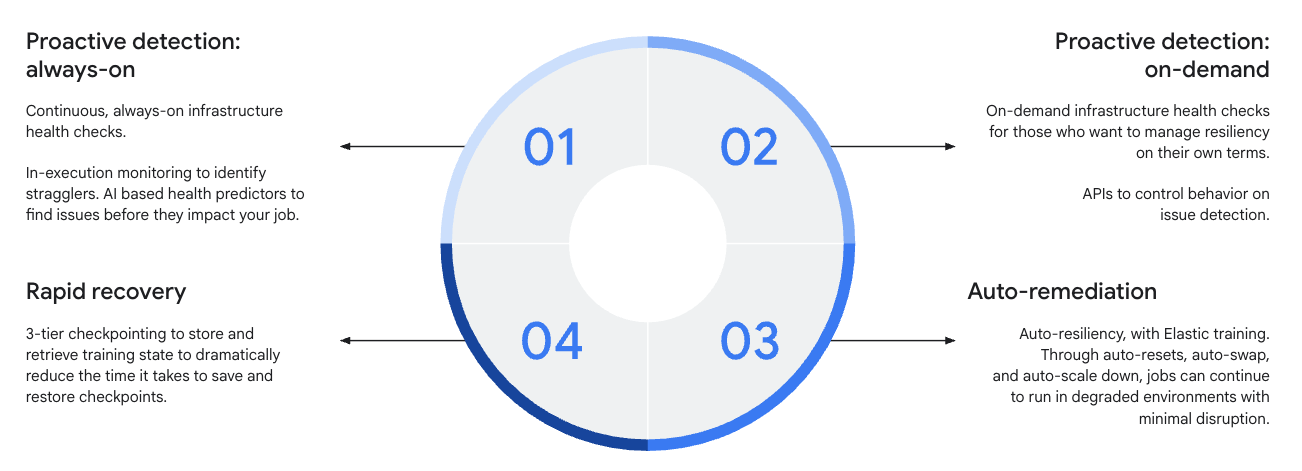
不间断的训练
通过请求健康状况清单确保基础可靠性,此外,还可利用三层检查点和高级维护控制等额外功能,最大限度地提高训练效率。
部署前资格审查和准备
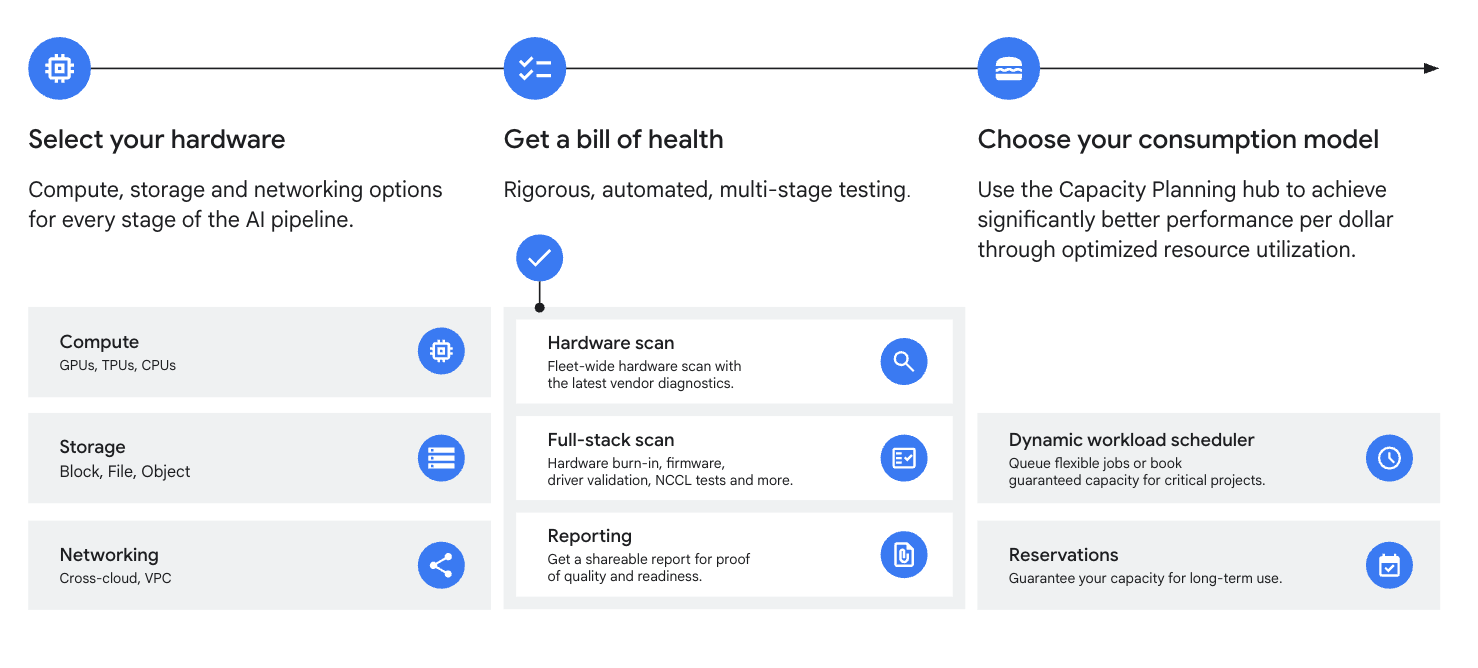
设计高性能、可靠的基础
在启动集群之前,您需要确信您的加速器从一开始就是高性能且可靠的。Cluster Director 可为您的 TPU 和 GPU 提供智能的拓扑感知放置。
每个计算、网络和存储组件都经过严格的多阶段资格认证流程验证,相关结果记录在一份详细的健康状况清单中,为您提供质量保证和就绪状态的最终证明。

学习资源
设计高性能、可靠的基础
在启动集群之前,您需要确信您的加速器从一开始就是高性能且可靠的。Cluster Director 可为您的 TPU 和 GPU 提供智能的拓扑感知放置。
每个计算、网络和存储组件都经过严格的多阶段资格认证流程验证,相关结果记录在一份详细的健康状况清单中,为您提供质量保证和就绪状态的最终证明。
部署集群
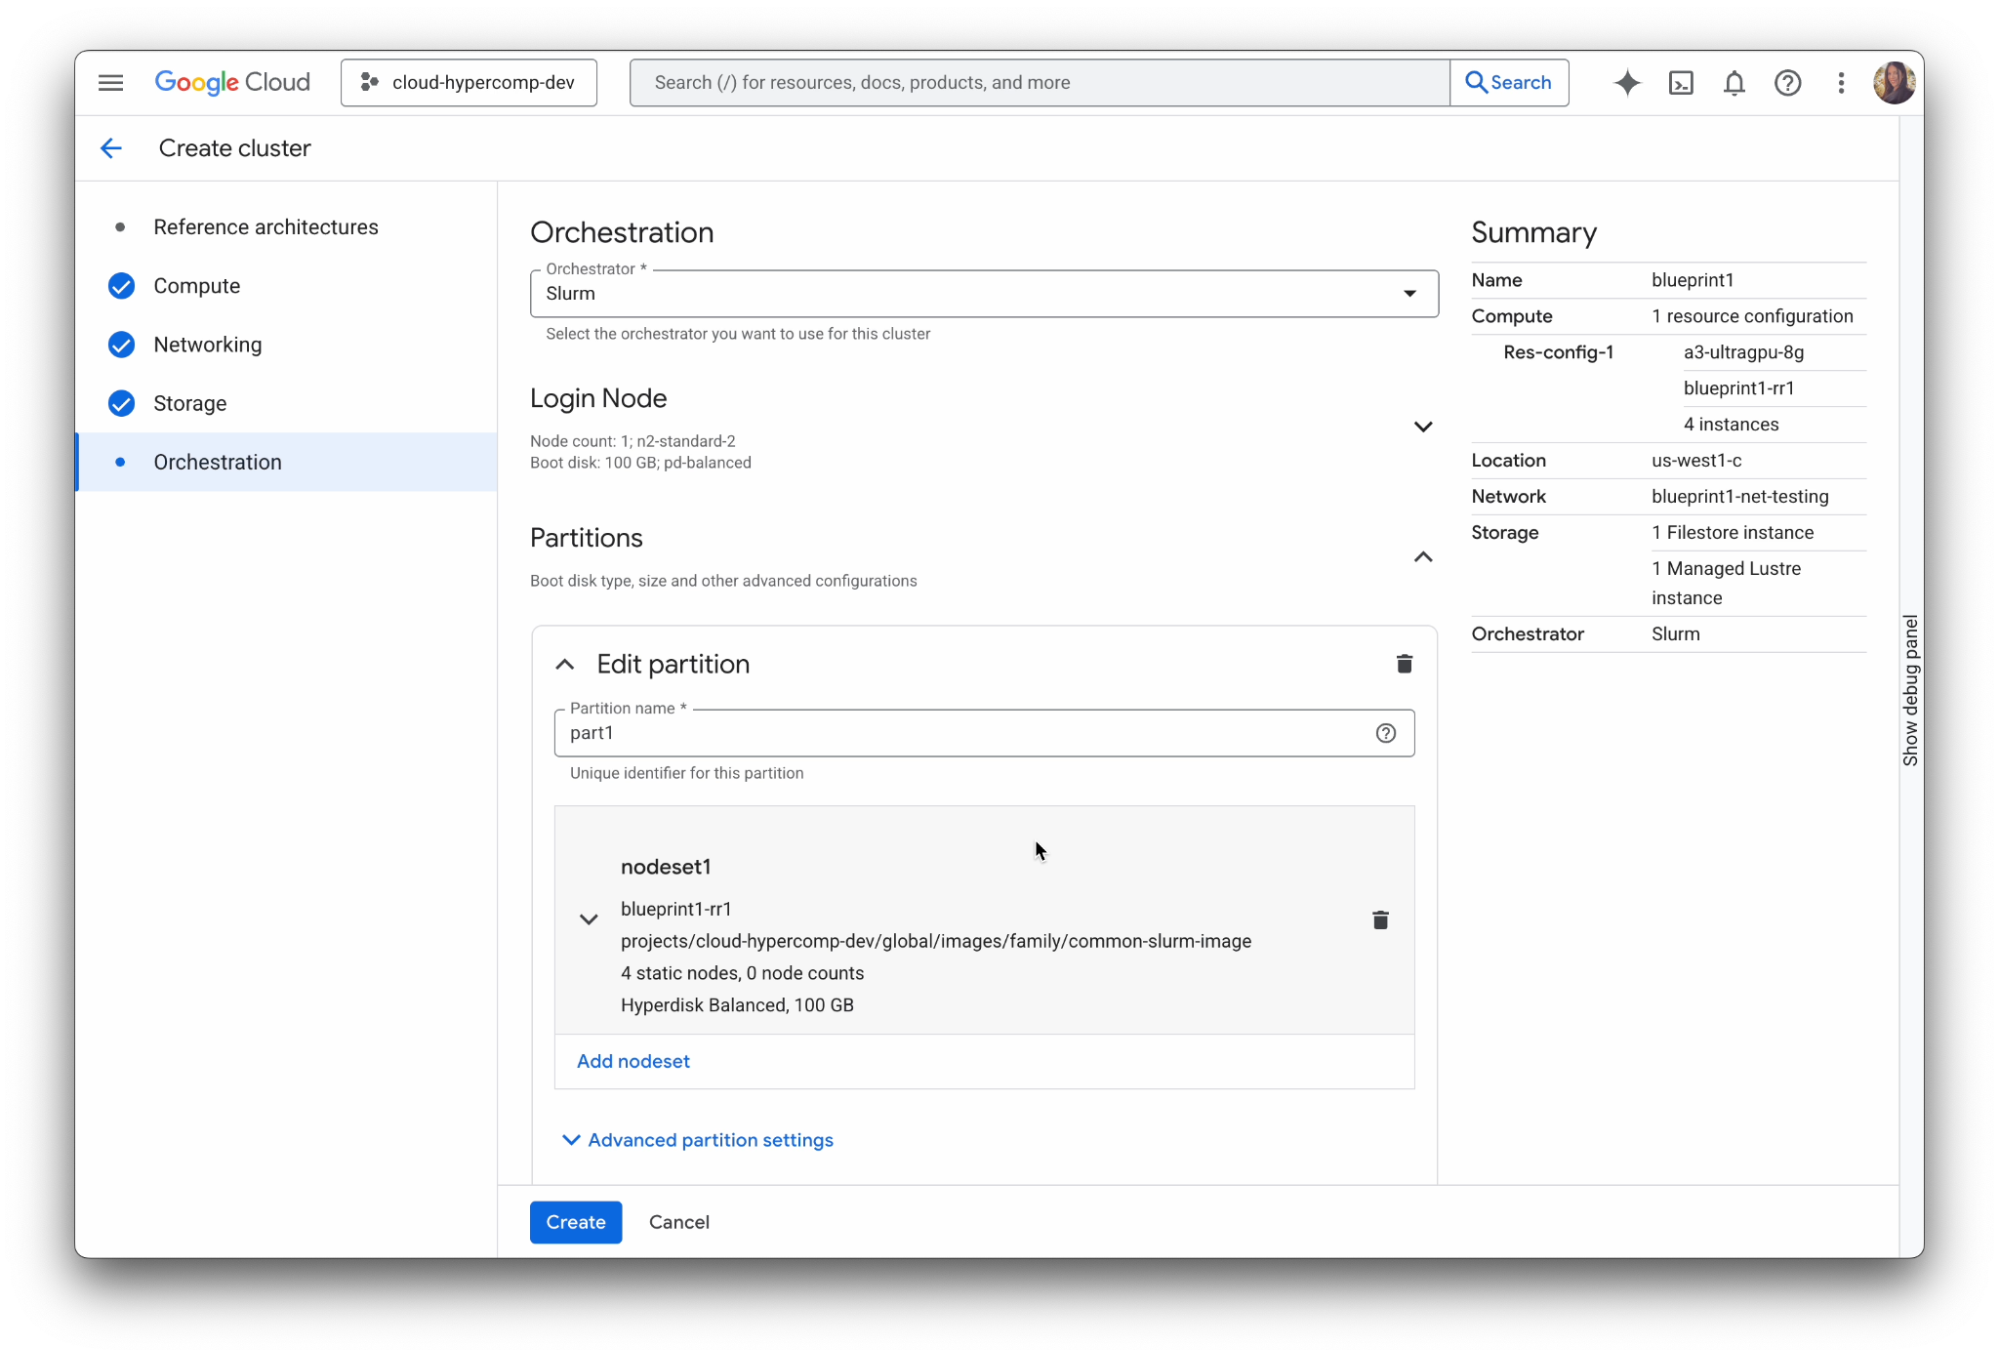
在几分钟内(而不是几天)部署集群
消除设置 GKE 或 Slurm 集群的复杂性。从经验证的参考架构着手,选择您的加速器和存储资源,剩下的工作交给 Cluster Director。
部署任意规模的全优化环境,内置 Google 针对性能和拓扑的最佳实践,从而大幅缩短部署时间。
学习资源
在几分钟内(而不是几天)部署集群
消除设置 GKE 或 Slurm 集群的复杂性。从经验证的参考架构着手,选择您的加速器和存储资源,剩下的工作交给 Cluster Director。
部署任意规模的全优化环境,内置 Google 针对性能和拓扑的最佳实践,从而大幅缩短部署时间。
管理集群
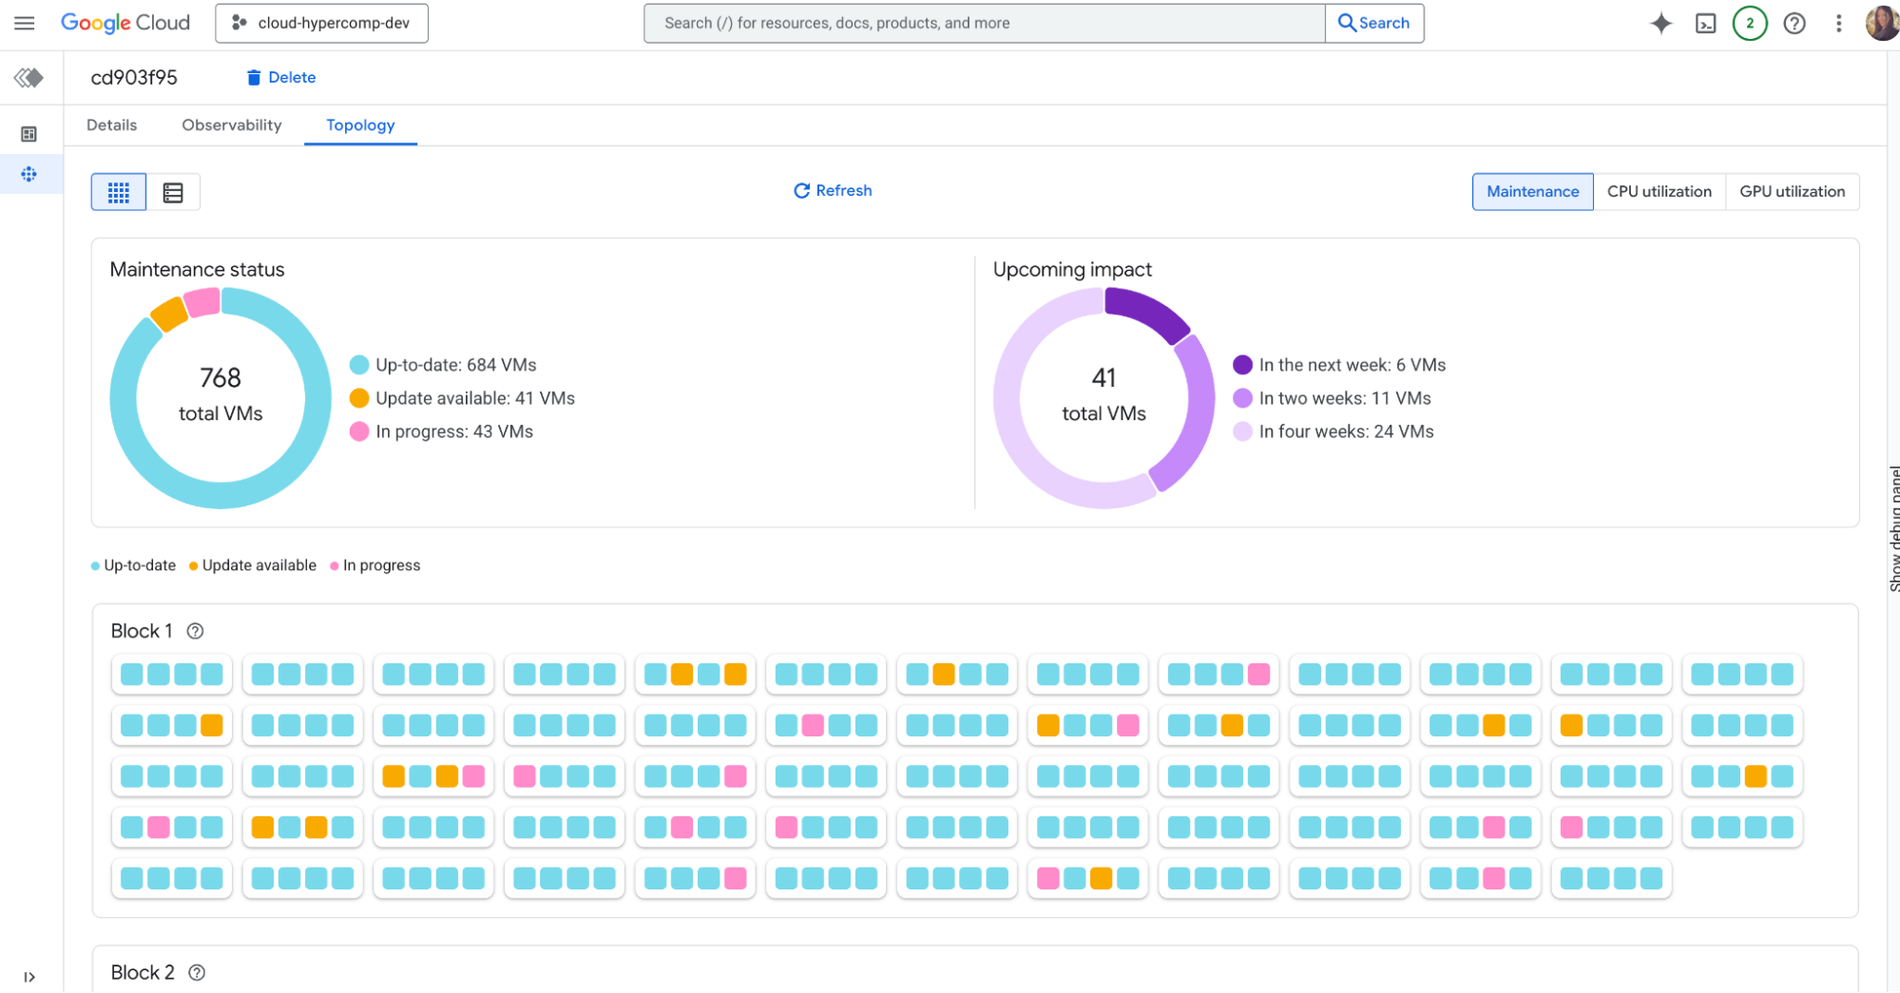
集群管理和可观测性
通过适用于 Slurm 集群的单一控制台,实现从原始基础设施到运行作业的无缝衔接。获取集群健康状况和利用率的拓扑视图。
当出现问题时,利用以作业为核心的可观测性,只需一个作业 ID 即可立即关联全栈指标,将数小时的猜测转化为几次点击,并快速识别任何性能下降的根本原因。
学习资源
集群管理和可观测性
通过适用于 Slurm 集群的单一控制台,实现从原始基础设施到运行作业的无缝衔接。获取集群健康状况和利用率的拓扑视图。
当出现问题时,利用以作业为核心的可观测性,只需一个作业 ID 即可立即关联全栈指标,将数小时的猜测转化为几次点击,并快速识别任何性能下降的根本原因。
检测硬件问题
学习资源
价格
| Cluster Director 定价方式 | 使用 Cluster Director 无需额外付费。您只需为集群使用的底层 Google Cloud 资源付费,例如计算、存储和网络。 | |
|---|---|---|
| 服务 | 说明 | 价格 (USD) |
开始免费试用 | 新用户将获得 $300 的免费试用赠金,可在 90 天内使用。 | 免费 |
使用 Compute Engine 免费层级,每月尊享一个 e2-micro 虚拟机实例、最高 30 GB 标准永久性磁盘存储空间和最高 1 GB 的出站数据传输。 | 免费 | |
虚拟机实例、存储和网络 | 如需了解详情,请查看我们的 Compute Engine 价格。 只需为实际使用的服务付费。没有预付费用,也没有终止费用。价格因产品和用量而异。 | 起价 $0.01 (e2-micro,随用随付) |
Cluster Director 定价方式
使用 Cluster Director 无需额外付费。您只需为集群使用的底层 Google Cloud 资源付费,例如计算、存储和网络。
虚拟机实例、存储和网络
如需了解详情,请查看我们的 Compute Engine 价格。
只需为实际使用的服务付费。没有预付费用,也没有终止费用。价格因产品和用量而异。
Starting at
$0.01
(e2-micro,随用随付)