データと AI のつながりを理解する
データはインテリジェント システムの基盤です。高品質なデータがなければ、AI モデルはパターンを理解することや、有用な予測を行うことはできません。従来のデータベースは、顧客名や取引金額などのクリーンで構造化されたデータを対象に設計されているため、この点に苦労することがよくあります。
最新の AI では、今日のデータセットの規模、多様性、複雑性に対処するために、これまでとは異なるアプローチが必要です。インテリジェントな出力を提供するには、データの関係を形成するためにコンテキストと詳細が必要です。
AI データベースは、これを管理するために特別に構築されています。テキスト、画像、音声など、どのようなデータであっても、AI ソフトウェアが迅速にアクセスできるようにデータを整理します。こうした特殊なシステムを使用することで、デベロッパーは単純なストレージを超えて、コンテキストと意味を理解するアプリを構築できます。
AI データベースと従来のデータベースの違いは何ですか。
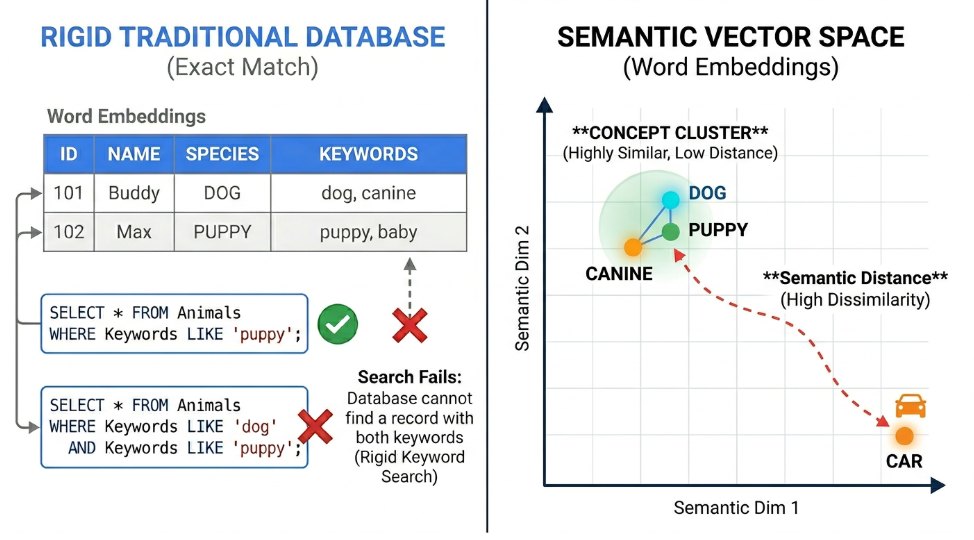
従来のリレーショナル データベースは、財務記録やユーザー プロファイルなどの構造化された情報の管理に適しています。これらの従来型システムでは、データは厳密な行と列に整理されます。アプリケーションが情報を取得する必要がある場合、データベースは正確なキーワードの一致と厳密なロジックに依存します。この方法では、整理されたデータを正確に保つことができますが、複雑なファイルや非構造化ファイルを処理する際には限界があります。
AI データベースは、高次元ベクトルに焦点を当てることで、まったく異なるアプローチを採用しています。開発者がインテリジェント アプリケーションを構築する際、エンベディング モデルを使用して、テキスト、画像、音声を長い数字の文字列に変換します。これらの数値配列は、元のデータの深い数学的意味とコンテキストを捉えています。AI データベースは、これらの膨大な数値リストを保存、インデックス登録、クエリするために特別に構築されています。
データベースがデータの背後にあるセマンティックな意味を理解するため、アプリケーションが情報を取得する方法が変化し、より迅速な ML 検索が可能になります。ユーザーが同義語を使用してコンセプトを検索した場合でも、基盤となる数値ベクトルが類似しているため、AI データベースは適切な情報を見つけます。
機能 | 従来のリレーショナル データベース | AI データベース |
主なデータ型 | 構造化データ、厳密な数値、短いテキスト文字列 | 非構造化データ、リッチメディア、ベクトル エンベディング |
検索機能 | キーワードの完全一致と厳密な論理演算子 | 意味、コンテキストを考慮した検索、ハイブリッド検索 |
ML のインテグレーション | AI モデルにデータを移動するには外部パイプラインが必要 | 大規模言語モデルとのネイティブ インテグレーションと組み込みのエンベディング ツール |
パフォーマンス管理 | データベース管理者による手動チューニングに大きく依存 | ML を使用して自動チューニングと予測スケーリングを実現 |
AI データベースのタイプ
エンジニアリング チームがインテリジェント アプリケーションを構築する際には、いくつかの異なるデータベース アーキテクチャから選択できます。プロジェクトによって、次の一般的な形式のいずれかを使用することになります。
- ネイティブのベクトル データベース: エンジニアは、高次元エンベディングを保存してクエリするために、これらのシステムをゼロから構築します。大規模なデータセット全体でセマンティック類似性検索を実行するだけでよい場合は、驚くほどの速度を発揮します。
- AI で強化されたリレーショナル データベース: 多くのデベロッパーは、使い慣れた SQL 環境を放棄したくありません。最新のクラウド プラットフォームでは、従来のデータベースに特殊な拡張機能が追加され、標準的なトランザクション データと並行してベクトル検索を実行し、ML モデルを呼び出せます。
- グラフ データベース: さまざまな情報の複雑な関係をマッピングするシステムです。人物、場所、コンセプトのつながりに関するより深いコンテキストを AI モデルに提供するナレッジグラフの構築に優れています。
- ドキュメント データベース: 数学ベクトルとともに、JSON ドキュメントなどの柔軟なファイルを保存する必要がある場合があります。ドキュメント データベースでは、未加工のテキスト、説明的なメタデータ、ベクトル エンベディングをすべて 1 か所に保存して、簡単に管理できます。
AI トレーニング データとデータセットの管理
AI データベースは、トレーニングと推論の両方のために大量のデータセットを取り込み、保存、処理することで、トレーニング データのライフサイクル全体を管理します。これは、開発者がデータをクリーンアップ、並べ替え、タグ付けして、AI モデルが効果的に学習できるようにするステージング エリアとして機能します。これらの大きなファイルに低レイテンシでアクセスできるため、開発者はシステムが適切な情報を見つけるまで何時間も待つことなく、モデルをトレーニングできます。
AI データベースのセキュリティはどの程度ですか?
デベロッパーが企業独自の情報を ML モデルに接続する場合、そのデータの安全性を確保することが最優先事項となります。最新の AI データベースには、機密性の高いデータセットを保護するための堅牢な機能が用意されています。保存時とネットワーク経由の移動時の両方でデータを暗号化するなど、標準的なエンタープライズ セーフガードを使用します。エンジニアリング チームは、厳格なアクセス制御を設定して、承認されたユーザー、アプリケーション、特定の AI モデルのみがデータを確認できるようにすることも可能です。
専用の AI データベースを使用する大きなセキュリティ上のメリットは、情報が隔離されることです。機密性の高いビジネス レコードをパブリック AI ツールに送信する代わりに、独自のプライベート クラウド ネットワーク内でクエリを安全に実行できます。多くの AI データベースでは、ML を使用してシステム トラフィックを自動的にモニタリングしています。これらの組み込みのセキュリティ機能は、異常な動作を特定するのに役立ち、データ パイプラインに到達する前に潜在的な脅威をブロックできる可能性があります。
よくある質問
AI データベースについて、デベロッパーがよく抱く疑問をいくつかご紹介します。
AI データベースはどのような場合に使用すべきですか?
アプリケーションで、テキスト ドキュメント、画像、音声ファイルなどの大量の非構造化データを処理する必要がある場合は、AI データベースを使用する必要があります。以下のような特定のシナリオに適しています。
- 異常と不正行為の検出: 大規模なデータセット内の異常なパターンを特定して、プラットフォームを保護します。ネットワーク ログや金融取引を数学ベクトルとして保存すると、アプリケーションは、通常のアクティビティ クラスタから大きく外れた外れ値を即座に特定し、システムとユーザーの安全を確保できます。
- セマンティック検索: ユーザーの質問の背後にある意図を理解する検索エンジンを構築します。ユーザーは、キーワードの完全一致に頼るのではなく、自然な会話形式の言語を使用して、適切なドキュメントやファイルを見つけることができます。
- 高度なレコメンデーション エンジン: 深い意味的つながりに基づいて商品やコンテンツを提案します。厳格で固定されたカテゴリタグに頼るのではなく、視覚的な類似性や曖昧な説明に基づいて買い物客と商品をマッチングできます。
グローバルな参照データベースで AI を検出できるか?
グローバルな参照データベースや同様の学術的な剽窃ツールは、提出されたテキストを既知の人間と機械の膨大なアーカイブと比較することで、AI によって生成されたコンテンツを検出できる場合があります。これらのツールは、特殊なアルゴリズムを使用して、予測可能なフレーズ、繰り返される文構造、データセット内のデータ異常を検出します。これらは便利ですが、精度はさまざまで、誤検出が発生することもあります。
RAG と AI データベースの関係
検索拡張生成(RAG)は、言語モデルを事実に基づいた実世界の情報にグラウンディングする手法です。AI データベースは、独自のデータを安全に保存することで、RAG パイプラインの基本的な知識ライブラリとして機能します。ユーザーが質問すると、データベースは最も関連性の高い情報を即座に探し出し、言語モデルに直接フィードします。このプロセスにより、AI は事実に基づいたコンテキストを把握し、非常に正確な回答を生成して推測を防ぐことができます。
AI データベースのメリット
AI データベースを使用すると、従来のソフトウェア開発から脱却するエンジニアリング チームに大きなメリットがもたらされます。これらのシステムは、最新の ML アプリケーションの固有の要件に対応するために特別に構築されています。
高いパフォーマンスと迅速なスケーラビリティ
高いパフォーマンスと迅速なスケーラビリティ
これらのシステムにより、デベロッパーは速度の低下をほとんど感じることなく、1 秒あたり数百万件の秒間クエリ数を処理できます。アプリケーションのユーザー数が数百人から数十万人に増えても、データベースはスケールして増加したワークロードを管理し、レスポンス時間を短く保ちます。
非構造化データの処理
非構造化データの処理
従来のデータベースは、テキスト ドキュメント、画像、音声ファイルなどの、現実世界の雑然とした情報を処理するのに苦労することがよくあります。AI データベースは、この非構造化データを効果的に処理するために特別に最適化されています。この機能により、自然な人間の言語と複雑な視覚パターンを実際に理解するアプリケーションをはるかに簡単に構築できます。
シームレスなクラウド インテグレーション
シームレスなクラウド インテグレーション
最新の AI データベースは通常、既存のクラウド インフラストラクチャに直接接続します。この接続性により、データ サイエンティストとエンジニアは統合された環境で共同作業できます。1 つの接続されたエコシステムで作業することで、単純なローカル プロトタイプから完全な機能を持つ本番環境アプリケーションに ML モデルを移行するのにかかる時間を短縮できます。
セマンティック検索と従来の構造化検索の比較
従来の検索は、完全一致を探すことで機能します。「子犬」を検索した場合、従来のデータベースでは「犬」に関するドキュメントは無視される可能性があります。単語が異なるためです。セマンティック検索では、単語の背後にある意味を調べることでこの問題を解決し、「子犬」と「犬」が関連していることをシステムが理解できるようにします。
ハイブリッド検索は、両方のアプローチを組み合わせて、それぞれのメリットを活かすものです。セマンティック検索を使用してクエリの背後にある意味を理解し、構造化検索を使用して日付やカテゴリなどの特定のフィールドでフィルタします。
AI を使用したデータベースの最適化
AI とデータベースの関係は双方向です。データベースは AI モデルをサポートしますが、開発者は DB の最適化にも AI を使用しています。
たとえば、AI と ML は、トラフィックの急増を予測し、ボトルネックが発生する前にコンピューティング リソースを割り当てることで、データベースのパフォーマンスを最適化するために積極的に使用されています。このプロアクティブな管理により、夜中に管理者が手動でサーバーサイズを調整する必要がなくなり、アプリケーションをスムーズに実行できます。
また、ML アルゴリズムは、ルーチン データベース チューニングの自動化とセキュリティ プロトコルの強化にも役立ちます。これらのツールは、クエリパターンを分析して、より優れたインデックス戦略を提案できるため、エンジニアは手動でのトラブルシューティングに費やす時間を節約できます。また、AI モデルはネットワーク トラフィックを常に監視して、異常なアクセス パターンを検出します。これにより、潜在的なセキュリティ脅威をリアルタイムで特定してブロックできます。
適切な AI データベースの選択
AI データベースを選択する際は、ML ワークフロー固有の要件にどのように対応しているかを慎重に検討する必要があります。組織は、ベクトルデータをネイティブにサポートし、プロジェクトの成長に合わせて拡張できるシステムを優先する必要があります。
データベースを選択する際は、次の機能に注目してください。
- ネイティブ ベクトル インデックス: データベース エンジン内で直接ベクトルを保存、検索する機能
- ハイブリッド検索機能: セマンティック理解と完全一致フィルタリングを組み合わせる機能
- スケーラビリティ: 速度を落とさずに大規模なエンタープライズ ワークロードを処理する能力
- エコシステムのインテグレーション: エンべディング モデル、LLM、既存のデータ パイプラインへのシームレスな接続
AI データベースで何が構築できますか?
AI データベースは、スマートで応答性の高いアプリケーションを作成しようとしている開発者に、さまざまな可能性をもたらします。これらのシステムは非構造化データを処理し、意味論的な意味を理解するため、従来のデータベースでは管理が難しい複雑な問題を解決するのに役立ちます。
構築できる一般的なアプリケーションをいくつかご紹介します。
- インテリジェントなサポート エージェント: 厳格なルールベースの chatbot を作成する代わりに、コンテキストを実際に理解するサポート エージェントを構築できます。会社の技術マニュアル、製品ガイド、過去のサポートチケットをベクトル エンベディングとして保存することで、AI エージェントは複雑なドキュメントを読み解き、ユーザーに非常に正確なトラブルシューティング手順を段階的に提供できます。
- 高度なレコメンデーション エンジン: 従来の小売アプリは、商品の提案にシンプルなタグを使用しています。AI データベースを使用すると、視覚的な類似性やライフスタイルの説明を理解するレコメンデーション システムを構築できます。買い物客が気に入ったリビングルームの写真をアップロードすると、その美観にぴったり合う家具を即座に検索できます。
- セマンティック検索ツール: 従業員が自然言語を使用して情報を検索できる、強力な社内検索エンジンを作成できます。たとえば、法務チームが特定の契約条項に関する質問を入力すると、検索クエリが文書内の専門用語と完全に一致しない場合でも、データベースは必要な段落を正確に取得します。
- カスタム開発者ツール: 独自のコードベース全体を AI データベースにインデックス登録できます。これにより、エンジニアリング チームは自然言語を使用して数百万行のコードを検索できます。新しい開発者がユーザー認証を処理する特定の関数を見つける必要がある場合、何百ものファイルを一つずつ手動でクリックする代わりに、データベースに直接問い合わせることが可能です。
- リッチメディア プラットフォーム: 最新のアプリケーションでは、テキストだけでなく、さまざまなデータを処理する必要があることがよくあります。実際のコンテンツに基づいて音声クリップ、動画、画像を分析して取得するツールを構築できます。たとえば、メディア企業は、編集者がシーンの簡単な説明を入力するだけで、特定の動画クリップを即座に抽出するプラットフォームを作成できます。
Google Cloud データベースと Gemini プラットフォームを活用した構築
Google Cloud は、ベクトル検索をサポートする AlloyDB for PostgreSQL などのデータベース ソリューションとインテリジェントな Gemini プラットフォームを組み合わせることで、AI 搭載アプリを構築するための強力なエコシステムを提供します。このインフラストラクチャは、レイテンシを低く抑えながら大規模なデータセットを処理できるように設計されています。
これらのツールを接続することで、デベロッパーはコンテキストをデータベースに保存し、人間のような応答を簡単に生成する堅牢なアプリケーションを構築できます。このインテグレーションにより、最新の AI 開発における信頼性とスピードの基準が提供されます。
関連する Google Cloud のプロダクトとサービス
Google Cloud は、デベロッパーが AI データベースを構築、スケーリング、管理することに役立つ強力なツール エコシステムを提供します。
 AlloyDB for PostgreSQLこのフルマネージドのリレーショナル データベースは、ネイティブのベクトル検索と ML モデルとの直接統合により、高パフォーマンスの AI ワークロードを処理します。
 Cloud SQL開発者は、この人気のマネージド データベースを使用して、標準の PostgreSQL 拡張機能を使用して、従来のリレーショナル データとともにベクトル エンベディングを保存およびクエリできます。
 Spannerこのグローバル分散型データベースを使用すると、チームは世界中の膨大な量の構造化データと非構造化データに対して、ダウンタイムをほぼゼロに抑えてセマンティック類似性検索を実行できます。
 BigQueryこのサーバーレスのデータ ウェアハウスは、データエンジニアが巨大な AI データセットを管理し、企業データがすでに存在する場所でベクトル検索を直接実行するのに役立ちます。
 Gemini プラットフォームこの包括的な ML プラットフォームは、AI データベースに保存されるベクトル エンベディングを生成し、複雑な検索パイプラインの構築とデプロイを容易にします。
 Firestoreこの柔軟な NoSQL ドキュメント データベースにはベクトル検索機能が含まれており、デベロッパーは応答性の高い AI 機能をモバイルアプリやウェブアプリに迅速に組み込めます。
開始にあたりサポートが必要な場合
お問い合わせ信頼できるパートナーと連携する
パートナーを探すもっと見る
すべてのプロダクトを見る