什么是数据库分片?
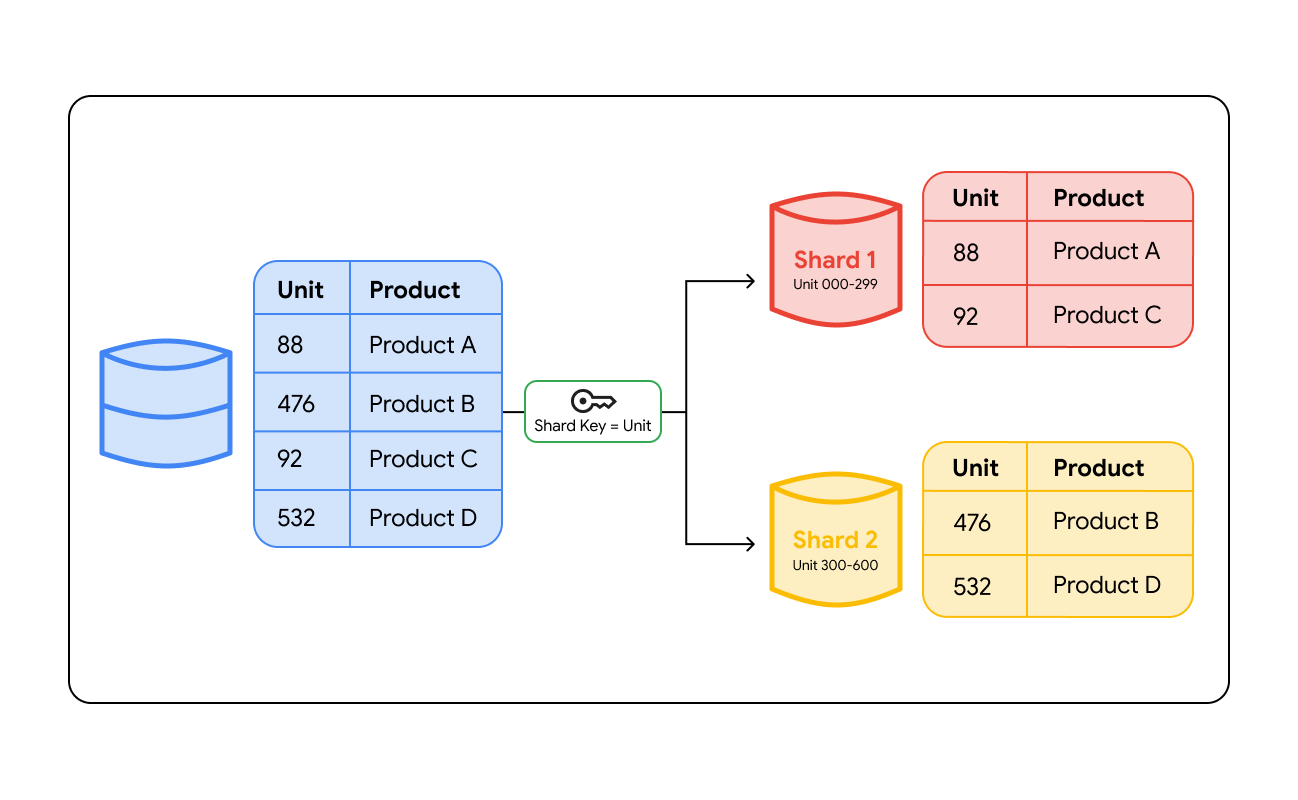
数据库分片是一种策略,用于解决数据量巨大的应用中的可伸缩性问题。它涉及将单个大型逻辑数据集拆分为更小、更易于管理的部分,称为分片。每个分片都存储在单独的数据库服务器实例上,从而有效地将数据和工作负载分散到多台机器上。
分片是横向扩缩(扩容)的关键方法。分片允许您向集群添加更多商品服务器,而不是使用更多 CPU 或 RAM 升级单个服务器(纵向扩缩),因为纵向扩缩最终会导致硬件瓶颈。这使得应用能够处理几乎无限增长的数据量和用户流量。
分片是一种强大的扩容方法,但它只是三种常见的横向扩缩策略之一:
- 只读副本:这涉及创建主数据库的副本以处理只读流量,从而减轻主服务器的负载
- 分片:这会将数据和写入流量分布到多个独立服务器上
- 分布式数据库:Spanner 等产品可在数据库引擎本身内原生处理分布和扩缩,无需手动分片
数据库分片的工作原理
数据库分片的工作原理是根据称为分片键的特定值对数据进行分组。分片键是数据库中的一列(例如用户 ID、客户区域或订单号),用于确定哪个服务器将存储特定数据行。当数据写入数据库时,系统会查看此键,以确定数据所属的位置。
为了以后找到这些数据,系统必须将查询路由到正确的位置。这种路由主要通过以下两种方式实现:
- 路由层:分片架构可能会使用智能负载均衡器或专用代理层。当应用发送查询时,路由层会检查分片键,计算出哪个分片包含该数据,并将流量定向到该服务器。
- 应用端逻辑:在某些情况下(例如在多人游戏或高性能实时应用中),应用代码本身包含分片逻辑。该代码甚至在发送请求之前就计算出了正确的分片位置,这可以通过消除额外的网络跃点来减少延迟。
通过仅定位相关分片,数据库可以更快地回答查询,并处理数千个并发请求,而不会降低速度。
常见的分片方法
不同的应用需要不同的数据拆分逻辑。您选择的方法决定了“路由层”查找您的数据的方式。
基于键的分片(哈希分片)
此方法使用分片键上的数学公式(哈希函数)来分配数据。例如,系统可能会计算用户 ID (mod 4),以将用户分配到 4 个服务器之一。
虽然哈希函数有助于一致地分布数据,但只有在分片键具有高基数和低频率偏度时,它们才能确保均匀分布。如果您选择一个具有常见值的分片键(例如“姓氏”中“Smith”出现的次数是“Pyne”的 1,000 倍),则哈希函数会将每个“Smith”记录发送到同一分片。尽管使用了数学公式,但仍会创建“热分片”。
使用这种方法也很难添加新服务器,因为公式会发生变化,这通常需要您“重新分片”或将数据移动到新的服务器集群中。
基于范围的分片
数据是根据值范围分配的。例如,您可以将用户 ID 1-1,000 放在服务器 A 上,将用户 ID 1,001-2,000 放在服务器 B 上。这种方法非常直观,非常适合需要读取一系列数据(范围查询)的查询。缺点是会出现“热点”:如果所有新用户都被分配到服务器 B,那么服务器 B 将承担所有工作,而服务器 A 则处于空闲状态。
基于目录的分片
此策略使用一个对照表(目录)来跟踪哪个分片包含哪些数据。这种方法最灵活,因为您可以在分片之间移动数据,而无需更改公式。但是,此对照表会成为瓶颈;每个查询都必须先检查目录,从而增加延迟。如果目录发生故障,整个数据库都将无法访问。
地理分片
地理分片会根据用户的实际位置将数据分配给特定的服务器。例如,法国用户的数据存储在欧盟的服务器上,而美国用户的数据则存储在北美的服务器上。这显著降低了用户延迟(速度),并帮助公司满足 GDPR 等数据驻留法律的要求。
垂直分片
有时称为功能分区,这种方法涉及按特征而不是按行拆分数据。例如,您可以将所有“用户个人资料”表放在服务器 A 上,并将所有“照片上传”表放在服务器 B 上。虽然这种方式可以从逻辑上整理数据,但从功能上来说,它与微服务数据架构类似,如果某个特定功能(如照片)的数据量过大而使单个服务器无法处理,这种方式也无法解决问题。
如何优化数据库分片以实现均匀的数据分布
选择合适的分片键是分片过程中最关键的决策。糟糕的键会导致数据分布不均(热点),而良好的键能确保所有服务器工作均衡。为了优化此过程,您必须考虑以下三个因素:
- 基数:是指键可以拥有的唯一值的数量。您需要一个基数较高的键(如用户 ID),而不是基数较低的键(如“性别”或“州/省/直辖市/自治区”),这样数据才能拆分成许多小块。
- 频率:您必须避免使用某个特定值出现过于频繁的键。例如,如果您按“城市”分片,而 80% 的用户居住在纽约,则“纽约”分片将会过载。
- 单调变化:避免使用随时间严格递增的键,例如时间戳或自动递增 ID。如果按日期分片,所有新数据写入都会进入“今天”分片,从而形成写入热点,而旧分片则处于空闲状态。
分片主要术语
虽然这些术语在系统设计中经常一起使用,但它们解决的是不同的问题。
分片
分片是一种特殊的水平分区类型,其中数据块分布在完全不同的服务器上。这既解决了硬件容量限制(存储)问题,也解决了写入吞吐量瓶颈问题,因为不同的服务器可以同时处理写入操作。
- 手动分片:在手动分片环境中,开发者或数据库管理员负责定义分片键、为每个分片创建基础设施,并编写用于路由查询的逻辑。这样,您就可以精细地控制数据的存储位置。不过,这需要大量的维护工作。如果某个分片变得过大,您必须手动对数据进行“重新分片”,这需要将数百万行数据移动到新服务器,同时尽量减少应用停机时间。
- 自动分片:自动分片通常用于 Bigtable 等 NoSQL 数据库或 Spanner 等分布式 SQL 数据库,可自动处理数据和流量的分布。系统会监控数据大小和每个服务器上的负载。如果特定分片成为“热点”或变得过大,数据库引擎会自动拆分该分片并将数据移至不太拥塞的服务器。这可以减轻团队的运营负担,并帮助确保应用在扩缩时保持一致的性能。
分区
分区是将大表拆分成更小、更易于管理的部分(例如按月拆分日志表),但这些部分仍保留在同一服务器实例上。这解决了存储问题,因为这样可以更轻松地归档或删除旧数据,而不会影响表的其余部分。但它无法解决服务器问题。由于所有分区仍驻留在单台机器上,因此它们继续共享相同的 CPU 和 RAM,这意味着如果服务器达到性能极限,分区也无济于事。
复制
复制是将整个数据库复制到多个服务器的过程。这对于读取可用性来说是一个不错的选择;如果一个服务器发生故障,另一个服务器可以接管。不过,它无法帮助进行写入扩缩,因为写入的每条数据都必须复制到每个副本,从而将写入速度限制在单台机器的容量范围内。
同样重要的是,大多数复制模型一次只允许一个“写入者”(主节点)。如果您尝试允许多个服务器同时接受写入,则可能会发生写入冲突,即两个服务器尝试使用不同的信息更新同一条记录。从技术上讲,解决这些冲突非常困难,如果不是由复杂的分布式系统处理,可能会导致数据丢失或不一致。
分布式数据库
Spanner 等分布式数据库提供了分片优势,而无需手动操作。这些系统从一开始就设计为跨机器集群运行。它们会自动透明地处理数据分发、重新平衡和复制。其中一些系统有多个写入者,并自动处理写入冲突。这样,您就可以在保持传统关系型数据库一致性的同时进行横向扩缩。
请参阅下表,了解这些核心数据库概念之间的差异。
功能 | 分片 | 分区 | 复制 | 分布式数据库 |
主要目标 | 大规模写入扩缩和存储空间 | 可管理性和维护 | 高可用性和读取扩缩 | 自动全球扩缩 |
数据位置 | 不同服务器上的不同数据块 | 同一服务器上的不同数据块 | 同一数据在多个服务器上的副本 | 跨集群管理 |
写入性能 | 大幅提升(并行写入) | 小幅改进(较小的索引) | 无需改进(写入必须发送到所有副本) | 大幅提升 |
复杂性 | 高 | 中 | 低 | 低(托管式) |
数据库分片的优点
对于处理 TB 级数据或每秒处理数百万个事务的应用,分片通常是唯一可行的解决方案。
横向扩缩
横向扩缩
分片通过向集群添加标准服务器,实现了近乎无限的扩缩。这避免了传统纵向扩缩应用带来的“硬件税”。如果不分片,您往往会被迫购买昂贵且专业的硬件,这些硬件会遇到性能瓶颈。分片让数据库能够随着业务发展而扩容,同时使用更经济实惠的商用机器
提高查询性能
提高查询性能
分片可加快单个查询的速度,因为每个服务器搜索的数据集较小。查询可能只需要搜索包含 100 万行的分片,而无需搜索包含 1 亿行的索引。此外,由于数据位于不同的机器上,因此您可以并行运行多个查询,从而大大提高应用的总体吞吐量。
可靠性
可靠性
分片可限制故障的“影响范围”。如果一个分片发生故障,只会影响这些用户,而应用的其余部分仍可正常使用。不过,服务器越多,管理负担就越重。与单服务器设置相比,管理数十个实例的备份、安全和补丁会增加运营复杂性。
分片带来的挑战
分片虽然解决了大规模扩展的需求,但也带来了重大的技术和运营方面的权衡取舍。在放弃单实例架构之前,您应该考虑这些挑战。
- 数据热点:即使使用哈希函数,不均衡的流量也可能会产生“热点”,导致一台服务器因一小部分高活跃用户而过载,而其他分片则未得到充分利用。
- 性能下降:不使用分片键的查询需要系统在每台服务器上执行“分散聚集”操作。同样,跨分片联接的计算成本也很高,因为应用必须从多个物理位置拉取和合并数据。
- 运营复杂性:管理分片环境会增加日常任务的难度。架构更新、备份和时间点恢复必须在多个独立实例之间进行协调。
- 事务一致性:许多分片架构都难以支持跨不同分片的 ACID 事务。这通常会迫使开发者管理复杂的“部分失败”场景,或依赖最终一致性模型。
Google Cloud 如何助力实现数据库分片
Google Cloud 提供数据库解决方案,可消除手动分片的繁重工作,让您专注于构建应用,而不是管理基础设施。
 SpannerSpanner 是全托管式全球分布式数据库,提供“无分片”体验。它会自动对数据进行分片,并在各个区域之间均衡负载。作为多模型数据库,它可通过单一接口支持关系型数据、键值对数据和图表数据(通过 Spanner Graph)。这让您可以在保持强一致性和 SQL 熟悉度的同时进行横向扩缩。
 CloudSQL 和 AlloyDB如果您更喜欢传统的关系型数据库引擎,Google Cloud 可为 PostgreSQL、MySQL 和 SQL Server 提供托管式实例。Cloud SQL 和 AlloyDB 都支持原生分区,可在单个实例上管理大型表。您还可以使用这些实例构建自定义分片架构,以在多台机器间扩缩工作负载,而 AlloyDB 可为要求苛刻的数据提供额外的性能支持。
- Bigtable对于大规模 NoSQL 工作负载,Bigtable 是理想之选。它会自动处理“分片”(sharding),可管理 PB 级数据和每秒数百万个请求,适用于个性化和时序数据等应用场景。