Cloud Spanner の CPU 最適化バックアップで障害復旧を簡素化
Google Cloud Japan Team
※この投稿は米国時間 2022 年 3 月 23 日に、Google Cloud blog に投稿されたものの抄訳です。
ビジネス クリティカルなアプリケーションには、障害復旧およびデータ保護プランが不可欠です。このプランは、自然災害(火災、洪水、停電など)だけでなく、不良データの commit を引き起こすバグの出荷など、人為的な事故からも保護する必要があります。
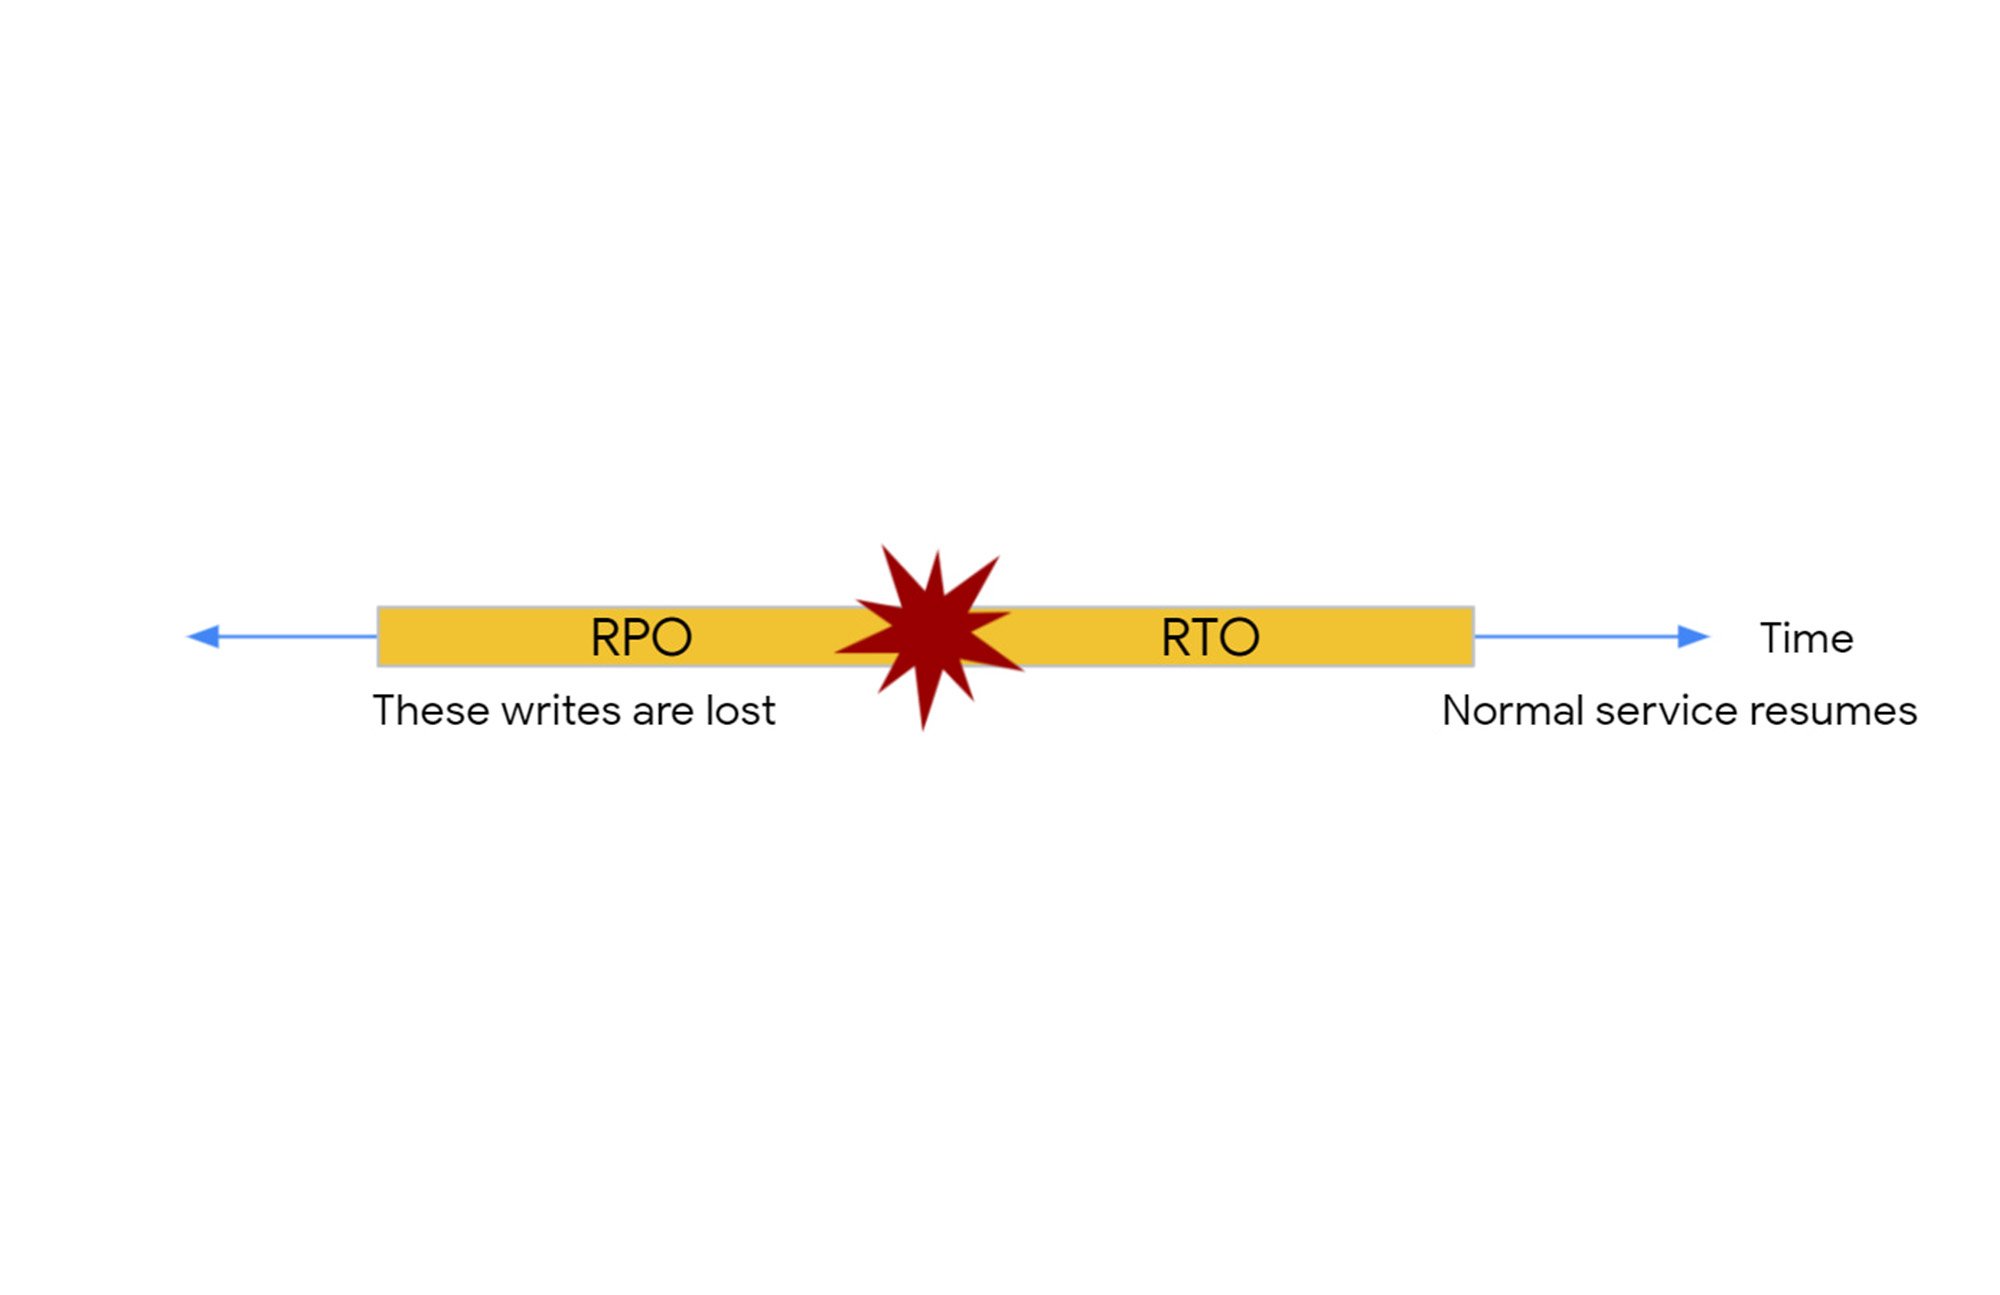
プランの一環として、アプリケーションのオーナーは、RPO(目標復旧時点)と RTO(目標復旧時間)の両方を考慮する必要があります。RPO は、復旧するために準備するデータの寿命に関するもので、RTO は、インシデント発生後にアプリケーションをオンラインに戻すために準備する時間に関するものです。
Cloud Spanner は、無制限のスケーリング、強整合性、最大 99.999% の可用性を備えたフルマネージド リレーショナル データベースです。Cloud Spanner は、リージョン構成ではゾーン間で、マルチリージョンでの構成ではリージョン間で、透過的かつ同期的なレプリケーションを提供します。このアーキテクチャは、従来の障害復旧ソリューションが対処しなければならないインシデントの原因、すなわち自然災害やマシン個別の故障から本質的に保護するものです。
Cloud Spanner が高可用性を提供するとしても、アプリケーションの所有者はデータ保護を必要としています。ユーザーエラーやアプリケーションのバグによって、誤った値がデータベースに保存される可能性を排除することはできません。このようなニーズに対応するため、Cloud Spanner は、バックアップ / 復元とポイントインタイム リカバリを提供しています。
Cloud Spanner のバックアップはトランザクション的に一貫しています。バックアップが作成されると、バックアップ タイムスタンプ(マイクロ秒単位のトランザクション commit タイムスタンプ)の時点のデータベースの内容を正確に取得します。Cloud Spanner は、バックアップ タイムスタンプまでに commit されたトランザクションに関連するすべてのデータがバックアップに含まれ、commit されていないトランザクションに関連するすべての部分更新が除外されることを保証しています。ポイントインタイム リカバリでは、ユーザーが選択した復元タイムスタンプから、バックアップと同じセマンティクスで復元できます。復元時間スタンプまでに commit されたすべてのトランザクションが復元されたデータベースに存在し、それ以外は何も存在しません。
たとえば、あるユーザーが 10 TB のデータベースを持ち、ビジネス クリティカルなアプリケーションを動かしているとします。ユーザーは障害復旧プランの一環として、定期的にバックアップをとります。多くのシステムにおいて、大規模なデータベースのバックアップには何時間もかかり、データベースの CPU 負荷が増大する可能性があります。バックアップによる CPU 負荷の増大が、本番環境のトラフィックに悪影響を与えることが懸念されます。Cloud Spanner は、この問題を CPU 最適化バックアップで解決しました。この機能を利用して、Cloud Spanner は、お客様のデータベース インスタンスに使用する CPU リソースと、バックアップ作成に使用する CPU リソースを分離しました。この機能は、Cloud Spanner のすべてのバックアップで有効になっています。
データベースのバックアップを作成するために、Cloud Spanner はデータベースの内容を読み取り、バックアップのコピーを書き出すバッチジョブを起動します。この作業は、データベースの完全なコピーを持つ各 GCP ゾーン(すべての読み書き可能なゾーンとすべての読み取り専用ゾーン)で行われます。各ゾーンのバックアップのコピーは独立して書き込まれ、そのゾーン内にのみ留まります。これにより、クロスゾーンのネットワーク トラフィックを伴わない高可用性バックアップと高速復元が可能になります。
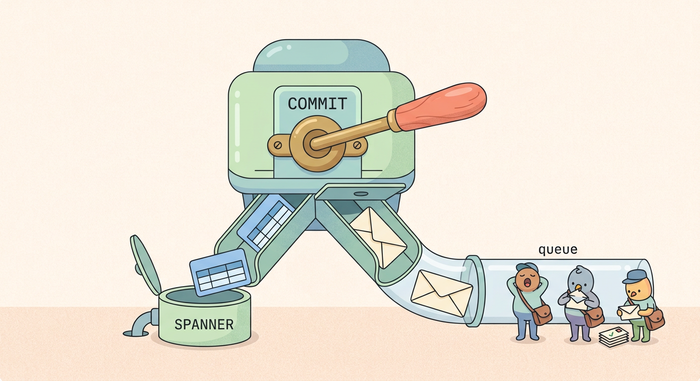
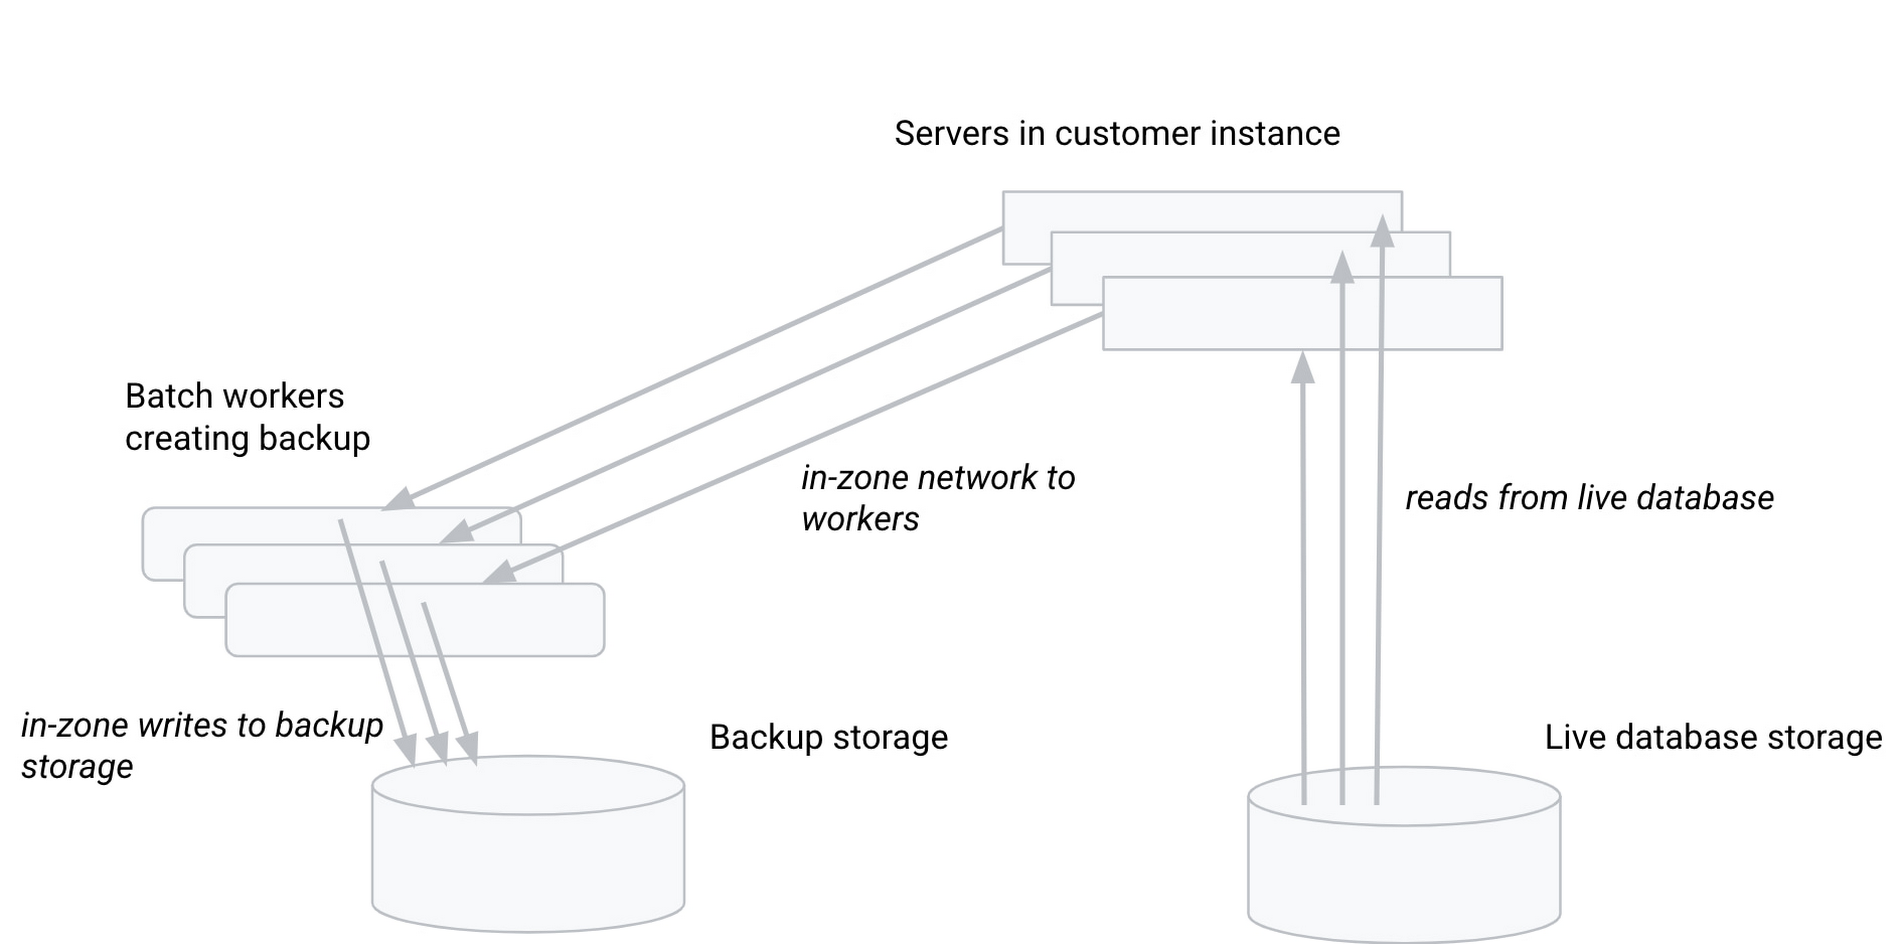
Spanner では、これまでずっとコンピューティングとストレージが分離されていました。しかし、CPU 最適化バックアップが登場する以前は、バックアップ ジョブがお客様のインスタンスの Cloud Spanner サーバーにデータをリクエストして取得していたため、サーバーのロジックがバックアップに含めるデータを正しく判断するうえで重要な役割を担っていました。この図は、CPU 最適化バックアップを行わない場合のデータのフローを表しています。
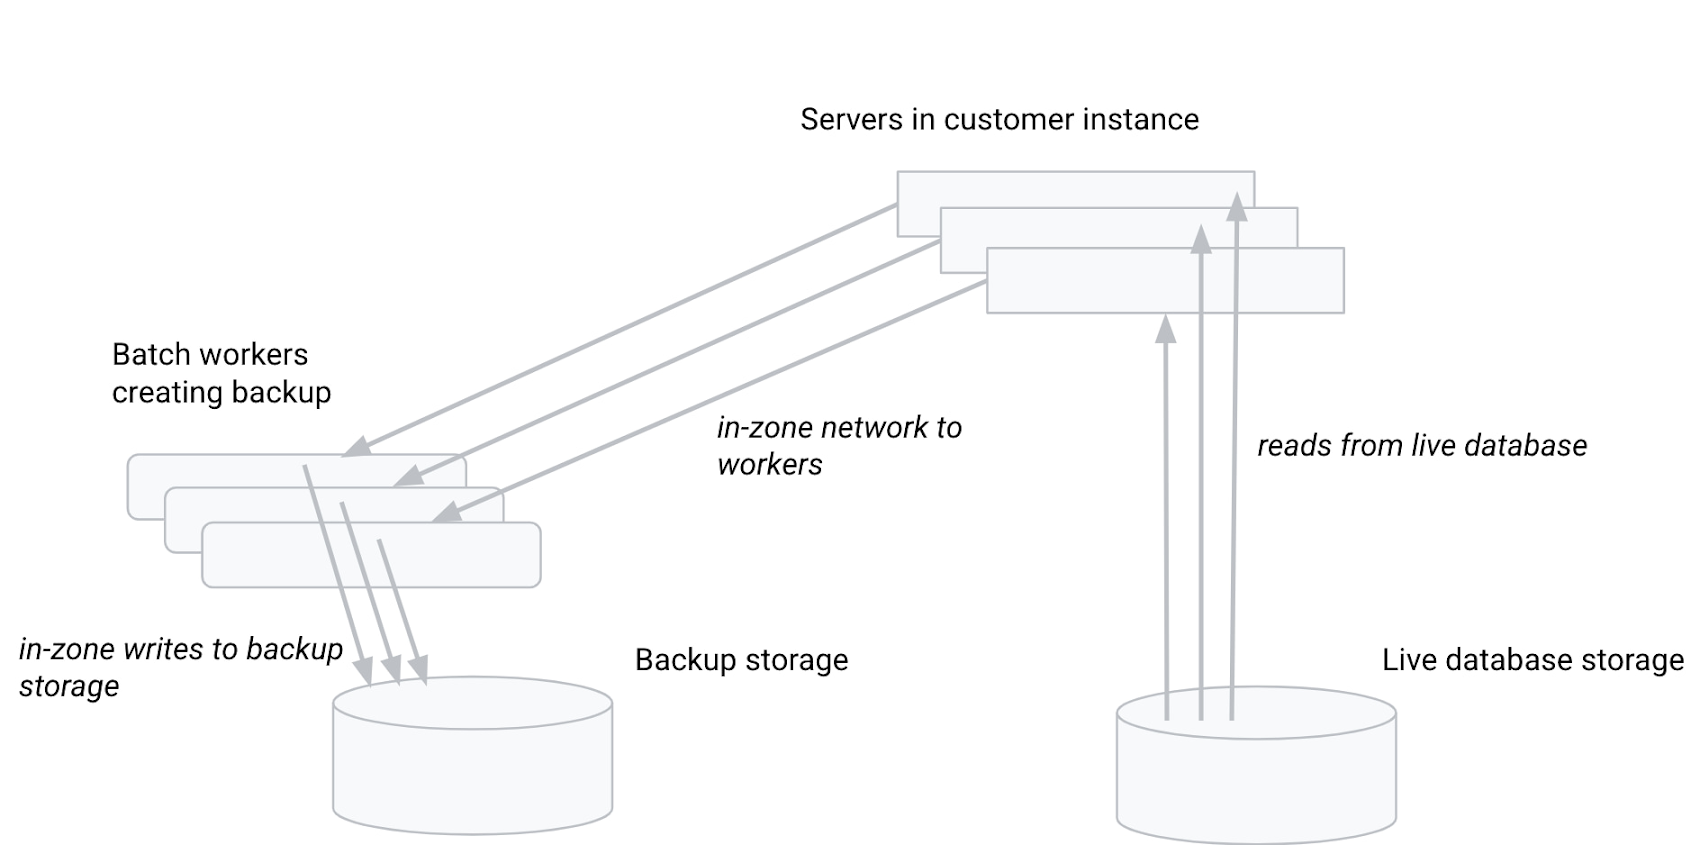
上記の方式では、ストレージ システムもバックアップのバッチジョブもすべて高いスケーラビリティを備えています。その際、お客様のインスタンス サーバーを経由してデータをコピーする際のスループットが制限要因となります。Cloud Spanner サーバーのロジックは、ここで重要な役割を果たします。バックアップに取り込むべき古いデータと、除外すべき新しいデータを切り分けます。新しいデータの例としては、中断されたトランザクションからの部分的な更新や、バックアップのタイムスタンプの後にのみ commit されたトランザクションからの更新があります。
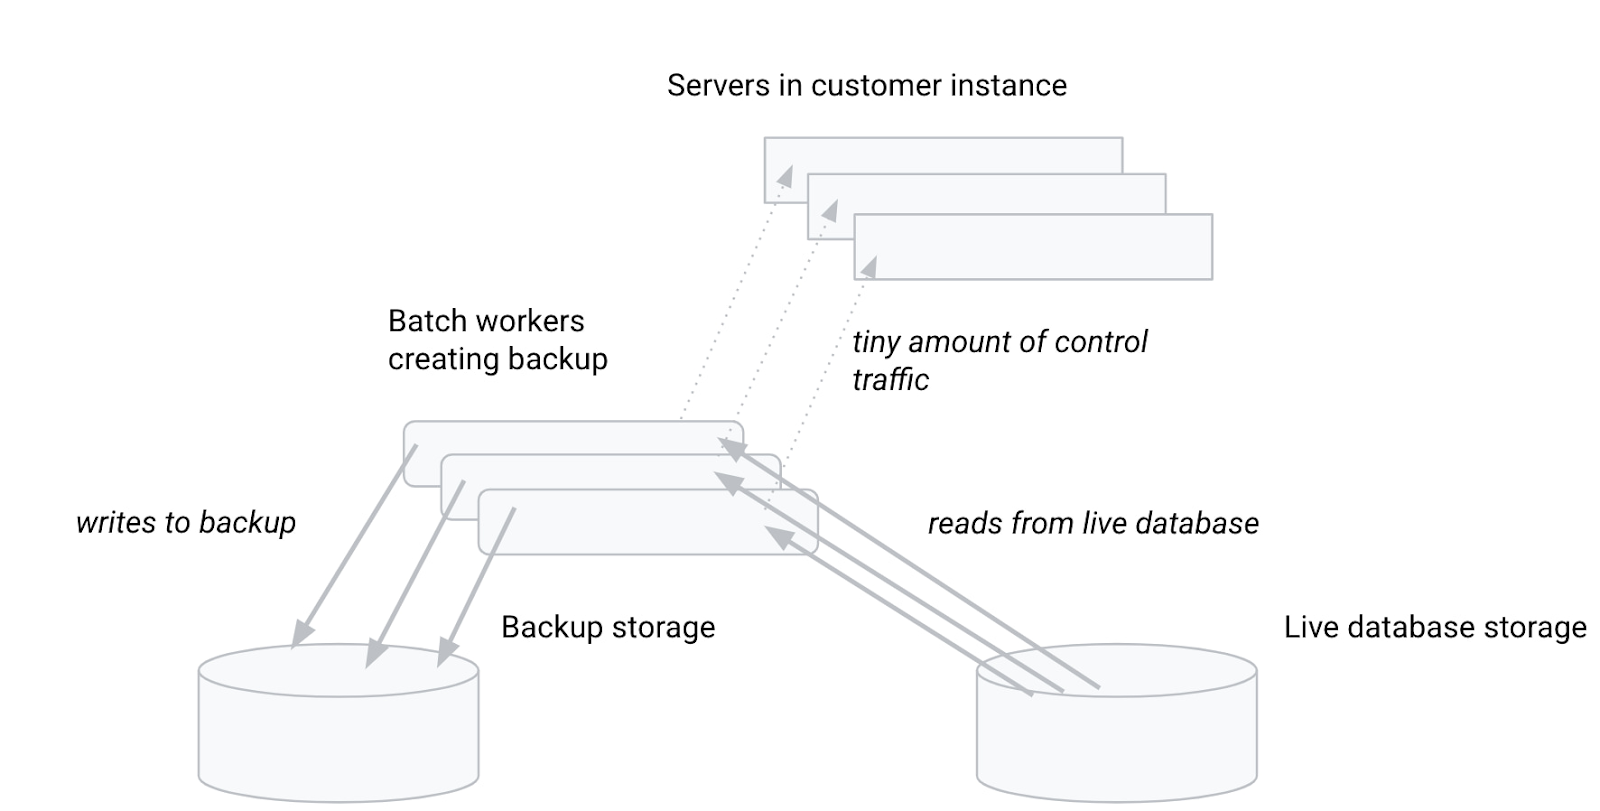
CPU に最適化されたバックアップでは、以前のサーバーサイドのロジックはバックアップ ワーカーのバッチジョブの一部として実行されます。これにより、バックアップに取り込むべきデータと除外すべきデータを切り分ける詳細な処理を、お客様のインスタンス サーバーに行わせることなく行うことができます。その代わり、作業はすべてバックアップ ワーカーのバッチジョブの内部で行われます。
これは、お客様にとっていくつかの重要な利点があります。
バックアップのための CPU ヘッドルームを確保するために、ノードや処理ユニットなどのコンピューティング能力を追加でプロビジョニングする必要がありません。
バックアップによるお客様のインスタンスの CPU 負荷はほぼゼロになり、バックアップ実行中の本番環境ワークロードのパフォーマンスへの影響はありません。
バックアップを作成するバッチジョブは、お客様のインスタンスのサーバー台数に依存せずにスケールできます。基盤となるファイル システムは高度に分散化されており、実質的に無制限の読み取り帯域幅を実現しています(実際には、バッチジョブのクライアント ワーカーの数によって制限されます)。CPU に最適化されたバックアップでは、バックアップ ジョブのサイズとお客様のインスタンスのサイズを切り離し、大規模データベースのバックアップを非常に大きなサイズ(潜在的には数千台)までバーストできるようにしています。
バックアップのパフォーマンスは、スキーマの詳細などデータベース固有の要因を含むさまざまな要因に依存するため、あまり具体的なパフォーマンス予測はしていません。とはいえ、数十〜数百テラバイトのデータベースを含むほとんどのデータベースのバックアップは、通常 1〜2 時間以内に完了することがわかっています。
CPU 最適化バックアップは、Cloud Spanner のデータ保護と障害復旧の技術革新の伝統を受け継いでいます。既存の復元機能は、ゾーンごとのバックアップを活用し、ゾーン間のデータコピーなしで高速な復元を可能にします。ポイントインタイム リカバリは、最新でない読み取り、過去のタイムスタンプのバックアップ、過去のタイムスタンプのエクスポートを使用して柔軟に復元できます。Google は、お客様により良いサービスを提供するために、Cloud Spanner の機能を革新し、改善し続けています。Cloud Spanner は、CPU 最適化バックアップの実装に伴い、追加費用が発生します。しかし、同じ価格でより良い体験をお客様に提供するために、Google は喜んで追加費用を負担します。CPU 最適化バックアップを利用した場合のバックアップ料金に変更はありません。
Cloud Spanner について詳しくは、YouTube 動画または Cloud Spanner のウェブサイトをご覧ください。
- ソフトウェア エンジニア、Gideon Glass