Google の Agentic Data Cloud にエージェントを大規模に強化する新機能が登場
Sirish Chandrasekaran
VP, Product Strategy & Growth, Data Cloud
Raj Pai
VP, Product Management
※この投稿は米国時間 2026 年 11 月 5 日に、Google Cloud blog に投稿されたものの抄訳です。
エージェントの時代に突入したのはそう昔のことではありませんが、今や、組織は本番環境でエージェントを運用し、大きな価値を引き出すようになっています。新たな収益源を獲得する機会となるほか、効率の向上や、リスク管理まで、エージェントを活用した業務の再構築は、企業のリーダーにとって最優先事項となっています。
そこで Google は、Agentic Data Cloud を構築しました。これは、いわゆる System of Action(行動のシステム)であり、その設計思想として、ウォールド ガーデン(閉じられた環境)を取り払ってあらゆるデータを有効活用する、高精度と信頼性を実現する、低コストでプロアクティブに運用する、といったことを重視しています。PayPal、Siemens、Telus、Vodafone、Walmart などの大手企業は、すでに Google とともにビジネス上の成果を上げています。
ここでは、Google の Agentic Data Cloud の主な最新情報をお知らせします。Google は、あらゆる場面でエージェントを強化するとともに、企業ごとのコンテキストに基づいてグラウンディングしながら正確で信頼できる回答を提供するなど、エージェント主体のエクスペリエンスを技術者とビジネス ユーザーの両方にとって優れたものにしています。
ボーダーレスな Lakehouse で、エージェントがあらゆるデータを有効活用
企業データは、マルチクラウド環境やオンプレミス システム、SaaS プラットフォーム(Confluent、SAP、Salesforce、Workday など)まで、あらゆる場所に存在します。オープンな Apache Iceberg 形式を基盤とするボーダーレスな Lakehouse により、データの保存場所を問わず、あらゆるデータを活用することが可能となっており、エージェントは一元管理された基盤を利用できます。この基盤のもとでは、データを移動したり、コネクタを組み合わせたりする必要はなく、想定外の下り(外向き)料金が発生することもありません。インフラストラクチャからモデルまで、あらゆるレイヤで調整済みのスタックを利用できます。実際、Apache Iceberg で管理されているデータは、過去 1 年間で 3 倍以上に増加しています。
ここでは、ボーダーレスな Lakehouse に関連する新しい機能強化をいくつかご紹介します。Gemini がボーダーレスな Lakehouse と直接連携できるようになりました。これにより、ビジネス ユーザーはクラウド全体に分散したレコードに対して、自然言語でクエリすることが可能となります。また、エージェントは推論をグラウンディングできるようになり、ビジネス ワークフローの促進につながります。さらに、AWS および Azure 向けの Cross-Cloud Interconnect とキャッシュ保存が一般提供となり、プライベートで安全な接続を通じて、下り(外向き)料金を追加で支払うことなく、クラウド間でデータをクエリできるようになりました。外部のクラウドデータに対してクエリを実行すると、Lakehouse は取得したデータブロックを Google Cloud 内に自動的にキャッシュ保存します。さらに、Databricks Unity、Snowflake Horizon、AWS Glue とのオープンな Iceberg カタログ連携や、SAP、Workday、Salesforce とのゼロコピー統合も利用できます。
AI にコンテキストを提供するため、ボーダーレスな Lakehouse は Knowledge Catalog と直接統合されています。Knowledge Catalog はクラウド ストレージ内の分散データや非構造化データに自動的にインデックスを付与し、エージェントが適切なコンテキストに基づき正確性を得られるようにします。また、トークン費用も抑えられ、インテリジェントで持続可能なエージェント戦略を実現できます。
「Delivery Hero talabat はボーダーレスな Lakehouse において、Amazon S3 テーブルから Apache Iceberg 形式の単一の元データを BigQuery に連携させることで、データ移動の費用を約 40% 削減しました。また、本番環境のストリーミング トランザクション イベントに対して両方のクラウドから数分以内にクエリできます。」- Delivery Hero talabat、スタッフ データ エンジニア、Harish Ramesh 氏
エージェントがただちにアクションを実行するには、過去の分析データとリアルタイムのトランザクション データの両方に同時にアクセスする必要があります。そこで、AlloyDB とボーダーレスな Lakehouse の新たなインテグレーションについてお知らせいたします。AlloyDB から Iceberg に直接アクセスすることで、ETL パイプラインやコピーを使うことなく、Cloud Storage に保存されている Iceberg テーブルに直接クエリを実行できるようになり、単一の PostgreSQL クエリで本番環境の運用データと過去のレイクハウス データを結合することが可能となります。AlloyDB のトランザクション機能と Iceberg テーブルへの直接アクセスを組み合わせることで、トランザクション データと分析データを効率的に組み合わせて、エージェントからの厳しい要求に応えられるようになります。また、Lakehouse ランタイム カタログと完全に統合されているため、AlloyDB に Iceberg テーブルを他のテーブルと同じように登録できます。これらのテーブルはすべて Knowledge Catalog に自動的に反映されるため、エージェントはガバナンスが適用された共通のコンテキストを取得できます。AlloyDB から Iceberg への直接アクセスは、集計クエリにおいて、Amazon の同等の PostgreSQL 互換サービスよりも最大 7 倍高速です。
このボーダレス戦略の完成度をさらに高めるのが、すでに一般提供となっている Spanner Omni です。これにより、オンプレミス、エッジノード、マルチクラウド環境にまたがるハイブリッド エージェント アプリケーションに、Google グレードの整合性、スケール、マルチモデル機能がもたらされます。
個々のエージェントを企業のコンテキストにグラウンディングして、正確かつ信頼できる回答を提供
エージェントの精度は、グラウンディングの基盤となるビジネス コンテキストの質に左右されます。Knowledge Catalog は、Google Cloud のユニバーサル コンテキスト エンジンであり、元データを共有ビジネス コンテキストに変換して、エージェントがより高い精度、信頼性、トークン効率で回答、行動できるようにします。このたび、Knowledge Catalog がさらに進化し、AI を活用したコンテキスト キュレーション機能が拡張されました。具体的には、自己学習機能、再利用可能なコンテキスト セット、刷新されたユーザー エクスペリエンスによって、コンテキスト レイヤがビジネスに応じて自動的に構築されて進化し続けるほか、人間がデータ ガバナンスを完全に制御できるようになっています。Google 社内のベンチマークによると、Knowledge Catalog の使用により、AI エージェントの精度が約 4 倍向上し、レイテンシは最大 33% 短縮、トークン使用量は最大 75% 削減しています。
企業の組織内で培われたノウハウの多くは、データベースの中ではなく、運用ハンドブックや、ドキュメント、チケットに記されています。そのため、エージェントのコンテキストは、人々が実際に尋ねる質問に寄せながらキュレートする必要があります。Knowledge Catalog の新しい自己学習型エンリッチメント(プレビュー版)では、コンテキスト キュレーションという重労働をエージェントが担います。具体的には、Knowledge Catalog が、Google Workspace、GitHub、Jira、Confluence、SharePoint などの非構造化ソースを継続的にマイニングし、ユーザー インテントや人間とエージェント間のあらゆるやり取りから学習して、コンテキストを補いながら自動的に進化させます。また、ローカルな知識を Open Knowledge Format(OKF)コンテキスト セットにパッケージ化して再利用できるようにすることで、コンテキスト エンジニアやデータ スチュワードが拡充されたコンテキストを簡単に管理できるようにしています。さらに、データ スチュワードとデータチーム向けに、Knowledge Catalog の新しい Studio エクスペリエンス(プレビュー版)も導入されました。会話型ユーザー インターフェースを通じて、自然言語でコンテキストを探索したり、クラウド環境および SaaS アプリケーションにまたがるデータ資産全体を可視化したり、提案されたコンテキスト拡充点をチェック、監査、承認したりできます(バージョニングとロールバック機能も完備されています)。
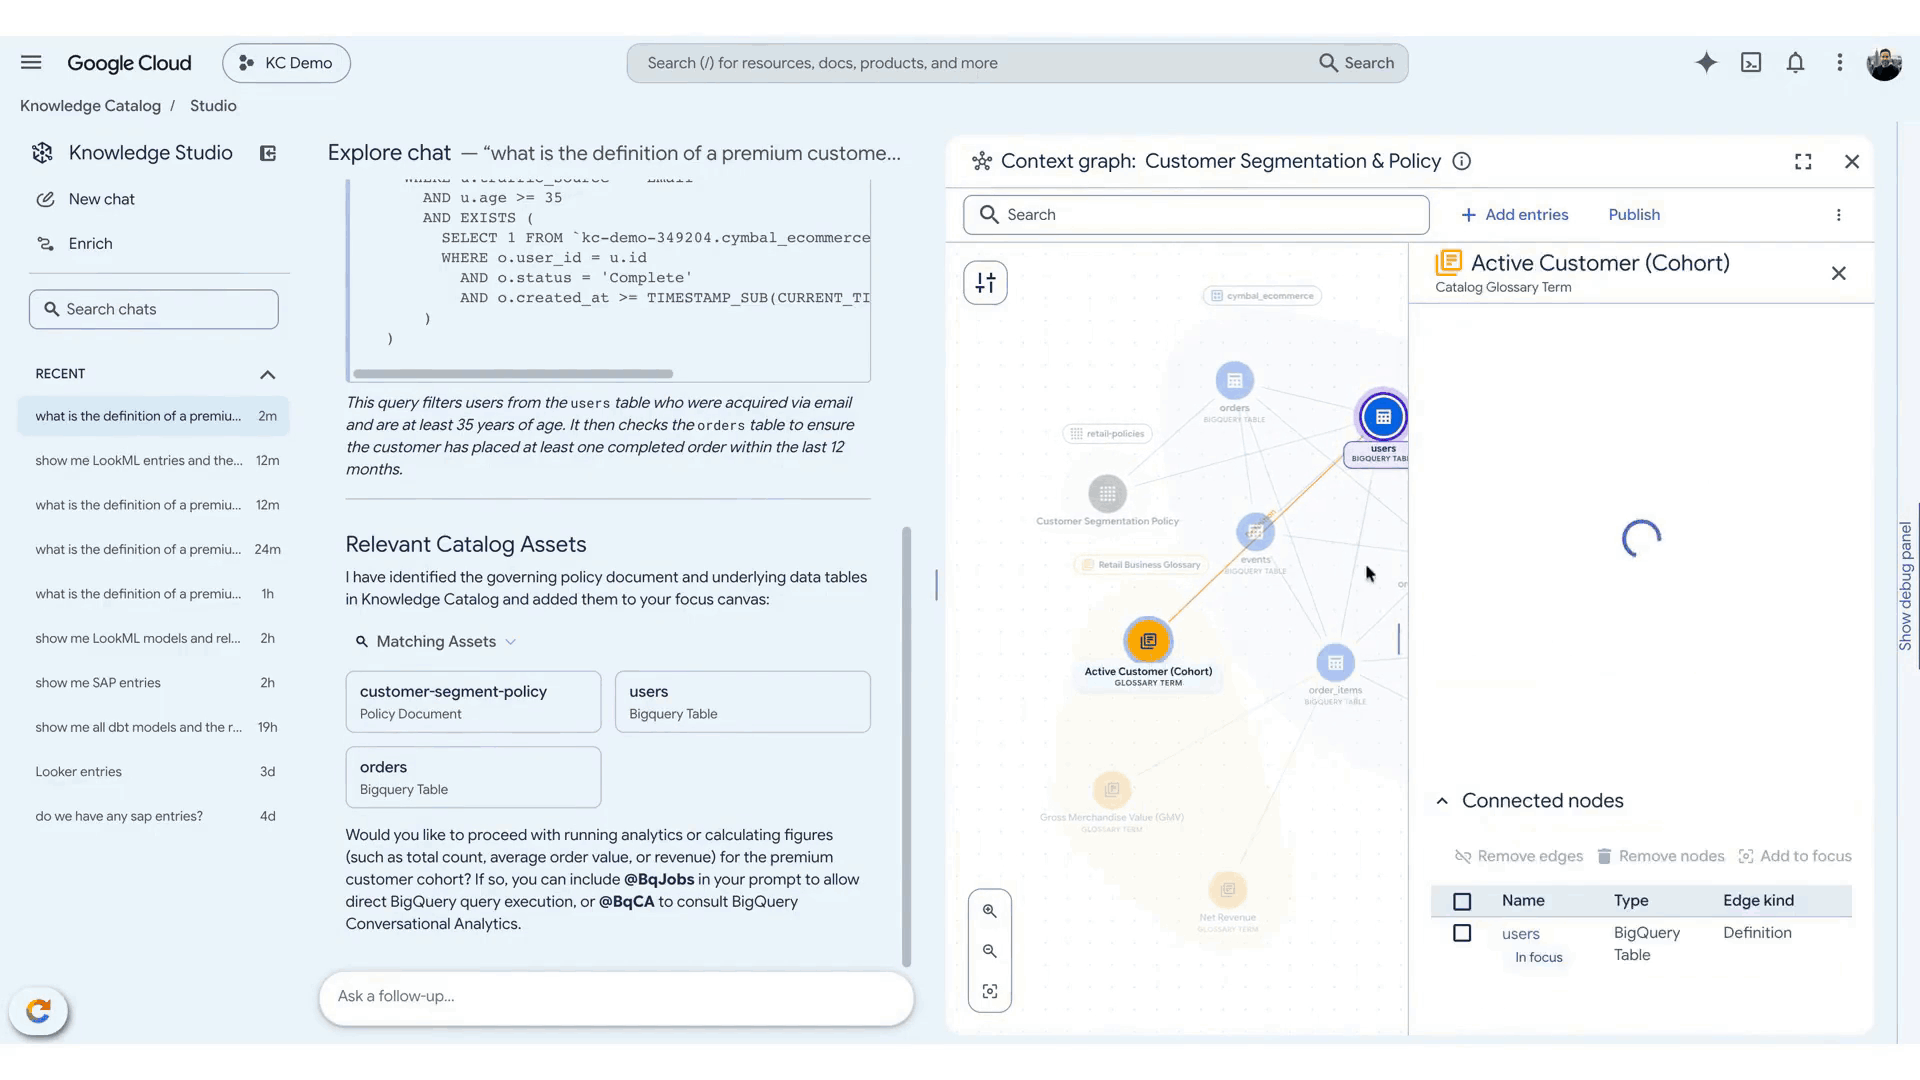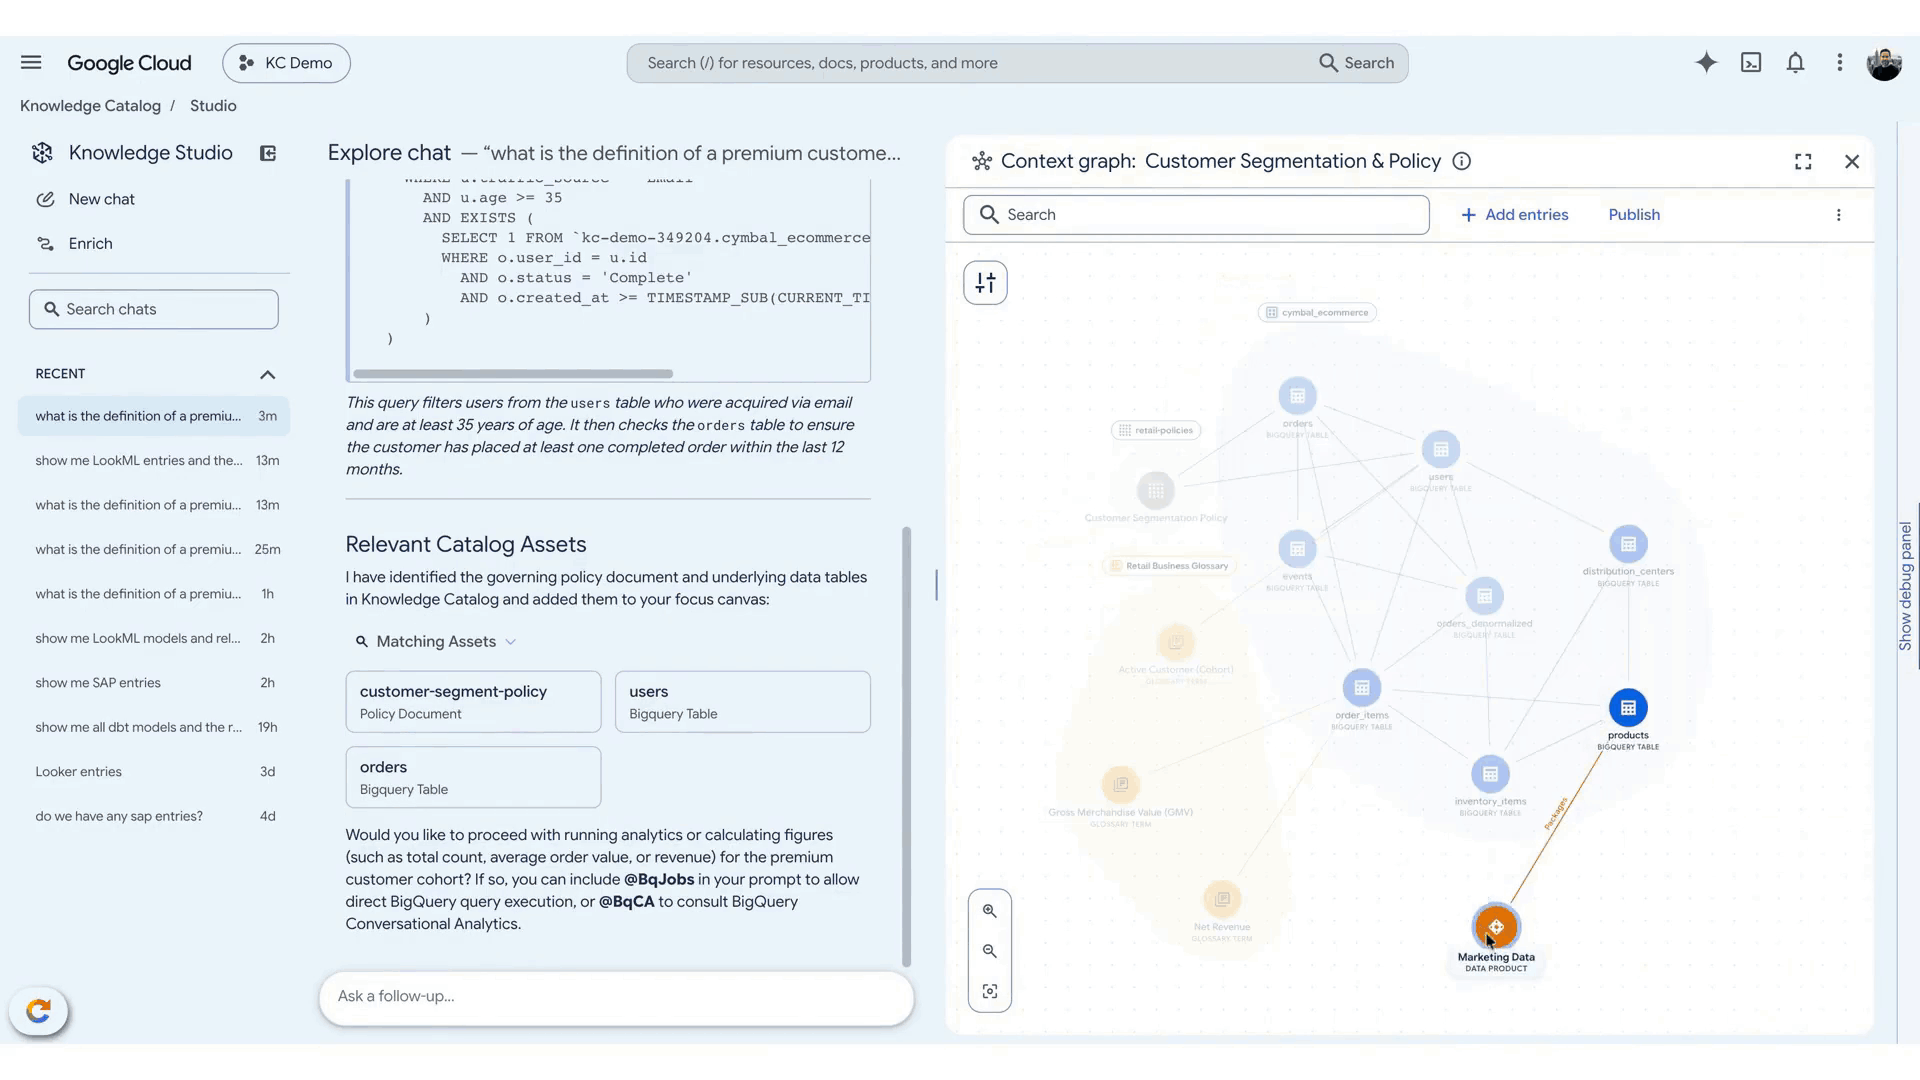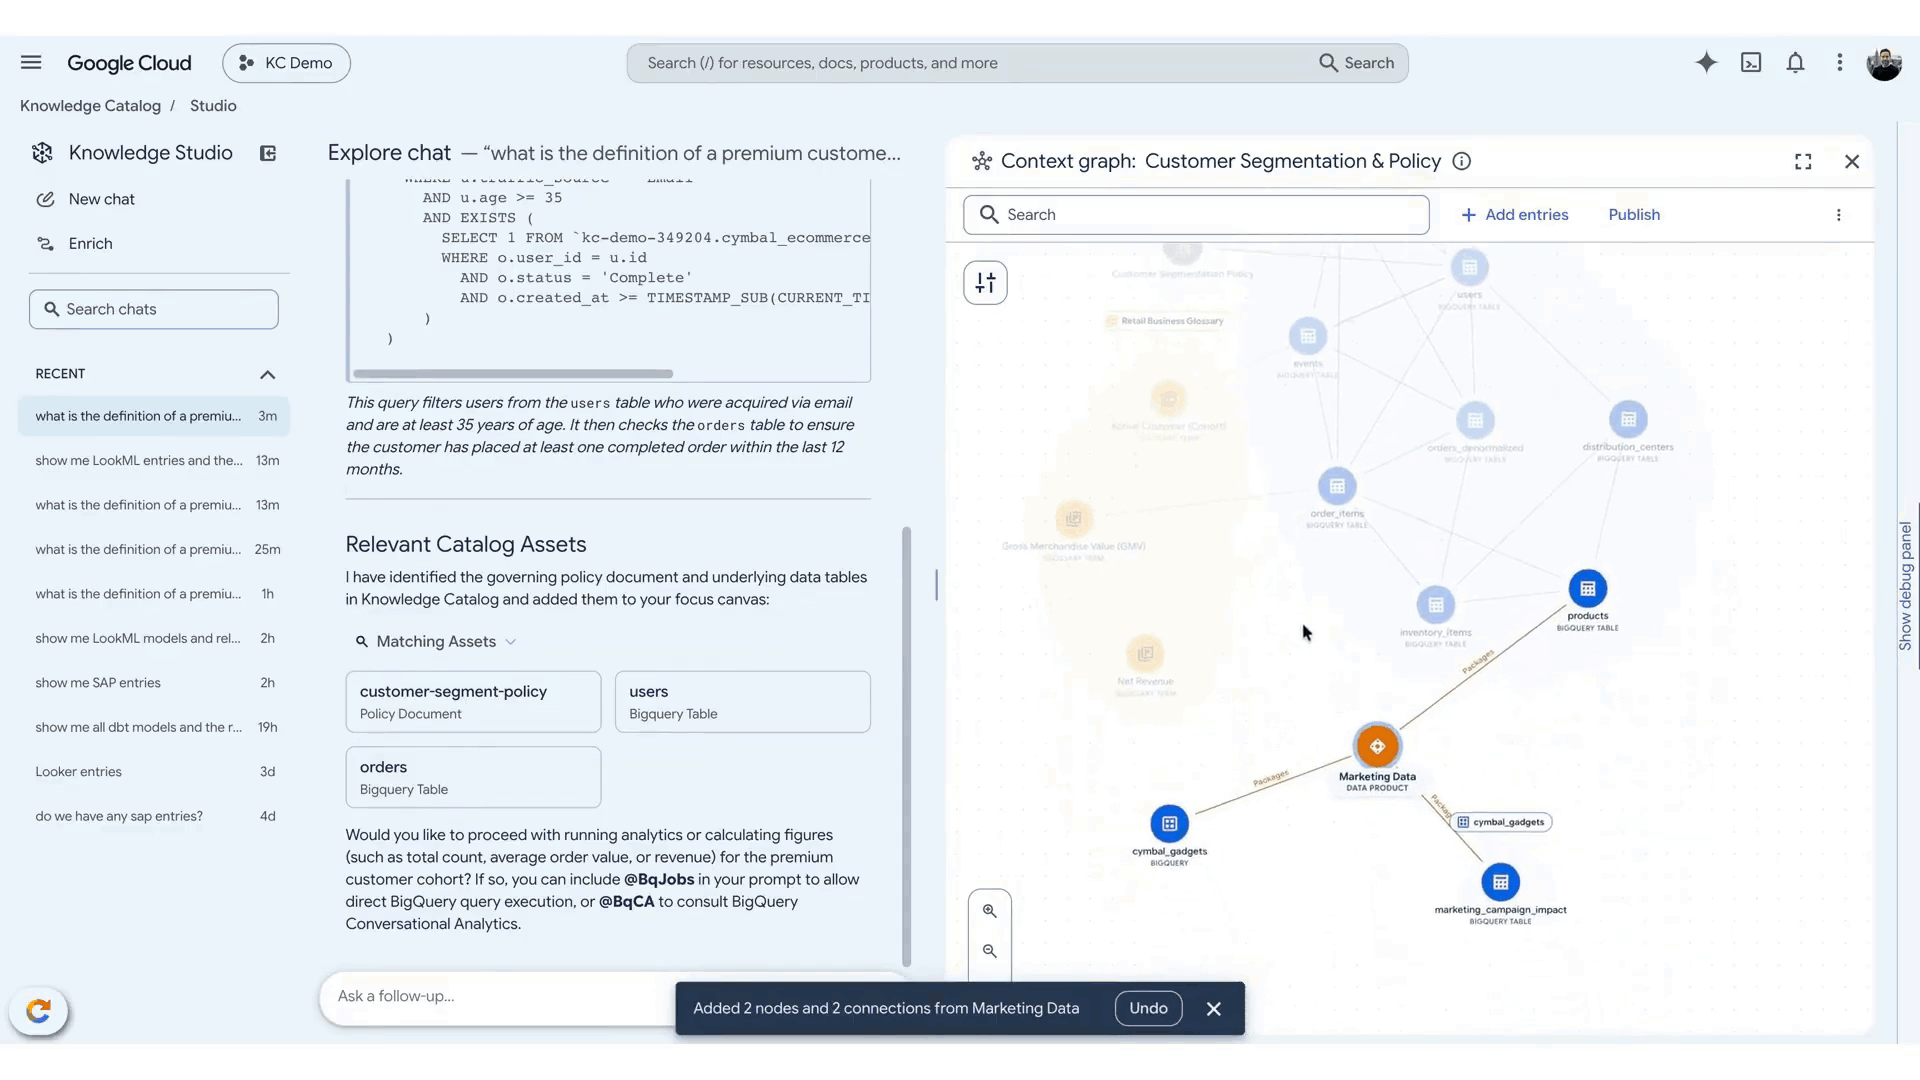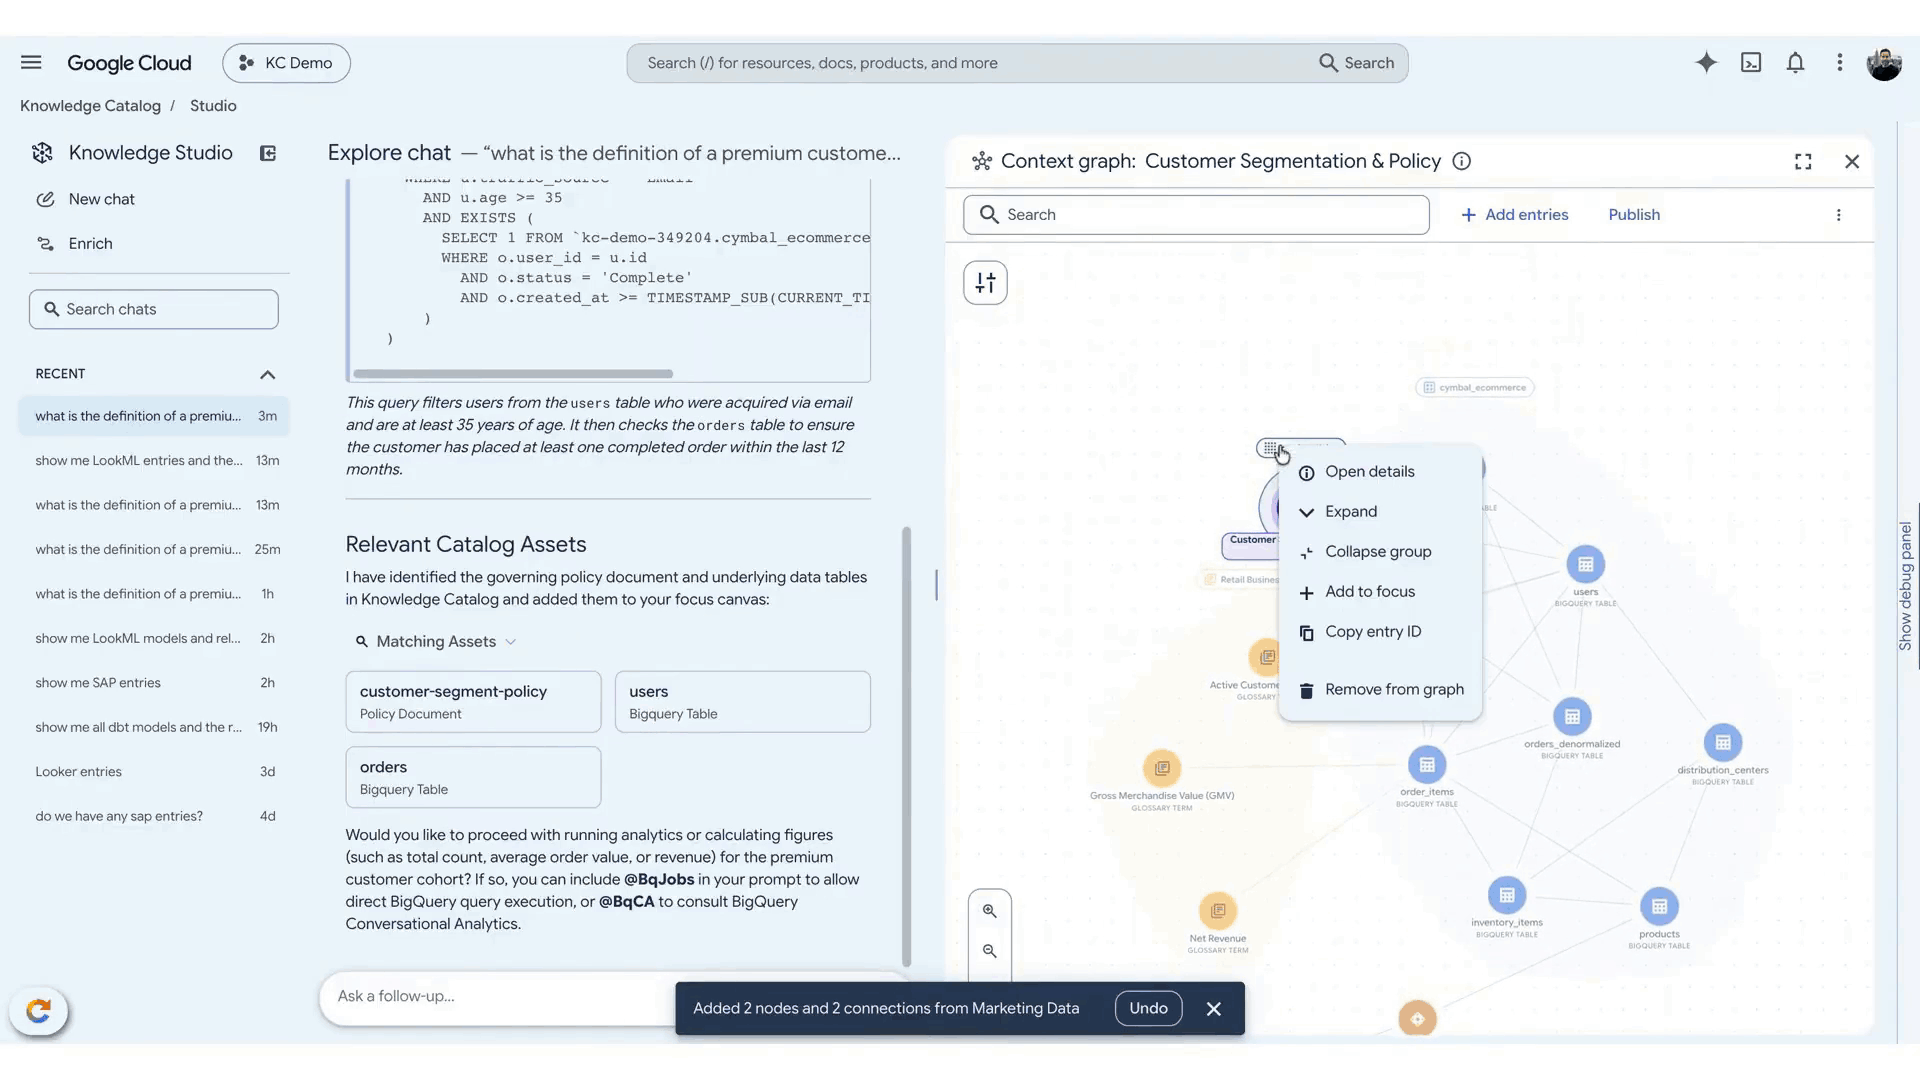
Knowledge Catalog の新しい Studio インターフェースでは、会話を通してコンテキストを探索でき、図がインタラクティブに変化します
さらに、Knowledge Catalog が Gemini でデフォルトで有効になりました(現在プレビューとして公開中)。これにより、データに関するあらゆる質問が、適切に管理されたビジネス コンテキストに自動的にグラウンディングされるようになります。Knowledge Catalog は、BigQuery、AlloyDB、Cloud SQL、Spanner との接続を経て、ビジネス用語の解決、信頼できるテーブルの特定、結合パスの判断までを行い、各ユーザーのアクセス権も考慮しながら SQL を生成します。こうした仕組みにより、エージェントは登録済みの共有コンテキスト セットに基づいて精度を一貫して確保できるほか、レイテンシの短縮やトークン費用の削減にもつながり、組織は自信をもってエンタープライズ規模でエージェントをデプロイすることが可能となります。
なお、重要なビジネス定義については LLM の推量に任せることはできません。そこで役立つのが、Knowledge Catalog が信頼できるセマンティック モデルにエージェントをグラウンディングする機能であり、このたび一般提供となりました。グラウンディングのソースは BigQuery、Looker(LookML)、Databricks、Snowflake、dbt、SAP に対応しており、データの移動は発生しません。これにより、財務上の純収益から、業務上の顧客離脱率の計算まで、ビジネスチームが使用している適切に管理された数式と同じものを使用できます。さらに、Knowledge Catalog では、メタデータの検出およびフェデレーションを Oracle AI Database@Google Cloud、Snowflake、Databricks Unity Catalog や、サードパーティのカタログ(Atlan、Collibra など)にも拡張できます。これにより、既存のカタログを活用しながら、データ資産全体を普遍的に理解することがあらゆるエージェントで可能となります。
実務担当者のエージェント エクスペリエンスを変革
Google は、データ専門家やビジネスチームの働き方をまったく新しいものへと変革します。具体的には、個々の従業員は、アシスタントという相棒のサポートを受けながら働く実務担当者から、自律型エージェントのオーケストレーターへと進化し、これらのエージェントが意図に基づきビジネスの成果を促進していく、という形になります。
先日の Gemini at Work イベントでは、技術チームと一般的なビジネス ユーザーのそれぞれに向けた Gemini の 2 つの新機能を紹介しました。データ エンジニアや ML エンジニア向けには、Gemini の ML スキルやツールが拡張されており、エージェント群がこれらを使ってあらゆるデータ サイエンティストやデータ エンジニアを支えます。エンジニアが求める結果を平易な言葉で説明すると、Gemini が PySpark コードの生成はもとより、それを編集してテストするためのノートブックの提供、モデルのトレーニング、パイプラインの問題のトラブルシューティングおよび修正までを行います。一方、ビジネス ユーザーは誰でも、質問するだけで信頼性の高いリアルタイムの業務レポートを生成できます。Gemini の業務レポート生成スキルが BigQuery および Knowledge Catalog と統合され、クエリを構築して保存するところまでを行います。クエリをいったん保存すれば、オンデマンドでレポートを実行し、トークン費用を生じさせることなく、毎回検証を経た一貫性のある回答を確実に得られるようになります。
さらに、これまでどおり独自ツールを使い続けたいデベロッパーのために、Data Agent Kit の一般提供が近ごろ発表されました。Google データクラウド ツールを、デベロッパーが自分の好きな IDE や CLI(VS Code、Claude Code、Antigravity など)に直接統合できるため、コンソールを切り替えたり、お決まりの ETL 処理を記述したりする必要がなくなります。具体的には、ネイティブの MCP ツールが完備されており、ビジネス インテントを定義するだけで、エージェントにデータ パイプラインの生成、調整、テストを任せられます。
エージェントの規模に対応するデータ インフラストラクチャの構築
ワークフロー内で連携するエージェント数が数百万単位へと規模が拡大すると、従来のデータベース アーキテクチャでは破綻に陥ります。Google は、このようなエージェントの規模に対応できるよう、特別に設計、カスタマイズされたインフラストラクチャの導入に取り組んでいます。
迅速なテストとプロトタイピングを促進するため、このたび AlloyDB Express のプレビュー版をリリースいたします。これは、開発速度を極限まで高めたいビルダーやコーディング エージェント向けに設計された、AlloyDB の新しいエディションです。このエディションは、2 秒未満の即時プロビジョニングをはじめ、ゼロへのスケーリング(一時停止)と再開、安全なプライベート IP 接続、オブザーバビリティの統合、小さなフットプリント(1~2 個の vCPU と 20 GB のストレージ)という特徴があります。この AlloyDB は、主にデベロッパーに対して、エージェントの開発およびテストのための PostgreSQL 環境を提供します。
一方、本番環境向けに、AlloyDB のエージェント向け PostgreSQL(プレビュー版)を最近発表しました。これを使えば、ワークロードを完全に分離した状態で、連携動作する数千の AI エージェントが本番環境のトランザクション データにクエリすることが可能となります。このエージェント対応のデータベース アーキテクチャでは、ミリ秒未満の I/O およびテラビット/秒の合計スキャン スループットが実現され、エージェントが 1 秒あたりに処理可能なクエリ数が 300 万以上に達します。コンピューティング リソースは、アクティブな推論セッションに基づいて自動的にスケールされ、アイドル状態になると本番環境システムに影響を与えることなくゼロにスケールダウンされます。
オープンソースのデータ インフラストラクチャ実行環境に関しては、Managed Service for Apache Spark が Lightning Engine のさらなる改善により、市場の同等サービスと比較してコスト パフォーマンスが 3 倍以上になっています。Spark 4.0 に対して最近行った機能強化により、起動が高速化されており(追加費用なし)、インタラクティブなワークロードや小規模なバッチ ETL ジョブにおいて効果を発揮します。さらに、プレミアム ティアでは、アップグレードされたハードウェアと Lightning Engine のソフトウェア アクセラレーションの組み合わせによりパフォーマンスが向上しており、これはデフォルトで有効になっています。
さらに、エージェントのスケールに対応できるよう、BigQuery の強化にも継続的に取り組んでいます。この過去 1 年間だけに限っても、流動的なスケーリングおよび組み込みのワークロード アクセラレーションなどのインテリジェントな最適化により、クエリ処理のコストを 50% 以上削減し、40% 以上高速化しました。また、BigQuery Graph の一般提供が始まり、ペタバイト規模のグラフ分析をリレーショナル テーブルで直接、ETL なしで実行できるようになりました。BigQuery Graph でデータをノードおよびエッジとしてモデル化できるため、データを別のグラフ データベースに移動することなく、複雑で隠れた関係を明らかにすることが可能となります。さらにこのたび、Google Research が提供する 2 つの新しいモデルを BigQuery でネイティブに実行できるようになりました。1 つ目は、現在プレビュー版の TimesFM 3.0 であり、カスタムモデルをトレーニング、管理しなくても、SQL で直接予測を生成できます。2 つ目は、同じくプレビュー版の TabFM であり、BigQuery に予測 ML を直接組み込めます。
使ってみる
上でお伝えした事柄に加えて、Google は、より広範なデータ エコシステム全体を通じて、コア パフォーマンス、コスト管理、運用レジリエンスの強化を継続的に行っています。
データ資産をアクティブな System of Action に変革する準備はできていますか?Agentic Data Cloud のページをご覧になるとともに、データ戦略ワークショップにご登録ください。Google Cloud で、エージェント時代のエンタープライズの構築を無料で始めましょう。
また、デジタル イベント「Trusted Agents, Real Outcomes(信頼できるエージェント、確かな成果)」では、Agentic Data Cloud のビジョンと最新のイノベーションを紹介していますので、こちらもどうぞご覧ください。ポートフォリオの実際の活用例や、Yahoo の実例を紹介するほか、データベース、データ分析、BI のプロダクト リーダー陣が詳細な解説を行っています。
- データクラウド プロダクト戦略および成長担当バイス プレジデント、Sirish Chandrasekaran
- プロダクト管理およびデータベース担当バイス プレジデント、 Raj Pai