AlloyDB for PostgreSQL から Iceberg に直接アクセスして、運用データと Lakehouse データを統合する
Nikhil Gaekwad
Product Management Lead, Databases
Bala Narasimhan
Group Product Manager, Databases
※この投稿は米国時間 2026 年 11 月 5 日に、Google Cloud blog に投稿されたものの抄訳です。
適切なビジネス上の意思決定を行うには、運用データベースから得られるビジネスの最新状況と、レイクハウスやデータ ウェアハウスなどの分析システムに保存されている履歴コンテキストという 2 種類のデータが必要です。従来、これらのシステムは別々のものでしたが、現在では急速に統合が進んでいます。こうした状況を受け、このたび AlloyDB for PostgreSQL から Iceberg に直接アクセスする機能(プレビュー版)を発表いたしました。デベロッパーは、Cloud Storage バケットに保存されている Apache Iceberg テーブルに対して AlloyDB から直接クエリし、最新の運用データと結合できるようになります。こうした処理をすべて、単一の SQL クエリで実行できます。
さらに、AlloyDB 同期と Lakehouse フェデレーションの一般提供も始まりました。Lakehouse は、データのオープンなコピーを 1 つ保持して、あらゆるエンジンから利用できるのが特徴ですが、このボーダーレスな Lakehouse を AlloyDB から操作する方法がこれで全部で 3 つになります。事例として、Etsy はボーダーレスな Lakehouse から 3 ペタバイトのデータを移動することなく結合して、パイプライン クエリを 60% 高速化しました。データの保存場所やアプリケーションからの読み取り方に応じて、AlloyDB では次のいずれかのアプローチを使用できます。
-
Iceberg への直接アクセス: AlloyDB カラム型エンジンによって、Iceberg テーブルを動かすことなくその場で高速に読み取ります。
-
AlloyDB 同期: レイテンシについて妥協できないワークロードに対して、指定間隔で同期された Lakehouse データを AlloyDB から提供します。
-
Lakehouse フェデレーション: ネイティブの BigQuery テーブルを動かすことなくその場でクエリを実行し、BigQuery で処理します。
このたびの新機能により、アプリやエージェントは、運用データと Lakehouse データをまとめて処理するために、カスタム パイプラインを構築、管理する必要がなくなります。
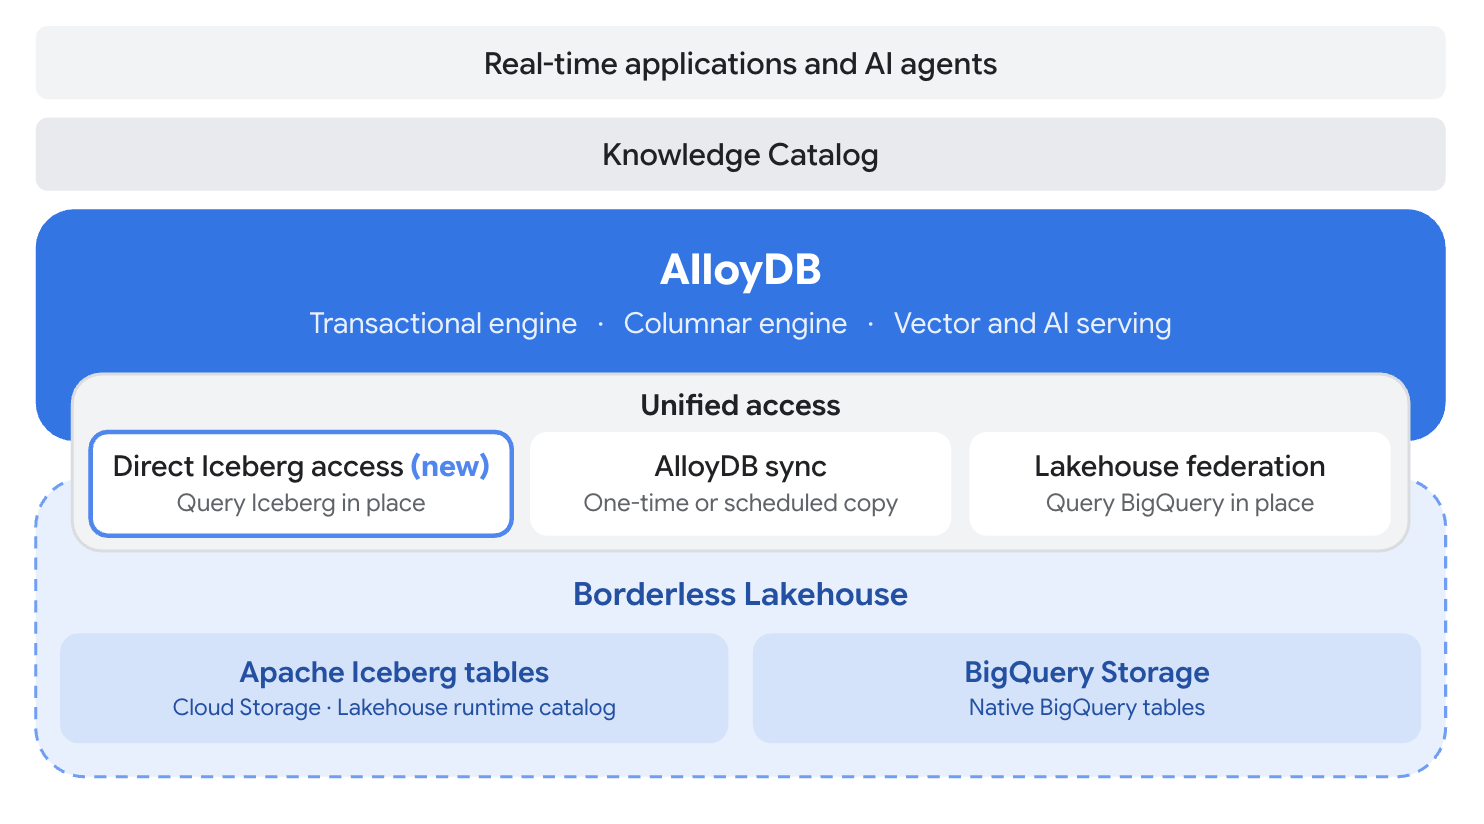
AlloyDB とボーダーレスな Lakehouse: Apache Iceberg または BigQuery データを動かさずにその場で直接クエリするか、または AlloyDB にデータを同期できます。これにより、リアルタイム アプリケーションや AI エージェントに対して、運用データおよび Lakehouse データの両方への制御アクセスを提供することが可能となります。
アクションと同時に意思決定
AlloyDB とボーダーレスな Lakehouse のインテグレーションにより、過去のコンテキストと本番環境のトランザクションの直接連携が可能となるため、カスタム パイプラインを構築、管理しなくても、アクションと同時に意思決定を行えるようになります。例:
-
不正行為やリスクの判定: 不正行為検出エージェントが、支払いの承認前に、データベース内の過去 30 日間の履歴に加えて、Iceberg 内の過去 5 年間の顧客取引履歴をチェックできます。
-
パーソナライズ: ショッピング エージェントが、ページに滞在中のユーザーのカート情報と、Lakehouse からのライフタイム バリューおよび返品履歴を組み合わせて、最適な特典情報を判断します。
-
動的な価格設定: 価格設定エージェントが、AlloyDB のリアルタイムの在庫と、Lakehouse の需要および天候の履歴データを組み合わせて、状況に即した価格を設定します。
-
データ プロダクト: データチームがキュレートしたテーブルを Iceberg にひとたび公開すれば、数十のアプリケーションがそれぞれ独自のコピーを保持することなく Iceberg から読み取れるようになります。
いずれの場合も、履歴は Lakehouse に残り、意思決定はデータベース側で行います。具体的には、エージェントが、アクセス許可されたテーブルおよび権限を使って、AlloyDB で人間の代わりに処理を行います。
では、3 種類の統合方法について詳しく見ていきましょう。
AlloyDB から Iceberg への直接アクセス(プレビュー版)
Iceberg への直接アクセスでは、AlloyDB はバケットパスまたは Lakehouse ランタイム カタログを使用して、Cloud Storage から Apache Iceberg テーブルを直接読み取ります。Iceberg テーブルをいったん登録すると、他の PostgreSQL テーブルと同様にクエリを実行できるようになり、本番環境の運用テーブルとの結合も行えます。
AlloyDB は、Lakehouse のデータをコピーすることなく、Iceberg テーブルをその場で読み取って、本番環境の運用データと結合します。
AlloyDB に Iceberg サポートが組み込まれ、AlloyDB カラム型エンジンによって加速される仕組みになっているため、Lakehouse データへのクエリが高速に処理されます。これらのクエリは、アプリケーションが使用するのと同じデータベース インスタンス上で実行され、読み取り用インスタンスを別途用意する必要はありません。また、社内の諸部門が Lakehouse に公開した最新のデータを読み取れます。
Cloud Storage の 1 TB のデータセットを対象に、集計クエリを使ってテストしたところ、AlloyDB から Iceberg への直接アクセスは、Amazon の同等の PostgreSQL 互換サービスよりも最大 7 倍高速、オープンソースの PostgreSQL 拡張機能よりも最大 3.5 倍高速でした。
AlloyDB 同期による最小レイテンシの読み取り(一般提供)
どんなテーブルでも動かさずにその場で読み取ったほうがいい、というわけではありません。たとえば、小売業者のリスクスコアは、支払いが発生するたびに参照、チェックされますが、このスコアが変更されるのは、データチームが夜間に再計算したときのみです。このように、リクエストのたびに読み取られ、更新はスケジュールに従って行われるようなデータは、AlloyDB 内にローカル テーブルとして持つと処理が最速となります。このようなケースでは、パイプラインを構築、維持することなく、データのコピーを最新状態に保つことが課題となります。
AlloyDB 同期は、Lakehouse データを BigQuery から AlloyDB に一度、またはスケジュールに従って定期的にコピーし、最新の状態に保ちます。このコピーは AlloyDB のローカル テーブルとなるため、アプリは他のテーブルと同じ速度で読み取ることができます。また、インデックスを作成したり、読み取りプールを使用したり、カラム型エンジンやベクトル検索を使ったりすることもできます。同期処理は、BigQuery コンソールまたは SQL からワンクリックで開始できます。
Lakehouse フェデレーション(一般提供)
すでに BigQuery に長年の分析データを蓄積している組織は、Lakehouse フェデレーションによって、ネイティブの BigQuery テーブルを動かすことなく AlloyDB から直接クエリして、本番環境の運用データと結合するところまでを、1 つのクエリで行えます。AlloyDB は、フィルタリング、集計、制限の処理を BigQuery に push し、BigQuery がほとんどの処理を行って、結果のみを返します。また、これらのクエリに対して課金されるプロジェクトを設定したり、クエリを使用できるロールを制限したりすることもできます。
Loyal Guru などの Google Cloud のお客様は、すでに AlloyDB と BigQuery をこのように組み合わせて使っています。
「AlloyDB を、BigQuery のような Google Cloud プロダクトと併用すれば、プラットフォームの機能を継続的に強化していくためのアジリティとパフォーマンスを確保できるほか、後手に回らぬよう新たなトレンドを予測することもできます。」 - Loyal Guru、共同創業者 / 最高技術責任者、Javi Fernández 氏
適切な方法を選んで使ってみる
現在、運用システムと分析システムを統合する動きが広がっています。Google Cloud 環境でそれを実現する方法は、以下のようにユースケースに応じて選択できます。
-
Iceberg への直接アクセス: アプリで Iceberg の過去データと本番環境のデータを統合する場合は、この方法が最適です。この方法では、AlloyDB カラム型エンジンによって処理が高速化されます。
-
試す: Iceberg への直接アクセスを PostgreSQL 18 インスタンスで有効にしてから、AlloyDB から Iceberg データにアクセスするの手順に沿って操作してください。
-
AlloyDB 同期: アプリがテーブルの読み取りを頻繁に行い、レイテンシを最小におさえたい場合に最適です。読み取るコピーは、更新後の最新のものとなります。
-
実装する: Google Cloud コンソールまたは psql を使って、BigQuery のテーブルを選択して AlloyDB に同期します。
-
Lakehouse フェデレーション: ネイティブの BigQuery テーブルに保存されている履歴データを BigQuery で処理したい場合に最適です。
-
始める: BigQuery のリアルタイム データへの AlloyDB アクセスを構成するの手順に沿って操作してください。
詳細については、AlloyDB から BigQuery データにアクセスする方法を選択するをご覧ください。
- データベース担当プロダクト管理リード、 Nikhil Gaekwad
- データベース担当グループ プロダクト マネージャー、Bala Narasimhan