Knowledge Catalog に新しい自己学習型コンテキスト エンリッチメントを導入
Firat Elbey
Group Product Manager, Data Analytics
Vasiya Krishnan
Product Lead
※この投稿は米国時間 2026 年 10 月 23 日に、Google Cloud blog に投稿されたものの抄訳です。
このたび、Google Cloud のエージェント向けコンテキスト エンジンである Knowledge Catalog で、自己学習型のコンテキスト エンリッチメント(プレビュー版)と、刷新された Knowledge Studio エクスペリエンス(プレビュー版)をリリースしました。自己学習型のエンリッチメントは、Knowledge Catalog 既存の Gemini によるエンリッチメントをベースにしており、エージェントとユーザー間のやり取りを分析してギャップを特定することで、ビジネス コンテキストを正確かつ最新の状態に保ちます。Knowledge Studio は、コンテキスト エンジニアとデータ スチュワードのための新しいコマンド センターです。会話形式でデータ資産を探索したり、視覚的なコンテキスト グラフ上で関係性を把握したりできるほか、コンテキスト グラフへの変更案をユーザーやエージェントに公開する前に確認することもできます。
エージェントの性能は、その推論のベースとなる組織全体の定義、ルール、関係、すなわちコンテキストの質に左右されます。そのため、コンテキストのキュレーションは企業における AI エージェント活用において最も重要な取り組みの一つとなっています。現在、キュレーションの大部分は手作業で行われています。コンテキスト エンジニアはエージェントごとにプロンプトとマッピングを記述し、データ スチュワードは数千ものアセットにわたり定義を手動で更新して最新の状態に保とうとします。しかし、組織のエージェントが数個から数千個、そして最終的には数百万個へと拡大していくと、この方法では対応できなくなります。
Knowledge Catalog の Gemini を活用した自己学習型エンリッチメントは、手動によるメンテナンス作業を、継続的なフィードバック ループへと進化させます。エージェントとユーザーのやり取りを分析することで、不足している情報や古くなったコンテキストを的確に特定します。さらに、ハンドブック、コード リポジトリ、ビジネス ドキュメントから検証済みの定義を抽出して、ガバナンスの効いた再利用可能な「コンテキスト セット」として集約します。また、最適化された検索により、各エージェントは肥大化したプロンプトや未加工のスキーマから推論するのではなく、必要なコンテキストを正確に取得して、組織全体で蓄積された学習成果を活用できます。社内ベンチマークによると、Knowledge Catalog の使用により、AI エージェントは精度が約 4 倍向上、レイテンシは最大 33% 短縮、トークン使用量も最大 75% 削減されます。
Gemini を活用した自己学習型のエンリッチメントでコンテキストを最新の状態に維持
Gemini エージェントに「前四半期の EMEA の純収益はいくらだった?」という簡単な質問をするとします。正しく回答するには、会社が純収益をどのように定義しているか、受注データがどのテーブルに保持されているか、そしてそれらがどのように結合されているかを把握している必要があります。しかし、そうした知識は通常、Google ドキュメントの財務ハンドブック、GitHub のデータモデル、Confluence ページなどに分散しています。従来の静的なデータカタログでは、エージェントが適切なデータを効果的にクエリできるように、現場のエキスパートがビジネス定義、指標、その他のコンテキストを手動で集めて更新する必要があります。しかし、実際にはエキスパートがすべてのアセットを文書化する余裕などありません。そのため、財務チームが翌四半期のパートナー クレジットの処理方法を改訂した瞬間、静的な定義と実態にずれが生じ、数式がハードコードされたすべてのエージェントが間違った回答を返すようになります。
Knowledge Catalog のエンリッチメント機能は、チームのすべてのドキュメント、リポジトリ、テーブルといったビジネス ナレッジがすでに保存されている場所で機能します。自社やサードパーティのソースにわたる構造化データはもちろん、Cloud Storage、Google Workspace、GitHub、Confluence、SharePoint の非構造化データとも連携します。ビジネス ナレッジの検出、抽出、体系化、維持を自動で行い、ハンドブックや Wiki などの非構造化ソースとそのコンテキストを Knowledge Catalog のテーブルやスキーマといった構造化メタデータに紐づけます。これにより、構造化データの検出と活用が大幅に容易になります。また、オンデマンドまたはスケジュール実行により、ビジネス定義、テーブルや列の説明、結合関係、ゴールデン クエリ、タスク固有のエージェント指示などを、それぞれのソースの引用と信頼スコアを添えて自動提案します。実行のたびにソースでの変更を検出し、古くなった定義を廃止するとともに競合をフラグ付けして、確認を促します。
エンリッチメント機能は、ユーザーとエージェント双方のインタラクションから学習します。エンリッチメントを構成すると、PII を秘匿化しながら、Gemini エージェント、BigQuery の会話型分析、カスタム エージェントからのインタラクション トレースを分析できます。また、曖昧な列のルックアップ、グラウンディングされていない指標、定義の欠落、ユーザーによる質問の言い換えなど、エージェントがつまずいた箇所を特定できます。その後、エンリッチメント機能は信頼できる回答を見つけて修正案をステージングし、同じ間違いが繰り返されないようにします。コンテキスト エンジニアリングはこのようにして何百万ものエージェントのやり取りに追従し、エキスパートが定義をゼロから記述しなくても、提示された変更をレビューするだけで済むようにします。
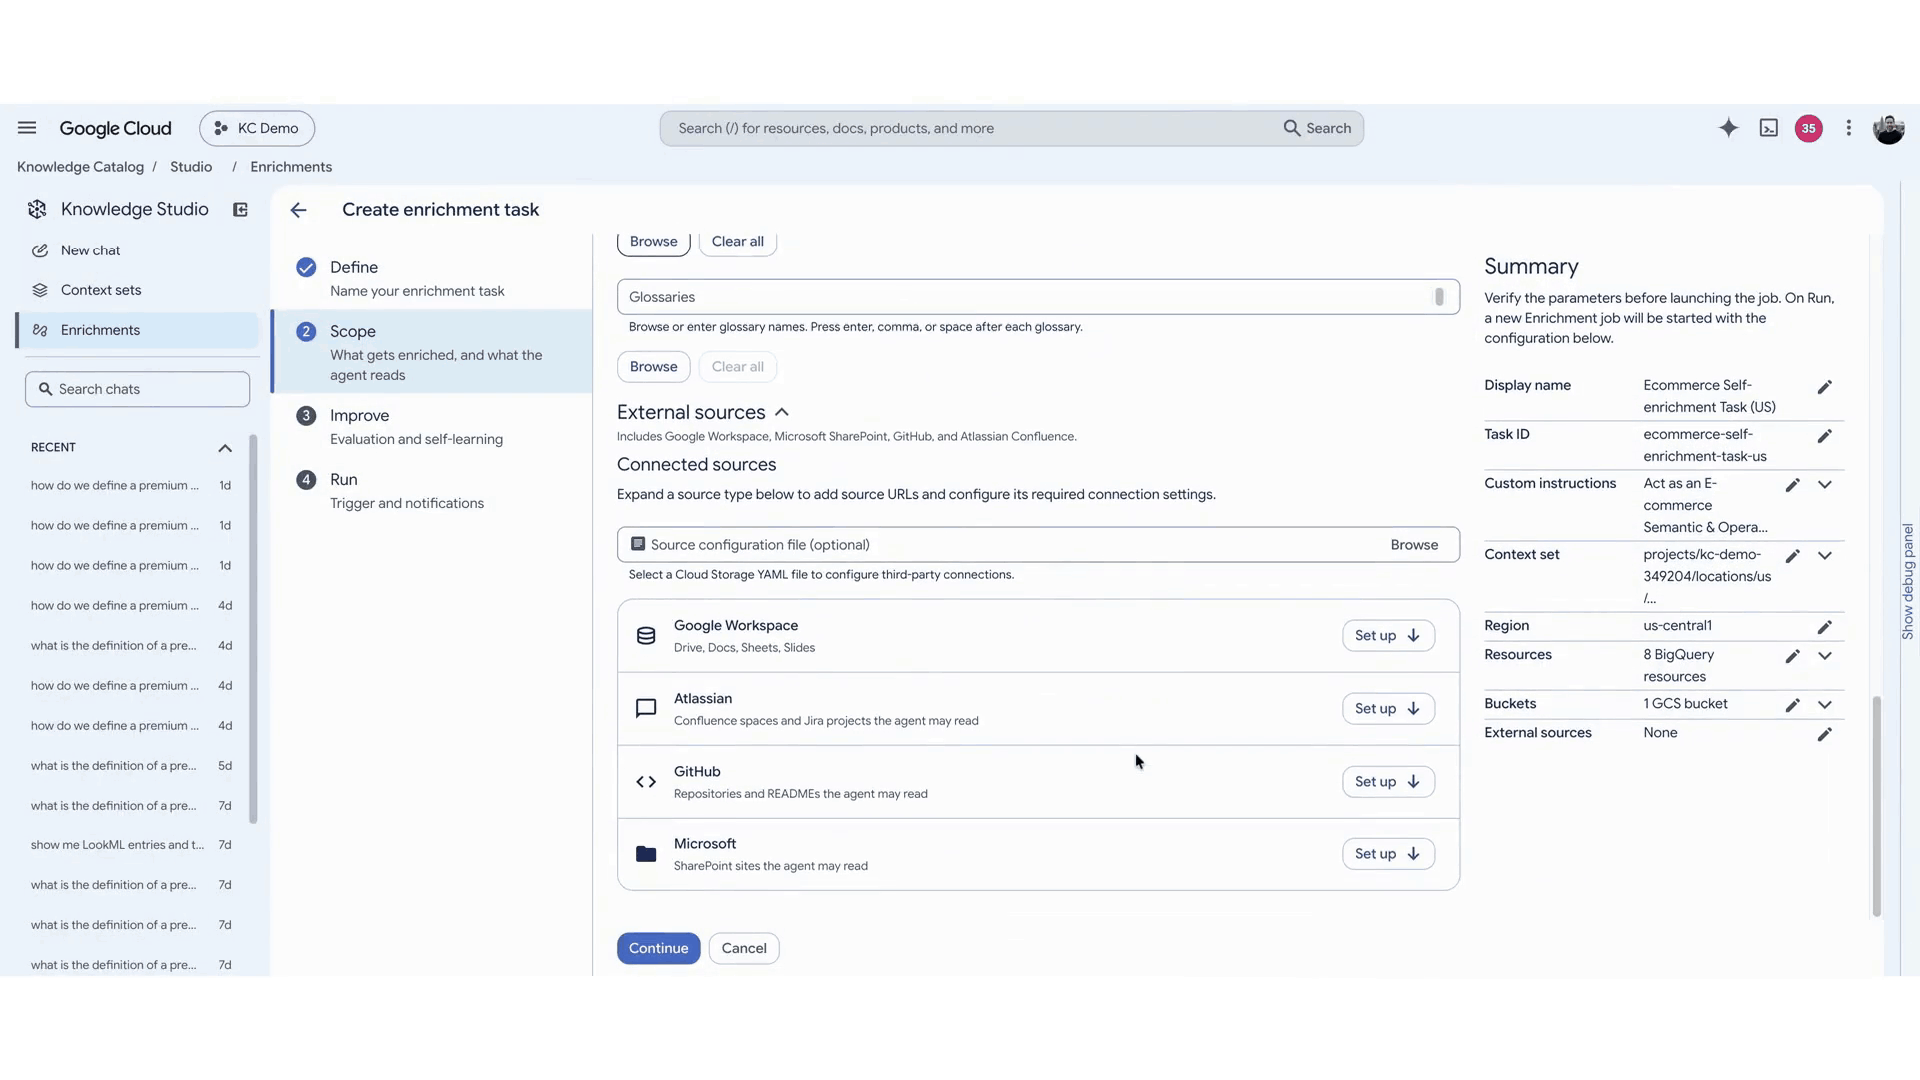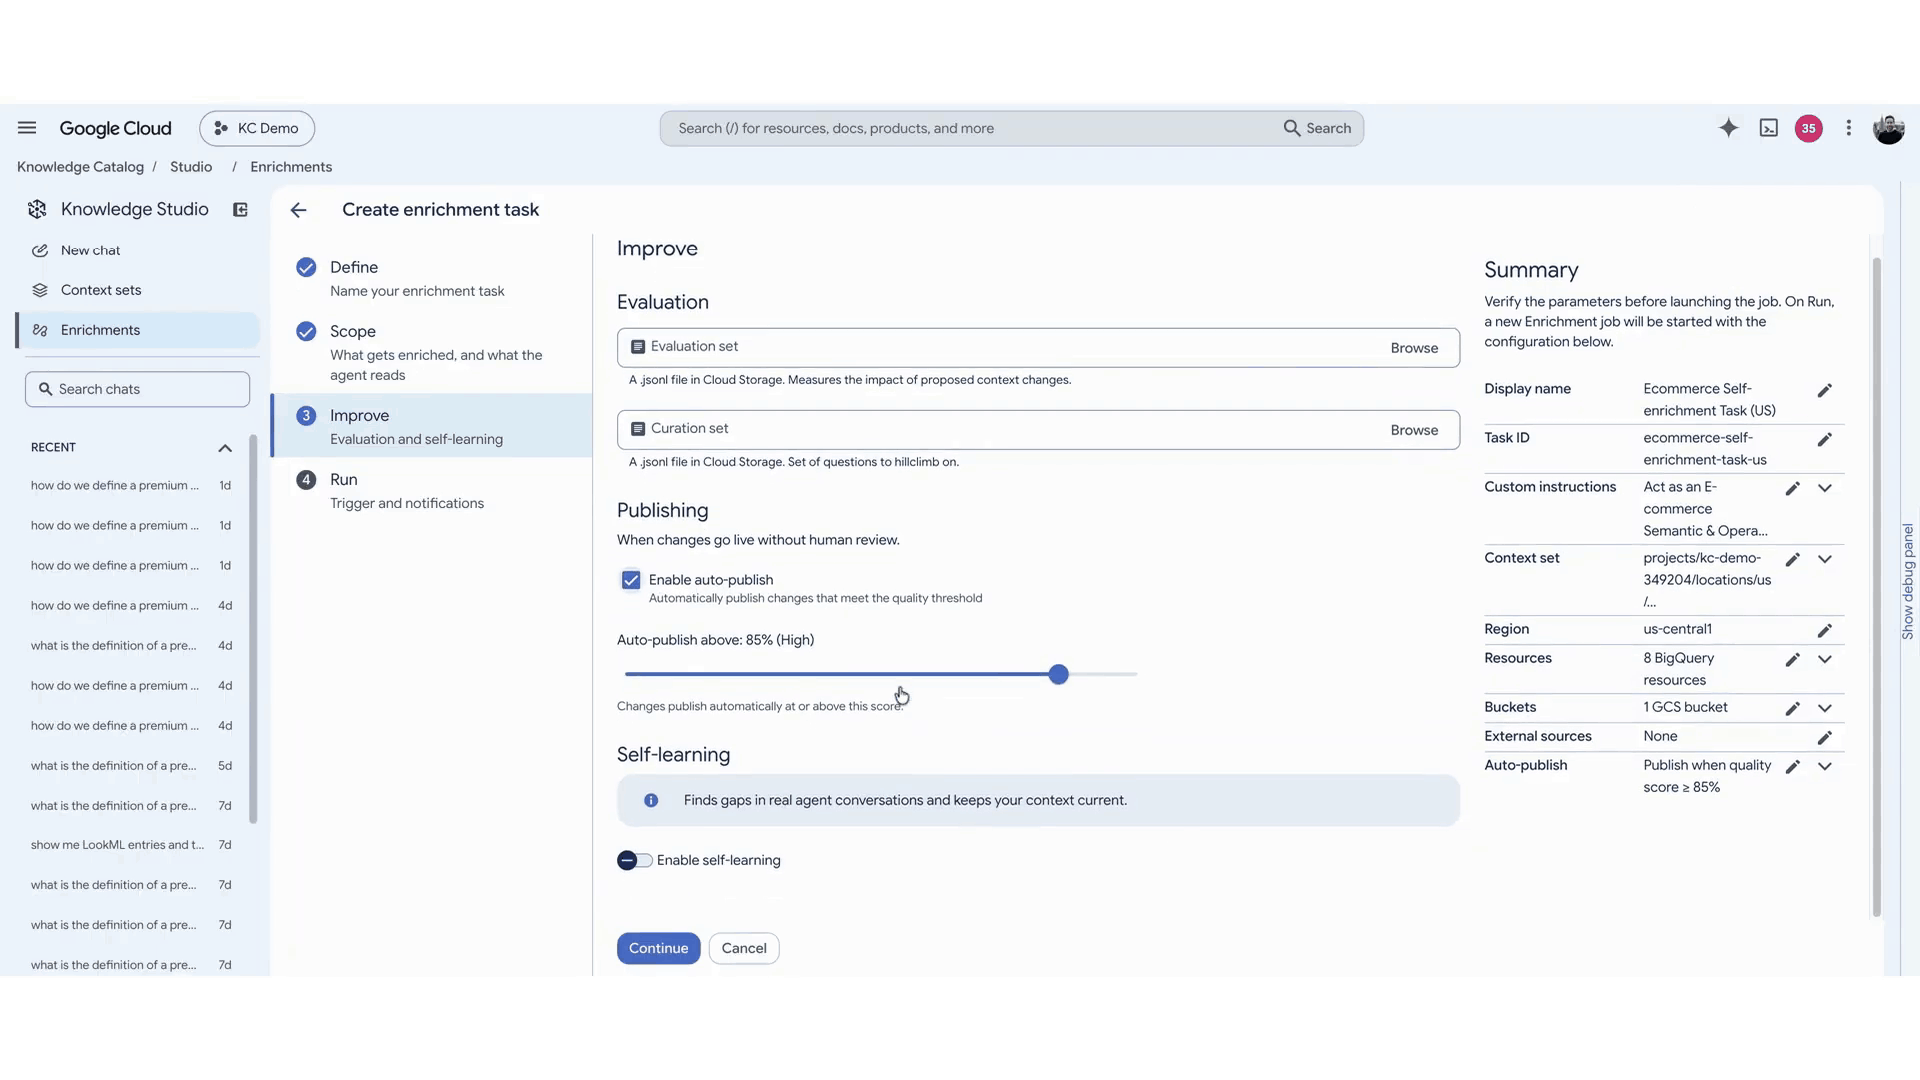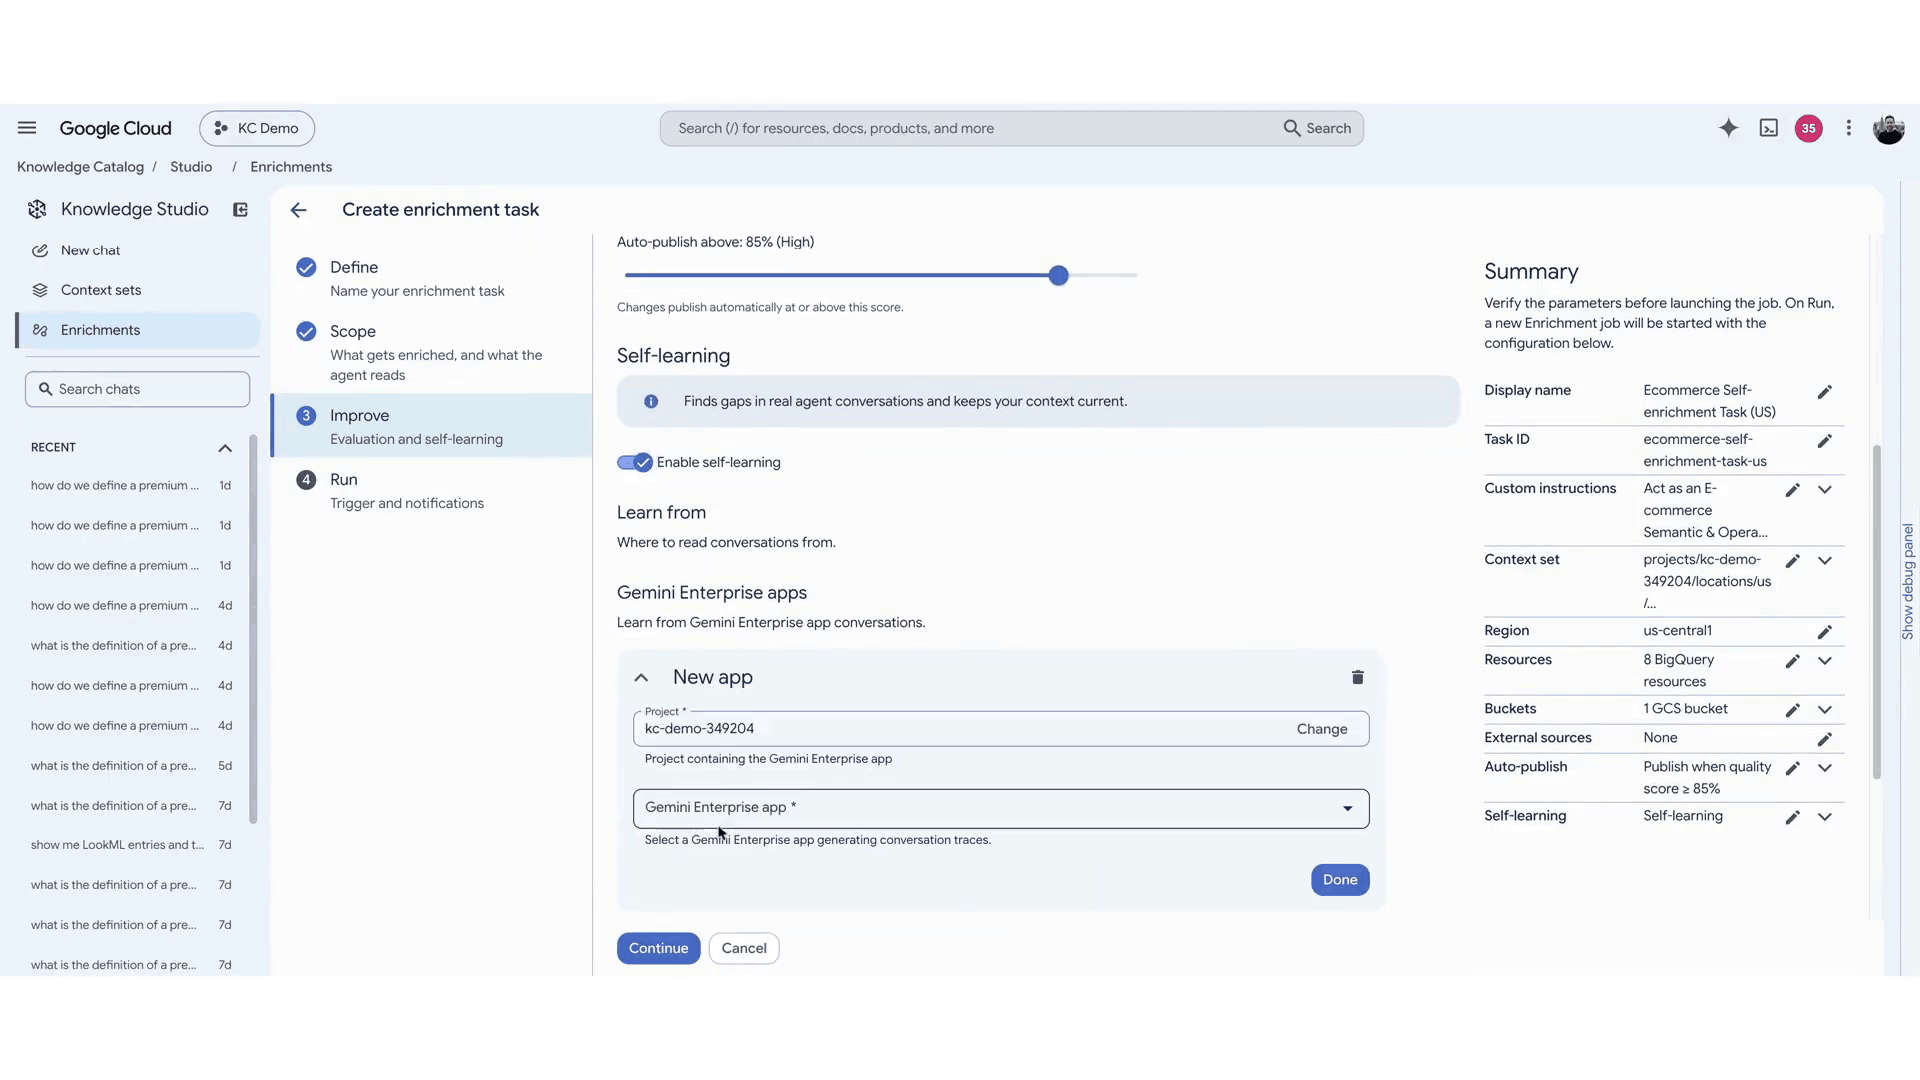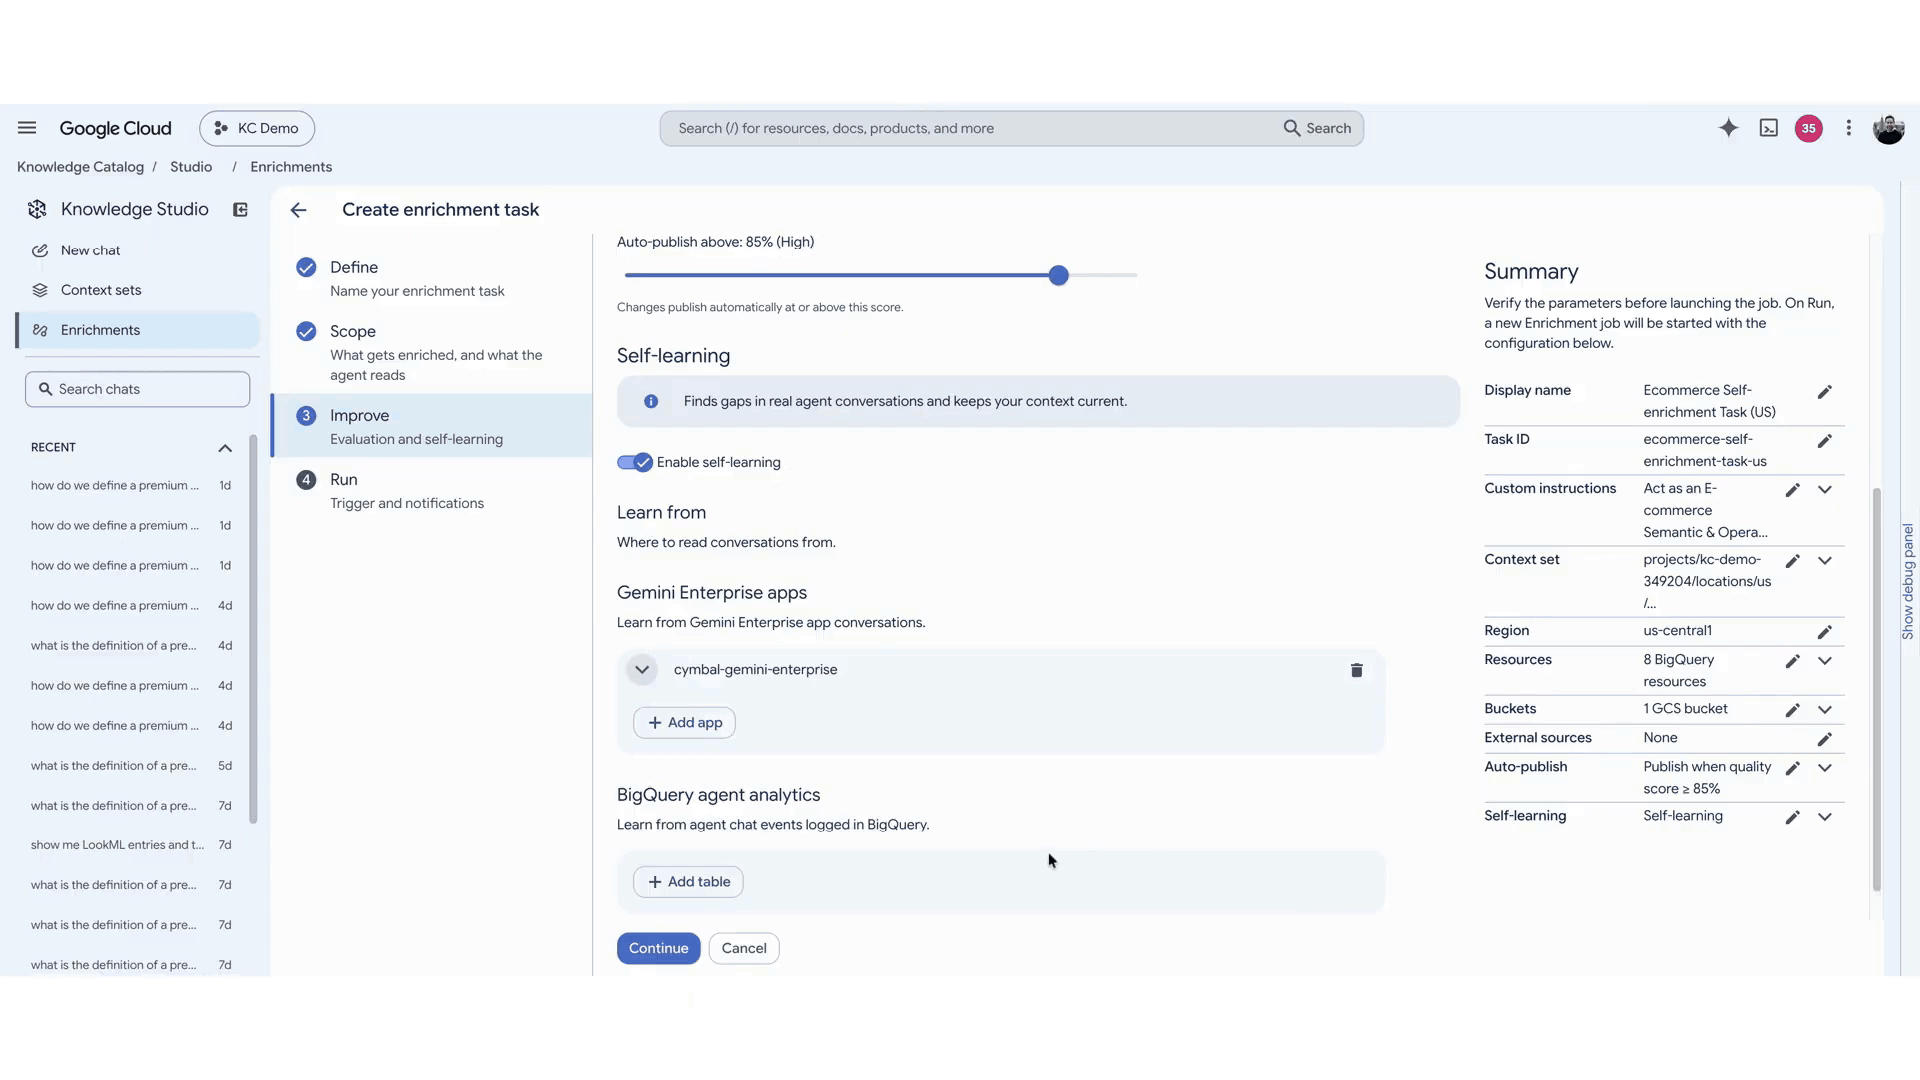
接続されたソース、評価、自己学習によってエンリッチメント タスクを構成
自動化とは、制御を放棄することではありません。自動公開はいつでも有効または無効にできます。また、提案された変更を自動的に承認する信頼スコア(例: 85%)を自由に設定することもできます。しきい値を下回る変更や、削除などの影響の大きい更新は、変更リクエストとしてスチュワードによる承認、編集、拒否の判断に回されます。独自の評価セットを提供して、提案された更新をエンドツーエンドでテストすることもできます。また、すべての変更は完全な来歴とともにログに記録され、元に戻すことができます。もちろん、Google がお客様のデータをモデルのトレーニングに使用することはありません。

公開前にエンリッチメントの提案、信頼スコア、変更の差分を確認
コンテキスト セットによりオーディエンスごとに適切なコンテキストを設定
その性質上、エンタープライズ コンテキスト グラフは非常に広範なデータを網羅したものになりますが、個々のタスクにおいてエージェントとユーザー双方が必要とするのは、信頼できる適切なセグメントのみであることがよくあります。Knowledge Catalog は、コンテキスト セットによってそれに対応します。コンテキスト セットとは、コンテキスト グラフの中から、特定のドメイン、チーム、エージェント、またはエンドユーザー グループの定義、指標、結合ロジック、ゴールデン クエリのみを厳選して管理するサブセットです。たとえば、セールス エージェントであればセールス用のコンテキスト セット、財務アナリストのアシスタントであれば財務用のコンテキスト セットにバインドできます。「純収益」は、グループによって当然意味が異なるため、すべてのドメインは同じカタログ内で独自の定義を維持します。ただし、エージェントは 1 つのセットだけに限定されるわけではありません。Knowledge Catalog の検索機能を使用すれば、任意のタスクに適したコンテキスト セットを動的に探し出すことも可能です。
コンテキスト セットには、組み込みのデータ ガバナンスときめ細かいアクセス制御機能も備わっています。各コンテキスト セットへのアクセスは IAM で管理されるため、どのエージェントとユーザーに読み取り、使用、編集の権限を与えるかをスチュワードが制御できます。エージェントは使用を許可されているセットからのみコンテキストを取得し、基盤となるデータへのアクセスは既存の権限に従って行われます。すべての更新は遡って追跡したり、元に戻したりできます。また、コンテキスト セットは Open Knowledge Format(OKF)を基盤としているため、OKF バンドルをインポートしてコンテキスト セットに変換し、それを再び OKF としてエクスポートすることで、コンテキストのポータビリティを維持できます。
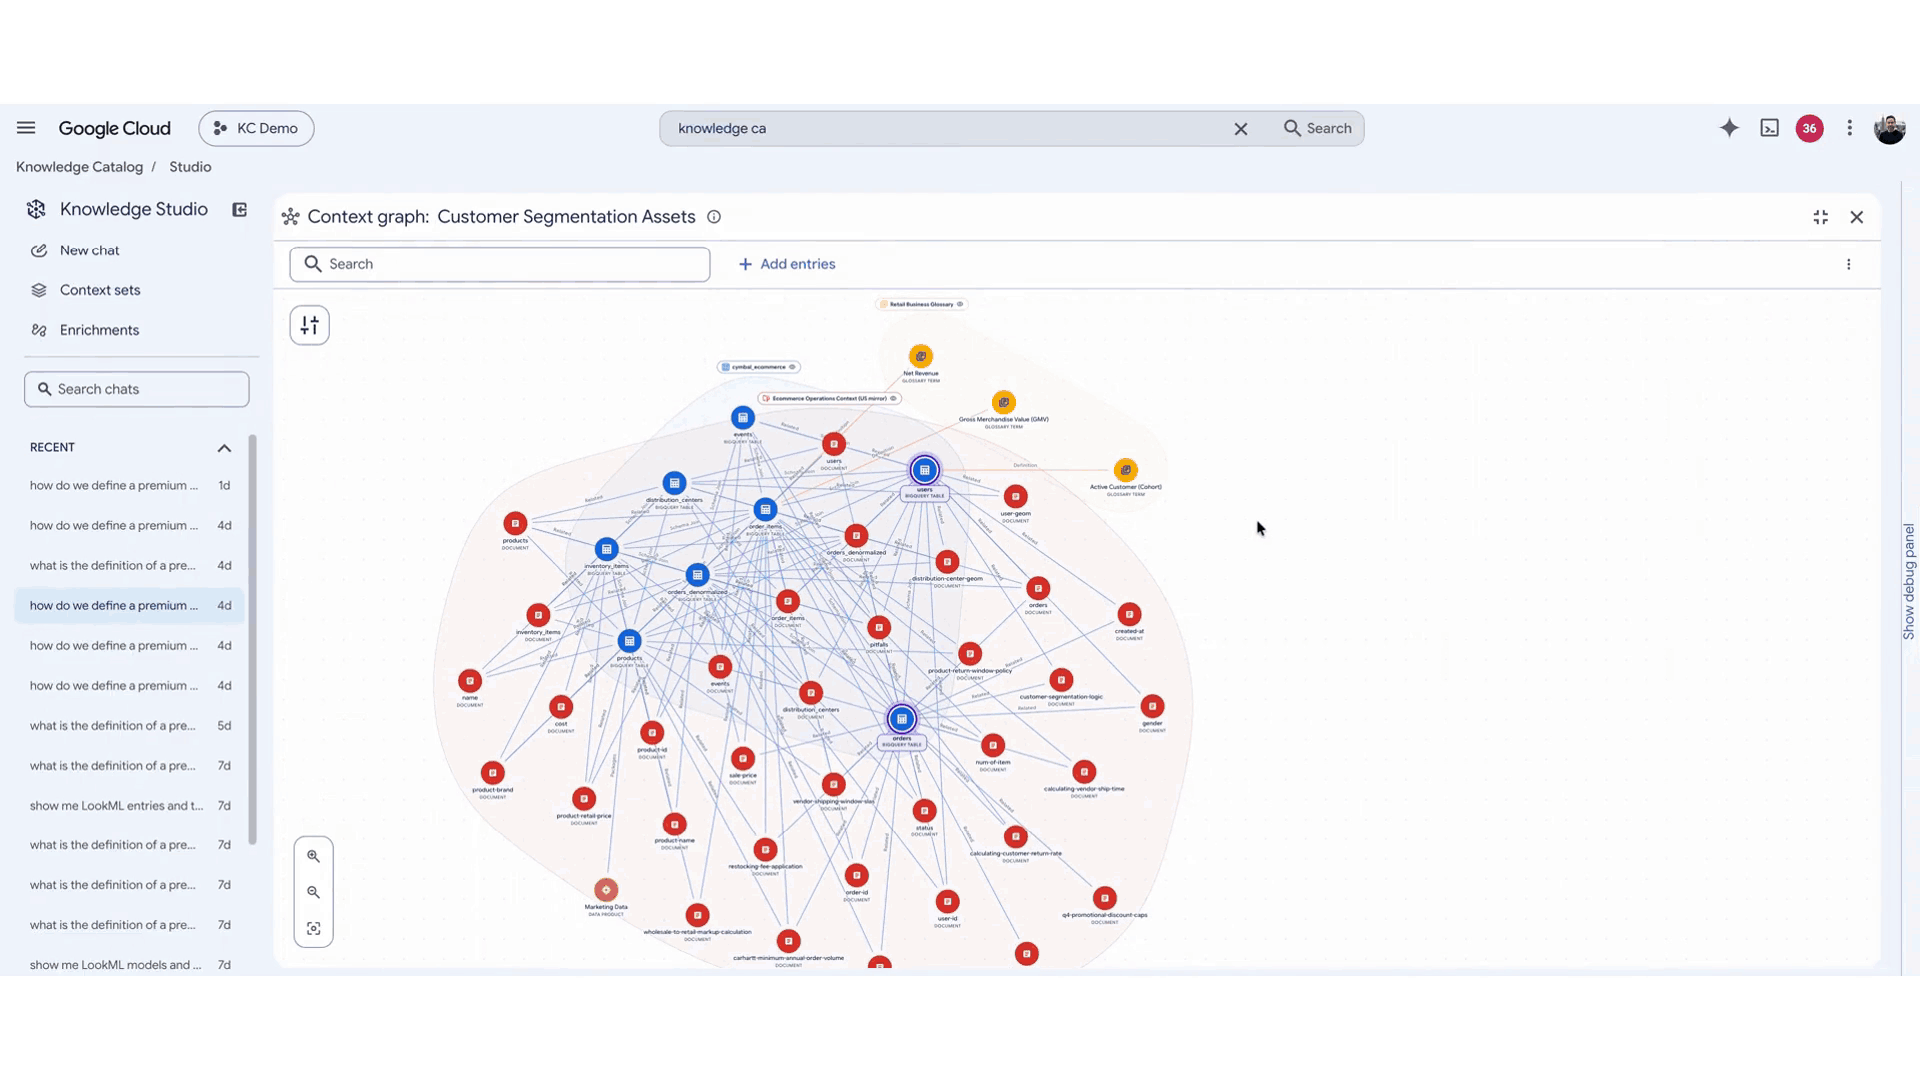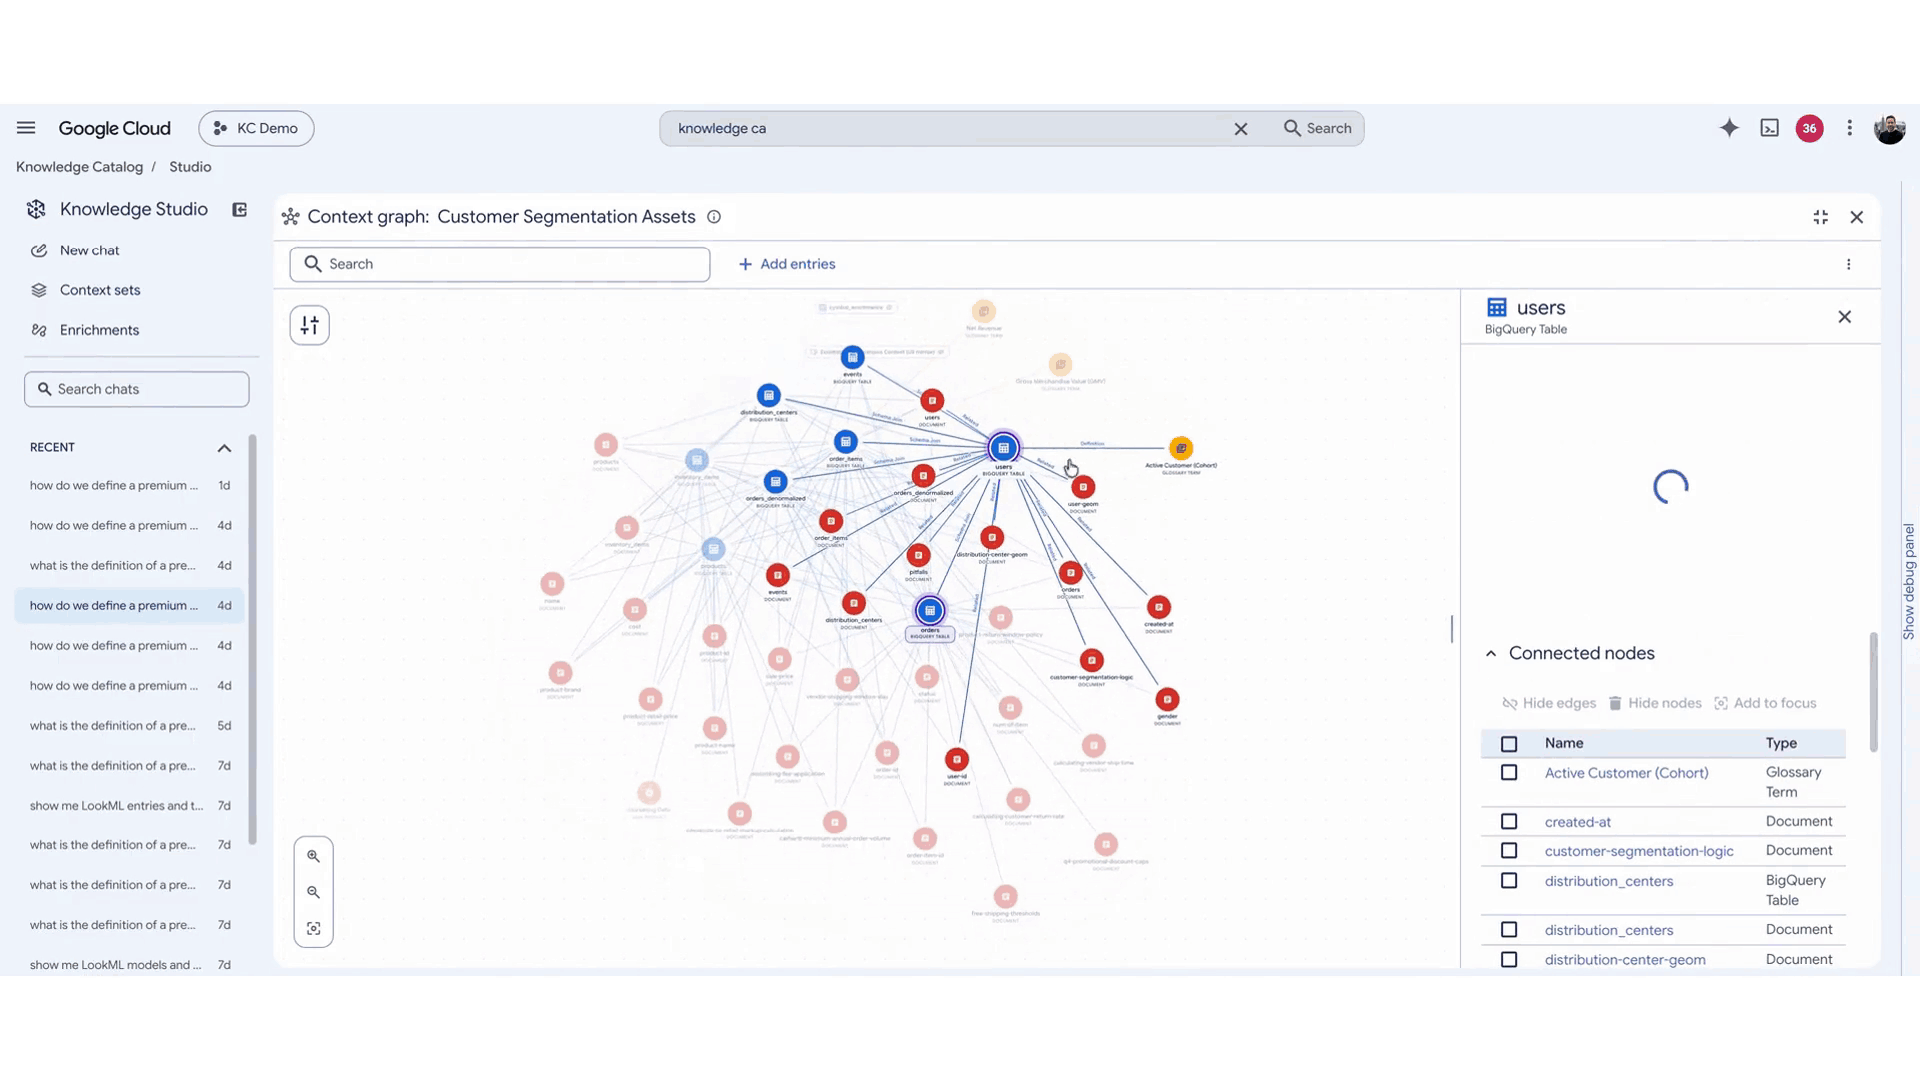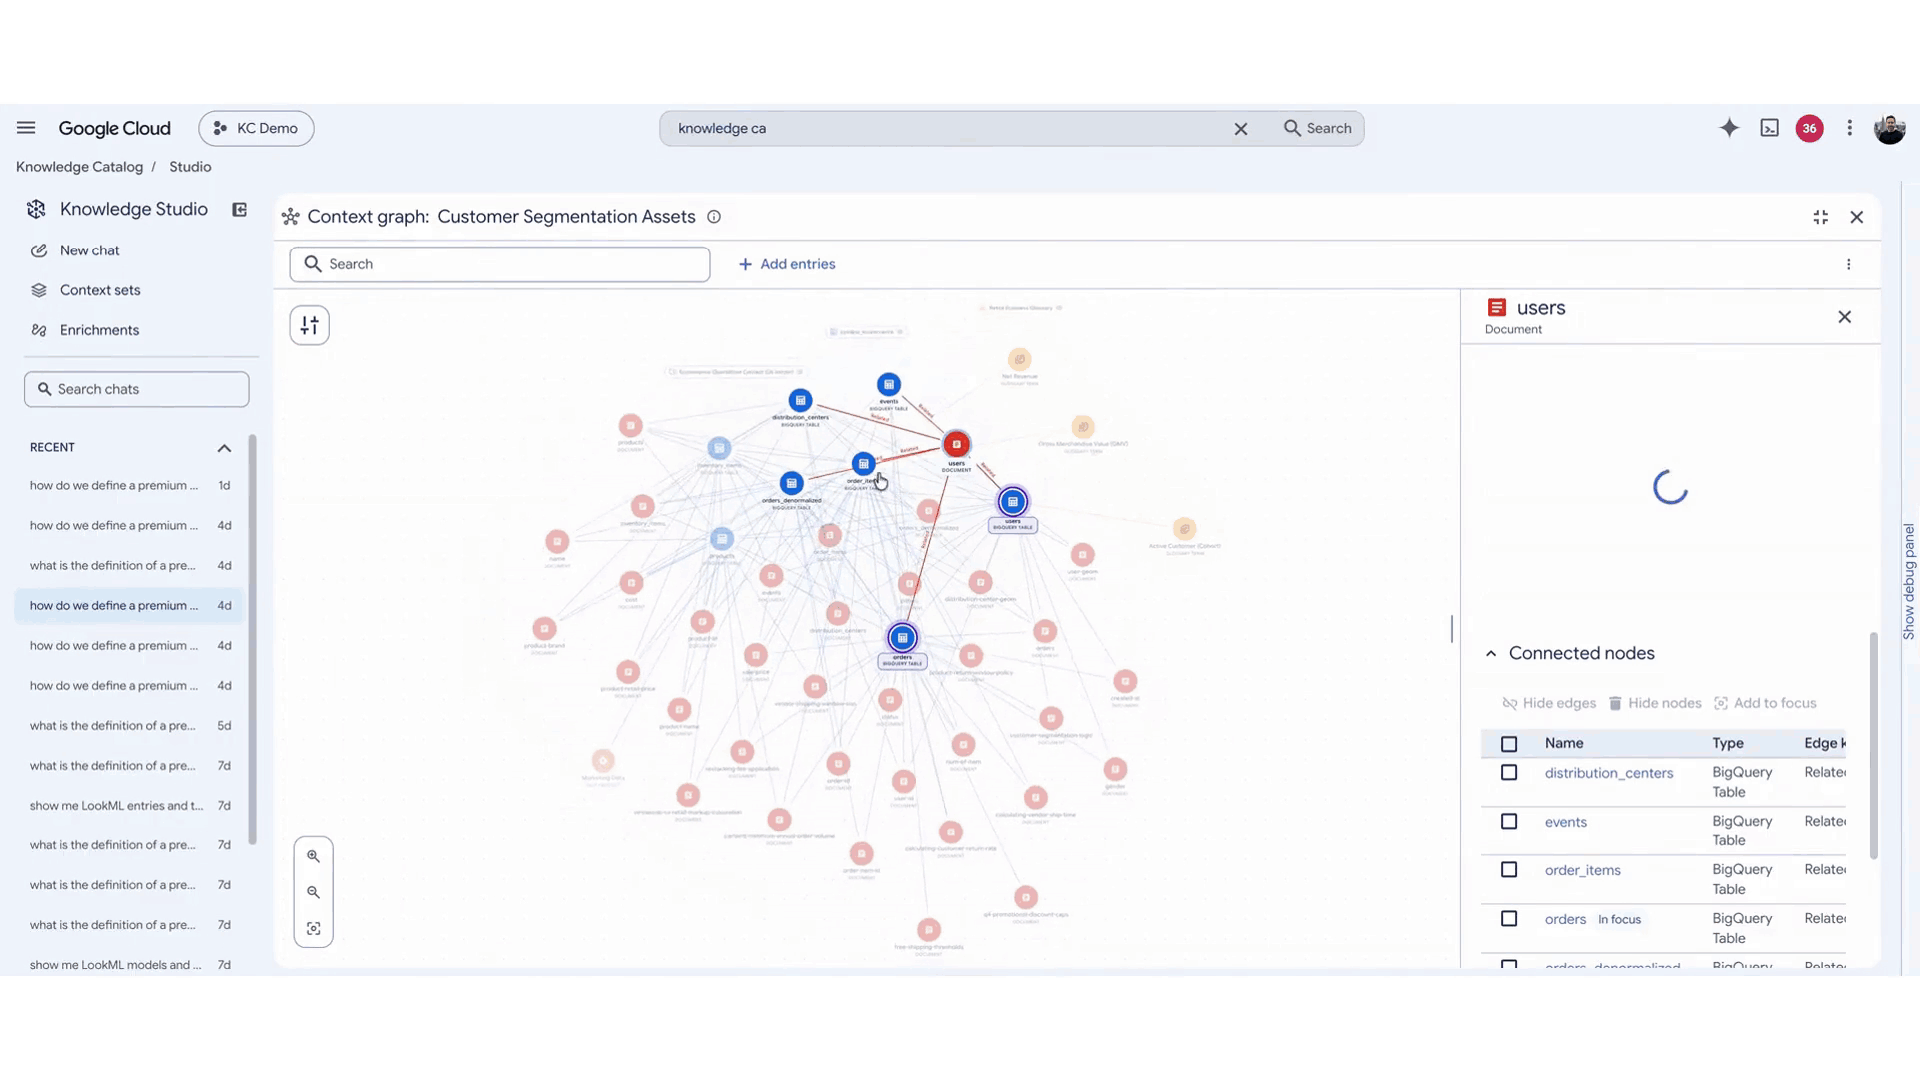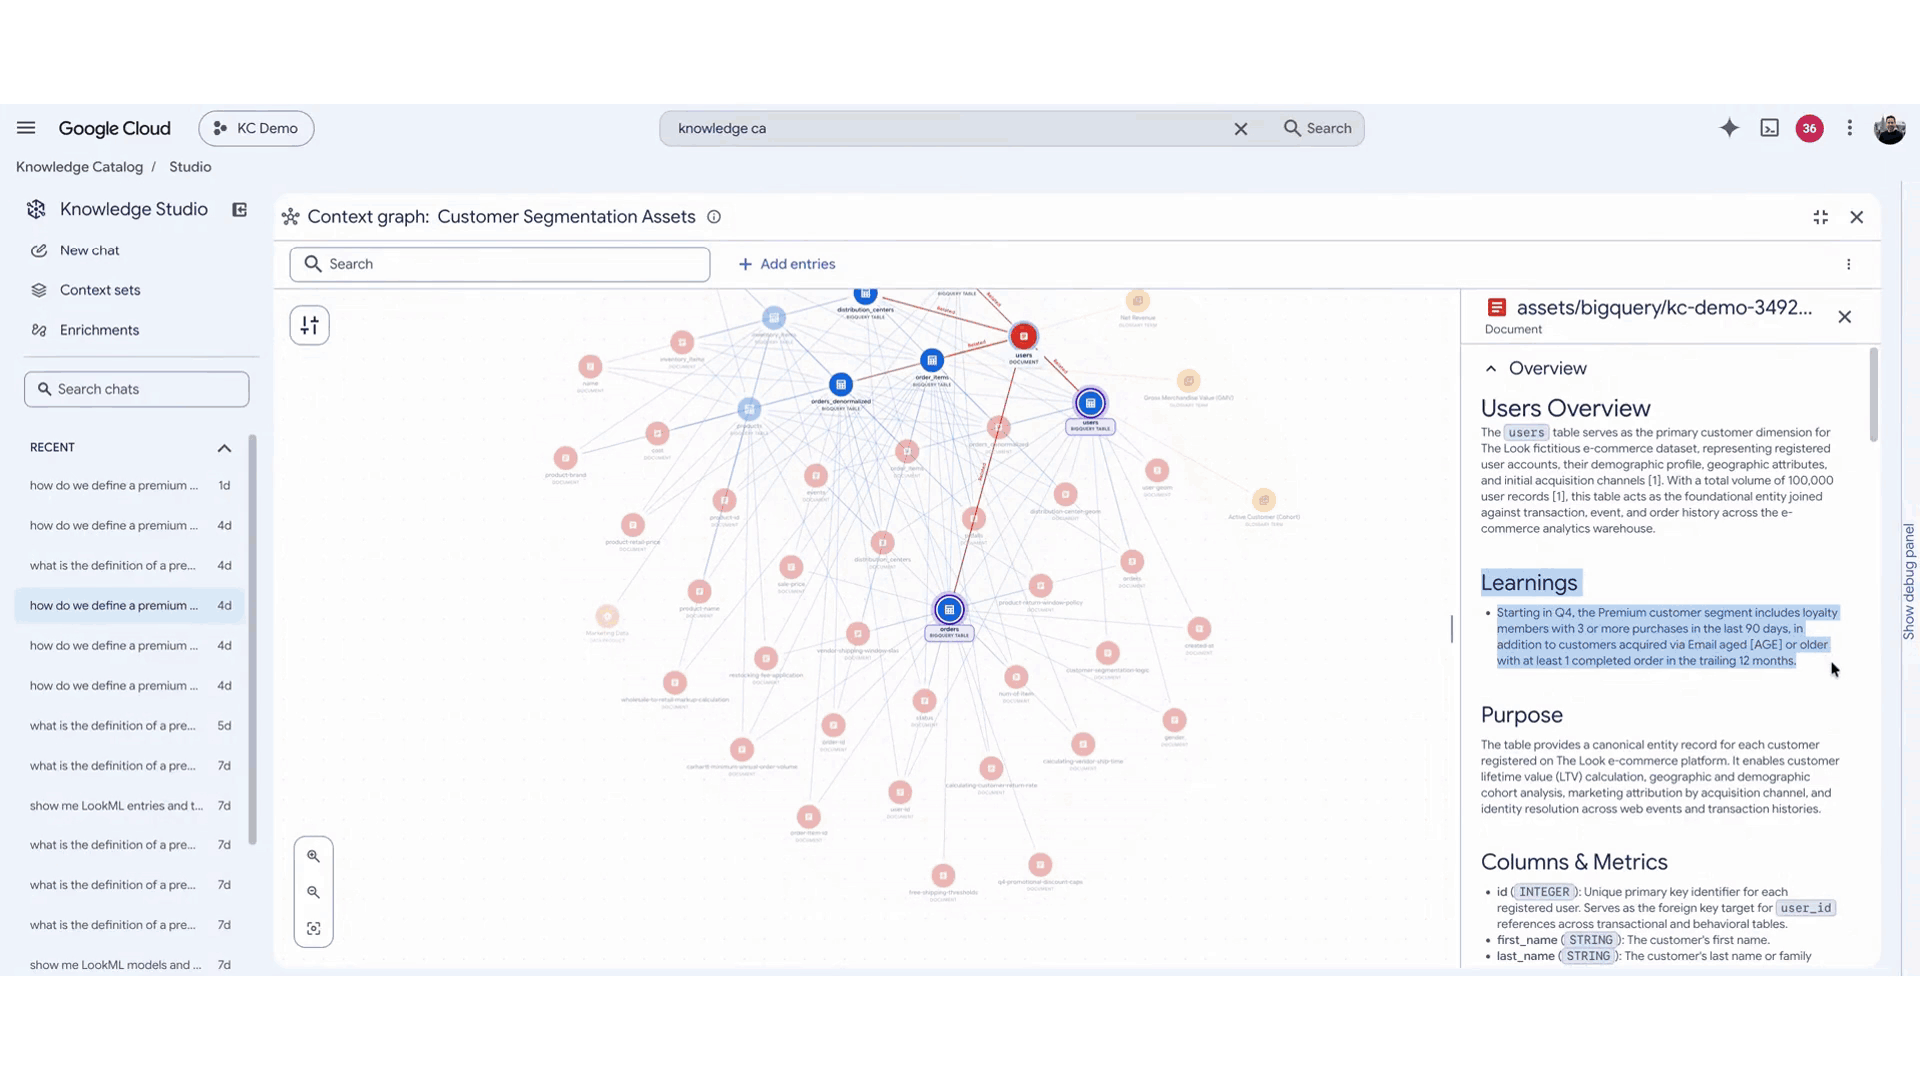
承認されたエンリッチメントを管理されたコンテキスト セットに公開
Knowledge Studio ですべてを探索、管理
上述の機能はすべて、エージェントのコンテキストをキュレートして管理するコンテキスト エンジニアとデータ スチュワード向けに構築された、刷新された Knowledge Catalog エクスペリエンスに統合されています。
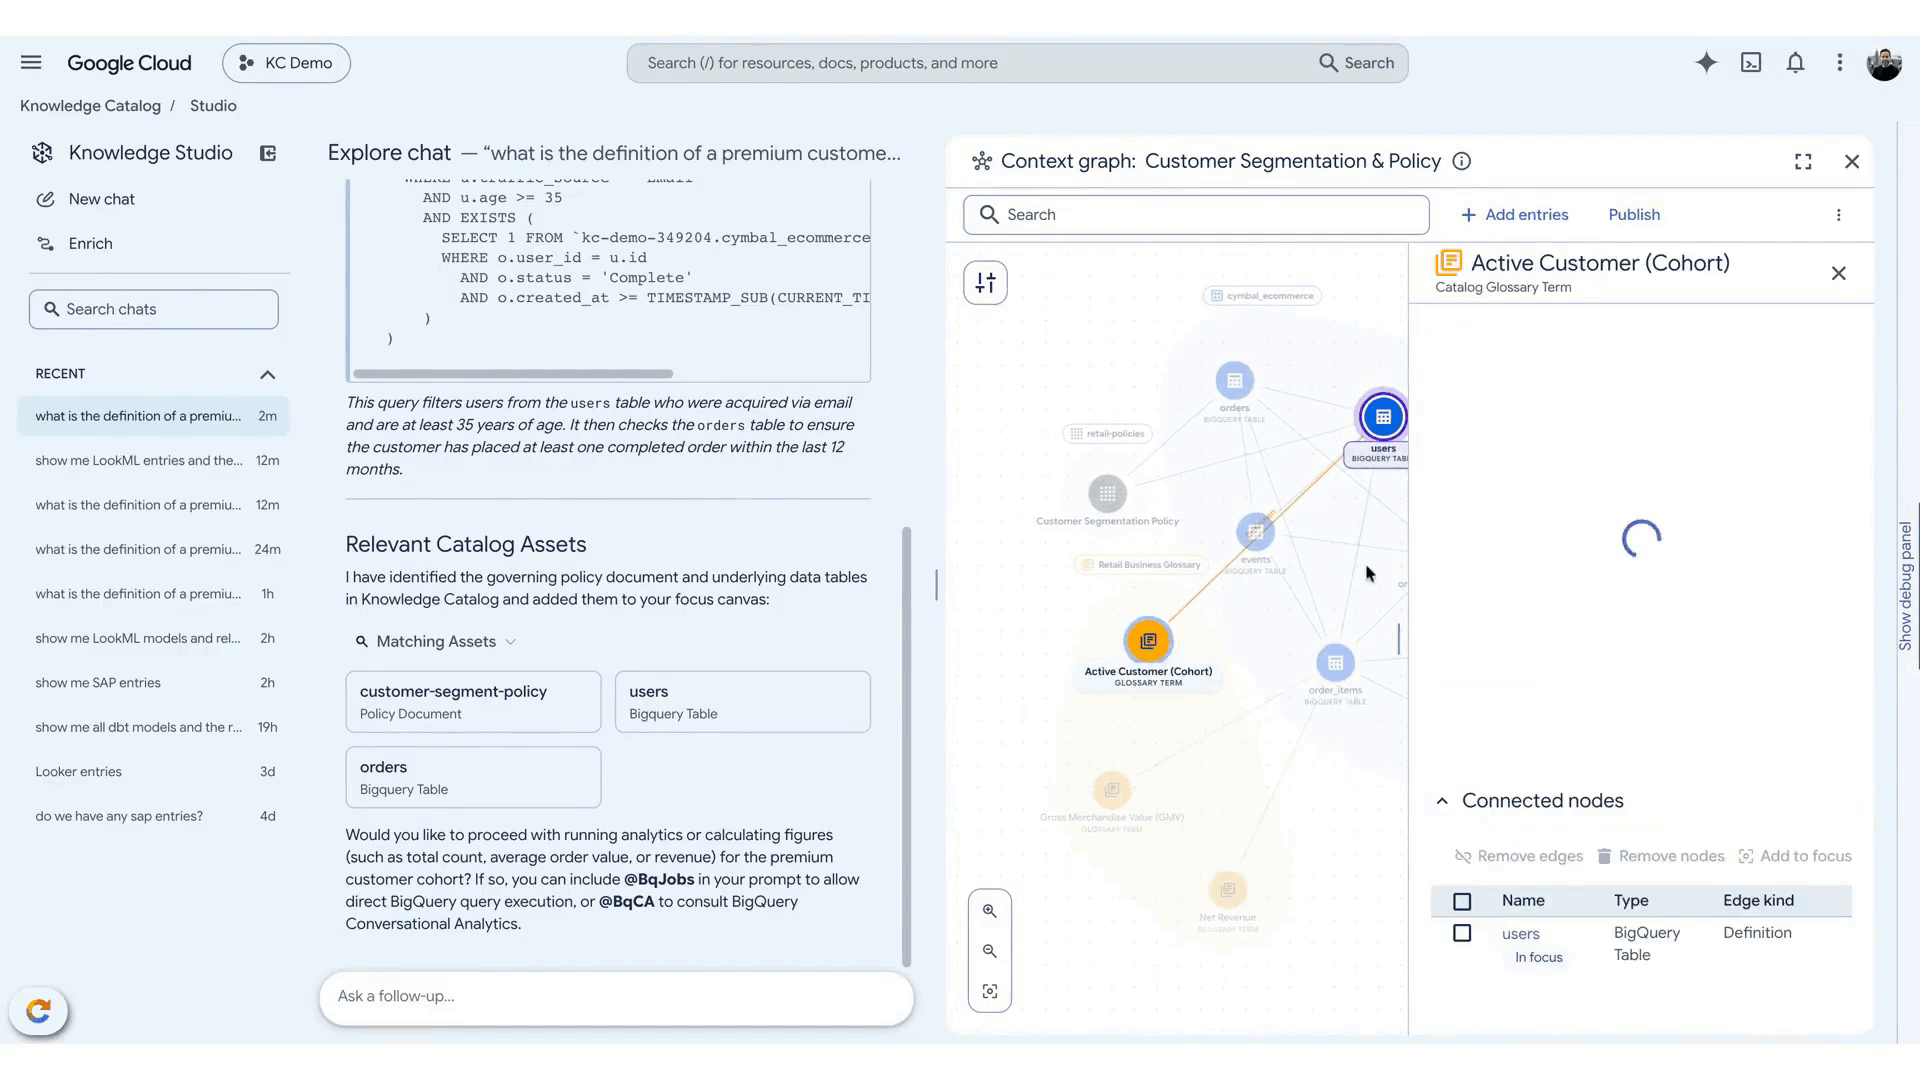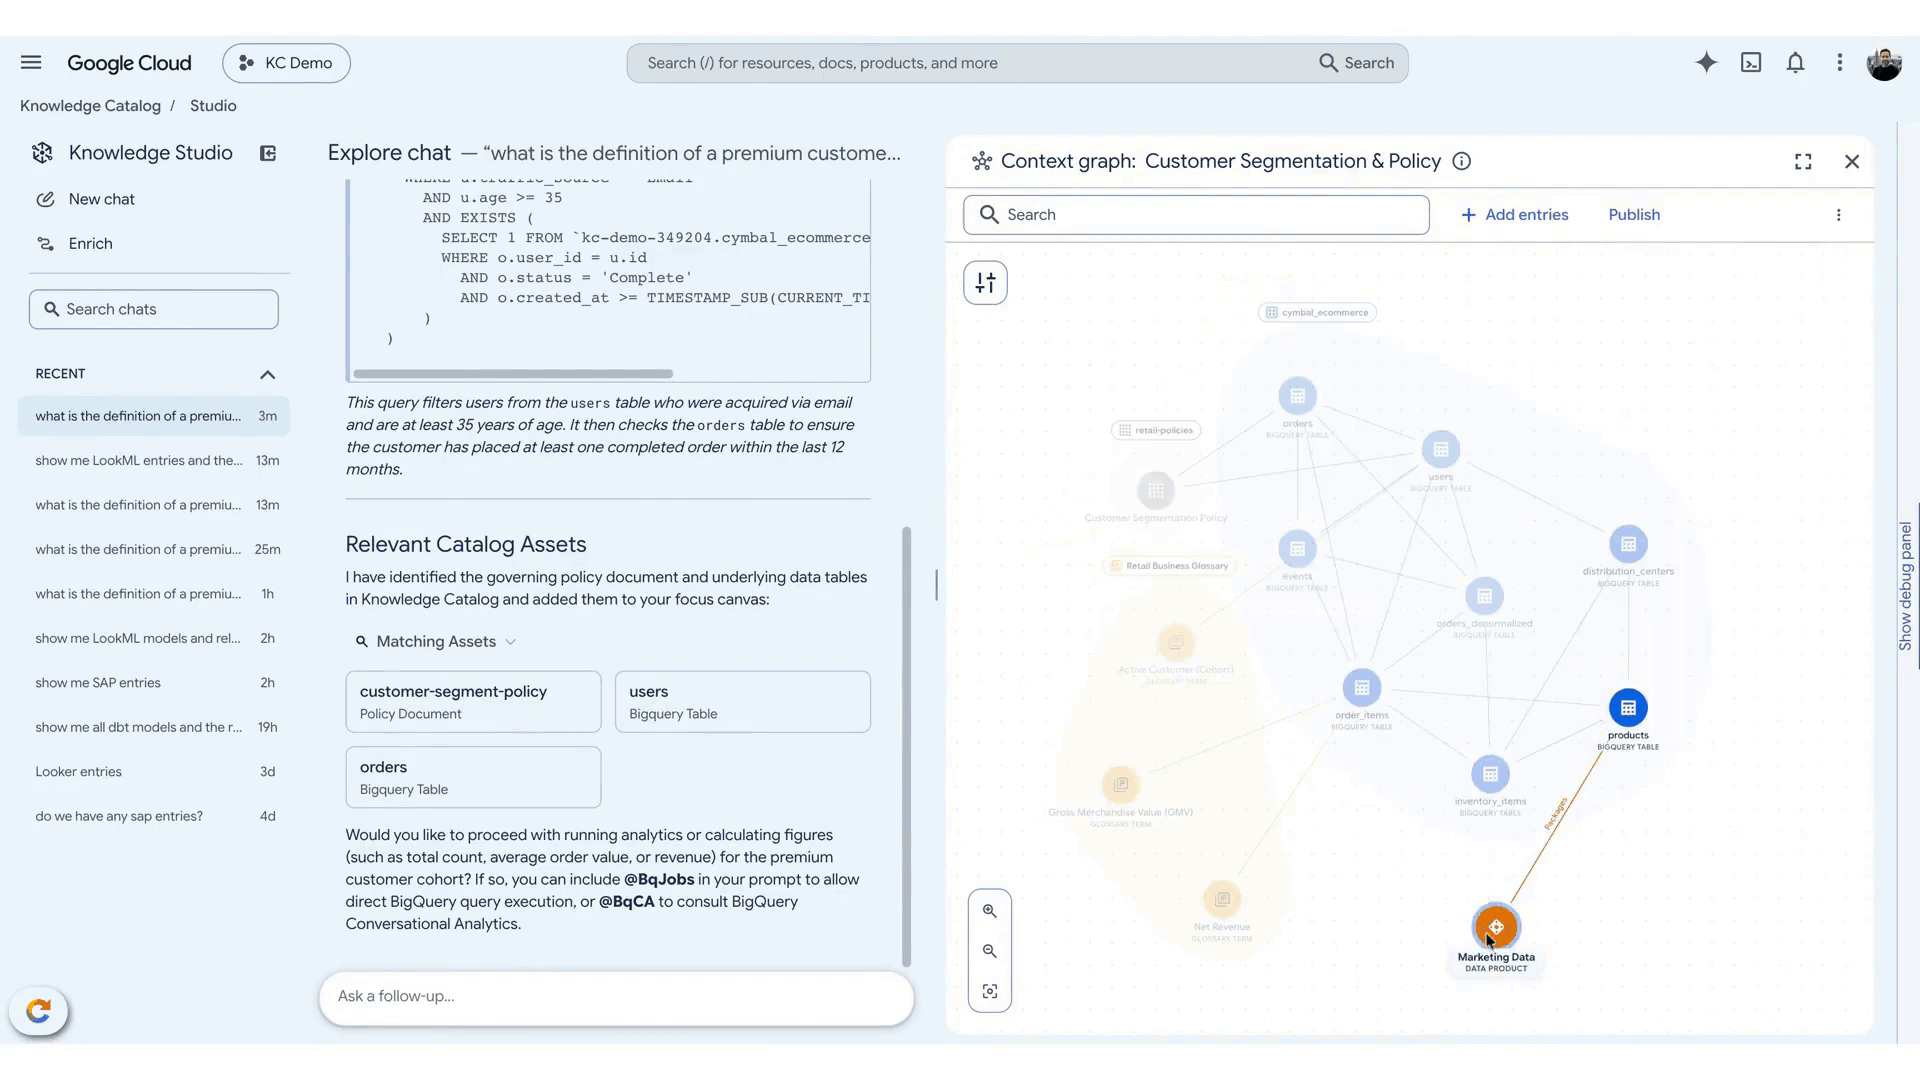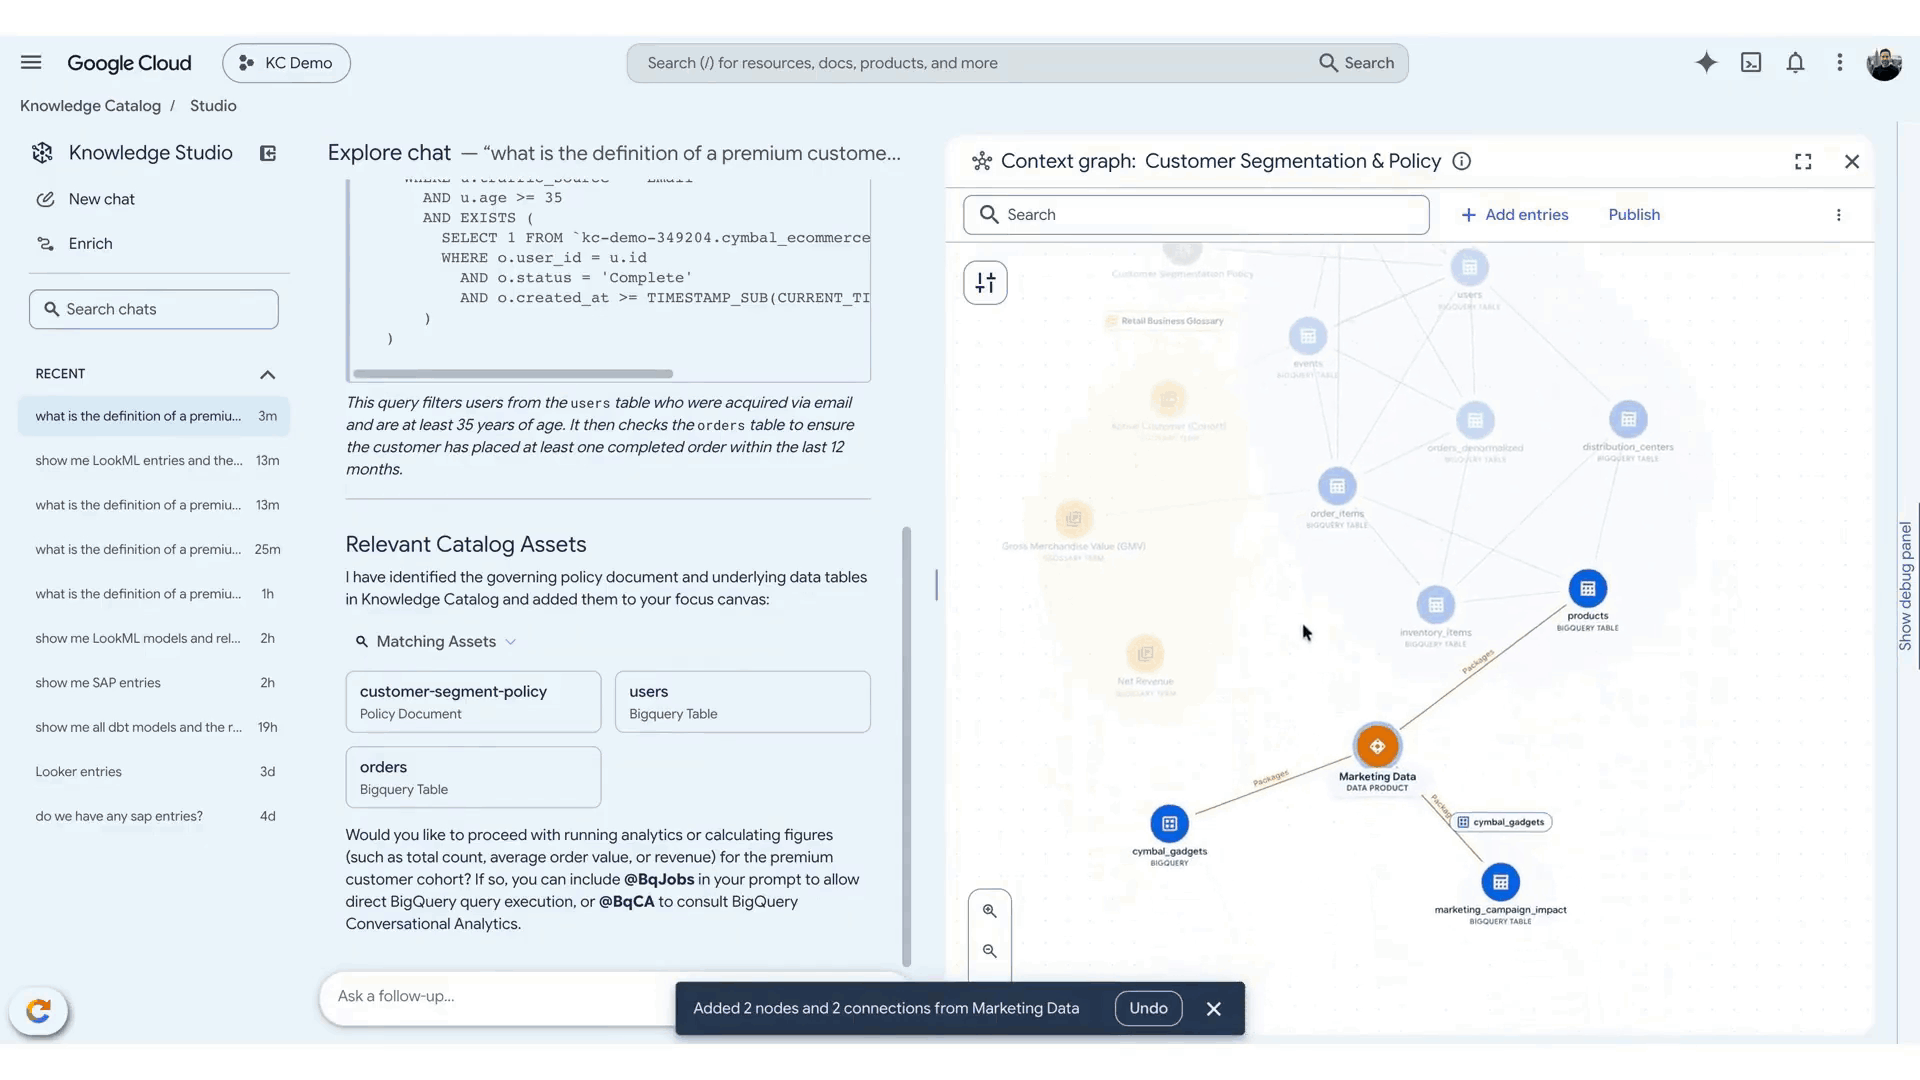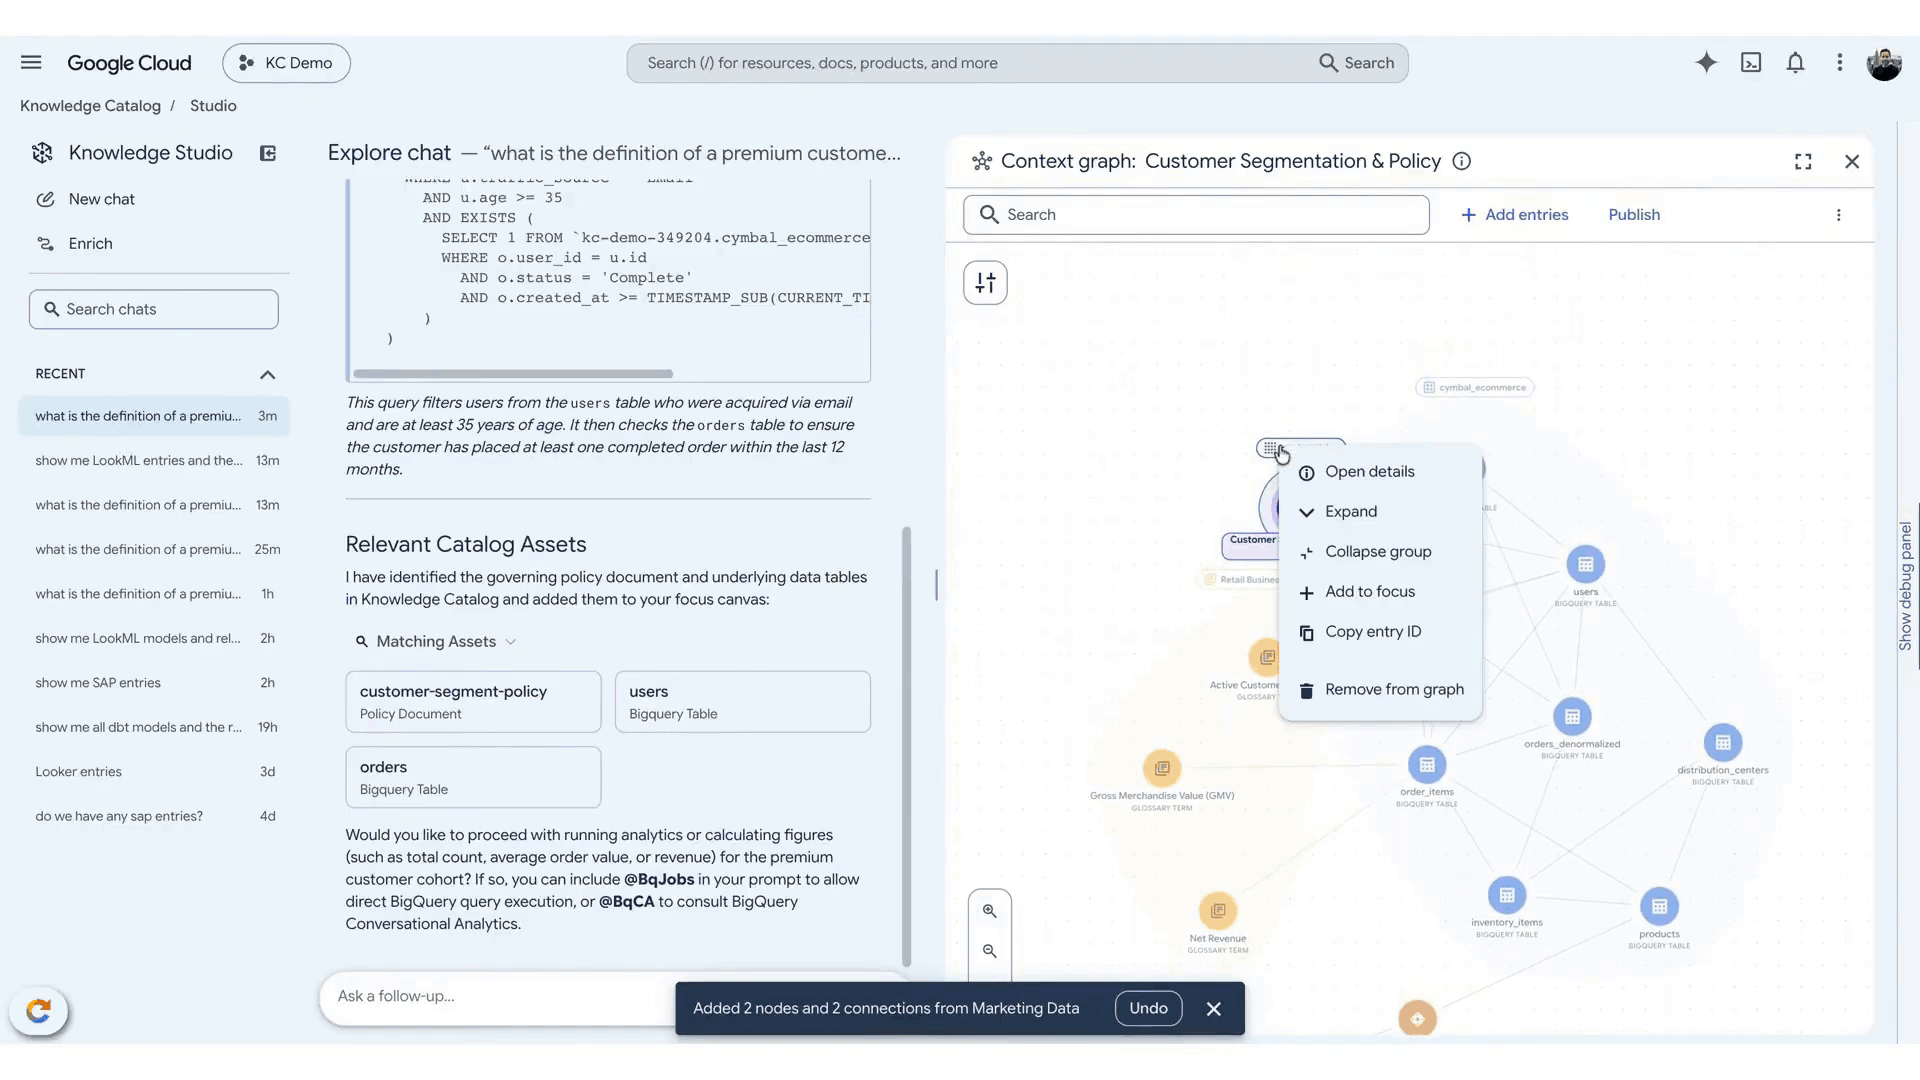
Knowledge Studio でコンテキスト グラフを視覚的に操作
新しい Knowledge Studio は、Knowledge Catalog を静的なインベントリのリポジトリからインタラクティブなコマンド センターへと変貌させます。これにより、以下が可能になります。
- コンテキスト カバレッジを一目で確認: オペレーショナル データベースやウェアハウスから、セマンティック モデル、コンテキスト セット、ドキュメントまで、クロスクラウド データ資産をビジュアル マップ上で俯瞰できます。
- 対話形式でコンテキストを探索: 自然言語でビジネスに関する質問をしたり、エンタープライズ コンテキスト グラフ全体で関係性をたどったりできるほか、エージェントがメタデータをどのように推論しているかを正確に把握できます。
- エンリッチメントを 1 か所で確認、検証: 提案された各変更、ソースの引用、信頼スコアを精査できます。実際の質問を用いてコンテキスト セットをテストし、ソフトウェア開発のようなバージョン管理機能で変更リクエストの承認、編集、ロールバックを行えます。
- エンリッチメント実行をモニタリング: 各エンリッチメント タスクのスケジュール、結果、トークン使用量、実行時間を追跡できるほか、実行が完了するとメールで通知を受け取れます。
使ってみる