AI.AGG で BigQuery の数百万行にわたるデータのセマンティック集計を実現
Pramod Niralakeri
Strategic Cloud Engineer
Shruti Malgatti
Cloud Migration Consultant, Data
※この投稿は米国時間 2026 年 11 月 6 日に、Google Cloud blog に投稿されたものの抄訳です。
10 年以上にわたり、BigQuery は構造化データの集計における業界標準を牽引し、ペタバイト規模の財務データの合計算出、アクティブ ユーザー数の集計、過去データの平均値算出などをわずか数秒で実行してきました。しかし、現代の企業がアプリケーション ログ、カスタマー サービスの文字起こし、製品画像、診断レポートといった急増する非構造化データに圧倒されるなか、重大なギャップが浮き彫りになっています。
これまで、リレーショナル SQL エンジンには、数百万行ものテキストやマルチモーダル データから、共通するセマンティックなテーマを集計、合成、抽出するネイティブな機能が備わっていませんでした。BigQuery には強力な行レベルの AI 関数(AI.GENERATE や AI.CLASSIFY など)が最近導入されましたが、大規模なデータセットを包括的に分析する際には、大規模言語モデル(LLM)のコンテキスト ウィンドウというアーキテクチャ上の独自の課題が立ちはだかります。
Gemini のような高度な基盤モデルであっても、重大なデータ切り捨てや致命的な実行エラーを回避しながら、数百万行ものデータを一度のプロンプトで処理することは不可能です。これまでは、この問題を解決するためにデータ エンジニアリング チームが複雑な外部 MapReduce パイプラインを構築し、レート制限に伴うバックオフを管理しながら、分割された要約を再帰的に繋ぎ合わせる必要がありました。
今回は、現在プレビュー版として提供されている AI.AGG について詳しく解説します。これは、BigQuery GoogleSQL にネイティブに組み込まれた、フルマネージドのマルチレベル セマンティック集計関数です。セマンティック集計を分散 MapReduce の問題として捉え直すことで、AI.AGG は、データチームがわずか 1 つの SQL クエリで数百万行ものデータに対し自然言語による指示を実行することを可能にします。
ここでは、その仕組み、革新的なエンタープライズ ユースケース、本番環境にデプロイするためのベスト プラクティスについて詳しく見ていきます。
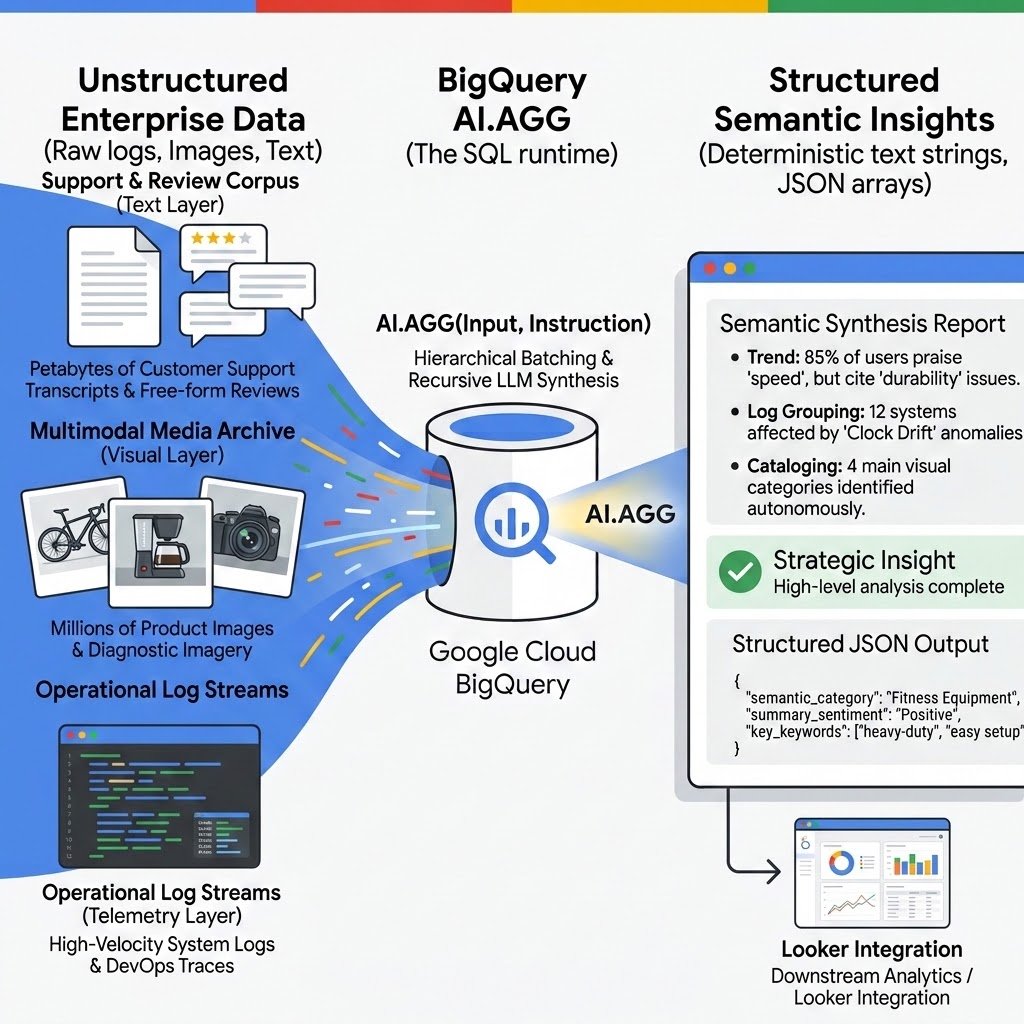
ペタバイト規模のデータを、BigQuery 上でネイティブにセマンティックなインサイトに変換します。
マルチレベルのバッチ処理アーキテクチャ
AI.AGG は、チャンキングや並列実行に伴う極めて複雑なエンジニアリング作業を抽象化します。AI.AGG クエリを実行すると、BigQuery エンジンがデータベース内でネイティブに一連の処理を自動的にオーケストレートします。
-
行レベルの検証: BigQuery エンジンは、各行が最大コンテキスト ウィンドウを超えていないかを確認します(10 MiB を超えるペイロードは破棄されるか、エラーが返されます)。
-
コンテキスト長を考慮したバッチ処理: BigQuery エンジンは、入力行を動的に小規模なバッチにグループ化して、選択した Gemini エンドポイントのトークン制限内に十分に収まるようにします。
-
並列推論: 自然言語による SQL プロンプトが各バッチに並列で適用され、Vertex AI を介して中間的なセマンティック サマリーが生成されます。
-
再帰的合成: 最後に、システムはこれらの中間出力をまとめてバッチ処理し、まったく同じ指示とともに LLM に渡します。この集約処理は、SQL の
GROUP BY句ごとに最終的な集計文字列が 1 つになるまで、再帰的に繰り返されます。
AI.AGG は、分散されたバッチ間で概念を統合するために高度な推論を必要とするため、パイプラインのすべての段階でフルウェイトの LLM に完全に依存しています。この点が、軽量化された CPU プロキシモデルを活用できる AI.CLASSIFY などの行レベルの関数とは異なっています。
マルチモーダルなエンタープライズ環境に対応
AI.AGG は、テキスト入力とマルチモーダル入力の両方にネイティブに対応しています。BigQuery オブジェクト テーブルと OBJ.GET_ACCESS_URL 関数を活用することで、分析チームはデータの移動やコード変換を行うことなく、Cloud Storage に直接保存されている数千もの画像から視覚的なインサイトを抽出して集計できるようになります。
データ エンジニアリングのヒント: NULL 排他ルール
複数の列を評価する場合、多くのユーザーは STRUCT(構造体)を関数に渡して処理します。しかし、その複合構造内のフィールドが 1 つでも NULL と評価されると、行全体が NULL と見なされ、何のアラートもなく破棄されてしまいます。データがパイプラインに確実に送られるように、NULL を許容するフィールドは常に IFNULL() で明示的にラップしてください(例: IFNULL(description, 'No data provided'))。
エンタープライズにおける革新的なユースケース
AI.AGG の真の分析力は、標準的な SQL の GROUP BY 操作と組み合わせることで発揮されます。
1. 大量のシステムログの診断分析
世界中に分散されたマイクロサービスが生成するシステムログには、明示的な致命的エラーとしては現れない、わずかなパフォーマンス低下(メモリ スラッシングやシステム クロックのドリフトなど)が潜んでいることがよくあります。AI.AGG を活用することで、DevOps チームは数百万件ものログをシステム コンポーネントごとに集約し、特定の目的に沿った、人が読める診断サマリーを生成できます。
-
プロンプト作成のヒント: 異常を探す前に、コンポーネントの「正常な動作」を明示的に説明するようモデルに指示します。これにより、LLM が完全に正常なログに対して誤ってエラーを検出するハルシネーションを抑えることができます。
2. Agentic Data Cloud の構築
AI.AGG は単なる分析レポートツールではなく、動的なオーケストレーション エンジンとしての側面も備えています。たとえば、明確な分類がされていない、過去のサポート チケットの膨大なリポジトリを取得したとします。AI.AGG をデプロイすれば、未加工のテキストを読み取って決定版のカテゴリ一覧を生成し、厳密な JSON 配列として出力することが可能です。
JSON_VALUE_ARRAY を使ってこの配列を展開し、生成された動的ラベルを AI.CLASSIFY などの行レベルの分類器に直接渡すことで、エンドツーエンドの自律的なデータラベル付けパイプラインを SQL 上でネイティブにオーケストレートできます。これにより、外部の Python スクリプトを用意する手間を省くことが可能です。
プロンプト エンジニアリングはデータ エンジニアリング
生成モデルを決定論的な SQL パイプラインに統合する場合、標準的な会話型のプロンプトではうまくいかないことがよくあります。プログラム処理を前提とした SQL 出力を得るためのプロンプト作成には、厳格なエンジニアリングの手法が求められます。
-
明示的な出力契約: プロンプトを API 契約として扱います。次のようなコマンドを追加します。「文字列の有効な JSON 配列を 1 つだけ返してください。マークダウンのコードブロックや会話テキストは含めないでください。」
-
コンテキスト区切り文字: 明示的なラベル(例:
'- Description: ')を付加した文字列連結を使用して、LLM のコンテキストを固定し、高密度のバッチ処理において各フィールドが混同されるのを防ぎます。 -
エラー発生時の設計: 欠落している情報については、推測するのではなく厳密な null 値を返すようモデルに明示的に指示することで、後続の処理におけるスキーマのハルシネーションを防ぎます。
-
少数ショット アンカー: プロンプト内で期待される構造の具体的な例を提供して、モデルのアテンション機構をその構造に強力にグラウンディングします。
ガバナンス、費用管理、ガードレール
セマンティック ワークロードを本番環境へ移行するには、運用面での監視が不可欠です。再帰的なバッチ処理アーキテクチャを採用しているため、Gemini に送信されるトークンの合計数は、元のソースデータのトークン数よりも多くなります。コストを抑えるため、WHERE 句や LIMIT 句による厳格な事前フィルタリングを徹底してください。
さらに、大規模で静的なデータセットを相互参照するワークフローにおいて、BigQuery は Gemini コンテキスト キャッシュをサポートしており、入力トークンの費用と実行レイテンシを削減することが可能です。AI.COUNT_TOKENS ユーティリティを使用すると、実行前にクエリのコストを見積もることができます。
管理者は、AI.AGG が BigQuery のガバナンス フレームワークに厳格に準拠し、データの引き出しを防止する VPC Service Controls(VPC-SC)をサポートしていることを確認したうえで、安心して運用できます。さらに、バッチ処理中に一時的なエラーが発生した場合でも、この関数はクエリ全体を停止させるのではなく、拒否された行をスキップして処理を継続する「グレースフル デグラデーション」を実行します。
プレビュー版を利用する際の留意事項:
-
SQL グループごとの最終出力文字列は、1 グループあたり 10,000 トークンまでに厳密に制限されています。簡潔な出力にするようモデルに指示してください。
-
個々のペイロード行は 10 MiB 以下である必要があります。
-
マルチモーダル配列を処理する際は、通知なくデータがスキップされないように、1 行あたりの画像アセットを 10 個未満に制限してください。
安定性を最大限に高めるため、1 回のクエリで処理する行数は最大 2,000 万行、出力する SQL グループ数は最大 1,000 個にとどめることをおすすめします。
AI.AGG を実際に使ってみる
利用を始める際の例として、従来の SQL 指標と併せて AI.AGG を活用し、インサイトを合成する方法をご紹介します。
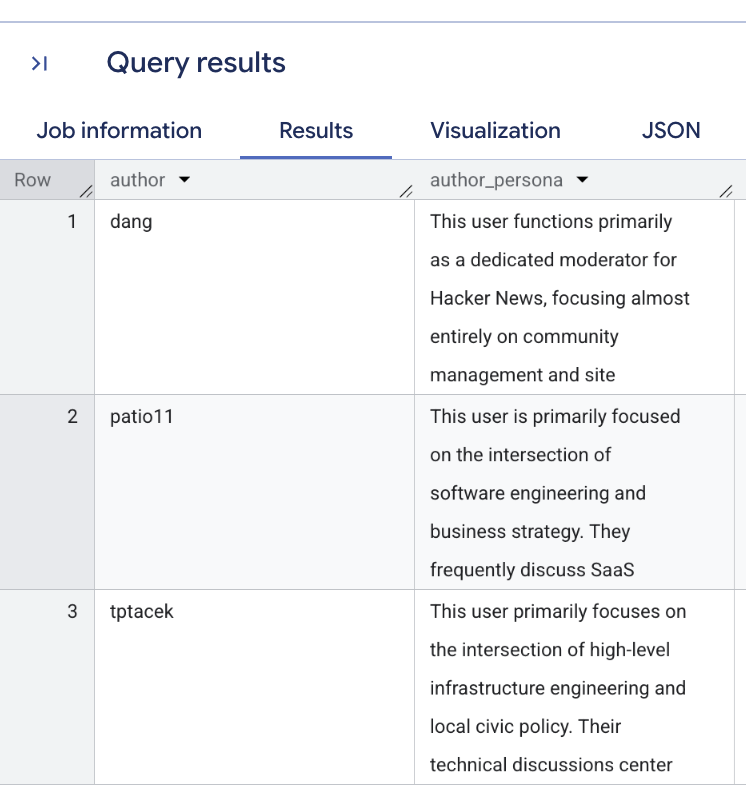
マクロレベルのトピック検出
特定のトップ投稿者の発言内容を要約し、数千件におよぶコメントを簡潔な要約文にまとめます。
DevOps 向けの自律的な診断レポート(ログ分析)
標準的な HTTP エラーコードを集計する代わりに、AI.AGG を活用して数千もの未加工のスタック トレースやログ メッセージを読み取り、マイクロサービス名ごとにグループ化することで、システム障害の定性的な根本原因を特定できます。
データ ウェアハウスの新たな時代
AI.AGG により、Google Cloud はペタバイト規模のセマンティック分析の民主化を推進しています。BigQuery のリレーショナル エンジンが持つ決定論的なグループ化機能と、Vertex AI Gemini のマクロな推論機能を融合させることで、エンタープライズ データ ウェアハウスを変革し、過去の指標を蓄積するだけの受動的なリポジトリから、高度で包括的なインテリジェンスを備えたアクティブでセマンティックなランタイムへと進化させています。
エンタープライズ データが持つセマンティックな価値を活用する準備はできていますか?Google Cloud コンソールにアクセスして BigQuery のドキュメントを確認し、今すぐ最初のセマンティック集計を実行してみましょう。
- 戦略的クラウド エンジニア、Pramod Niralakeri
- データ担当クラウド移行コンサルタント、Shruti Malgatti