エージェントの時代における妥協のない新しいデータベース アーキテクチャ
Amit Ganesh
VP Engineering, Databases
Sailesh Krishnamurthy
VP Engineering, Databases
※この投稿は米国時間 2026 年 9 月 25 日に、Google Cloud blog に投稿されたものの抄訳です。
データベース エンジニアはキャリア全体を通して、ある 1 つの課題に取り組んできました。それは、データを保持する記録システムの信頼性を損なうことなく、OLTP ワークロードをどのようにスケールするかということです。
Exadata は、データベース下部のスケールアウト ストレージ階層にクエリをオフロードすることで、ネットワークのボトルネックを排除し、この課題を解決しました。Azure SQL Hyperscale は、共有ブロック サーバーを使用して、数十のリードレプリカにスケールアウトしました。Aurora は、ログの適用処理を分散ストレージ ノードにオフロードし、複数の PostgreSQL ノードにわたる読み取り処理のスケーリングを実現しました。一方、新しいアーキテクチャでは、従来のオブジェクト ストレージにデータを永続化し、その手前にプロビジョニングされたキャッシュ階層を配置しています。これにより、ホットデータのレイテンシは抑制できるものの、キャッシュミスが発生するたびに長いレイテンシが発生します。
これらのアーキテクチャはどれも、スケール、レイテンシ、分離という 3 つの特性のうち、少なくとも 1 つ、場合によっては 2 つの制約を本質的に抱えています。たとえば、共有ブロック サーバー上に構築されたアーキテクチャでは、ブロック サーバーで I/O が必然的にボトルネックになるため、スケーラビリティが損なわれます。また、レプリケーション トラフィックが急増するたびに本番環境のワークロードがスロットリングされるため、分離も損なわれます。
こうしたトレードオフの中には、設計当初は実際に妥当だったものもあり、40 年間にわたってエンタープライズ データベース ワークロードの要件を満たしてきました。しかし、エージェントの時代においては、このような妥協はもはや通用しません。エージェント ワークロードは動的に生成されるため、事前に検証することはできません。そのため、ミッション クリティカルなシステムから分離することが、ビジネスの継続性を確保するうえで不可欠です。エージェント ワークロードは、データベース エンジンとそのすべてのインデックスの能力を最大限に活用して初めて実現できる低レイテンシを必要とします。同時に、単一のデータベースでは前例のない、まったく新しいレベルの弾力的なスケーリングも求められます。具体的には、単一のデータベースに対して数秒以内に 1,000 個のコンピューティング ノードを要求し、1 分以内に処理を終了するような、エージェントのバーストに対応できるスケーリングです。
真のエージェント型データベース アーキテクチャに必要な 3 つの原則
エージェントの時代には、3 つの基本原則によって定義される新しいエージェント型データベース アーキテクチャが必要であると Google は考えています。エージェント型データベース アーキテクチャがその真価を発揮するには、これら 3 つの条件すべてを満たすことが不可欠です。
-
原則: 分離 - 設計レベルでの分離でありながら、リアルタイムなデータアクセスを実現。エージェントは、プライマリ クラスタとデータベース コンポーネントを共有しないデータパスを介して、1 秒未満の更新頻度で本番環境のライブデータを読み取る必要があります。リアルタイムとは、古いコピーやブランチではなく、秒単位で更新される最新のデータを意味します。これは割り当てではなく、物理的な分離です。リソースを共有するということは、運命を共にすることを意味するからです。その境界線はストレージ レイヤまで達しているため、設計レベルでリソースの競合を排除しています。
-
原則: レイテンシ - 1 ミリ秒未満のベースライン I/O。運用ワークロードでは 1 ミリ秒未満のブロック I/O が求められますが、エージェントでもその基準は変わりません。コンピューティング ノードは DRAM とローカル SSD を利用して高速化を実現していますが、キャッシュミスが発生してリモート ストレージへアクセスする場合であっても、アプリケーションかエージェントかを問わず、1 ミリ秒未満で処理を完了できるストレージ設計が求められます。パフォーマンスが桁違いに低下するアーキテクチャは、エージェントにとって根本的に使い物になりません。
-
原則: スケール - エージェント スケールのコンピューティングと I/O。エージェントのスケールは、瞬発的かつ一時的でありながら、極めて大規模という特徴を同時に持ちます。データベース コンピューティング ノードは、数秒でのスピンアップ、数千台へのスケール、短時間でのバースト実行、エージェントの処理終了後の自動的なゼロへのスピンダウンを行う必要があります。本番環境に一切影響を与えずに、データベースのコンピューティングと I/O を数千ノード規模へ即座にスケールさせることは、従来のデータベースの常識では不可能なことでした。エージェントの動的な性質を考えると、コンピューティング、ストレージ I/O、その間にあるキャッシュ階層にいたるまで、スタック全体における事前プロビジョニングは現実的ではありません。
重要なのは、エージェント アーキテクチャは、これら 3 つの原則をすべて同時に満たす必要があるということです。こうしたアーキテクチャにより、エージェントは本番環境の安定性を損なうことなく、ライブ運用データ、つまり企業の実体に直接アクセスして処理を行うことができます。その結果、以下のような劇的な変化がもたらされます。
-
連動障害がない: ビジネスを運営するエンジンと、その上で推論を行うエージェント フリートが完全に分離されているため、エージェントが本番環境に影響を与える経路が排除されます。
-
容量予測が不要: 真の弾力性により、予測不可能なエージェントの急増に備えて事前プロビジョニングを行う煩わしさが解消されます。
-
セマンティクスの妥協がない: エージェントに対して制限される機能はありません。すべての推論ステップにおいて、リレーショナル SQL、ハイブリッド検索(ベクトル、全文、空間)、そしてインデックスの機能を最大限に活用できます。
AlloyDB のエージェント アーキテクチャ
AlloyDB の新しいエージェント型データベース アーキテクチャは、これら 3 つの原則をすべて満たす初のシステムです。Google は、ストレージ、ネットワーク、コンピューティング、データベースにわたって、これをゼロから構築し、以下を実現しました。
-
分離によって設計レベルでの障害の連鎖を回避: トランザクション本番環境クラスタは、エージェント ワークロードから完全に分離され、事前プロビジョニングされた専用インフラストラクチャ上で実行されます。エージェントは、Model Context Protocol(MCP)を介して、本番環境とは別の専用の Colossus ストレージ セグメントから直接読み取る、マイクロ VM ベースの AlloyDB ノードの独立したエフェメラル プールに接続します。
-
予測可能な 1 ミリ秒未満のストレージ I/O: すべてのストレージ読み取りは、Google の Colossus ストレージ システムによって直接処理され、1 ミリ秒未満のベースライン レイテンシを継承します。これにより、コールド キャッシュミスによるパフォーマンスの急激な低下がなくなります。
-
ゼロから数千ノードへの真のコンピューティング スケーリング: エージェント プールは、エージェント アクティビティのバーストに対応して、ゼロから数千のノードへと迅速にスケールアップし、タスクが完了した瞬間にゼロにスケールダウンします。
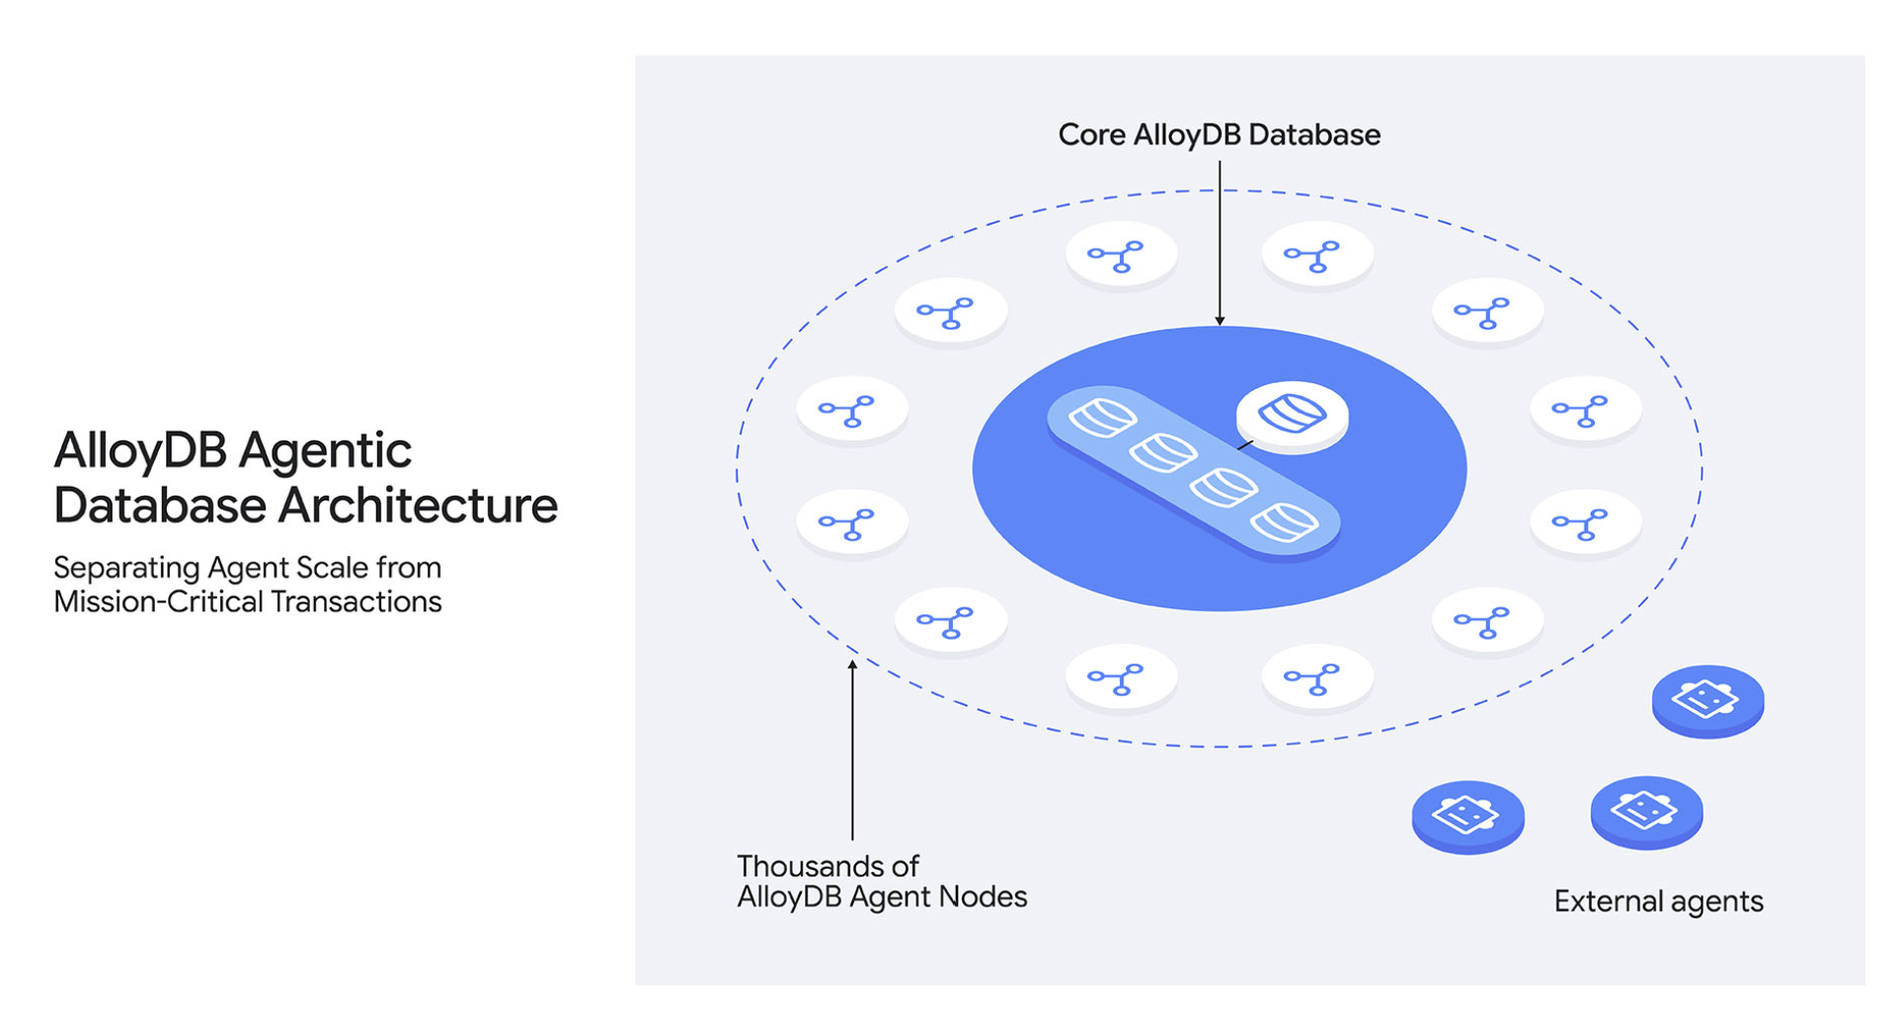
エージェントは、1 秒未満の更新頻度で本番環境データをクエリし、PostgreSQL エンジンのすべての機能(ポイント検索、インデックス トラバーサル、ベクトル、全文検索、空間検索、カラム型スキャン、レイクハウス全体の連携クエリ)を駆使して、推論ループを強化できます。
エージェント向け AlloyDB PostgreSQL のプレビューに参加して、データの規模を問わず本番環境データ上でエージェントを実行しましょう。その全機能について詳しくは、関連するお知らせのブログ記事をご覧ください。
既存のアーキテクチャが 3 つの原則をすべて満たせない理由
従来型および新興の運用データベースは、3 つのアーキテクチャ パラダイムのいずれかを採用することでスケーリングを図っています。自律型 AI エージェントの要件に照らして評価すると、どのパラダイムにも構造上の根本的な限界があり、3 つの原則を同時に満たすことは不可能です。
独立したレプリカ(シェアードナッシング ストレージ)
従来のリレーショナル アーキテクチャでは、プライマリ インスタンスから専用のレプリカ データベースにレプリケーション ログをストリーミングすることで読み取りをスケールします。各レプリカ データベースは、それぞれ専用のローカル ストレージまたはアタッチされたブロック ストレージを備えています。これは「原則: 分離」を満たしています。つまりレプリカはプライマリ クラスタと物理リソースを共有せず、継続的なログ レプリケーションにより、準リアルタイムの最新性が維持されます。また、「原則: レイテンシ」も満たしています。専用のローカル ストレージにより、予測可能な 1 ミリ秒未満の読み取りレイテンシが保証されます。しかし、「原則: スケーリング」は満たしていません。スケーリングには、新しいレプリカをプロビジョニングし、数百ギガバイトまたはテラバイトのストレージをリハイドレーションする必要があります。これらすべての処理には数時間かかります。これでは、秒単位で発生するエージェントの爆発的な推論バーストには対応できません。さらに、静的にプロビジョニングされたコンピューティングとストレージは、エージェントの実行が完了した後も、アイドル状態でコストが発生し続けます。
分離された共有ストレージ サーバー
2 つ目のアプローチは、ステートレス コンピューティング ノードを、永続性とレプリケーションを管理し、ブロック書き込みをオフロードする可能性のあるカスタム ストレージ サーバーの共有マルチテナント階層から切り離すことです。このアプローチは、「原則: レイテンシ」を満たします。最適化されたストレージ サーバーへの読み取りアクセスは、常に安定した低いレイテンシで処理されます。しかし、「原則: 分離」は満たしていません。すべてのレプリカがプライマリと同じサーバーから読み取るため、エージェント I/O が本番環境 I/O と直接競合し、障害の連鎖のリスクが生じるためです。また、「原則: スケール」も満たしていません。データがコピーされないため、ステートレス コンピューティング レプリカは迅速にスピンアップするものの、ストレージ I/O の合計帯域幅が、事前にプロビジョニングされたストレージ階層の容量に制限されるためです。基盤となる I/O 容量をスケールせずにコンピューティング ノードを追加しても、ストレージの処理能力が飽和し、スロットリングを加速させるだけです。
共有ブロック サーバーを使用したオブジェクト ストレージ
3 つ目の新しいアプローチは、汎用オブジェクト ストレージでデータの耐久性を確保し、ブロック サーバーの共有階層からブロック読み取りを行うというものです。オブジェクト ストレージからのランダム読み取りには数十ミリ秒かかります。これは従来のデータベース ストレージより桁違いに遅く、少なくとも 25 年前のエンタープライズ向けディスクアレイと比べてもさらに遅いレベルです。そのため、ブロック サーバーにホットデータを保持させることで、低レイテンシでのデータ提供を実現しています。このアプローチは、「原則: レイテンシ」を満たしますが、1 つ注意点があります。それは、ブロック サーバーでキャッシュミスが起きると、許容できないほど高いレイテンシでオブジェクト ストレージまでフォールバックが発生してしまう点です。一方で、「原則: 分離」を満たしていません。レプリカは本番環境とブロック サーバーを共有しているためです。エージェント I/O と本番環境 I/O は同じ処理容量を使用します。そのため、その容量が枯渇したりスロットリングされたりすると、エージェントだけでなく本番環境にも影響が及びます。また、共有ストレージ サーバーと同じ理由で、「原則: スケール」も満たしていません。レプリカはすぐに起動しますが、ブロック サーバーがバーストに合わせて I/O をスケールしないためです。
このファミリーの一部のアーキテクチャでは、Apache Spark などの分析エンジンがデータベース エンジンをバイパスして、基盤となるオブジェクト ストレージを直接読み取ることもできます。分析ワークロードの場合、これは価値があり、十分に現実的なアプローチです。しかし、エージェントには低レイテンシの検索が不可欠です。インデックス、ポイント検索、ベクトル検索を排除すると、ブルート フォース テーブル スキャンが余儀なく行われ、レイテンシが急増し、エージェントが検索と推論のループを実行できなくなります。
既存アーキテクチャの評価
Google は、共有ブロック サーバーを備えたオブジェクト ストレージ アーキテクチャを使用する市販のサービスを対象に、スケーリングの限界と本番環境の分離の両方を検証する評価を行いました。利用可能な DRAM よりも大きなデータセットに対して、同時にインデックス検索を実行しました。1 つのリーダー インスタンスから始めて、最大 8 つのリードレプリカを追加してワークロードをスケールしました。
物理リソースを共有するアーキテクチャでは、リードレプリカを追加してエージェントをスケールすると、レプリカとプライマリの両方のパフォーマンスが急速に低下します。以下のグラフに示すように、Google のテストでは、レプリカを追加してもスループットの増加は 2 倍未満にとどまりました。レプリカ 4 台でピークに達した後、共有ブロック サーバーの帯域幅が飽和状態になると、スループットは低下しました。

プライマリ データベースへの影響は即座に、かつ深刻な形で現れました。レプリカが追加されると、プライマリのスループットは 75% 以上も急落したのです。

つまり、従来型と新興型のどちらのアーキテクチャも、エージェントが求める規模に対応できないということです。本番環境システムの安定性を損なうことなくそれを実現することは、到底不可能です。
原則に基づく評価
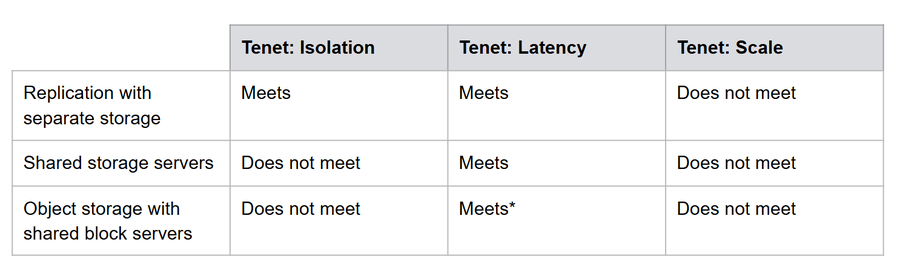
* 部分的に対応: ホットデータはブロック サーバーから低レイテンシで提供されますが、ブロック サーバーでキャッシュミスが発生すると、オブジェクト ストレージへのアクセスが生じて数十ミリ秒のレイテンシが発生します。
いずれの場合も、この課題は構造的なものであり、単にチューニングで解決できる問題ではありません。レプリケーションは、各レプリカに専用ストレージを割り当てることで分離を実現します。そのため、そのストレージへのデータ同期にかかる時間よりも短い時間でレプリカを追加することはできません。共有ストレージ サーバーは、ストレージを共有することでコンピューティングを迅速に追加できますが、I/O を分離することもスケールすることもできません。オブジェクト ストレージ上のブロック サーバーは、プロビジョニングされた階層でレイテンシを抑制できるものの、分離もバーストもできず、キャッシュミスが発生するたびにオブジェクト ストレージへのアクセスが生じてしまいます。どのアプローチも、あるレイヤで問題を解決したとしても、別のレイヤでその代償を払うことになります。3 つの原則をすべて同時に満たすには、コンピューティング、ネットワーク、ストレージにわたるデータベース アーキテクチャを再考する必要があります。
AlloyDB をスタック全体でどのように構築したか
AlloyDB のエージェント型データベース アーキテクチャは、Google のデータ、AI、インフラストラクチャ スタック(AI モデル、データベース エンジン、および分析エンジン、さらにはストレージ、ネットワーキング、コンピューティング インフラストラクチャ)全体にわたって垂直統合されています。
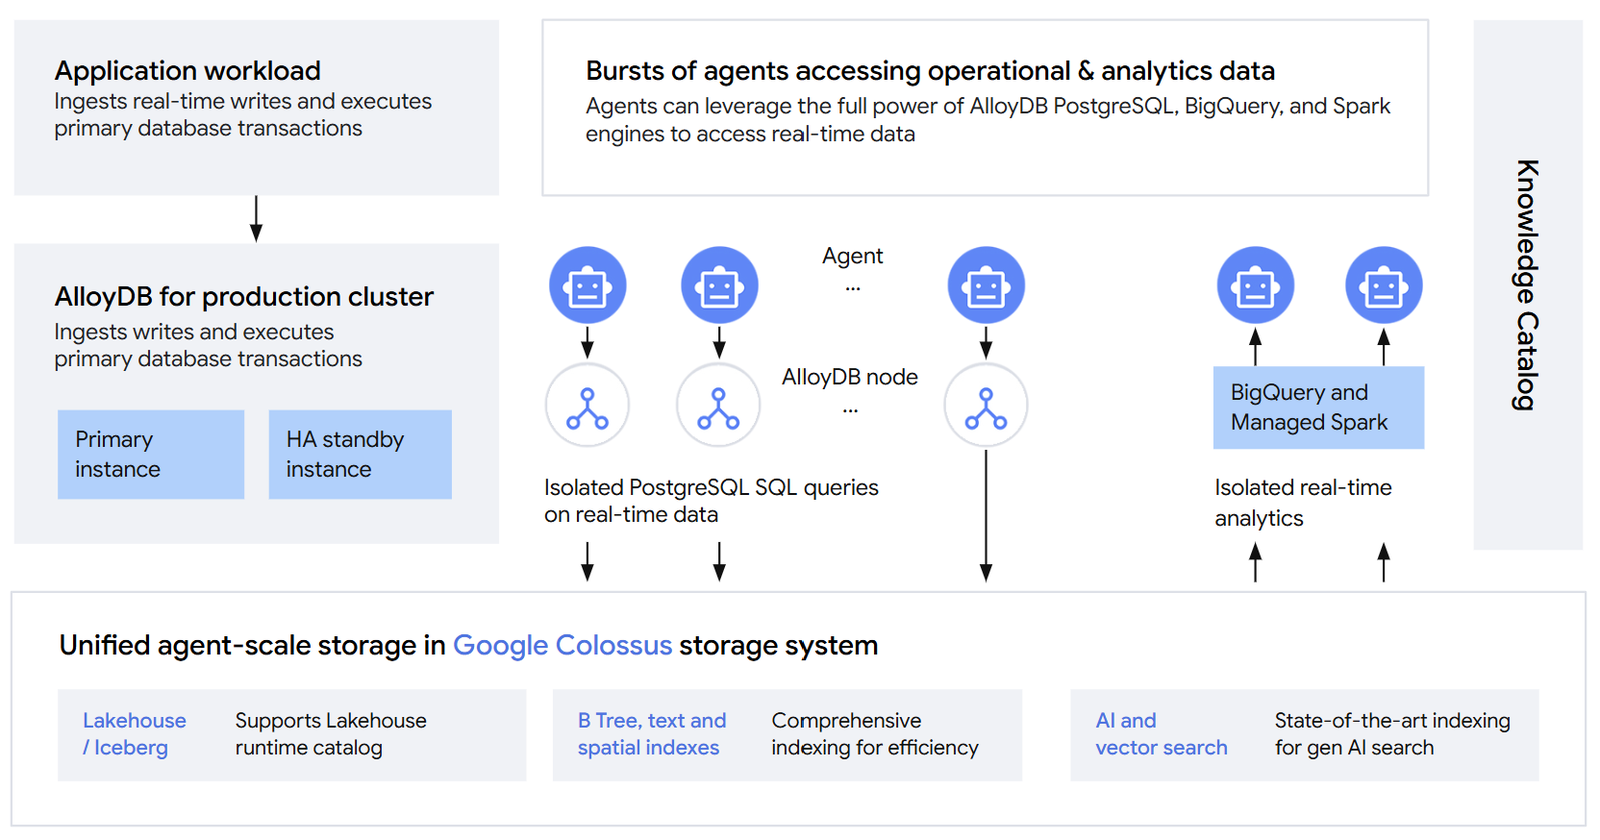
ストレージ: 基盤としての Colossus
永続レイヤでは、AlloyDB は Google のエクサバイト規模の分散ストレージ システムである Colossus を基盤としています。Colossus は、Google 検索、YouTube、Gmail、Google ドライブ、Spanner、Bigtable を支えています。1 つの Colossus クラスタは、エクサバイト規模のストレージと数万台のマシンにスケールします。Spanner では、Colossus 上に直接構築されたトランザクション データベースが数千ノードまでスケールできることを実証しました。新しい AlloyDB アーキテクチャは、同じ基盤を新たな課題、すなわちエージェントに適用します。
Colossus には、AlloyDB がこれら 3 つの原則を満たすための、3 つの特性があります。
-
1 ミリ秒未満の直接 I/O: Colossus は、読み取りレイテンシを最小限に抑えるように設計されています。Colossus ストリームを開くデータベース ノードは、データが物理的に存在する場所を記述したハンドルを受け取ります。承認とメタデータの解決は、ストリームの作成時に 1 回しか行われません。それ以降の読み取りはすべて、最適化されたネットワーク プロトコルを介して、データを保持するディスクに対して直接行われます。その結果、データベースのすべてのデータで 1 ミリ秒未満のレイテンシが実現します。ウォームアップする中間層も、キャッシュミスを起こすような層もありません。
-
圧倒的なスループット: Colossus は、帯域幅をプロビジョニングする必要がなく、同時ホスト数に制限がないため、単一の AlloyDB データベースに対して最大 15 TB/秒の総スループットと 2,000 万の秒間クエリ数を実現します。Colossus のスケールから見れば、AlloyDB エージェント ノードのフリートがもたらす負荷は、ストレージのサイズ調整が必要になるようなものではありません。それは、このストレージがすでに処理している負荷のごく一部にすぎないからです。
-
物理セグメントのパーティショニング: AlloyDB は、本番とは別の Colossus セグメントからエージェントにサービスを提供するため、エージェントの I/O が本番環境のデータパスと競合することはなく、意図的に本番環境のデータパスから分散されます。
コンピューティング、ネットワーク、ストレージのいずれのデータパスにおいても、エージェントがデータベース コンポーネントを本番環境と共有することはありません。
ネットワーク: Jupiter によるスケーラブルな帯域幅
コンピューティングとストレージは、Google の大容量データセンター ネットワークである Jupiter によって結び付けられています。1 つの Jupiter ファブリックが 10 万台以上のサーバーを 13 ペタビット/秒の二分割帯域幅で接続します。これは、地球上のすべての人がビデオ通話を行うのに十分な帯域幅です。
Jupiter は、ネットワーキング ファブリック全体で予測可能な低レイテンシと高い二分割帯域幅を提供します。そのため、エージェント ノードをクラスタ内のどこにでも柔軟に配置でき、一元化されたストレージに常にアクセスできます。エージェント プールがゼロから数千ノード規模にスケールするにつれて、基盤となる相互接続の容量が、配置上のボトルネックを発生させることなく、増大するトラフィックを吸収します。
コンピューティング: 柔軟でサーバーレスな PostgreSQL と分析
コンピューティング レイヤでは、エージェントが MCP を介して AlloyDB のエージェント プールに接続します。エージェント プールを構成する AlloyDB エージェント ノードは、データベースの秒単位の最新状態に、読み取り専用でアクセスできます。このレイヤは、以下の機能を提供します。
-
マイクロ VM 分離: 各エージェント ノードは、軽量かつセキュアなマイクロ VM 内で実行される、完全に機能する AlloyDB for PostgreSQL データベース エンジンです。これらのインスタンスは、互いに完全に分離されており、専用のプライマリ クラスタからも分離されています。
-
迅速なスピンアップとスケーリング: エージェント ノードは、エージェントからのリクエストに応じてプロビジョニングされ、エージェントが処理を終了すると自動的に停止します。バーストが発生すると、AlloyDB は数千のエージェント ノードを迅速にプロビジョニングし、数百万の同時エージェントにサービスを提供します。エージェントが処理を終了すると、それらを解放します。課金はエージェント ノードのアクティビティの秒単位で行われるため、1,000 個のノードを数十秒間使用するバーストでは、ジョブが消費したリソースに対してのみ課金され、それ以上のコストは発生しません。
一方、本番環境クラスタは、専用インフラストラクチャ上に事前プロビジョニングされ、記録システムに合わせてサイジングされた、従来通りの状態のまま維持されます。エージェント ノードは Colossus から直接データを読み取るため、1 秒未満の更新頻度で、一貫した本番環境のデータを参照できます。
エージェント プール以外にも、BigQuery と Spark は本番環境クラスタから同じように分離された Colossus から AlloyDB データを読み取ることができるため、エージェントは Lakehouse Federation を使用して、リアルタイムの運用データを大規模な Lakehouse データセットと結合できます。
AlloyDB の新しいエージェント データベース アーキテクチャは、Google 規模のストレージ、ネットワーク、コンピューティング レイヤを基盤とすることで、際立った目標を達成しています。それは「データのみを共有し、それ以外は何一つ共有しない」という目標です。
AlloyDB のエージェント型データベース アーキテクチャの評価
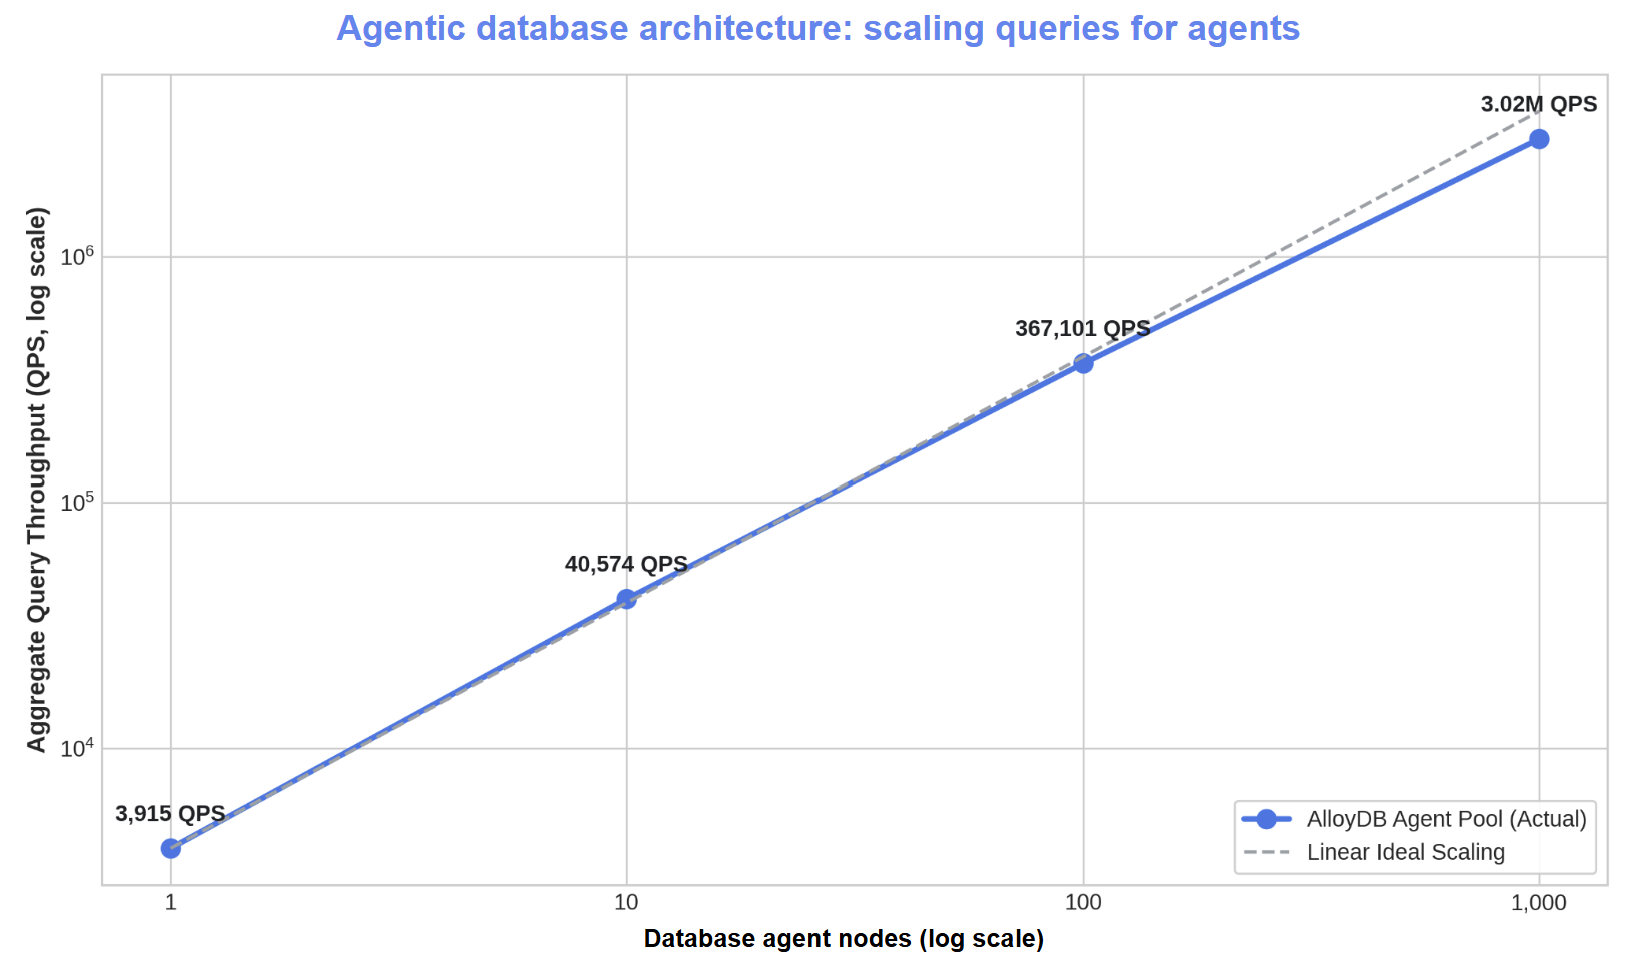
Google は、利用可能な DRAM よりも大きなデータセットに対して同時インデックス検索を実行し、フルスタック全体におけるスケーラビリティを検証することで、AlloyDB の性能を評価しました。エージェント ワークロードを、単一のエージェント ノード(従来のリードレプリカではなく、エージェント プール内の独立したデータベース インスタンス)から開始し、単一のデータベース上で数千ノードまで動的にスケールしました。その際、エージェント全体の合計スループットと、本番環境への影響を測定しました。
このテストでは、エージェント ノードを 1 つから 10 個に増やすと、スループットが 3,900 QPS から 4.1 万 QPS へとほぼ完全に比例して向上しました。さらに 2 桁上(100倍)の規模までスケールさせても、最大 1,000 ノードに達するまで、ほぼ完全に比例したパフォーマンスが得られました。Google は、以下を確認しました。
-
プライマリのパフォーマンス低下ゼロ: エージェント ノードを 1 から 1,000 にスケールしても、プライマリ クラスタのパフォーマンスに測定可能な影響は生じませんでした。
-
膨大なスループット: 合計スループットが動的に 773 倍の 300 万 QPS にスケールされ、1,000 台のコンピューティング ノードにわたって Colossus で 800 万 IOPS 以上を達成しました。
2,100 のエージェント ノードでテーブル全体のスキャンを同時に実行する同様のベンチマークでは、合計スキャン スループットが 1 秒あたり約 1 テラビットを超えました。
エージェント プールは本番環境クラスタと物理インフラストラクチャを共有しないため、チームは本番環境システムを危険にさらすことなく、推論フリートを数千ノード規模にスケールできます。
3 つの原則すべてを設計に組み込む
次の表は、AlloyDB のアーキテクチャが 3 つの原則をどのように満たしているかを示しています。
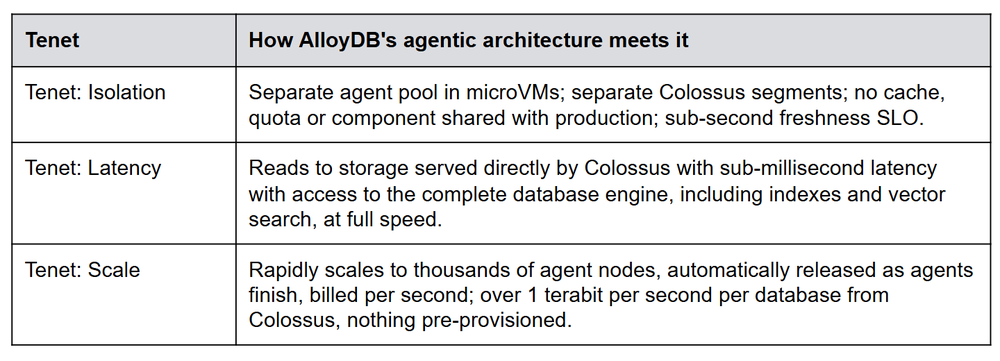
エージェント型データベース アーキテクチャには、これら 3 つの基本要素が不可欠です。すなわち、Colossus の特性を備えたストレージ、コンピューティングとストレージをボトルネックなしに接続するネットワーク、そしてエージェントの規模に合わせてプロビジョニングと解放ができるコンピューティングです。
Google は、Google 検索、YouTube、Gmail を稼働させるために、20 年以上かけてまさにその基盤を構築してきました。現在、これは Google のエージェント型データベース アーキテクチャの基盤となっています。
本番環境に影響を与えることなく、エージェントにライブデータを提供
AI を活用した開発に取り組むすべての組織が、ある共通のジレンマに直面しています。それは、ビジネスを支えるシステムを危険にさらすことなく、エージェントに対して本番環境のライブデータへの完全なアクセス権をどのように付与するか、という問題です。これまでは、アプリケーションのニーズではなく、アーキテクチャの制約によって、その選択を強いられていました。エージェントにデータベースへの直接アクセスを許可すると、ミッション クリティカルなシステムを、予測不可能な負荷、深刻なリソース競合、本番環境の停止のリスクにさらすことになります。
これら 3 つの原則に基づいて構築されたアーキテクチャは、こうした妥協を完全に排除します。エージェントは、1 秒未満の更新頻度を保った本番環境のライブデータに基づいて推論します。そして、すべてのインデックス、ベクトル、全文検索、空間検索、SQL の全機能など、エンジンのフル機能を 1 ミリ秒未満の I/O で自由自在に駆使できます。このアーキテクチャは、エージェントの要求に応じて数千もの分離されたノードに動的にスケールし、処理が終了したらゼロにスケールダウンします。その間も、コア トランザクション ワークロードは影響を受けることはありません。共有コンポーネントも、共有割り当ても存在せず、連動障害のリスクもないからです。エージェントは、ビジネスの継続性を損なうことなくビジネスにイノベーションをもたらすことができます。
この優れた特性が、本番環境データを参照する他のすべてのシステムにも適用されます。レポート、分析、アプリケーションは、本番環境を危険にさらすことなくライブデータを自由に読み取ることが可能になり、50 年間にわたってオペレーショナル データベースを縛り続けてきた制約が、ついに解消します。
企業の記録システム内のデータは、その企業にとって最も重要なものです。この基盤の上に構築されたそのデータは、ついに最大限に活用できるようになります。
制約なきデータベースへ。
詳細については、ドキュメントページをご覧ください。こちらから登録すると、今すぐご利用いただけます。
- データベース エンジニアリング担当バイス プレジデント、Amit Ganesh
- データベース、エンジニアリング担当バイス プレジデント、Sailesh Krishnamurthy