AlloyDB と Cloud SQL のネイティブ BM25 ランキングを発表
Darshana Sivakumar
Group Product Manager
Nisa Meshal
Customer Engineer
※この投稿は米国時間 2026 年 9 月 19 日に、Google Cloud blog に投稿されたものの抄訳です。
ベクトル検索は、生成 AI、検索拡張生成(RAG)、データ エージェント アーキテクチャの重要なコンポーネントですが、ベクトル検索だけでは不十分な場合もあります。ベクトル エンベディングは概念的な意味を理解するのに優れていますが、特定の英数字 ID や正確な商品 SKU 番号を扱うのは苦手です。真に堅牢な検索アプリケーションや AI アプリケーションを構築するには、セマンティック ベクトル検索と従来の完全一致キーワード全文検索を組み合わせる必要があるかもしれません。これは、ハイブリッド検索と呼ばれます。
検索において、Best Matching 25(BM25)は、特定のクエリに対するドキュメントの関連性を推定するために使用される重要なアルゴリズムです。これまで、AlloyDB や Cloud SQL で BM25 ランキングを使用するには、全文検索バックエンドを追加する必要がありました。これにより、データサイロ、同期の遅延、運用の複雑化が生じていました。このたび、Tiger Data が作成したオープンソースの pg_textsearch 拡張機能により、AlloyDB と Cloud SQL for PostgreSQL 17 以降でネイティブ BM25 インデックスのプレビュー版が利用可能になりました。これにより、個別の全文検索バックエンドを維持する手間がなくなります。
統合されたハイブリッド検索バックエンドにより、最先端の全文検索を実現するために、個別のシステムをプロビジョニング、管理、または購入する必要がなくなりました。これらはすべて、運用データが保存されているデータベース内で直接行われ、以下を実現します。
-
業界標準のキーワード ランキング: Tiger Data の
pg_textsearchを活用して、C 言語で最適化された超高速の BM25 スコアリングを Postgres テーブルに直接適用できます。 -
複雑さを排除し、完全な整合性を実現: ベクトル検索と全文検索のために複数のバックエンドを維持する場合に発生する、データの重複、ETL パイプライン、同期の遅延を排除します。
-
強化されたセマンティック検索(AlloyDB 限定): ScaNN および HNSW インデックス タイプにより、ベクトル検索クエリが(標準の PostgreSQL と比較して)最大 6 倍および 10 倍高速になります。
pg_textsearch を使用する理由
PostgreSQL に組み込まれている ts_rank を使用して、ある程度の規模で全文検索を行ったことがある方なら、その限界をご存じでしょう。コーパスが大きくなるにつれて、ランキングの品質が低下します。逆文書頻度はサポートされていないため、一般的な単語は珍しい単語と同じ重み付けになります。用語頻度飽和がないため、「データベース」という単語が 50 回出現するドキュメントは、1 回しか出現しないドキュメントよりも上位にランクされます。
BM25 は、情報検索のゴールド スタンダードであり、逆文書頻度(珍しい用語ほど重要)、用語頻度飽和(繰り返しに左右されない)、文書長正規化を提供します。Tiger Data のブログ投稿では、PostgreSQL ページで BM25 検索エンジンを構築した方法について詳しく説明しています。
全文検索の例
AlloyDB と Cloud SQL の両方で BM25 全文検索を始める方法をご紹介します。サンプル テーブル cymbal_products を考えてみましょう。このテーブルには、固有識別子 uniq_id、product_name 列、各商品のテキスト説明を含む product_description 列、生成された product_embedding 列が含まれています。cymbal_products には、屋内植物や屋外植物など、さまざまな小売商品に関する情報が含まれています。
インデックスの作成
BM25 を使用するには、pg_textsearch 拡張機能を有効にします。
cymbal_products テーブルの product_description 列にインデックスを作成します。
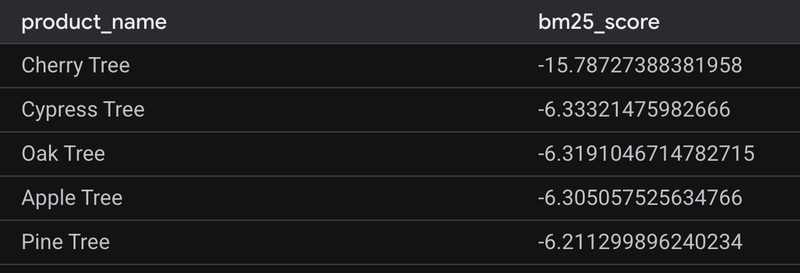
BM25 全文検索クエリは、<@> 特殊演算子を使用して実行できます。以下のスニペットでは、「cherry tree」を検索しています。
出力例を以下に示します。スコアが低いほど、関連性が高いことを示します。
AlloyDB ハイブリッド検索の例
AlloyDB でハイブリッド検索システムを設定するのは簡単です。同じテーブルにベクトル インデックスとキーワード インデックスの両方を作成し、ハイブリッド検索ユーザー定義関数(UDF)を使用して結果をシームレスに統合できます。
ベクトル インデックスの作成
ScaNN ベクトル検索インデックスを作成する方法は次のとおりです。
ハイブリッド検索
AlloyDB には、ハイブリッド検索クエリを非常に簡単に実行できる、すぐに使用可能なハイブリッド検索 UDF が用意されています。UDF は、Reciprocal Rank Fusion(RRF)アルゴリズムを使用して、各検索コンポーネントのランク付けされた結果を 1 つの統合リストにマージします。このクエリは、UDF を利用して、商品説明で「trees that grow taller than houses(家よりも高く成長する木)」のベクトル検索と「California(カリフォルニア)」のキーワード検索を実行します。
以下のサンプル出力に示すように、結果は RRF スコアの降順でランク付けされます。
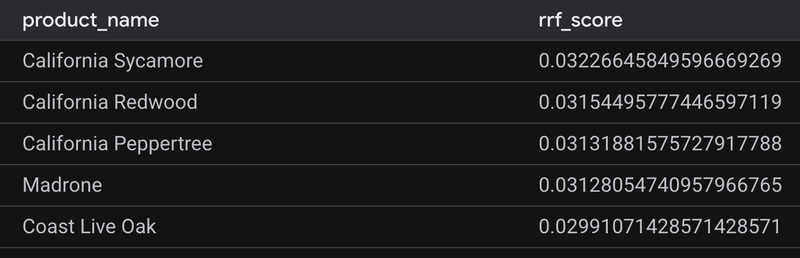
ここで、ハイブリッド検索は、セマンティックな直感と正確なキーワード マッチングのギャップを埋めます。ベクトル エンベディングは「家より高く育つ木」のような概念的なクエリの理解に優れていますが、従来の全文検索は「カリフォルニア」のような厳密な識別子に求められるピンポイントの精度を提供します。この 2 つを融合することで、AlloyDB は、アプリケーションが「California Sycamore」のような、地域に関連性の高い具体的な結果をリストの最上位に優先的に表示できるようにします。
Cloud SQL ハイブリッド検索の例
Cloud SQL では、同じテーブルにベクトル インデックスとキーワード インデックスの両方を作成し、共通テーブル式(CTE)を使用して結果をシームレスに結合し、以下に示すように RRF スコアを統合できます。
ベクトル インデックスの作成
Cloud SQL で HNSW インデックスを作成する方法は次のとおりです。
ハイブリッド検索
こちらがハイブリッド検索クエリです。
結果の出力は、上記の AlloyDB ハイブリッド検索の結果と同じです。
実際の操作を見る
こちらのデモ動画で、これらの機能がどのように連携するかをご覧ください。
関連リソース
Google は、Tiger Data と協力できることを大変嬉しく思っています。また、皆さまにネイティブ BM25 サポートを活用いただき、より高速でスマート、かつシンプルな AI アプリケーションを構築していただけることを楽しみにしています。今すぐ pg_textsearch 拡張機能を有効にして、AlloyDB と Cloud SQL で究極のハイブリッド検索エンジンを体験してください。
お試しになりたい場合は、以下のリソースをご確認ください。
-
AlloyDB のリソース
-
AlloyDB をまだご利用でない場合は、30 日間の無料トライアルで AlloyDB をお試しください
-
Cloud SQL のリソース