Cloud Run 上の Temporal Serverless Workers: 需要の変動を見越してワーカーをスケーリング
Sagar Randive
Product Manager
Aniruddh Chaturvedi
Engineering Manager
※この投稿は米国時間 2026 年 10 月 16 日に、Google Cloud blog に投稿されたものの抄訳です。
オープンソースの Temporal 実行プラットフォームは、現代のソフトウェア インフラストラクチャにおける基盤レイヤとして急速に普及しており、特に分散システムや AI エージェント ワークロードのオーケストレーションで真価を発揮しています。しかし、Temporal でワーカーのデプロイやスケーリングを行うには、特有の課題が伴います。ワーカーはリクエストの処理ではなくタスクのポーリングを行うため、リクエスト ドリブンなサーバーレス プラットフォームには適していません。その結果、Kubernetes や VM 上でワーカー フリートを運用せざるを得なくなり、継続的な管理の手間と費用が発生します。指標パイプラインを構築し、自動スケーリングのトリガーをチューニングしても、指標の反映遅延によってスケーリングが急激な負荷に追いつかないことがあります。デプロイごとにアップグレードやバージョンの複雑な管理に追われ、タスクがキューにない状態でもコンピューティング料金を払い続けなければなりません。
Google は、まさにこのような pull ベースのタスクのために Cloud Run ワーカープールを開発しました。インスタンスがキューやストリームに接続し、次のアイテムを取り出して処理します。このたび、Temporal のオープンソース プラットフォームのフルマネージド版である Temporal Cloud が、これらのワーカープールを自動スケーリングできるようになりました。現在プレビュー版として提供されている Cloud Run 上の Temporal Serverless Workers を使用すると、ワーカーをワーカープールとしてデプロイできます。Temporal は、タスクキューの作業量に合わせてプールのサイズを自動調整します。タスクがない場合は、プールをゼロにスケールダウンできます。運用すべきクラスタやオートスケーラーは不要で、既存のワーカーコードもそのまま利用できます。
Cloud Run ワーカープールと Temporal の連携の仕組み
ワーカープールは、継続的なバックグラウンド タスクを実行するための Cloud Run リソースです。パブリック エンドポイントを持たず、各インスタンスのライフサイクル全体にわたって CPU が常時割り当てられます。これは Temporal ワーカーの実行モデルと一致しています。Temporal は、Cloud Run ワーカープールを次のように管理します。
-
Temporal ワーカーは、プロジェクト内で Cloud Run ワーカープールのインスタンスとして実行され、Temporal Cloud をポーリングしてタスクを取得します。
-
Temporal Cloud は、付与された IAM 権限を使用してタスクキューの状況をトラッキングし、Cloud Run Admin API 経由でワーカープールのインスタンス数を設定します。Temporal がインスタンスへの接続を開くことはないため、ポートを開いたり、ファイアウォール ルールを追加したりする必要はありません。
-
ビルドのバージョンごとに、それぞれ独立した Cloud Run ワーカープールとして実行します。古いビルドのワーカープールは、そのビルドで開始されたワークフローで再び処理が必要になるまで、インスタンス数をゼロの状態で待機させることができます。
Temporal ワーカーは、ご自身のプロジェクト内、サービス アカウント、ネットワーク上で実行されます。Temporal が、その実行数を判断します。
Temporal Serverless Workers の活用例
Cloud Run ワーカープールと Temporal Serverless Workers を組み合わせることで、以下のようなさまざまなユースケースが実現します。
自動スケーリングするエージェント ワーカー: AI エージェントが、LLM の推論とツール呼び出しのマルチステップ チェーンを実行します。ここでは、Temporal の耐久性に優れた実行機能と Cloud Run ワーカープールが効果的に連携します。Temporal ワーカーは即座にスピンアップし、LLM の処理ステップ、エンベディング生成、API 呼び出しなどの急激な負荷を処理したあと、キューが空になると自動でゼロにスケールダウンします。ワーカーは Google Cloud AI API にキーレスでアクセスできます。推論用に GPU をアタッチすることも可能で、その場合でも GPU 付きのワーカーは問題なくゼロまでスケールダウンします。Temporal は、各モデルやツールの呼び出しを耐久性に優れたアクティビティとして実行します。ステップの途中でワーカーが消失した場合でも、アクティビティは別のワーカーで再試行され、ワークフローは継続されます。
長時間実行されるワークフロー: Temporal ワークフローは無制限に実行し続けることができるため、現実世界のリソース状態を長期間にわたってトラッキングするアプリケーションを構築できます。このパターンは、あるエンティティの状態をワークフローが表すことから、一般に「エンティティ パターン」と呼ばれます。しかし、こうした長時間実行されるワークフローでは、常に一定のコンピューティングが必要とされるわけではありません。個々のステップによって処理時間が短いものもあれば長いものもあり、時にはワークフロー自体がスリープして、人間や外部システムからの入力を待機している状態になることもあります。Cloud Run ワーカープールは、このパターンをサポートする柔軟なコンピューティング リソースを提供します。個々のステップは必要な時間だけ実行でき、処理すべきタスクがないときは、Temporal がワーカープールを自動的にスケールダウンします。
バーストバッチ処理: ワーカープールはインスタンスの実行中にのみ課金されるため、バッチ実行の合間にアイドル状態になっているワーカープールは、インスタンスがゼロの間は費用が発生しません。請求処理やメディアのコード変換といったジョブでは、バッチ処理の到着に合わせて Temporal がプールをスケールアウトし、キューが空になると自動でスケールインします。最大インスタンス数を設定することで、課金対象となるインスタンス数を制限できます。設定した上限を超えるタスクは、ドロップされるのではなく、キューで待機します。
Temporal ワーカーの実行基盤に Cloud Run ワーカープールを選ぶ理由
以前は、Cloud Run サービス上で Temporal ワーカーを実行するために、いくつかの回避策を講じる必要がありました。
-
HTTP リスナーの実装(Cloud Run サービスは、コンテナが特定のポートでリクエストをリッスンすることを前提としているため)
-
インスタンス単位の課金への変更(リクエスト処理の合間もワーカーが CPU を保持し続けるようにするため)
-
最小インスタンス数の設定(Cloud Run サービスがゼロにスケールダウンしないようにするため)
Cloud Run ワーカープール上で Temporal ワーカーを実行することで、これらの回避策は不要になり、次のようなメリットが得られます。
-
エンドポイントの管理が不要。ロックダウンすべき公開 URL やロードバランサは存在せず、実装が必要なヘルスチェック ポートもありません。
-
低料金で安定した CPU。インスタンスはアイドル状態にならず、スロットリングも行われません。Cloud Run はアイドル状態に見えるインスタンスを勝手に削除しないため、プールが縮小するタイミングは Temporal のみが決定します。ワーカープールの料金は、インスタンス課金型の Cloud Run サービスと比較して、vCPU 時間あたりおよび GB 時間あたりで約 40% 安く設定されています。
-
リビジョンのチャーンなしでスケーリング。インスタンス数を変更しても新しいリビジョンは作成されないため、Temporal は負荷の変化に応じて頻繁にプールのサイズを変更できます。
Temporal によるワーカープールのスケーリングとバージョニングの仕組み
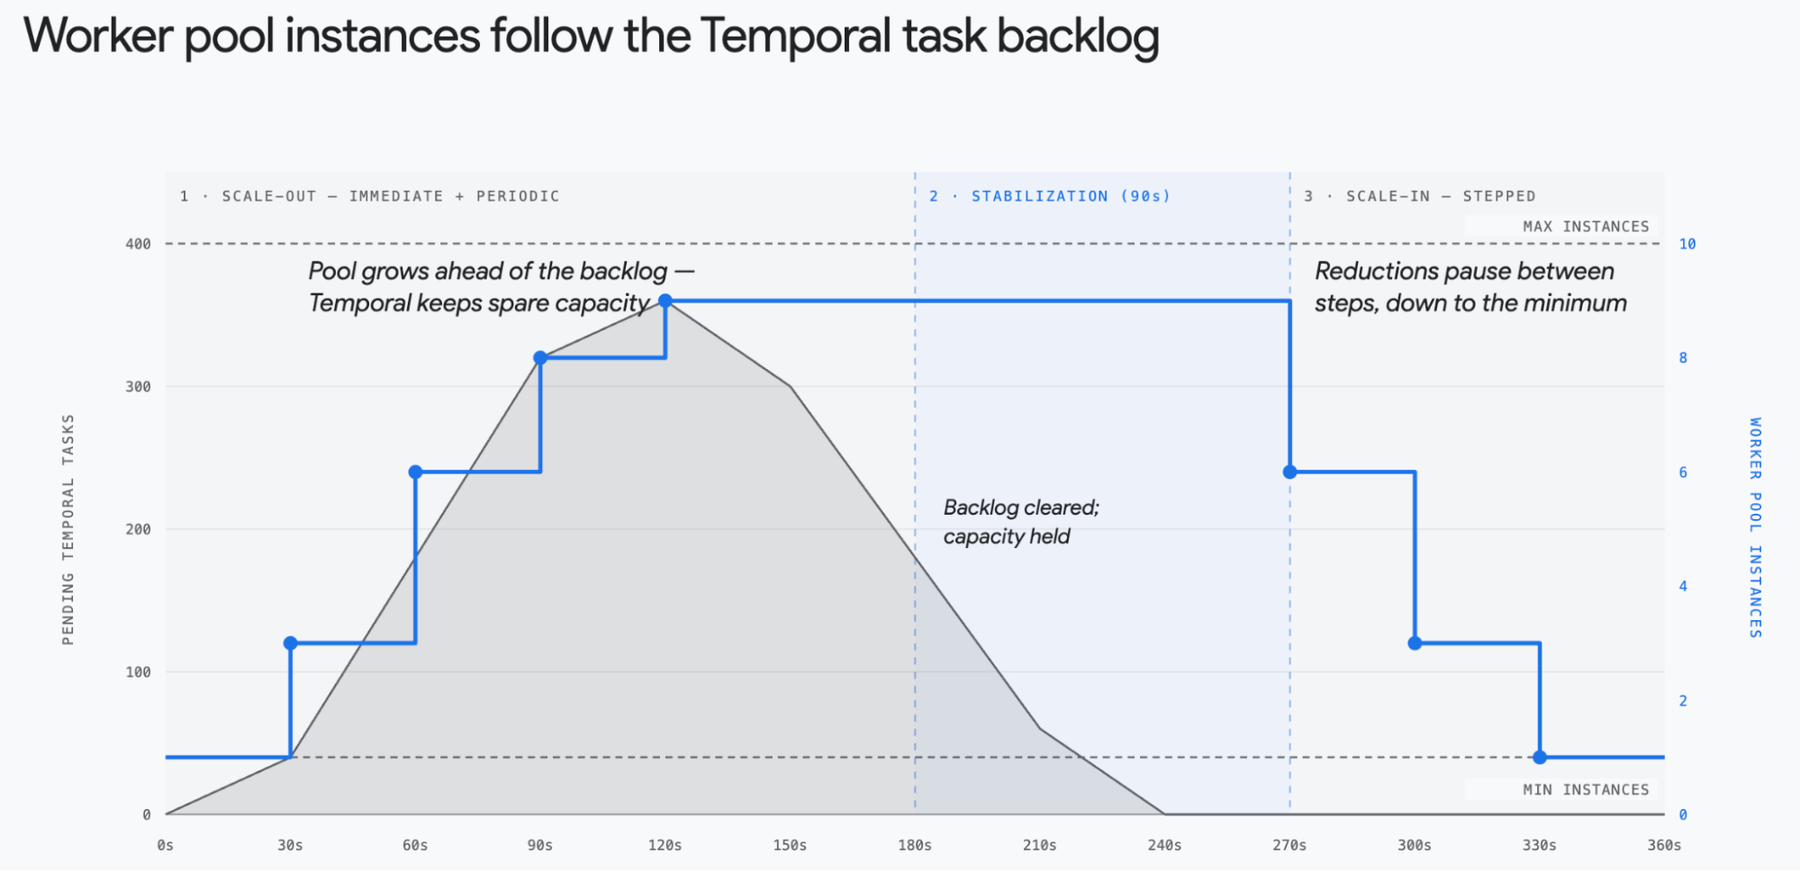
Temporal は、タスクがタスクキューのバックログに追加されてからワーカーに取得されるまでの遅延を主要な指標として、リソースを追加するタイミングを判断します。この遅延が大きくなっている場合は、利用可能なワーカーが飽和状態にあります。スケーリングは次のように行われます。
-
サーバーサイドの検出: Temporal サーバーは、タスクキューごとにバックログからワーカー取得までのレイテンシをトラッキングします。
-
プッシュ通知: レイテンシがトリガー条件を超えると、サーバーはワーカー コントローラ インスタンスにプッシュ通知を送信します。
-
プロビジョニング: ワーカー コントローラがワーカープールにリソースを追加します。新しいインスタンスが起動して接続し、タスクのポーリングを開始するまでには一定の時間を要するため、リソースの追加はシグナルの検知より遅れて反映されます。
Temporal は常に予備のリソースを保持しているため、タスクが溜まってから対処するのではなく、需要の増加に先立ちあらかじめプールを拡張します。スケールインはより慎重に行われます。Temporal は、利用可能なワーカーが見つからなかった最後の時点から一定の安定化期間(デフォルトは 90 秒)が経過するのを待ってからスケールインを行い、連続してインスタンスを減らす際にも一定の間隔を空けます。Cloud Run の構成可能な正常シャットダウン機能により、シャットダウン時間が 10 秒から 10 分に延長されます。これにより、SIGTERM に対応したワーカーが処理を完了させるか、チェックポイントを作成するための時間を確保できます。インスタンス数は、設定した最小値から最大値の範囲内に維持されます。アイドル期間後の最初のタスクがインスタンスの起動を待てない場合は、最小値を 1 以上に設定してください。
実行中のワークフローに影響を与えずに新しいコードをデプロイするのは容易ではありません。Temporal ワークフローはステートフルで決定的な挙動をするため、実行途中でコードを差し替えると非決定性エラーが発生します。Cloud Run 上の Serverless Workers は、Temporal ワーカーのバージョニングを必須にすることで、この問題を解決します。条件分岐を使用してコードにパッチを適用する必要はありません。代わりに、各ワーカー デプロイ バージョンは独立したワーカープールとしてデプロイし、deploymentName と buildId で識別します。個別のワーカープールを使用することで、次の 2 つの問題を解決できます。
-
特定のワーカー デプロイ バージョンで開始されたワークフローは、そのバージョンのまま実行を継続し、完了まで処理されます。
-
各ワーカー デプロイ バージョンは個別にスケーリングとドレインが行われるため、コンピューティング費用とリソース利用率をアプリケーションの要件に沿って最適化できます。既存のワークフローが完了して以前のワーカー デプロイ バージョンがドレインされると、基盤となるワーカープールは最終的に自動でゼロにスケールダウンされます。
ワークフロー タイプごとにバージョニング動作を設定するか、ワーカーレベルのデフォルトを設定します。
-
PINNED: ワークフローは、開始されたワーカー バージョン(ビルド ID)に固定され、そこで終了します。短時間実行のワークフロー、注文処理、マルチステップ API に最適です。
-
AUTO_UPGRADE: ワークフローのロールアウトに伴い、新しい「現在の」または「ターゲット」ワーカー デプロイ バージョンへと移行します。サブスクリプション請求や数週間に及ぶタスクなど、長時間実行のワークフローに最適です。
ワーカー バージョニングの構成の詳細については、こちらをご覧ください。
使ってみる
セットアップは次の 3 つのステップで行います。
-
Temporal ワーカーをコンテナ化し、プール名にビルド ID を含めて Cloud Run ワーカープールとしてコンテナをデプロイします。Temporal API キーなどの認証情報は Secret Manager に保管します。
-
ワーカープールをスケールできるように、Temporal Cloud に管理権限を付与して、Temporal をワーカープールに接続します。
-
プールのプロジェクト、リージョン、名前を指定したワーカー デプロイ バージョンを Temporal で作成します。
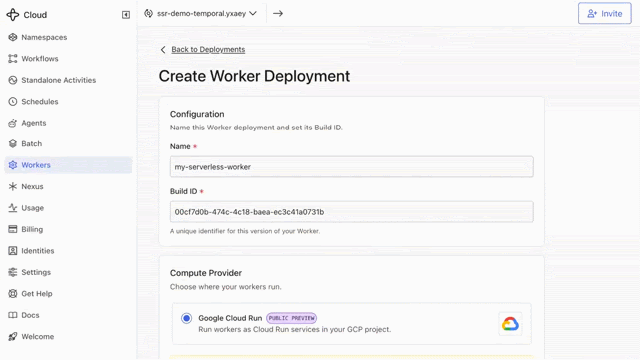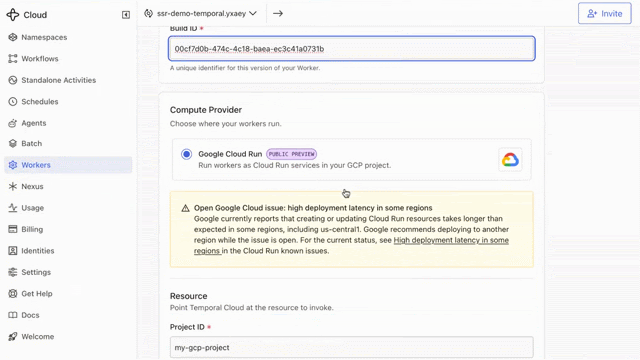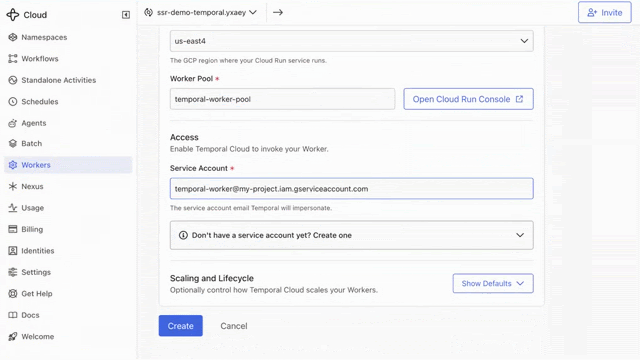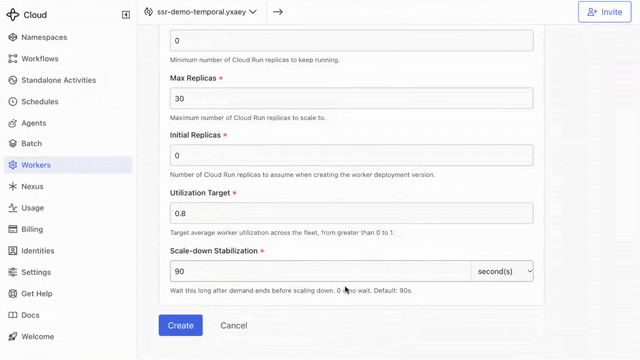
Cloud Run の Temporal Serverless Workers はプレビュー版であるため、安定版リリースまでに API や構成が変更される可能性があります。利用を開始する方法は次のとおりです。
-
Cloud Run 上の Serverless Workers がどのようにスケールし、バージョンを処理するかを理解する。
-
セットアップ ガイドに沿って、最初のワーカーをデプロイする。
-
Cloud Run ワーカープールに関するドキュメントで、CPU、メモリ、GPU、ネットワーキングのオプションを確認する。
-
構成可能な正常なシャットダウンのプレビュー版に申し込む。
- プロダクト マネージャー、Sagar Randive
- エンジニアリング マネージャー、Aniruddh Chaturvedi