Compute Engine コンソールで VM フリートの健全性をモニタリングする
Google Cloud Japan Team
※この投稿は米国時間 2023 年 4 月 7 日に、Google Cloud blog に投稿されたものの抄訳です。
インフラストラクチャ オペレーターの多くが、大規模な VM フリートの管理を強いられています。多くの場合、このタスクには、各種の重要なシグナルの収集、外れ値の識別、ドリルダウンによる根本原因の発見、問題の解決が含まれます。複数のページを切り替えて必要な情報を収集する必要があるため、一般的にこのタスクは、オペレーターにとって時間のかかるプロセスとなります。
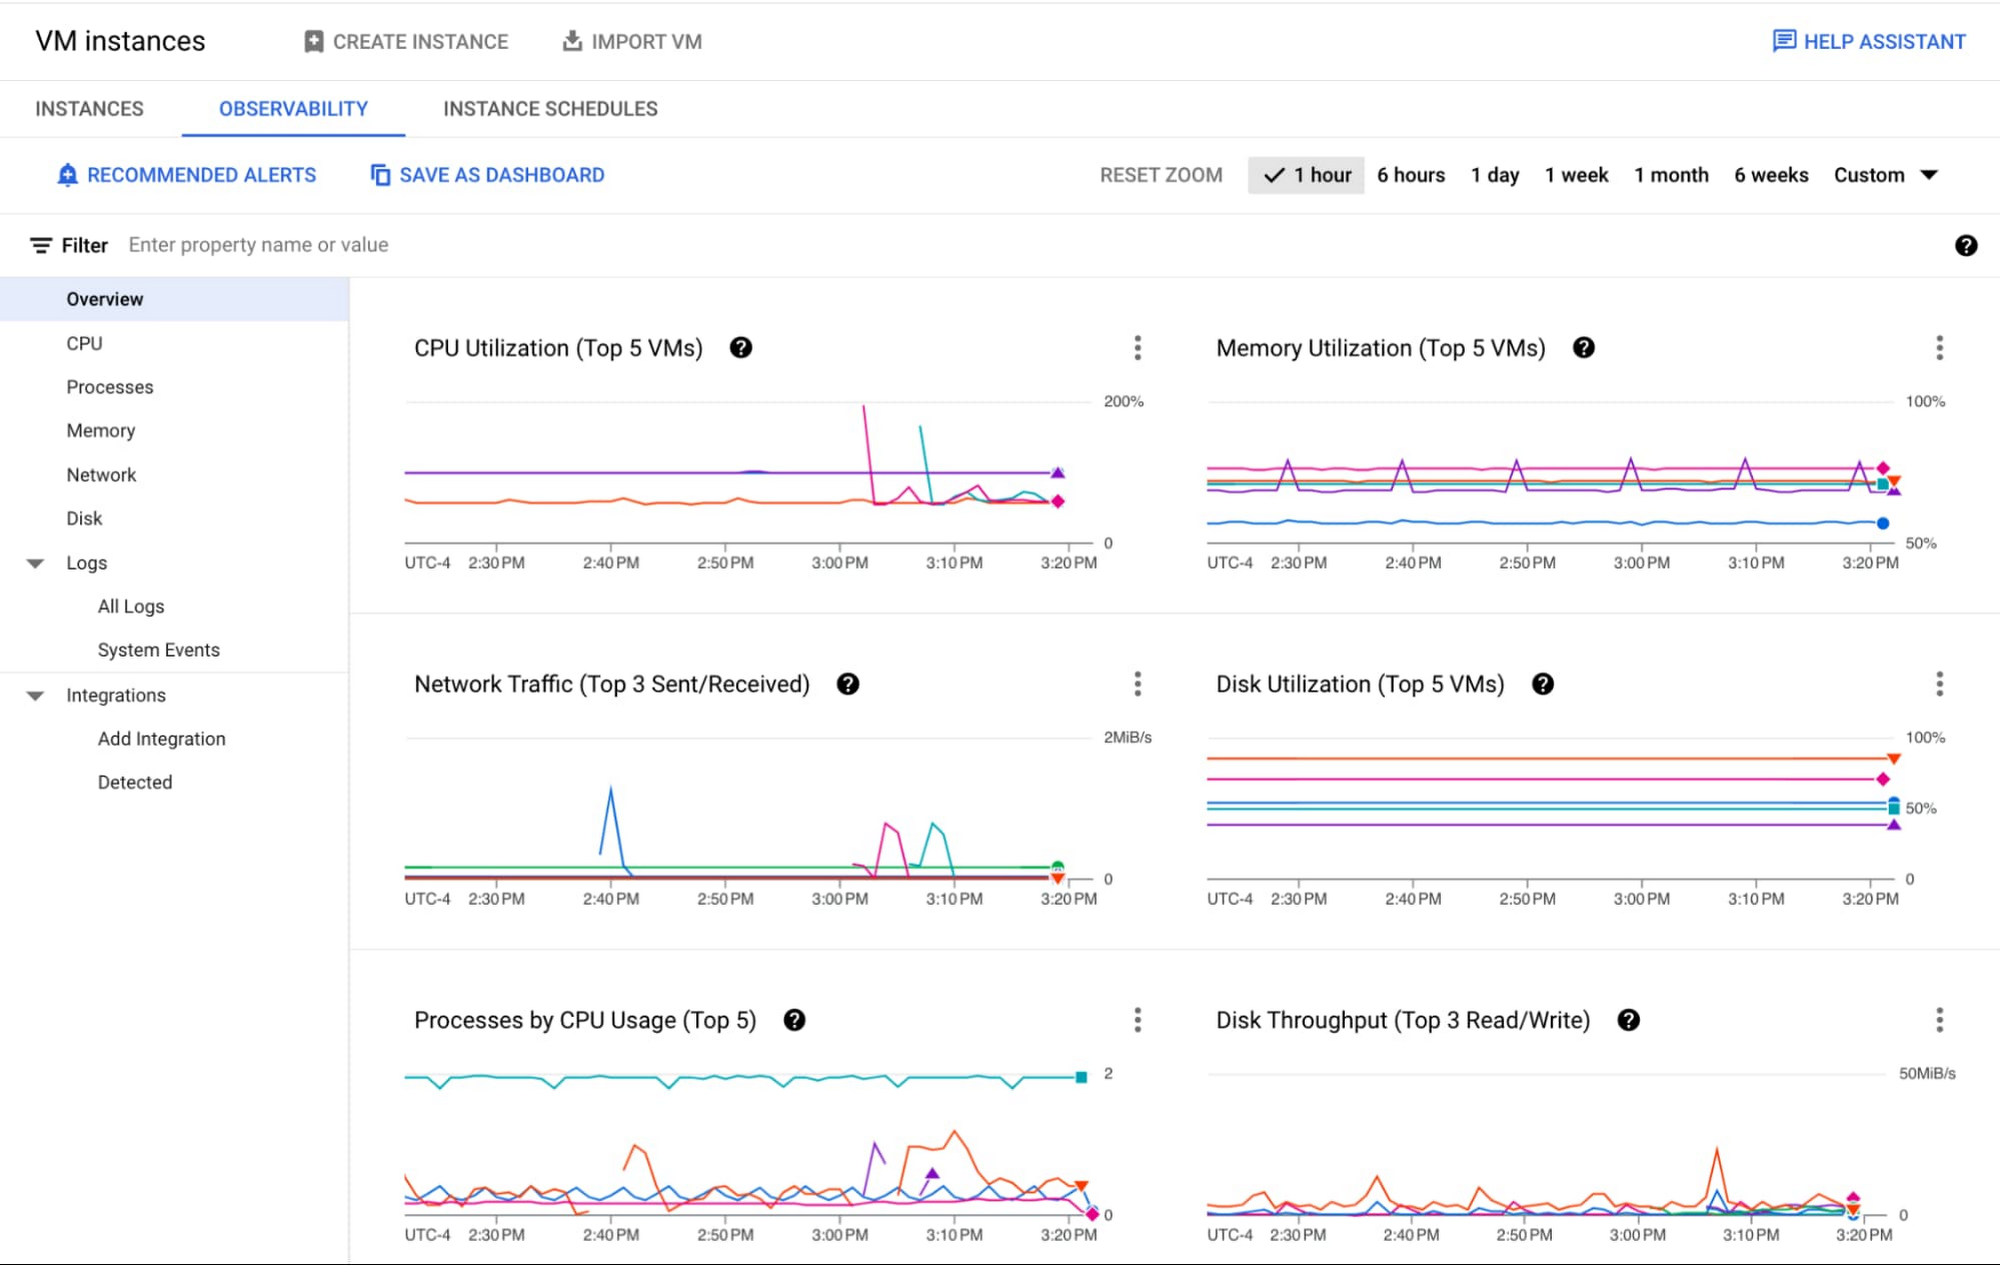
このたび、Compute Engine コンソールの [VM リスト] ページの [オブザーバビリティ] タブが一般提供されるようになったことをお知らせいたします。新しい [オブザーバビリティ] タブを使用すると、VM フリートの健全性を簡単にモニタリング / トラブルシューティングできます。このタブには、主要な健全性指標とすぐに使えるログが表示され、フリートのどこかに異常があればハイライト表示されます。1 つの UI 内で、CPU、メモリ、ネットワーク、ディスク、ライブプロセス、システム イベント、ライブログの分析情報をすばやく取得できます。
フリートレベルのコンテキスト内オブザーバビリティ
この新しいフリートレベル ビューでは、1)CPU やメモリなどの主要な指標に基づいて VM の外れ値を識別し、2)リソース使用量が多いプロセスや宛先別のネットワーク レイテンシに関するフリート全体の傾向を確認して、VM をより全体的に把握できます。
統計情報
[オブザーバビリティ] タブでは、構成を行わなくても主要な健全性指標を可視化できます。すぐに使えるすべての指標とその使用例を次に示します。
CPU
CPU 使用率、vCPU コア使用率: CPU リソースが不足している VM を見つけて、アプリケーションのパフォーマンスに関する問題をトラブルシューティングします。VM パフォーマンスのトラブルシューティングをご覧ください。
CPU 使用量別のプロセス: 問題の根本原因を究明したり最適化の機会を発見したりするために、CPU 使用量が上位のプロセスを特定します。
vCPU あたりのシステム負荷: 数値が 1 に近い場合は、パフォーマンスの問題を防ぐために VM をスケールアップする必要があるかもしれません。
未使用の vCPU コア: CPU リソースの使用量が少ない VM を特定し、コスト削減の機会を見つけます。
プロセス
CPU 使用量、メモリ使用量、ディスク スループット別のライブプロセス: CPU 使用量、メモリ使用量、ディスク スループットが上位のプロセスを特定し、最適化の機会または予想外のリソース消費の原因を見つけます。
VM あたりの CPU 別のライブプロセス、VM あたりのメモリ別のプロセス、VM あたりのディスク スループット別のプロセス: CPU / メモリ / ディスクの消費量が上位のプロセスを実行しているサンプル VM を見つけます。
メモリ
メモリ使用率、使用されているメモリのバイト: メモリが不足している VM を特定し、アプリケーションのパフォーマンスに関する問題をトラブルシューティングします。
未使用のメモリのバイト数: メモリリソースの使用量が少ない VM を特定し、コスト削減の機会を見つけます。
メモリ別のプロセス: メモリ使用量が上位のプロセスを特定します。
状態別のメモリ(複数の VM): フリート全体の空きメモリ、使用されているメモリ、キャッシュに保存されているメモリ、バッファメモリ、スラブメモリの合計サイズを確認します。
ネットワーク
ネットワーク トラフィック: コストを最適化するためにフリート全体の「トップトーカー」を見つけます(ネットワーク コストを参照)。
宛先タイプ別の送信トラフィック(GCP / 外部 / Google)、外部(または異なるプロジェクト)への送信、リージョン間の送信、ゾーン間の送信: ネットワーク コストのトップ コントリビューターを見つけます(ネットワーク コストを参照)。
宛先タイプ別の RTT(GCP / 外部 / Google): 異常なレイテンシ(RTT)を特定し、アプリケーションのパフォーマンスに関する問題をトラブルシューティングします。
拒否されたファイアウォール パケット数(最大分散): 受信トラフィックの異常(拒否されたトラフィックの急増など)を見つけます。
ディスク
ディスク使用率: ディスク空き容量が不足している VM を特定し、アプリケーションのパフォーマンスに関する問題をトラブルシューティングします。
ディスク スループット、ディスク IOPS: スループットと IOPS 全体で外れ値を示している VM を確認し、ディスクのパフォーマンスをモニタリングします。
I/O サイズ、I/O レイテンシ、キューの長さ、CPU I/O 待機率: I/O サイズ、I/O レイテンシ、キューの長さを確認し、ディスク I/O のパフォーマンスに関する問題を詳しく調べます。これらのディメンション全体でパフォーマンスを最大化するためにワークロードを調整する方法については、永続ディスクのパフォーマンスの最適化をご覧ください。
注: CPU やネットワークなどの多くの指標は無償で提供され、Compute Engine インフラストラクチャによって自動的に収集されます。メモリ、ディスク使用率、プロセスなどのその他の指標は Ops エージェントを必要とするため、課金対象となる場合があります(Cloud Monitoring の課金対象外の指標と課金対象の指標を参照)。
ログ
[ログ] セクションには VM フリートのすぐに使えるログが表示され、キーワード、VM ID、重大度レベル、推奨クエリのいずれかでログを簡単にフィルタできます。また、ホストマシンのメンテナンス イベント(ライブ マイグレーションまたはホストエラー)、Spot VM のプリエンプションなど、重要なシステム イベントに関する分析情報を取得できます。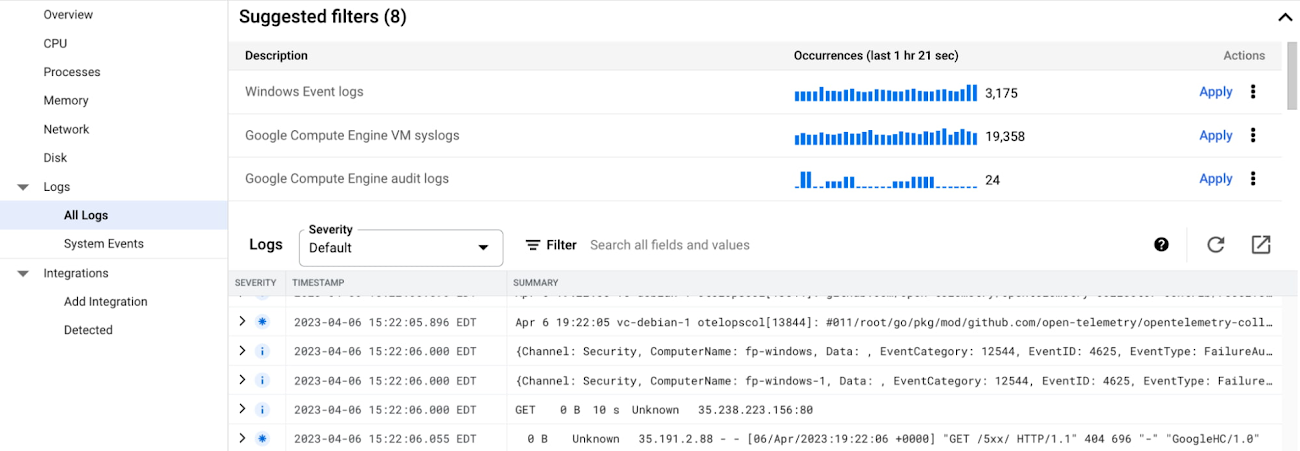
より高度なログ分析が必要な場合は、右上のアイコンをクリックして Cloud Logging に移動します。Cloud Logging は、エクサバイト規模のストレージ、検索機能、分析機能、アラートを備えたフルマネージドのリアルタイム ログ管理サービスです。
特定の VM へのドリルダウン
特定の VM をトラブルシューティングするには、以下のようにグラフをクリックしてポップアップ カードを固定し、調べたい VM をクリックします。
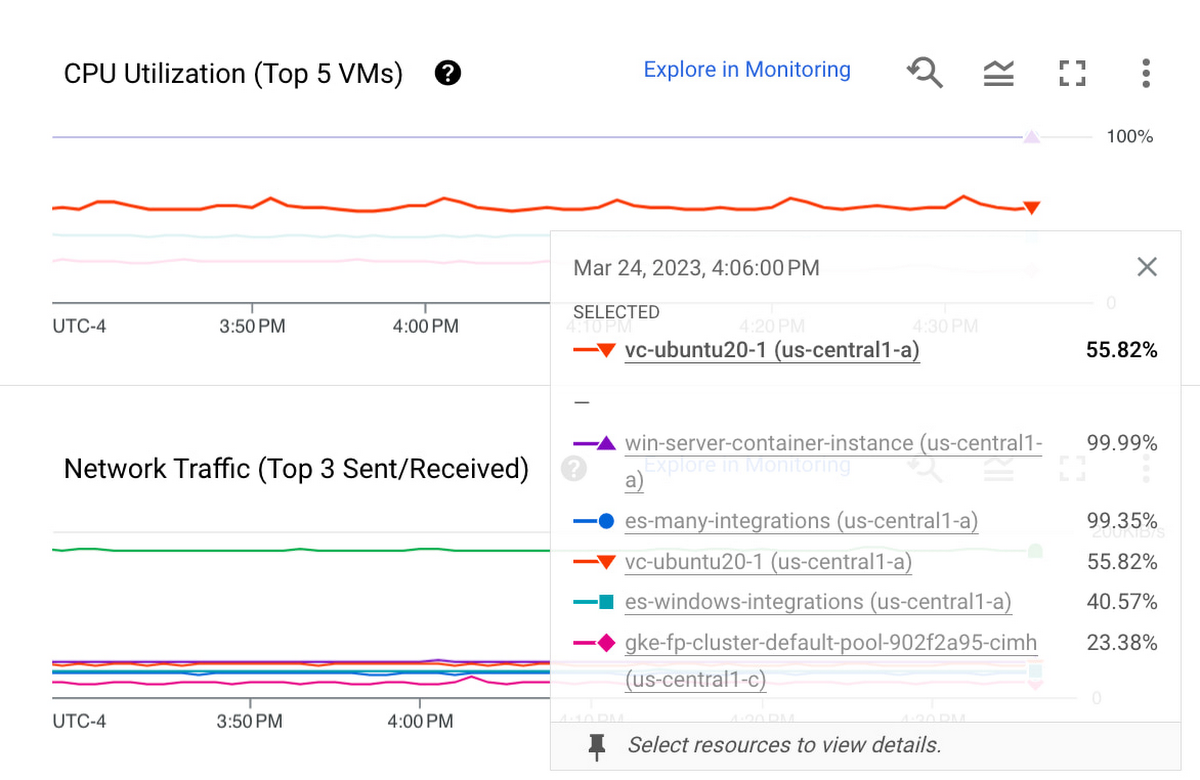
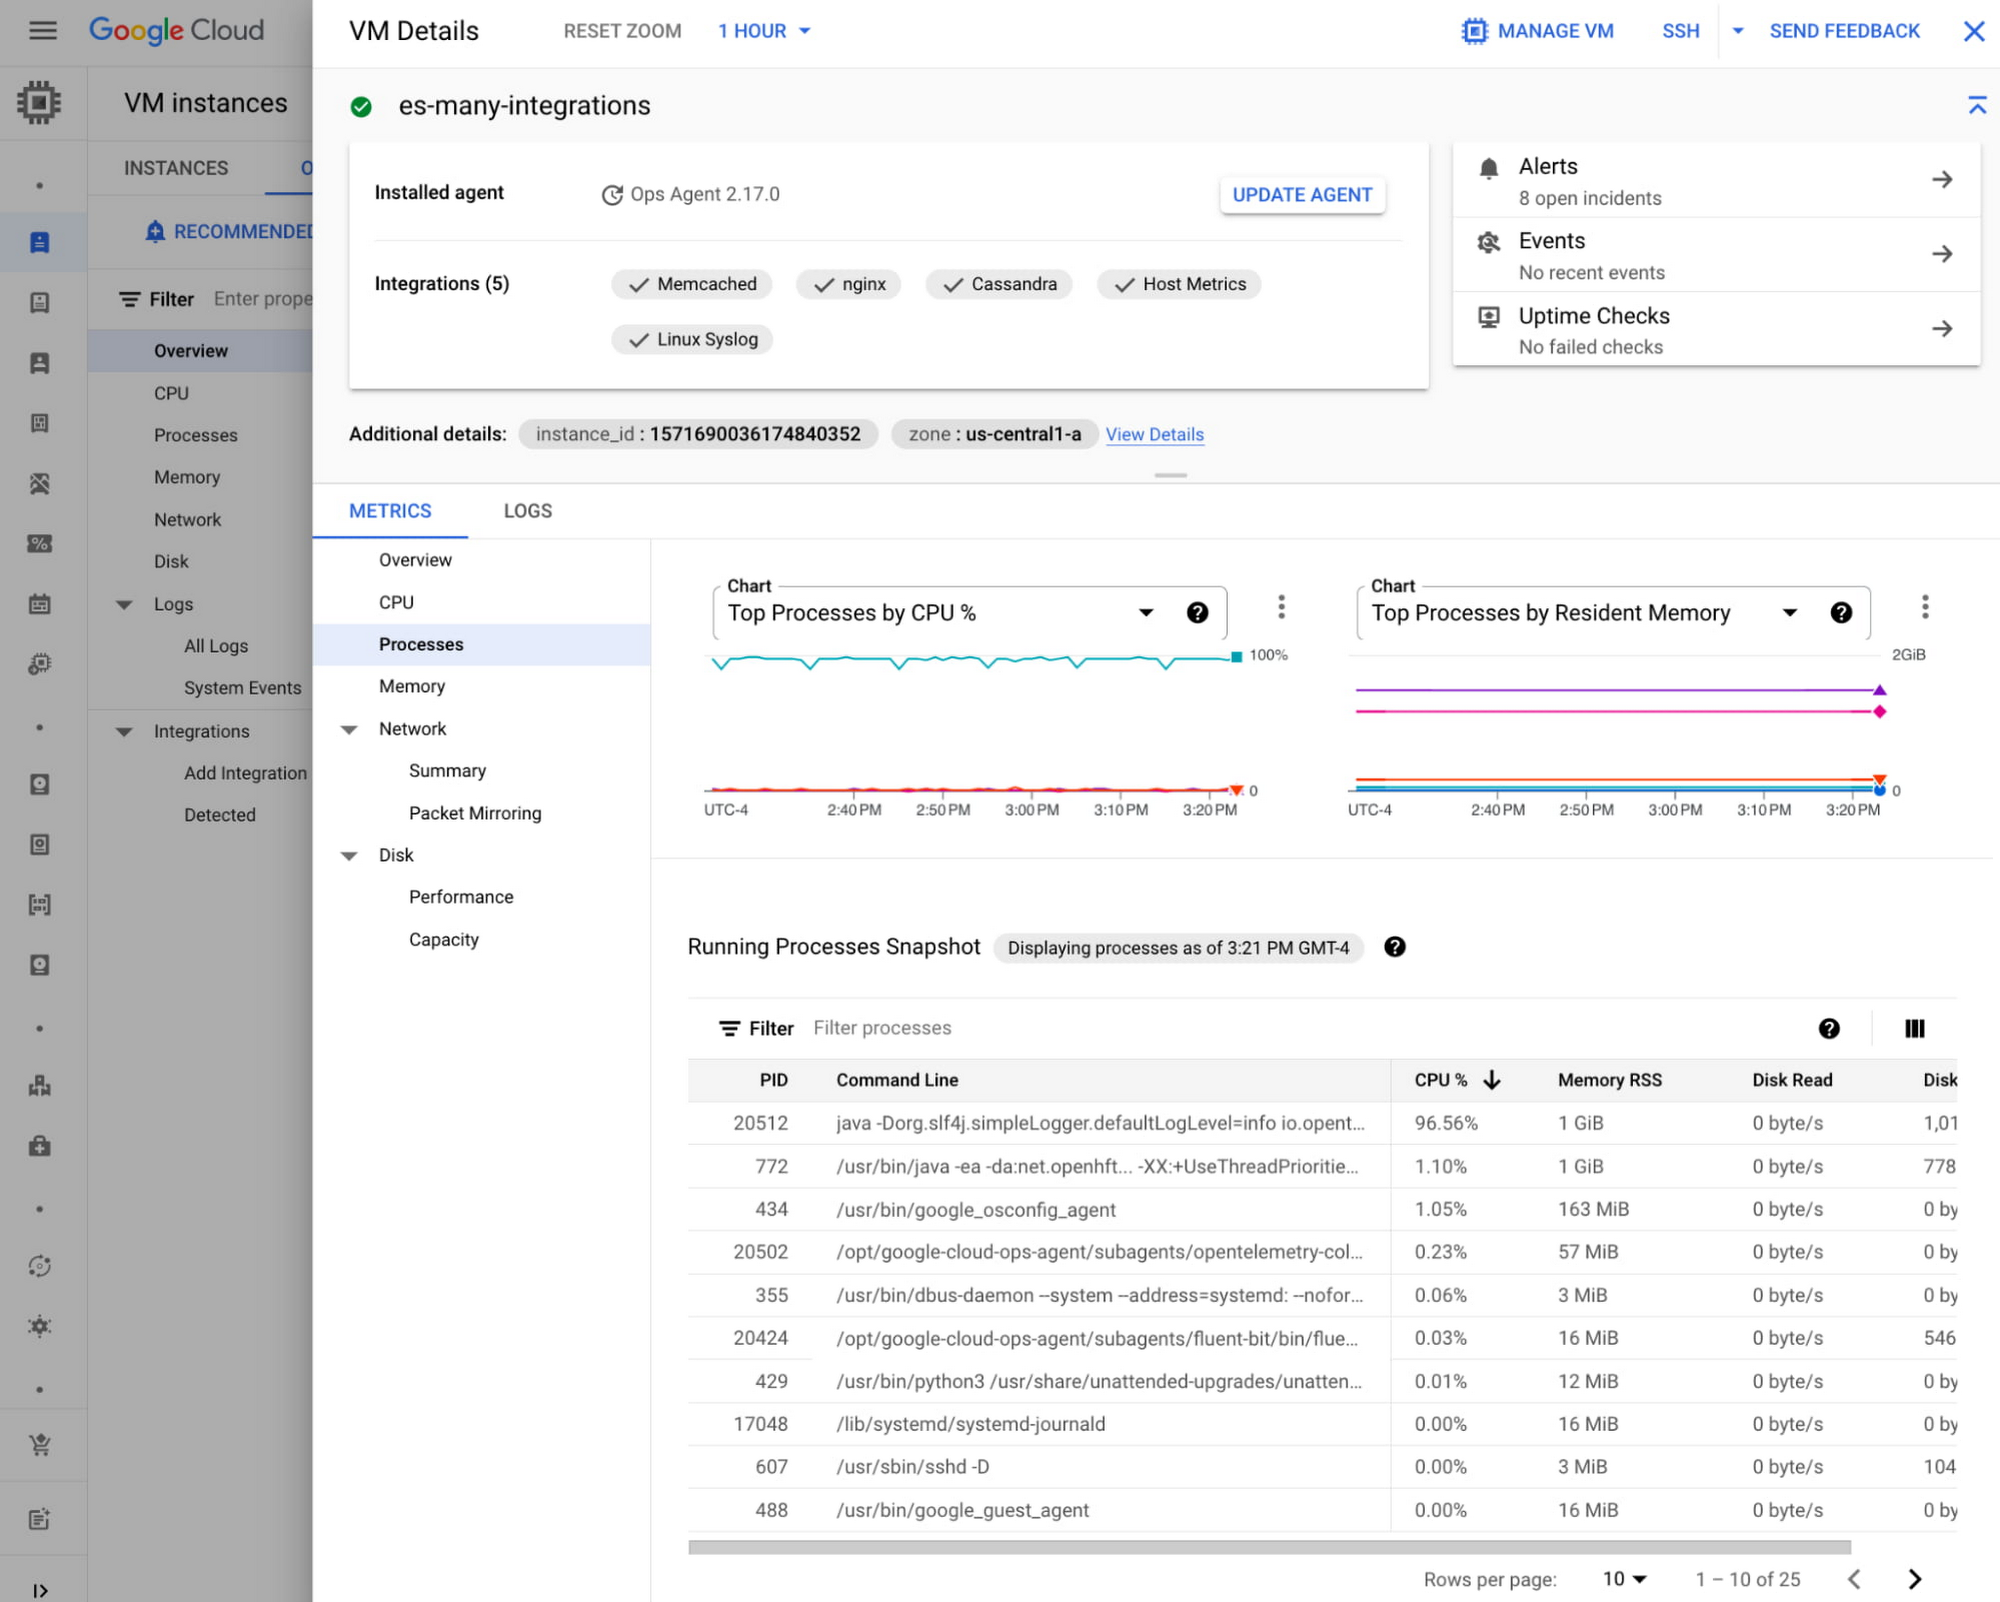
VM をクリックすると、VM の詳細(指標、ログ、プロセス、対応待ちのインシデント、稼働時間チェック、VM への SSH 接続や VM の管理のショートカットなど)が表示されます。
アプリケーションのインテグレーションについて
インフラストラクチャの上部で、[オブザーバビリティ] タブから NGINX や MySQL などのアプリケーションのモニタリングを開始することもできます。[アプリケーションのインテグレーション] セクションには、Ops エージェントを使用してサードパーティ アプリケーションをモニタリングする方法のガイドがあります。インテグレーションごとに、収集された指標、構成ガイド、関連するサンプル ダッシュボードの詳細を確認できます。
推奨アラート ポリシーについて
VM で障害が発生したときに通知を受け取りたい場合があります。[推奨アラート] セクションでは、CPU 使用率やメモリ使用率などの主要な健全性指標について、すぐに使えるアラート ポリシー テンプレートが提供されています。数回クリックするだけで、フリート全体にこれらのポリシーを設定できます。
今すぐ使用を開始する
新しい [オブザーバビリティ] タブを確認するには、[Compute Engine] > [VM インスタンス] に移動して、[オブザーバビリティ] タブをクリックします。また、この新しいタブを最大限に活用するため、Compute Engine VM に Ops エージェントをインストールすることをおすすめします。
皆様からのフィードバックやご提案をお待ちしております。コンソールの右上隅にある [フィードバックを送信] 機能を使用するか、Google Cloud コミュニティ(Cloud Operations ページ)に投稿してご意見をお聞かせください。Google が適切なプロダクトを開発するために、皆様からのフィードバックをお待ちしております。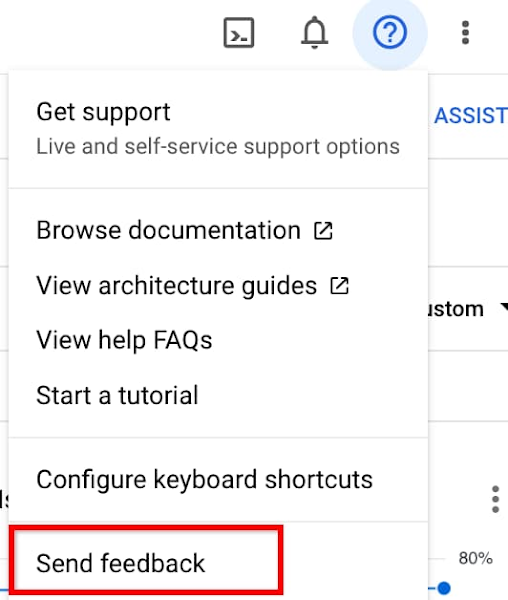
- プロダクト マネージャー Yanqiu(Alice)Wang
- シニア ソフトウェア エンジニア Dave Raffensperger