最小限のダウンタイムで PostgreSQL データベースを Spanner PostgreSQL 言語データベースに移行する
Thiago Tasca Nunes
Software Engineer
Vikram Manghnani
Technical Program Manager
※この投稿は米国時間 2024 年 2 月 24 日に、Google Cloud blog に投稿されたものの抄訳です。
Spanner は、従来のデータベースの制約を解消したいと考える企業にとって魅力的な選択肢となっています。一般提供が開始された Spanner PostgreSQL 言語の人気の高まりとともに、PostgreSQL から Spanner への移行に関心を示す人が増えています。 PostgreSQL データベースから Spanner(PostgreSQL 言語)への移行には、次のような大きなメリットがあります。
-
水平方向のスケーラビリティ
-
強整合性
-
99.999% の可用性
-
PostgreSQL デベロッパーにとって使い慣れた構文とセマンティクス
-
VACUUM 処理、共有バッファのチューニング、接続プーリングの管理といったメンテナンス タスクが不要
Spanner にはこのように明白なメリットがあるものの、本番環境データベースの移行は大変な作業です。組織はダウンタイムや業務の中断を懸念しています。しかし、心配はいりません。綿密に計画を立てること、そして Spanner 移行ツール(SMT)を使用することで、PostgreSQL から Spanner に移行する際のダウンタイムを最小限に抑えることができます。
移行の詳しいプロセスについては、公式ガイドをご覧ください。このブログ投稿では、最小限のダウンタイムでサンプル アプリケーションを移行する手順をご紹介します。
1. 移行元(PostgreSQL)と移行先(Spanner)のリソースを構成する
このガイドに沿って Cloud SQL for PostgreSQL データベース(名前: example)を作成し、このガイドに沿って移行先の Spanner インスタンスを設定します。
2. サンプル アプリケーションを設定する
この移行デモは、Cloud Shell を使用して行います。Cloud Shell を起動して、認証を行います。
サンプルアプリは次の GitHub で入手できます。
このアプリは、singers、albums、songs という 3 つのテーブルのスキーマで動作します。このアプリではデータ挿入を定期的に実行して、本番環境と同様のトラフィックをシミュレートします。
PostgreSQL に接続するようにアプリを構成します。Cloud SQL インスタンスの概要ページで、インスタンスの接続名を確認します。次のように正しい値を変数に代入して、コマンドを実行します。
Docker 化したアプリケーションを起動します。
レコードが Cloud SQL PostgreSQL に挿入されます。確認したら、アプリケーションを停止します。
3. SMT を構成する
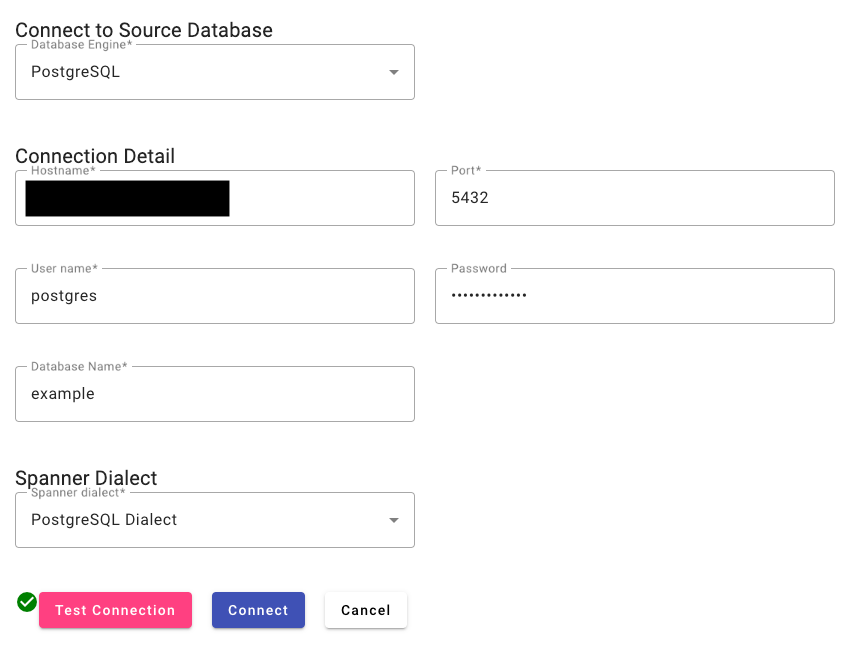
このクイックスタート ガイドに沿って SMT のウェブ UI を起動し、ステップ 1 で作成した project-id と instance-id を入力して Spanner に接続します。
SMT による PostgreSQL データベースへの接続を許可するには、この IP 許可リストガイドを参照してください。
移行元データベースに接続するために、次のように入力します。
-
ホスト名: PostgreSQL インスタンスのパブリック IP またはプライベート IP
-
ポート:
5432 -
PostgreSQL データベース名:
example -
Spanner 言語:
PostgreSQL
4. スキーマを構成して移行する
[Configure Schema] ビューで各テーブルをクリックすると、PostgreSQL のスキーマと Spanner のスキーマを左右に並べて比較できます。
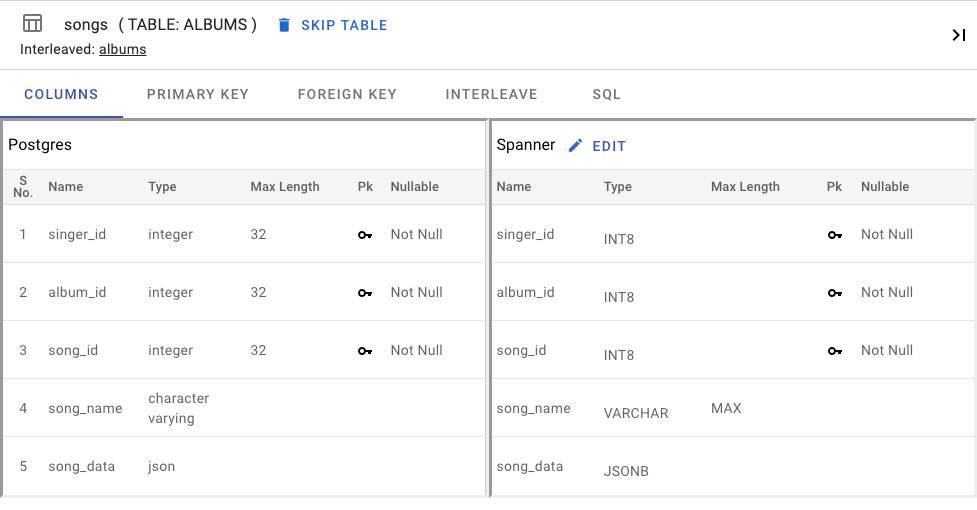
Spanner の albums テーブルと songs テーブルでは、クエリをより適切に最適化するためにインターリーブを利用できます。これは [INTERLEAVE] タブで設定します。
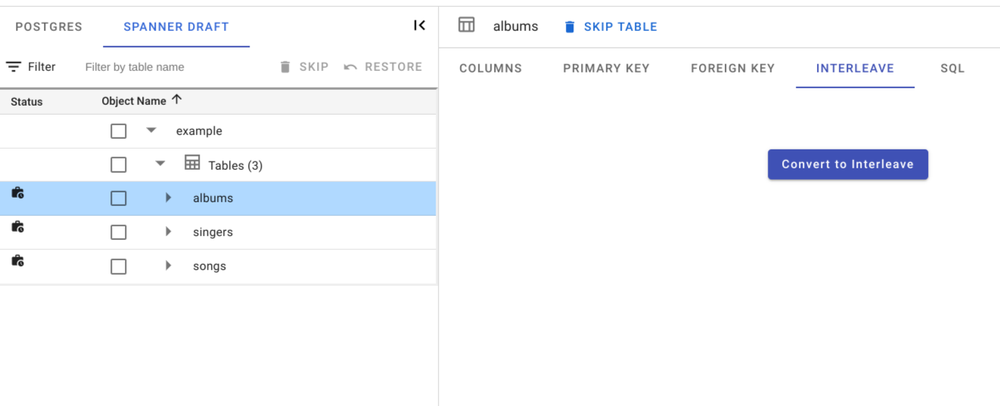
次に、スムーズに移行できるように、SMT に表示されたすべての問題を解消する計画を立てます。
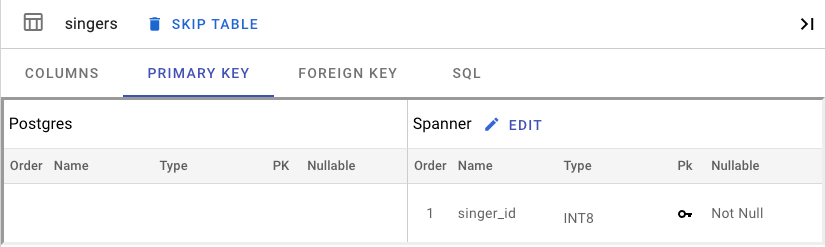
Spanner では、すべてのテーブルに主キーが必要です。singers テーブルには主キーがありませんでしたが、singer_id に対する UNIQUE 制約がありました。この列が主キーになるように SMT によって移行が行われました。
一部の列には、SERIAL データ型があります(ID の場合)。これは Spanner でサポートされていないため、SEQUENCE を使用します。Spanner の SEQUENCE は単調に増加しないため、ホットスポット化を防ぐことができます。これは後ほど手動で作成する必要があります。
Spanner では 8 バイトの整数型のみがサポートされているため、int4/SERIAL 列は int8 に移行されました。これらは、後でアプリケーションのリファクタリングに影響を及ぼします。
特定された冗長インデックスを削除するには、songs テーブルで該当のインデックスを選択して、作成をスキップします。
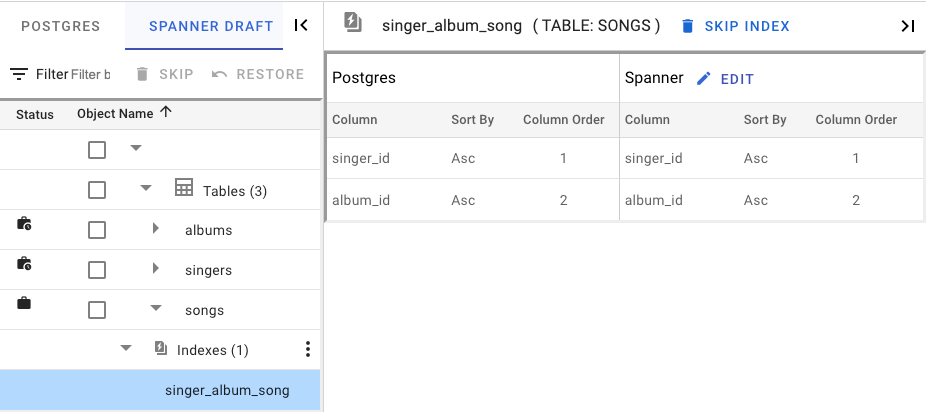
示された問題をすべて解消する計画を立てたので、[Save Session] をクリックして作業内容を保存します。[Prepare Migration] をクリックして続行します。
最初はスキーマのみを移行して、Spanner に対してアプリケーションを検証します。次のように入力します。
-
移行モード:
Schema -
Spanner データベース:
example
[Migrate] をクリックします。完了すると、作成されたデータベースへのリンクが表示されます。
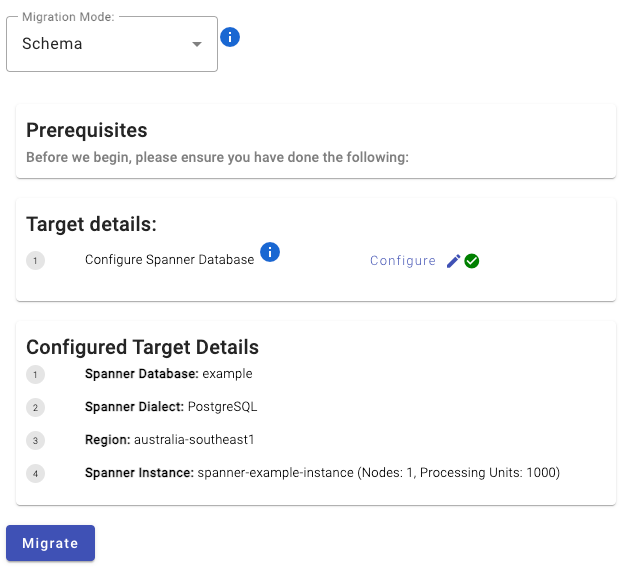
最後に、SMT によって自動化されなかったスキーマの更新を適用します。移行したデータベースに対して、このファイルのステートメントを実行します。これは Spanner Studio で実行できます。
5. アプリケーションを更新する
アプリケーションを Spanner で動作させるために、次のような軽微な更新をいくつか行う必要がありました。
-
PostgreSQL ワイヤ プロトコルを対応する Spanner ワイヤ プロトコルに変換するように PGAdapter を構成する。
-
Spanner では json 型の代わりに jsonb 型がサポートされているため、クエリを更新する。
これらの更新の詳細については、こちらをご覧ください。
Spanner に対してアプリケーションをテストするために、まずアプリケーションを構成します。
アプリケーションを起動します。
アプリケーションによっていくつかの行が挿入されたことを確認したら、アプリケーションを停止してサンプルデータを削除します。
6. ダウンタイムを最小限に抑えた移行
SMT では、「ダウンタイムを最小限に抑えた移行」のプロセスを次のようにオーケストレートします。
- 移行元データベースから移行先データベースに初期データを読み込む。
- 変更データ キャプチャ(CDC)イベントのストリームを適用する。
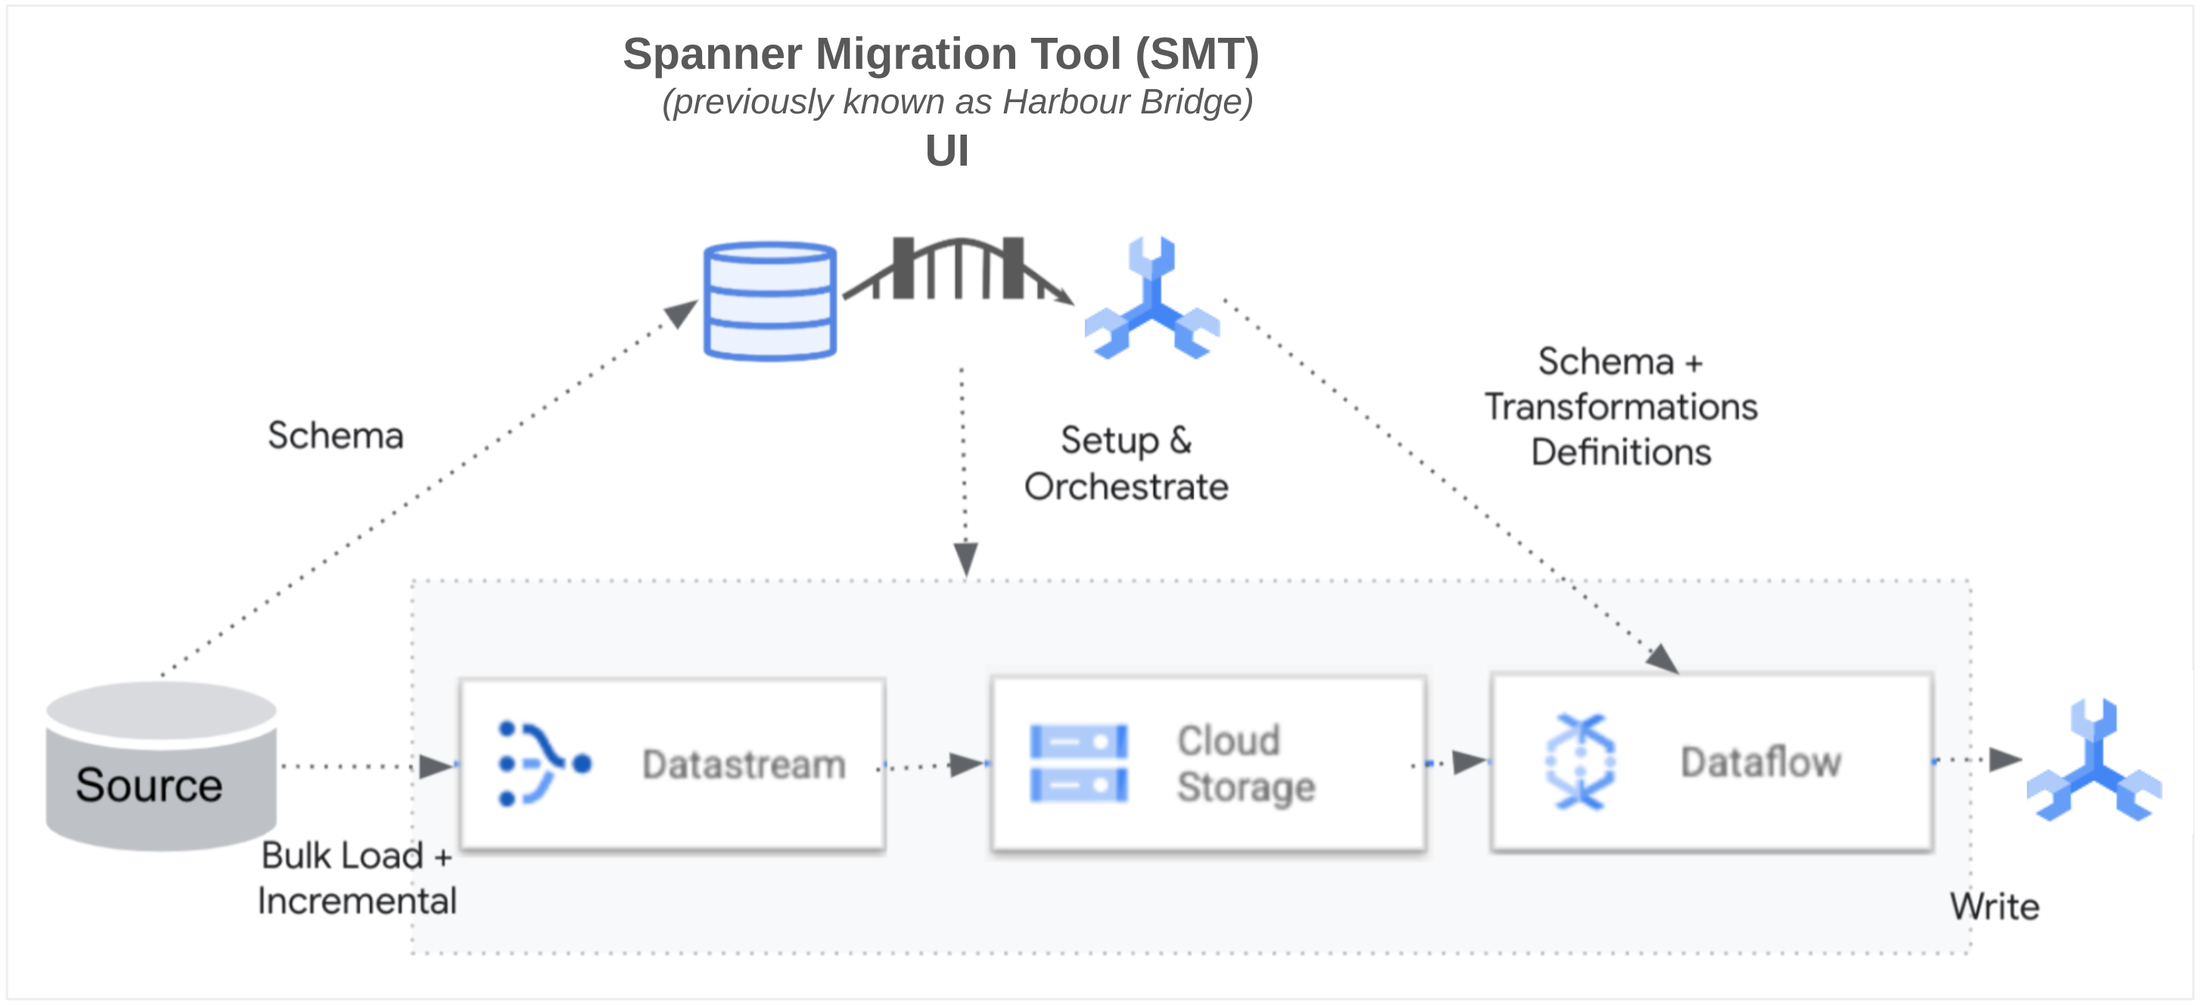
SMT によって以下が設定されます。
-
初期データの読み込み中に CDC イベントを保存する Cloud Storage バケット
-
CDC データを一括読み込みして増分データを Storage バケットにストリーミングする Datastream ジョブ
-
CDC イベントを Spanner に移行する Dataflow ジョブ
このパイプラインのデプロイを SMT に許可する際には、必要な権限がすべてあることを確認してください。
次に、このガイドに沿って移行元 PostgreSQL の CDC を設定します。その後、ライブ トラフィックをシミュレートするために、PostgreSQL を指すアプリケーションを再起動します。
SMT に戻って保存したセッションを再開し、[Prepare Migration] をクリックして移行の準備を続けます。次のように入力します。
-
移行モード:
Data -
移行タイプ:
Minimal downtime Migration
移行元 PostgreSQL データベース(example)の詳細と、移行先 Spanner データベース(example)を入力します。
(PostgreSQL CDC 構成から)移行元データベースの接続プロファイルを入力し、IP 許可リストの手順に沿って操作します。
最後に、ターゲット接続プロファイルを設定して、[Migrate] をクリックして移行を開始します。
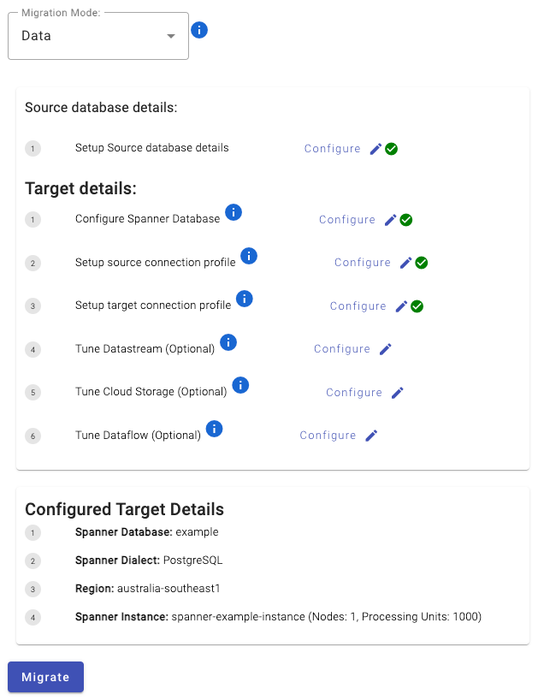
SMT によって移行のモニタリングに役立つリンクが生成されます。
7. Spanner を使用する
PostgreSQL を使用しているアプリケーションを停止します。
Spanner の処理が追いつくまで待機します。Dataflow のバックログがゼロになったら、Spanner アプリケーションに切り替えます。
これで、SMT を使用したアプリ移行のデモは完了です。
[End Migration] をクリックしてジョブをクリーンアップできます。
まとめ
綿密な計画を立てること、そして SMT を活用することで、Spanner への移行時のダウンタイムを最小限に抑えることができ、効率的に移行できます。
-ソフトウェア エンジニア Thiago Tasca Nunes
-テクニカル プログラム マネージャー Vikram Manghnani