JFrog 社が Google Cloud BigQuery で大規模な DevOps を成功させた方法
Google Cloud Japan Team
※この投稿は米国時間 2021 年 11 月 13 日に、Google Cloud blog に投稿されたものの抄訳です。
編集者注: 今回は、JFrog 社のソフトウェア エンジニアである Mitali Bisht 氏に、BigQuery とデータポータルが JFrog DevOps Platform での運用分析をどのように強化させているかについてお話を伺います。
DevOps をスムーズに進めるには、それにまつわる運用についてできるだけ多くのことを知る必要があることを JFrog は認識しています。これは、JFrog DevOps Platform を支える弊社の アーティファクト リポジトリ マネージャ、Artifactory の基本原則です。情報とは Artifactory の場合はアーティファクトとビルド メタデータを指しますが、これらの情報は私たちが日々構築している複雑なシステム全体を追跡可能にするパスを提供します。データとそれを分析する能力によって、人や機械は賢明な意思決定ができるようになります。
そのため、Google Cloud Platform(GCP)で SaaS サブスクリプションを実行している JFrog Cloud のお客様により良いサービスを提供するには、数百件ものデプロイメントの運用データを収集して分析する必要がありました。
統計情報を収集して、ユーザーが次のような判断を行う際に役立つメタデータを提供したいと考えました。
JFrog アカウントを積極的に使用しているユーザーは誰か(IP アドレス別)?
サイバー攻撃の試みを示唆するアクティビティはあるか?
ユーザーが最もよく使用しているモジュールまたはパッケージはどれか?
それらのリソースはどのくらい効率的に使用されているか?
単一ユーザーの規模では、JFrog Platform Log Analytics の統合を通じてセルフホスト型のお客様にいくつかの機能を提供しています。それにより、お客様は Splunk や DataDog などの分析プログラムで、高可用性デプロイのアクティビティを独自に構成して確認できます。
ただし、GCP での SaaS 運用をモニタリングするには、それをはるかに上回る規模で複数のデプロイからこの種のデータを抽出し、分析できるソリューションを作成する必要がありました。
利用可能な数多くの GCP サービスの中でも、特に Cloud Logging、BigQuery、データポータルを活用することで、膨大な量の運用データをリアルタイムで収集、分析、可視化することができました。
JFrog がこのプロジェクトに使用したアーキテクチャについて、詳しく見ていきましょう。
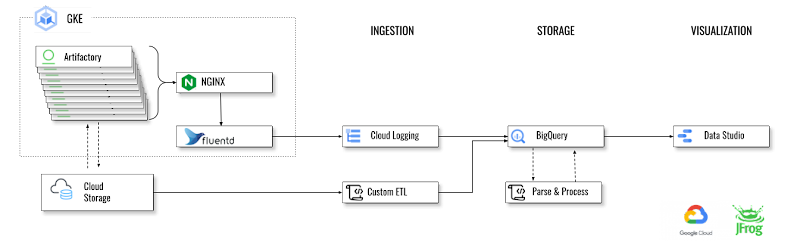
ステージ 1: ログからのデータの取り込み
データは次の 2 つのログソースから取り込みました。
Artifactory SaaS インスタンスにサービスを提供する nginx サーバー
外部のクラウド ストレージからストリーミングされるログ
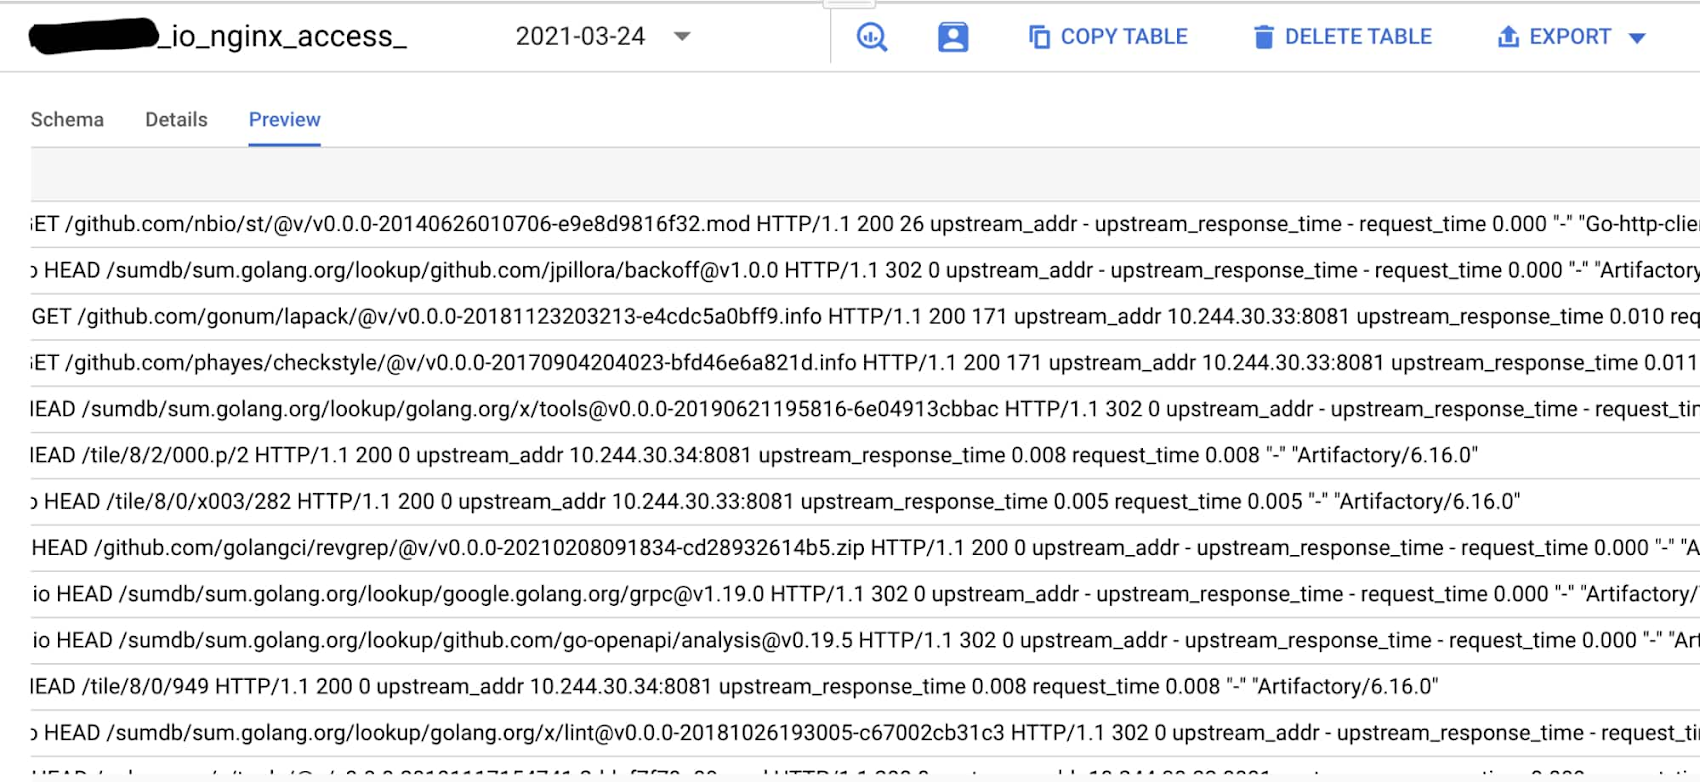
NGINX アクセスログ
まず最初に、GKE で Kubernetes クラスタをセットアップ中に、 google-fluentd Logging エージェント Pod の設定をデフォルトで完了しました。Logging エージェント google-fluentd は、fluentd ログデータ コレクタに変更を加えたものです。デフォルトの構成では、この Logging エージェントがデフォルトのログリストにあるログを Cloud Logging にストリーミングします。nginx-access の設定はこのデフォルトで十分でした。追加のログをストリーミングするために、エージェント構成をカスタマイズする必要もありませんでした。
Cloud Logging では、監査ログ、プラットフォーム ログ、ユーザーログを含むすべてのログが Cloud Logging API に送信され、ログルーターを通過します。ログルーターは、各ログエントリを既存のルールと照合して、どのログエントリを破棄するか、どのログエントリを Cloud Logging で取り込む(保存する)か、ログシンクを使用してサポートされている宛先にどのログエントリをルーティングするかを判断します。ここでは、ログを BigQuery のパーティション分割テーブルにエクスポートするためのログシンクを作成しました。オブジェクト「Sink」は、包含 / 除外フィルタと宛先を保持します。GCP プロジェクトの [ログ] -> [ログルーター] セクションでシンクを作成および表示できます。たとえば、包含フィルタは次のようになります。
外部のクラウド ストレージ ログ
社外のクラウド ストレージでは、複数のプロジェクトのログが同じバケットに蓄積されます。自社のプロジェクトに関連するログのみを選別するために、Python のカスタム スクリプトを作成して、次のタスクを毎日実行するようにスケジュール設定しました。
プロジェクトに関連するデータを認証、読み取り、選択する。
データを処理します。
BigQuery のストリーム取り込み API を使用して、ログデータを BigQuery に直接ストリーミングしました。 BigQuery Data Transfer Service(DTS)も活用しました。DTS は、Google 広告などの Google SaaS アプリや、Amazon S3 などの外部クラウド ストレージ プロバイダからデータを取り込み、Teradata や Amazon Redshift などのデータ ウェアハウス テクノロジーからデータを転送するフルマネージド サービスです。DTS では、あらかじめ設定されたスケジュールに基づいて BigQuery に自動的にデータを転送できます。
ステージ 2: BigQuery のストレージ
BigQuery は、データセットと呼ばれる単位でデータテーブルを整理します。これらのデータセットは GCP プロジェクトを範囲とします。プロジェクト、データセット、テーブルという複数の範囲を対象とすると、情報を論理的に構造化するのに役立ちます。コマンドライン、SQL クエリ、またはコードでテーブルを参照するために、「project.dataset.table」という構文を使用しました。
BigQuery は、カラム型ストレージ形式と圧縮アルゴリズムを利用して、大規模な構造化データの読み込み用に最適化された Colossus にデータを格納します。Colossus はレプリケーションや(ディスク クラッシュ時の)復元のほか、分散型管理も行います(そのため単一障害点がありません)。Colossus を使用すると、BigQuery ユーザーは保存データを数十ペタバイトまでシームレスにスケールできます。従来のデータ ウェアハウスのように高額なコンピューティング リソースに接続するといったコストをかける必要もありません。
費用とパフォーマンスの両方を最適化したい場合、BigQuery でのデータ保持がベスト プラクティスとなります。また、別のベスト プラクティスには、BigQuery のテーブル パーティショニングとテーブル クラスタリングの機能を使用して、一般的なデータアクセス パターンに合わせてデータを構造化することが挙げられます。
BigQuery でテーブルがクラスタ化されると、テーブルのスキーマ内の 1 つ以上の列のコンテンツに基づいて、テーブルデータが自動的に編成されます。指定した列は、関連するデータを並置するために使用されます。新しいデータがテーブルまたは特定のパーティションに追加されると、BigQuery はバック グラウンドで自動再クラスタリングを行い、テーブルまたはパーティションのソート プロパティを復元します。ユーザーは、自動再クラスタリングを完全に無料で自由に使用できます。
パーティション分割テーブルは、パーティションと呼ばれるセグメントに分割された特殊なテーブルです。このテーブルを使用すると、データの管理や照会が簡単になります。通常、データの取り込み時間、TIMESTAMP/DATE 列、INTEGER 列を使用して、大きなテーブルを多数の小さなパーティションに分割できます。BigQuery は、パーティション分割テーブルの作成に次の方法をサポートしています。
取り込み時間パーティション分割テーブル
DATE/TIMESTAMP 列のパーティション分割テーブル
INTEGER 範囲パーティション分割テーブル
JFrog ではデータストレージとして、次の取り込み時間でパーティション分割された BigQuery テーブルを使用しました。
データの取り込み時間や受信時間に基づいてパーティション分割される。
BigQuery は、データの取り込み時間または受信時間を反映した、日付に基づく日単位のパーティションにデータを自動的に読み込む。
パーティション管理は、特定の範囲でクエリを実行する場合、BigQuery のパフォーマンスと費用を完全に最適化するための重要な要因といえます。クエリごとにスキャンするデータ量を減らせるだけでなく、クエリの開始前にプルーニングを決定できます。パーティショニングにより、費用の削減やパフォーマンスの向上を実現すると同時に、ユーザーが極めて大規模なテーブル全体に対して誤ってクエリを実行した場合の費用の急増も防ぐことができます。
ステージ 3: データの解析と処理
BigQuery に保存した生のログデータは、分析する前に簡単にクエリできるように処理する必要があります。
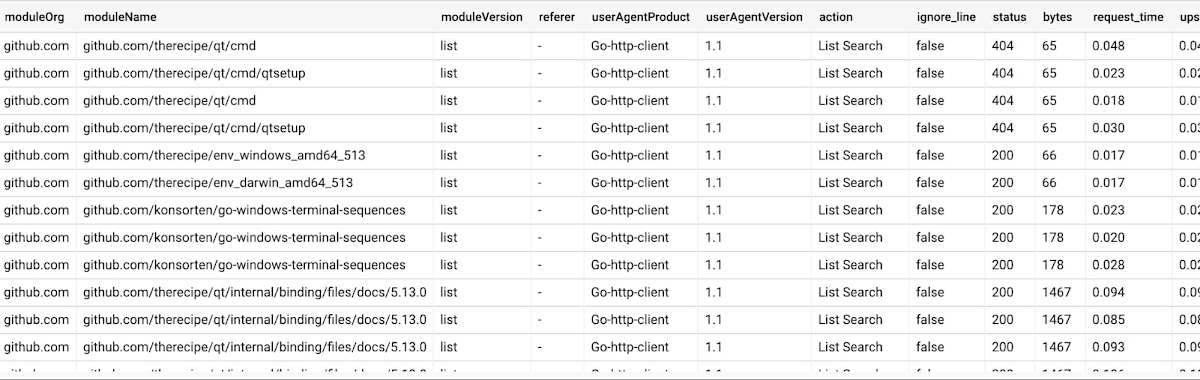
データを解析する
生のログデータの処理には、Python スクリプトを使用しました。このスクリプトでは、BigQuery パーティション分割テーブルに保存した生のログを読み取り、解析してデータを分解します。さらに、そうして絞り込んだ結果を、より細かく列定義した新しい BigQuery パーティショ分割ンテーブルストアに保存します。
また、MaxMind の IP 位置情報サービスと統合し、IP 逆引き参照を実行して、組織ごとの使用状況をより適切に可視化しました。BigQuery への API 呼び出しには、ほとんどの一般的な言語で利用できるクライアント ライブラリがあります。
この Python スクリプトは毎日実行され、取り込んだデータを処理して BigQuery に返しています。
データを分析する
BigQuery は、非常に大きなデータセットで複数の複雑な同時クエリを非常に効率的に実行します。BigQuery のコンピューティング エンジンは、SQL クエリを実行する大規模なマルチテナント クラスタ、Dremel です。Dremel は、必要に応じてスロットをクエリに動的に割り当て、複数のユーザーからの同時実行クエリに対する公平性を保ちます。1 人のユーザーが数千のスロットを取得してクエリを実行できます。ストレージとコンピューティングの間では「シャッフル」が行われます。これは、Google の Jupiter ネットワークを活かして、極めて高速にデータを移動するものです。
BigQuery でクエリを実行する際、その結果セットを実体化して、一時テーブルに保存するのではなく、新しいテーブルを作成できます。そのため、ワンクリックで複数のテーブルのデータを結合して新しいテーブルに保存でき、一部のデータセット テーブルへのアクセス権しか持たないユーザーに対しても、GCS へのエクスポート、Google スプレッドシートやデータポータルでの検索を使ってデータを渡すことができます。
ステージ 4: 可視化
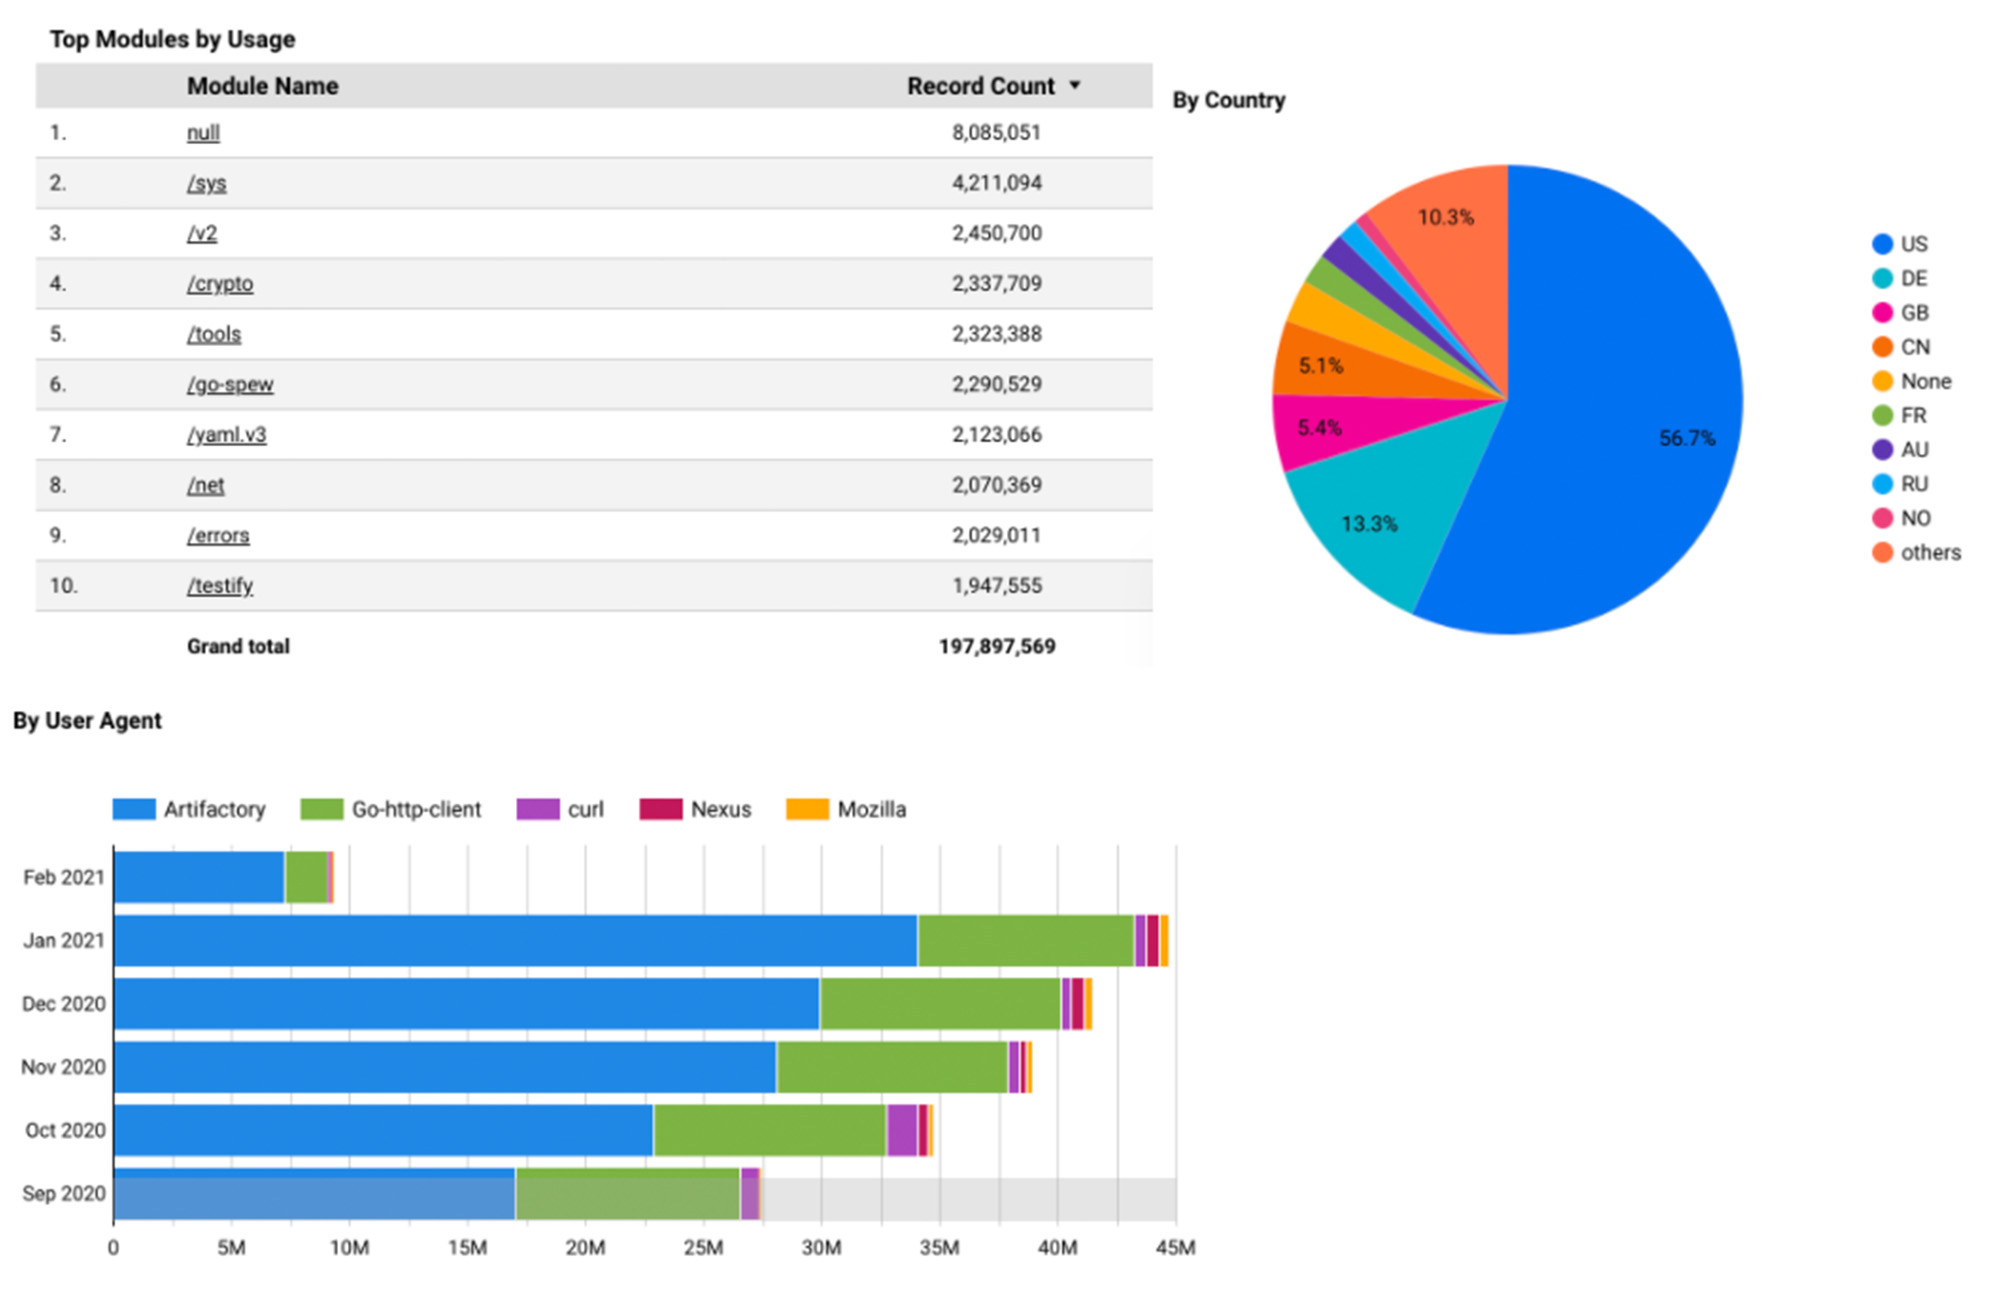
こうして処理されたデータの可視化には、GCP データポータルを使用しました。データポータルは、ペタバイト規模の処理能力と、Google Cloud Platform のその他のサービスとのエンドツーエンドの統合を備えた無料のサービスです。
データポータルは、BigQuery を含む 14 の Google エコシステム コネクタをサポートしています。Google データポータル独自の有益な機能の 1 つに、他の Google Workspace アプリとのコラボレーションの促進が挙げられます。これこそ、JFrog の BI ツールに最適な選択肢だと考えました。
私たちは可視化するプロジェクト、データセット、テーブルを選択して、データソースを作成しました。[データポータルで調べる] をクリックすると、グラフ、フィルタ、指標を追加するオプションを備えた新しいレポートページが作成されます。
大規模 DevOps 向けのビッグデータ
膨大な量のログデータを収集、処理、可視化する機能を活用することで、JFrog の運用チームは SaaS のお客様の進化するニーズをより詳しく理解し、Google Cloud Platform でのスムーズな業務の遂行を続けることが可能になりました。
クラウドでの DevOps では、毎日数百テラバイトのアーティファクト データが企業のアーティファクト リポジトリを通過していますが、私たちは今回の経験を通して、JFrog の企業顧客がこうしたデータにどれほど依存しているかをこれまで以上に強く認識するようになりました。このビッグデータを処理する BigQuery のおかげで、私たちとお客様のビジネスは最大効率で稼働し続けることができています。
クラウド DevOps を通じてエンタープライズ規模のサービスのリリースと提供を加速させる方法については、Enterprise + Cloud サブスクリプションから Google Cloud Marketplace の JFrog Platform をご覧ください。
- JFrog 社ソフトウェア エンジニア Mitali Bisht 氏