AlloyDB と Memorystore for Valkey で AI エージェントの長期記憶を実装する方法
Itai Rosenblatt
Senior Engineering Manager, AlloyDB AI, Google
Paul Ramsey
Product Manager, Google
※この投稿は米国時間 2026 年 10 月 2 日に、Google Cloud blog に投稿されたものの抄訳です。
エンタープライズ AI エージェントが、複数日にわたる複雑なワークフローや長期にわたるタスクを実行するには、永続メモリが必要です。このブログ投稿では、短期バッファメモリに Memorystore for Valkey を、長期永続メモリに AlloyDB AI を使用する 2 層メモリ アーキテクチャによって、重要なデータとエンタープライズ ガードレールを維持しながら、トークン消費量を最大 70% 削減する仕組みを見ていきます。
たとえば、ユーザーの休暇の予約を支援する、パーソナライズされた旅行エージェントを構築するとします。ユーザーは数日間にわたってエージェントと何度もやり取りし、旅行プランのアイデア出しから具体的な購入・予約の検討に至るまで、さまざまな質問をします。真にシームレスなエクスペリエンスを提供するには、このエージェントは、以前のセッションで設定されたフライトの好み(例: 「直行便のみ」)、ホテルの予算、食事の要望(例: 「グルテンフリーのメニューが必要」)を記憶しておく必要があります。さらに重要なのは、会話が観光のおすすめや旅行プランの計画といった細かい内容に深入りしても、これらの重要情報を保持する必要がある点です。エージェントは、追加の質問や訪問先に関する魅力的な詳細情報によって、ユーザーの基本的な要件や決定事項を忘れたり上書きしたりすることがないようにしなければなりません。
ステートフルなワークフローは、LLM のステートレスな性質と本質的に矛盾する
AI エージェントは、マルチターンの会話や長期にわたるワークフローに活用されていますが、大規模言語モデル(LLM)はセッション間でステートレスのままとなっています。ユーザーが数日後にエージェントを再び利用する際、モデルはコンテキスト ウィンドウが空の状態で処理を開始します。アプリケーションがエージェントの長期メモリを使用して過去のコンテキストを再構築するように設計されていない限り、ユーザーは目標とコンテキストを最初から説明し直す必要があるため、ストレスのたまる断片的なユーザー体験になってしまいます。
100 万トークンのコンテキスト ウィンドウが標準となった現在、この問題に対する手っ取り早い解決策としてよく使われるのは「コンテキスト スタッフィング」です。これは、未加工のチャット履歴からツールの実行ログまで、プロンプトに収まるあらゆるものを会話のターンごとに詰め込むというものです。実際、これは AI モデルが使用され始めた初期によく見られたパターンです。しかし、この手っ取り早い解決策では、規模が大きくなるとすぐに問題が発生します。メッセージごとのトークン消費量が倍増し、単純なプロンプトでも応答時間が 30 秒を超えるようになり、モデルでは「lost in the middle(情報の埋もれ)」と呼ばれる精度低下が生じ、大量のプロンプト テキストに埋もれた重要な指示を見落とすようになります。
もう一つの一般的な回避策は、ローリング サマリーを使用することです。これは LLM に古いメッセージを定期的に要約して、短い文章に圧縮するよう指示する手法です。これによりプロンプトのサイズは削減されますが、LLM ベースの要約は本質的に情報の欠落を伴います。数回の圧縮を繰り返すうちに、些細ながらも重要な詳細がバックグラウンド ノイズとして除去されてしまうからです。数ターンも経つと、エージェントはユーザーが最初に設定した制約を、いつの間にか無視するようになります。以前の会話やマルチターン タスクの記憶を保持するには、ユーザー体験の低下や、新たなボトルネックの発生を回避したうえでの、よりスケーラブルなアプローチが必要であることは明らかです。
2 層メモリ アーキテクチャの実装
ガードレールと制約を遵守し、信頼性と費用対効果に優れたエンタープライズ エージェントを構築するには、2 層メモリ アーキテクチャの採用をおすすめします。
-
短期セッション バッファ: トークン数で制限されたスライディング ウィンドウを使用して、アクティブな会話ターンをメモリにキャッシュします。これにより、デバイスをまたいだ複数回のやり取りでもコンテキスト ウィンドウのデータ量を一定に保ち、直近のメッセージを常に最新の状態に保つことができます。この階層では、ターンごとに 1 ミリ秒未満の高速かつ高スループットなルックアップが必要となるため、Memorystore for Valkey がアクティブなセッション状態の維持に最適です。
-
長期永続メモリ: 重要な事実、ユーザーの好み、エピソード的事実をセッションをまたいで保存します。この階層では、トランザクションの整合性、データ ガバナンス、リレーショナル データとベクトルにわたるハイブリッド検索が必要となります。これらは、AlloyDB AI がネイティブに提供する機能です。
長期記憶とアクティブ セッション バッファの両方をリレーショナル データベースに直接保存することも可能ですが、インメモリ キャッシュを備えた 2 層アーキテクチャの方がパフォーマンスとスケーラビリティが向上します。アクティブ セッション バッファは非常に一時的なもので、会話のターンごとに 1 ミリ秒未満の高スループットな更新が必要です。これらの高頻度で発生する書き込みをインメモリ Key-Value キャッシュで処理することで、リレーショナル データベースでの書き込みの増大とテーブルの肥大化を防ぎます。これを行わないと、頻繁な行の削除や負荷の高いバキューム処理が必要になってしまいます。これは、データベースの前段にキャッシュ階層を追加して、アクセスが集中している行への高頻度なルックアップをオフロードするのと同様の仕組みです。この分業により、プライマリ データベースは負荷を抑えて応答性の高い状態を維持し、トランザクションの整合性、複雑なハイブリッド ベクトル検索、長期的な分析クエリの実行など、本来の目的にリソースを集中させることができます。
Memorystore for Valkey の短期キャッシュと AlloyDB AI のネイティブ機能を組み合わせることで、エンティティ抽出、メモリ圧縮、セッションをまたいだメモリ、ハイブリッド検索をデータベース層内で直接実行し、アクティブなプロンプトを軽量かつ高速に維持し、優れた費用対効果を実現できます。
4 種類のメモリについて
エージェントの長期的なステートを効果的に整理するために、エージェントのメモリを、前述の短期ストレージ レイヤと長期ストレージ レイヤにわたる、互いに補完し合う 4 つのタイプにさらに分割します。
短期的な会話コンテキストを構造化された長期的なルールから分離することで、エージェントは、トークン ウィンドウを未加工のインタラクション ログで埋め尽くすことなく、関連するコンテキストをオンデマンドで取得できます。
階層型メモリ アーキテクチャのブループリント
以下の図は、アプリケーション オーケストレーション レイヤ、Memorystore for Valkey の短期バッファ、AlloyDB AI の長期リポジトリを接続する読み取りパスと書き込みパスの概要を示しています。
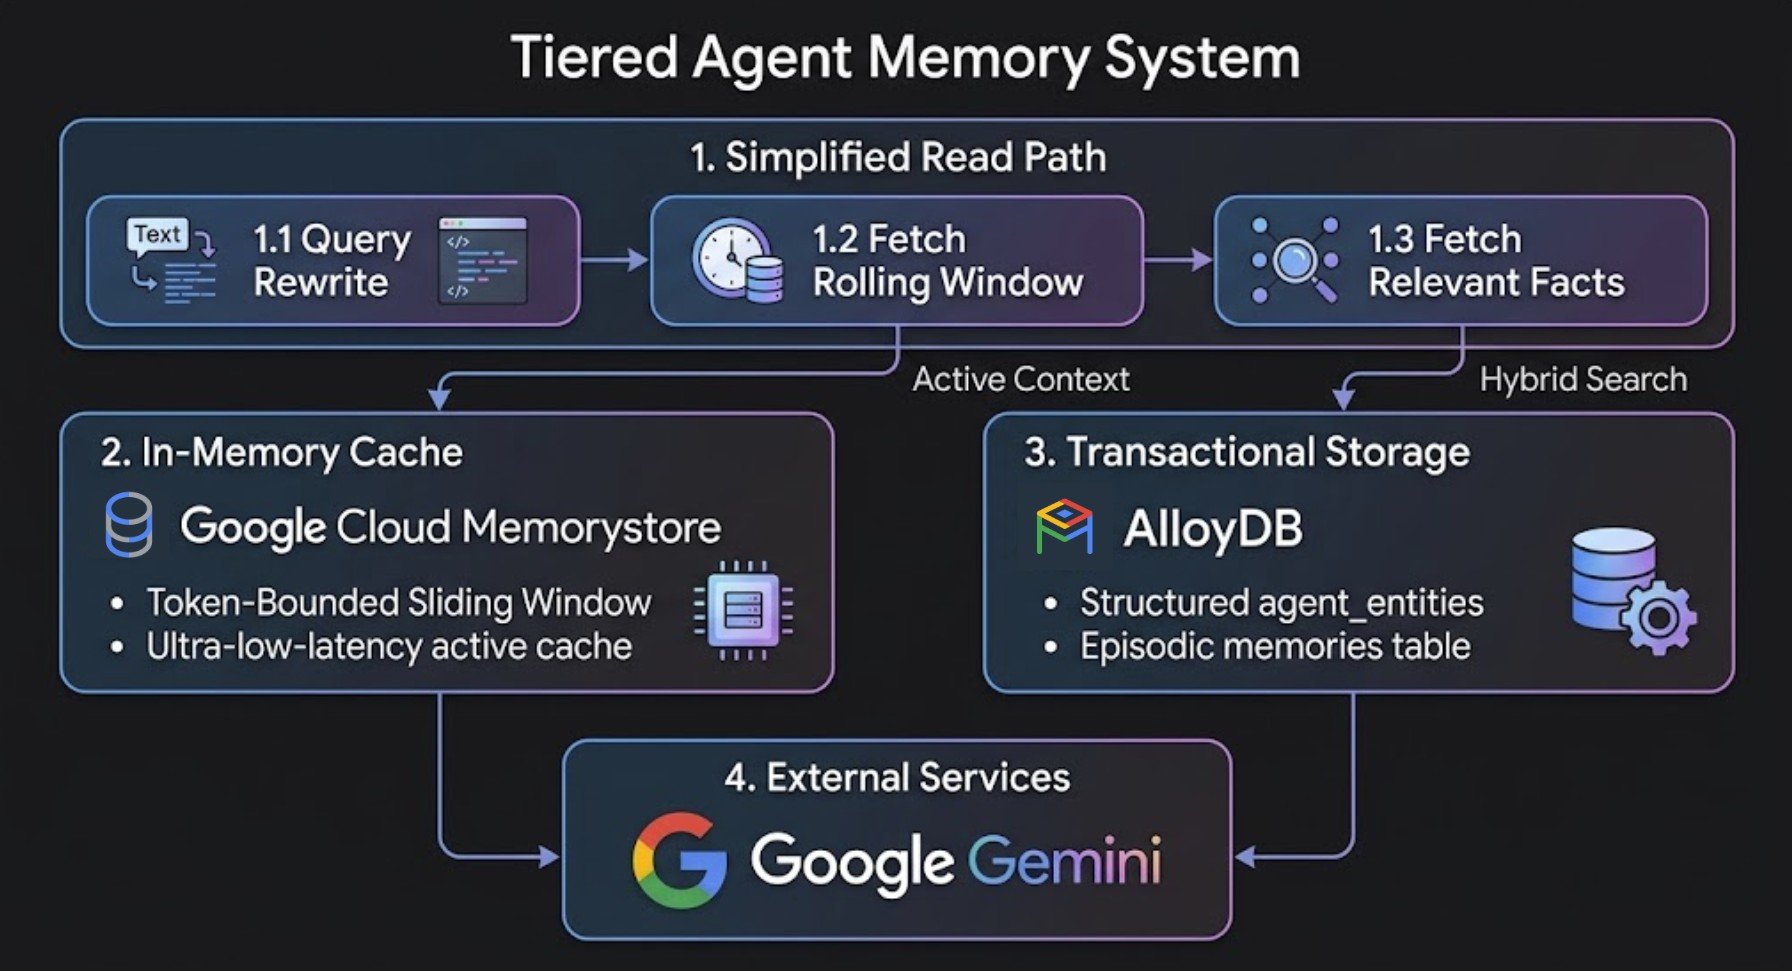
このシステムは、以下の 2 つの連携した実行パスで動作します。
-
読み取りパス: ユーザーが質問すると、アプリケーションは Memorystore for Valkey からアクティブなスライディング ウィンドウを取得し、
ai.generateを使用してデータベース内クエリの正規化を実行します。そしてai.hybrid_searchを使用して AlloyDB にクエリを送信し、スコープ設定されたエンティティ ルールと関連するエピソード的事実を取得します。 -
書き込みパス: 回答が生成されると、会話のターンはすぐに Memorystore for Valkey にキャッシュされます。非同期のバックグラウンド キュー ワーカーが、会話のやり取りから構造化エンティティを抽出し、AlloyDB に直接書き込みます。AlloyDB では、トランザクション自動エンベディングによってベクトル表現が即座に計算され、データベースに保存されます。
ビジネスへの影響と費用対効果
開発におけるマルチターンの対話(45 ターン以上、大量のツール実行)を対象としたベンチマーク テストでは、短期キャッシュを長期永続化から分離することで、単純なコンテキスト スタッフィングと比較して、費用削減とパフォーマンス向上を実現しました。
注: 上記の指標は、実際のエンタープライズ AI ペア プログラミング アシスタントが、複数のセッション、プロジェクト、コンテキストの切り替えにわたって開発者とやり取りする様子を再現した、シミュレートされた開発ワークロードに基づく内部ベンチマーク結果を反映したものです。実際の費用削減とレイテンシは、プロンプトの構造、クエリの頻度、データ量によって異なります。
これらの結果は、階層型メモリがエージェントのユニット エコノミクスをどのように変化させるかを示しています。ターンが追加されるたびに費用曲線が上昇するのではなく、プロンプト サイズが一定の範囲内に収まるため、高速の応答時間を維持しながら、継続的な LLM API 費用を削減できます。
AlloyDB AI の核となる技術的メリット
AlloyDB AI は、コア AI 機能をデータベース エンジンに直接組み込むことで、永続的なエージェント メモリの実装に伴う運用上のオーバーヘッドを削減します。その主な特長は以下のとおりです。
-
データベース内トランザクション自動エンベディング(ai.initialize_embeddings): AlloyDB は、Agent Platform(旧称 Vertex AI)とのネイティブ統合を使用して、テキスト列のベクトル エンベディングを自動的に生成し、1 秒あたり最大 3,000 個のエンベディングを処理できます。
incremental_refresh_mode => 'transactional'を使用すると、AlloyDB は同じトランザクション内でソースデータが変更されるとエンベディングを最新の状態に保つため、カスタム エンベディング パイプライン、外部スケジューラ、複雑な再試行ロジックが不要になります。 -
データベース内生成 AI 関数(ai.generate): AlloyDB では、Gemini などの基盤モデルを SQL クエリから直接実行できます。これを使用すると、データベース内でクエリを分解できます。つまり、ユーザーの複合的な質問を単一の要素からなるサブクエリに分割し、相対的な時間表現(「前回のセッション」など)を明示的な識別子に解決できます。アプリケーション側で個別にラウンドトリップを行う必要もありません。
-
組み込みの Reciprocal Rank Fusion(ai.hybrid_search)によるネイティブ ハイブリッド検索: AlloyDB は、エンジン内で直接 Reciprocal Rank Fusion(RRF)を実行する組み込み SQL 関数を提供します。ベクトル コサイン類似度(HNSW または ScaNN インデックスに対する
<=>)と PostgreSQL 全文検索(BM25、RUM、または GIN を使用)を 1 回のデータベース呼び出しで組み合わせ、セマンティック マッチングと正確なキーワード検索を融合させます。同時に、メタデータ フィルタ プッシュダウン(filter_condition)をサポートすることで、パフォーマンスの向上と確定的なスコープ分離を実現します。 -
IAM 認証情報を使用した Agent Platform との直接統合: AlloyDB は、Google Cloud IAM サービス アカウントのロールとデータベース認証を使用して、Google Cloud のプライベート ネットワーク経由で Agent Platform 基盤モデルに直接接続します。これにより、アプリケーション コードで API キーを保存、ローテーション、受け渡す必要がなくなります。
-
運用、ベクトル、ガバナンスの統合エンジン: AlloyDB は、リレーショナル ビジネスデータ、ベクトル エンベディング、全文インデックス、エンタープライズ権限を、ACID 準拠の単一の PostgreSQL データベースに統合します。これにより、個別の運用データベースとベクトル データベース間で発生するデータのドリフトや統合の複雑さを回避できます。
主な実装パターン
以下は、2 層メモリ アーキテクチャの構成に使用されるコア データベース パターンです。実行可能な完全な Python スクリプトと SQL スクリプトについては、対応する AlloyDB エージェント メモリ Codelab をご覧ください。
1. スキーマと自動エンベディングの設定
AlloyDB で、必要な拡張機能をインストールし、構造化メタデータ、全文検索用に生成された tsvector 列、ベクトル エンベディング列を含む agent_entities テーブルを定義します。
次に、ai.initialize_embeddings を使用してエンベディングを生成します。トランザクション モードを使用すると、ソースデータの変更に応じてエンベディングが最新の状態に保たれます。
最後に、HNSW ベクトル インデックスと RUM 全文検索インデックスを作成して、ハイブリッド検索を高速かつ効率的に行えるようにします。
2. ネイティブ ハイブリッド検索による長期記憶のクエリ
読み取りパスで、ai.hybrid_search を使用して関連する長期エンティティを取得します。このネイティブ SQL 関数は、AlloyDB で直接 Reciprocal Rank Fusion(RRF)を実行し、ベクトル類似性検索と全文キーワード検索の結果をシームレスに再ランキングして、単一のデータベース クエリに結合します。
3. AI 関数を使用したデータベース内メモリ圧縮
カスタムのプルーニング スクリプトを記述せずに長期的なストレージの増加を管理するには、AlloyDB で自動抽出および圧縮クエリを直接実行して、保存しておくべき重要な部分を特定します。このパターンでは、SQL 共通テーブル式(CTE)と ai.generate を使用して、古いエピソード的事実の履歴を高密度の要約に統合します。
たとえば、子どもを連れて飛行機を乗り継ぐことの複雑さに関する長いやり取りを、「直行便を希望」という要約にまとめることができます。
4. 2 層メモリ アーキテクチャの ADK エージェントへの接続
コアの 2 層メモリ アーキテクチャを構成したら、対応する Codelab で示されるように、デフォルトの ADK Memory プロバイダを拡張して、この 2 層メモリ アーキテクチャを使用できます(例: ADKTieredMemoryProvider)。長期記憶を ADK エージェントにアタッチするには、次のようにツール(例: longterm_memory_tool)として提供するだけです。
エンタープライズ ガバナンスとマルチテナント セキュリティ
エンタープライズの本番環境でエージェント メモリを実行するには、厳格なセキュリティ境界とアクセス制御が必要です。まず、スコープとマルチテナントの分離を維持する必要があります。agent_entities の user_id、project_id、scope 列にインデックスを付け、PostgreSQL の行レベル セキュリティ(RLS)を適用することで、同じデータベース クラスタ内の部門、チーム、個々のユーザー間でメモリストアを分離できます。パラメータ化されたセキュアビュー(PSV)は、もう一つの確定的なアプリケーション レベルのセキュリティ レイヤを提供し、悪意のあるプロンプトや過度に広範な SQL クエリから保護するのに役立ちます。
さらに、上記の実装パターンに示すように、メモリ ライフサイクルの自動管理を提供する必要があります。スケジュールされた SQL コンパクション クエリと時間ベースのパーティション プルーニングを組み合わせることで、データベースのフットプリントとクエリのレイテンシを長期にわたって予測可能な状態に維持できます。このアプローチの詳細については、対応する Codelab をご覧ください。
まとめと次のステップ
アクティブなコンテキスト ウィンドウを永続ストレージから分離することは、プロダクション レディな AI エージェントを構築するための実用的なアプローチです。1 ミリ秒未満のセッション キャッシュを実現する Memorystore for Valkey と、トランザクション対応の長期ストレージである AlloyDB AI を組み合わせることで、長期にわたるタスクや複数ターンのエージェント エクスペリエンス全体で厳格なビジネスルールを維持しながら、トークン費用を大幅に削減し、応答時間を短縮できます。
利用方法は次のとおりです。
-
対応する AlloyDB エージェント メモリ Codelab の実践的なチュートリアルを最後まで進め、実際に動作する 2 層メモリ アーキテクチャをデプロイします。
-
データベース側の ML 機能の詳細については、AlloyDB AI のドキュメントをご覧ください。
-
自動ベクトル エンベディングの生成とハイブリッド ベクトル検索の実行に関するガイドをご覧ください。
- Google、AlloyDB AI シニア エンジニアリング マネージャー、Itai Rosenblatt
- Google、AlloyDB AI / Cloud SQL 担当プロダクト マネージャー、Paul Ramsey