BigQuery の TabFM のご紹介: 予測分析の再定義
Vaibhav Sethi
Group Product Manager
Xi Cheng
Engineering Manager
※この投稿は米国時間 2026 年 9 月 2 日に、Google Cloud blog に投稿されたものの抄訳です。
これまで、チャーン、購入意向、不正行為スコアの予測といった企業の予測分析タスクでは、XGBoost、ランダム フォレスト、ディープ ニューラル ネットワーク(DNN)などのライブラリを使用してカスタムモデルを構築する必要がありました。トレーニング、チューニング、デプロイ、再トレーニングという従来のサイクルは効果的ですが、複雑で時間がかかる場合があります。さらに、手動での特徴量エンジニアリング、ハイパーパラメータ チューニング、時間と費用のかかるトレーニングといったオーバーヘッドに加え、専門的なデータ サイエンス スキルが必要となることから、企業は意思決定において予測モデルを十分に活用できていない可能性があります。
この投稿では、BigQuery の TabFM モデルについてお知らせします。Google Research が開発した TabFM は、表形式データの回帰と分類に対応した、最先端の事前トレーニング済み基盤モデルです。コンテキスト内学習(ICL)を使用し、単一の SQL ステートメントを介して、表形式のデータセットに対する高精度な予測を瞬時に提供し、独立したトレーニングとデプロイの手順を不要にします。BigQuery の TabFM は現在プレビュー版です。
TabFM は、以下のようなメリットを BigQuery 分析にもたらします。
-
ゼロショット予測: モデルのトレーニング、チューニング、アーティファクトのデプロイをスキップします。ラベル付きの過去データと新しい予測テーブルを単一の SQL 関数に渡すだけで、高品質な予測を即座に取得できます。
-
エージェント アプリケーション向けの予測 ML: ビジネス用途のエージェントを構築する場合、TabFM と BigQuery MCP サーバーを組み合わせることで、予測機能を追加できます。ランタイムやインフラストラクチャを管理する必要はありません。データを入力するだけで予測結果が得られます。
-
最先端の精度: 複雑なデータセットにおいて、カスタム トレーニングされた既成の従来モデルを上回り、業種別ベンチマークで優れた精度スコアを達成します。
-
シンプルなデベロッパー エクスペリエンス: BigQuery 上でネイティブに実行され、シンプルな SQL 構文でアクセスできます。欠損値やカテゴリ エンコードなどの特徴量化タスクを自動的に処理するため、複雑な特徴量エンジニアリング パイプラインを管理する必要がありません。
-
スケーラビリティ: BigQuery の分散推論アーキテクチャを使用して、大規模な推論テーブル(最大数百万行)を数分で処理します。
表形式の予測のための主要なモデル
Google の TabFM は、幅広い表形式データにわたり業界トップクラスの精度を実現しています。TabArena ベンチマークの評価において、TabFM のパフォーマンスは、従来の ML モデルと他の表形式基盤モデルの両方を一貫して上回っています。
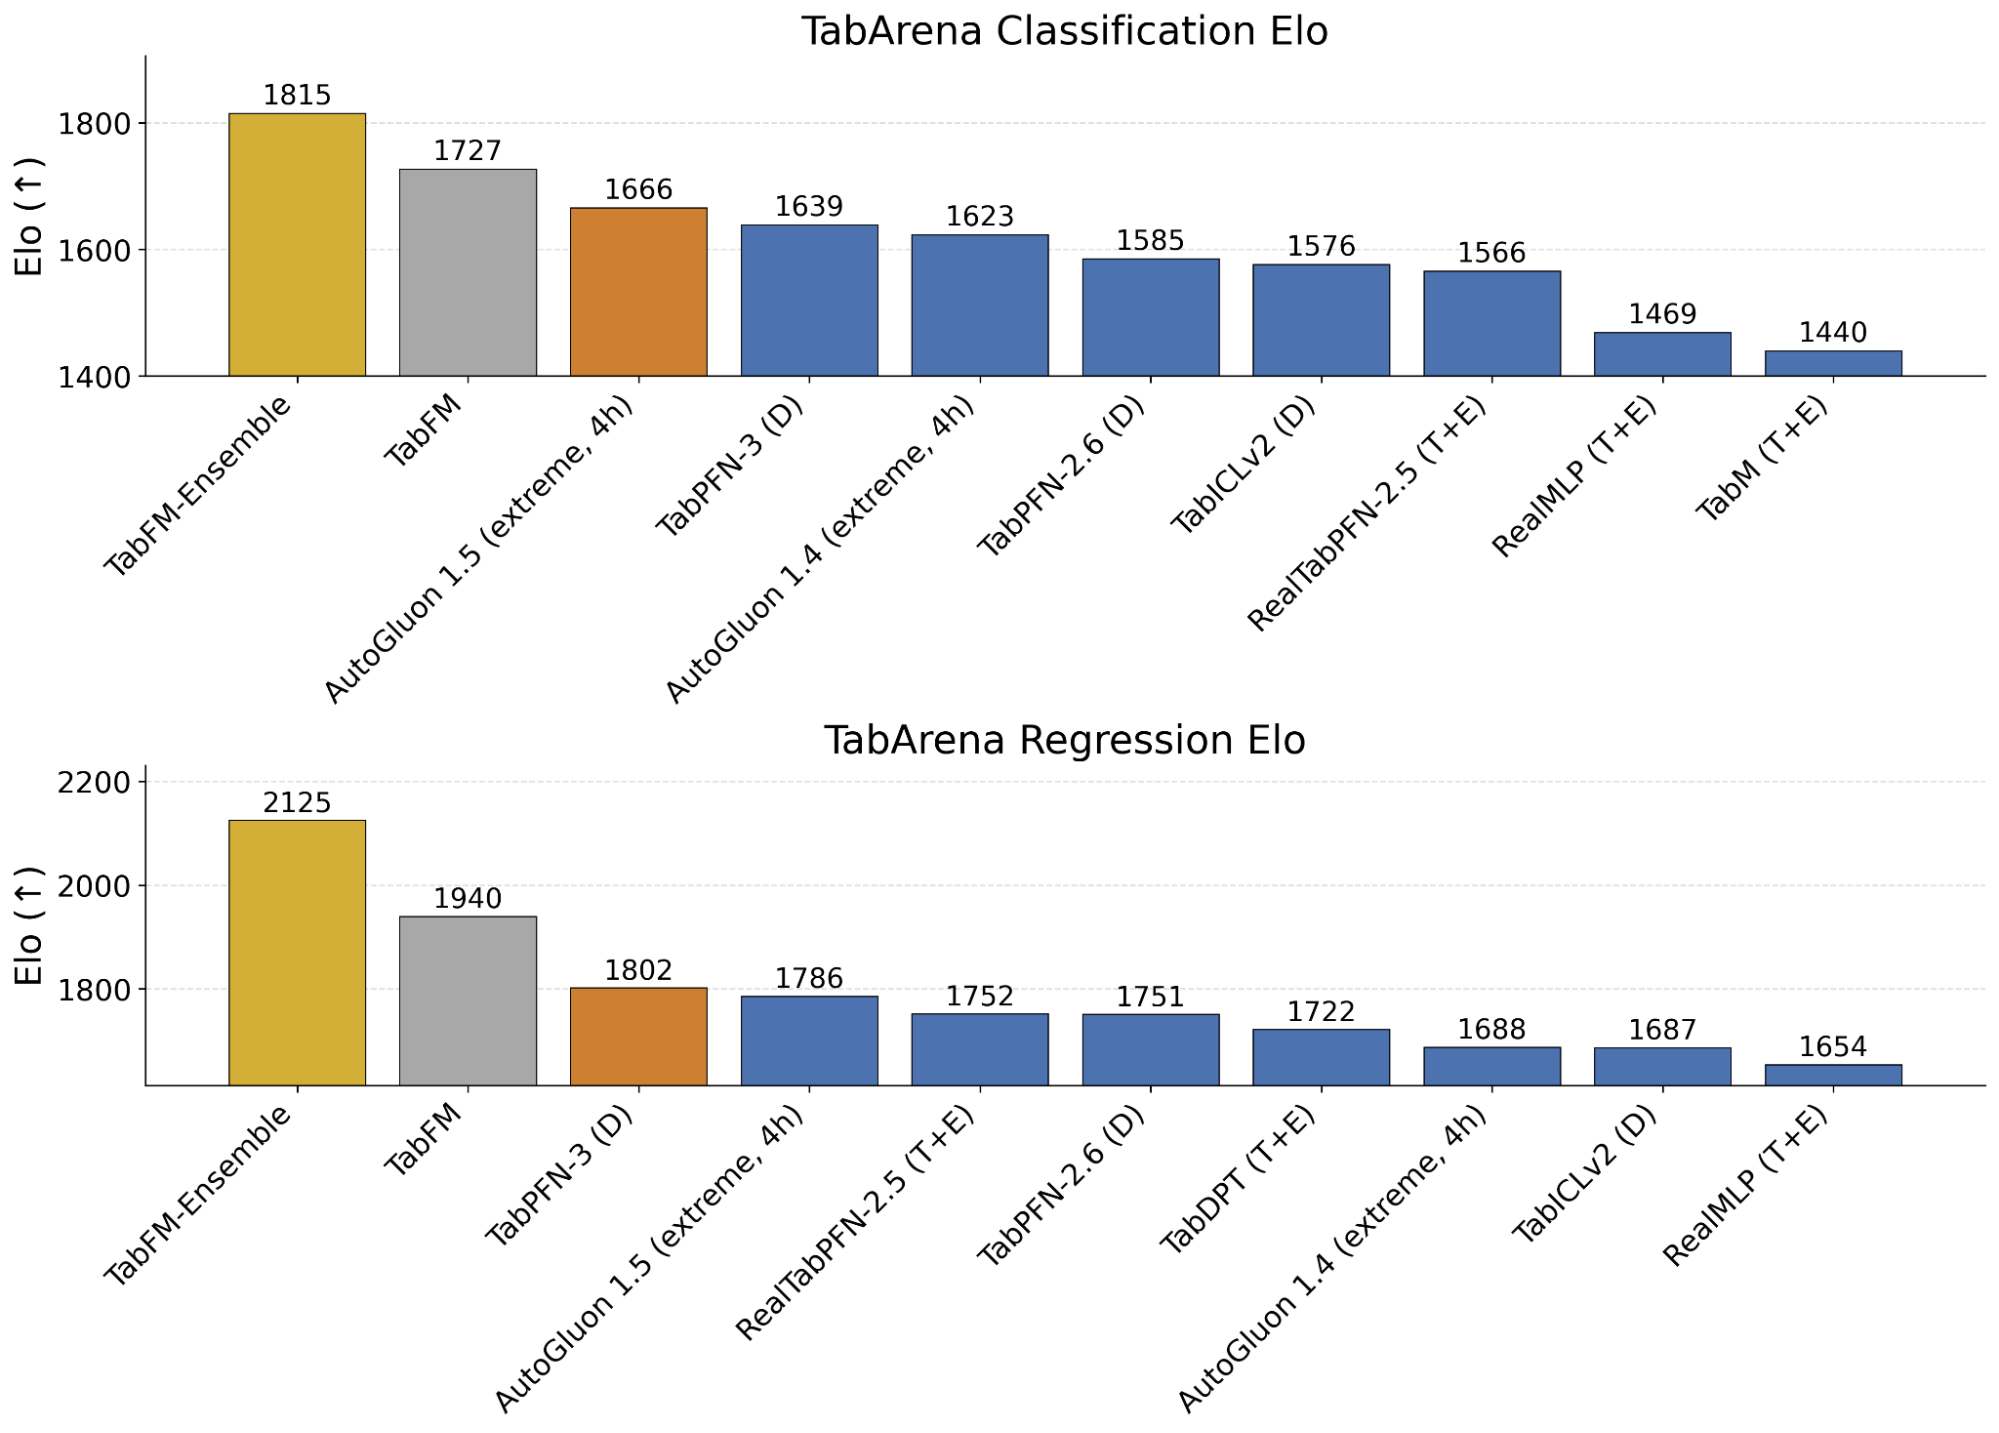
TabArena の分類(上)と回帰(下)における上位 10 モデルの ELO 評価(↑)。(D)= デフォルト、(T+E)= チューニング + アンサンブル。スコアが高いほど、パフォーマンスが優れていることを示します。
TabFM モデルについて詳しくは、こちらをご覧ください。
BigQuery で TabFM を使ってみる
TabFM の使い方は簡単です。新しい組み込みの SQL 関数である AI.PREDICT と AI.EVALUATE を通じて、直接利用できます。
1. AI.PREDICT で即座に予測結果を取得する予測を行うには、トレーニング データと予測データを渡す単一のクエリを記述します。モデルは、ターゲット ラベルのデータ型に基づいて、タスクが分類問題か回帰問題かを自動的に推論します。
この例の出力には、予測テーブルの元の列すべてに加えて、予測ラベルと確率の列(predicted_is_fraud など)が含まれます。手動での特徴量エンジニアリングやモデルの作成は不要でした。
2. AI.EVALUATE でモデルを評価するAI.EVALUATE 関数を使用すると、テストセットに対する予測パフォーマンスをすばやく確認できます。これにより、標準的な評価指標を 1 ステップで生成できます。
AI.EVALUATE は、回帰問題に対しては r2_score、mean_absolute_error などの堅牢な指標セットを、分類問題に対しては適合率、再現率、f1 などの指標を返します。
BigQuery の TabFM の仕組み
従来の ML では、モデル パラメータをトレーニング データセットに適合させる必要があります。これに対し、TabFM ではコンテキスト内学習を使用します。大規模言語モデル(LLM)が少数ショットのプロンプト例からタスクを学習するのと同様に、TabFM はトレーニング テーブルをコンテキスト内の例として読み取り、1 回のフォワードパスでターゲット テーブルに対する予測を生成します。
表形式基盤モデルの演算の複雑さとメモリ使用量に対応するため、BigQuery はデータに対して分散並列推論を実行します。さらに、インテリジェントなトレーニング データ サンプリングと分散実行を使用して、パフォーマンスとリソース使用率を最適化します。これにより、BigQuery はトレーニング データとして大規模な入力行を処理しながら、数百万行の推論データに対して迅速かつ効率的に予測を実行できます。
ジョブに適したツールを選択
TabFM は、BigQuery に画期的なゼロショット機能を導入し、XGBoost モデルなどの既存のサービスを補完します。TabFM と他のモデルのどちらを選択すべきかは、以下の基準で判断します。
-
TabFM は、ML の専門知識がなくても迅速かつ高品質な予測分析情報が必要な場合や、過去のデータセットが小規模から中規模である場合、データが頻繁に変更される場合、そして精度を維持するためにモデルを頻繁に再トレーニングする必要がある場合に使用します。また、オンデマンドでの予測分析を必要とする会話型ワークフローやエージェント ワークフローにも適しています。
-
XGBoost のような従来のモデルは、非常に大規模な過去のデータセットがある場合、カスタム ハイパーパラメータ チューニングを完全に制御する必要がある場合、TabFM の現在の制限を超えるほど特徴量が多い場合、または特徴量の重要度の説明可能性(例: どの入力特徴量が予測に最も貢献したか)が必要な場合に使用します。
予測 ML が簡単に
TabFM が BigQuery にネイティブに統合されたことで、予測 ML は標準の SELECT クエリを実行するのと同じくらい簡単になりました。TabFM により、モデルのトレーニング、チューニング、管理に伴う手作業のオーバーヘッドが排除され、デベロッパー、データ サイエンティスト、アナリストは、元データから豊富な予測分析情報を数秒で取得できます。
今すぐ利用を開始するには、一般公開ドキュメントをご覧ください。ご質問やご意見がございましたら、bqml_feedback@google.com までお知らせください。皆様がどのようなものを構築されるのか、楽しみにしております。
- グループ プロダクト マネージャー、Vaibhav Sethi
- エンジニアリング マネージャー、Xi Cheng