非構造化データ ワークフローのモダナイズ: Alteryx Live Query と Google Cloud BigQuery の連携
Kira Droganova
Senior Product Manager, Alteryx
Rama Vundela
Data Analytics Specialist, Google
※この投稿は米国時間 2026 年 10 月 10 日に、Google Cloud blog に投稿されたものの抄訳です。
Alteryx One Live Query と Google Cloud BigQuery は、分断されたツールへの依存を減らし、データの移動を最小限に抑え、ウェアハウス ネイティブの実行を可能にすることで、企業が複雑な非構造化データを大規模に処理する方法を一新します。
Live Query は、ビジネス ユーザーがコードを 1 行も記述することなく高度なデータ パイプラインを構築できる、直感的なブラウザベースの環境を提供します。BigQuery のスケールとパフォーマンスを組み合わせることで、安全な SQL プッシュダウンが可能になります。つまり、データ変換ロジックは、ネットワーク経由でデータを移動させることなく、ウェアハウス内で直接実行されます。この相乗効果は、ドキュメントを多用するワークフローで特に威力を発揮します。Live Query は、BigQuery 環境の厳格なデータ ガバナンスとセキュリティを維持しながら、Gemini などの Google の高度な AI および ML モデルをオーケストレートして、PDF や画像から情報を抽出できます。
請求書 PDF の処理から、Live Query を使用した BigQuery での例外レポート管理まで
財務チームやオペレーション チームは、ベンダーからの請求書の山に埋もれてしまうことがよくあります。これらのドキュメントは PDF 形式で届きますが、データに一貫性がなく、請求書番号の形式もさまざまであるため、手作業によるエラーが発生するリスクが高くなっています。従来、データチームは手動でデータを抽出するか、分断された複数のツールを使用してデータをウェアハウスに移す必要がありました。このプロセスには、時間がかかるだけでなく、データの重複や金額の不一致が発生しやすいという問題がありました。
Live Query for BigQuery のインテグレーションにより、請求書のライフサイクル全体を自動化できるようになりました。データチームは、BigQuery エコシステム内で直接、PDF の処理、主要なフィールドの抽出、結果の標準化を行うことにより、ドキュメント内の異常やデータの問題といった例外をより迅速に特定できると同時に、BigQuery のきめ細かなアクセス ポリシーに基づいて構成、ガバナンス管理された企業データを、ウェアハウスの外部に転送する必要がなくなります。
ソリューションの概要: 抽出、分類、検証、ルーティング、計上
Live Query ソリューションの仕組みについて、さらに詳しく見ていきましょう。請求書 PDF は、非構造化ドキュメントとして Google Cloud Storage に届きます。Live Query ワークフローでは、ドキュメント抽出ツールが、ユーザーが選択したモデル(Gemini や Document AI など)を使用して構造化フィールドを抽出します。その後、結果は信頼性の高い照合が行えるよう標準化され、BigQuery にすでに格納、ガバナンス管理されている請求書の履歴レコードと照合されます。
この自動化されたワークフローは、手作業による介入を最小限に抑えながら、ドキュメントから意思決定へとスムーズに至れるよう設計されています。エンタープライズ規模では、このパターンは少数の PDF を処理するだけにとどまりません。照合ロジックを BigQuery と整合させながら、数百万件もの非構造化ドキュメントに対する分析や AI 活用を可能にします。
AI を活用した抽出と BigQuery ネイティブの実行を組み合わせることで、このソリューションは以下を実現します。
-
ストレート スルー処理の向上: 手作業を減らし、より多くの請求書を自動的に処理できるようにします。
-
照合の迅速化と手動例外の削減: 抽出した請求書をプロセスの早い段階で BigQuery データと照合することにより、チームは重複や不一致を早期に特定し、手動での確認が必要な請求書の数を減らすことができます。
-
監査可能性の強化: ソースから最終的な業務出力まで、データの明確な処理履歴を保持します。
-
データ移動の削減: データを BigQuery 内にとどめ、その組み込み機能を活用することで、セキュリティ、ガバナンス、管理機能を強化します。
アーキテクチャ: Google Cloud ネイティブ パターン
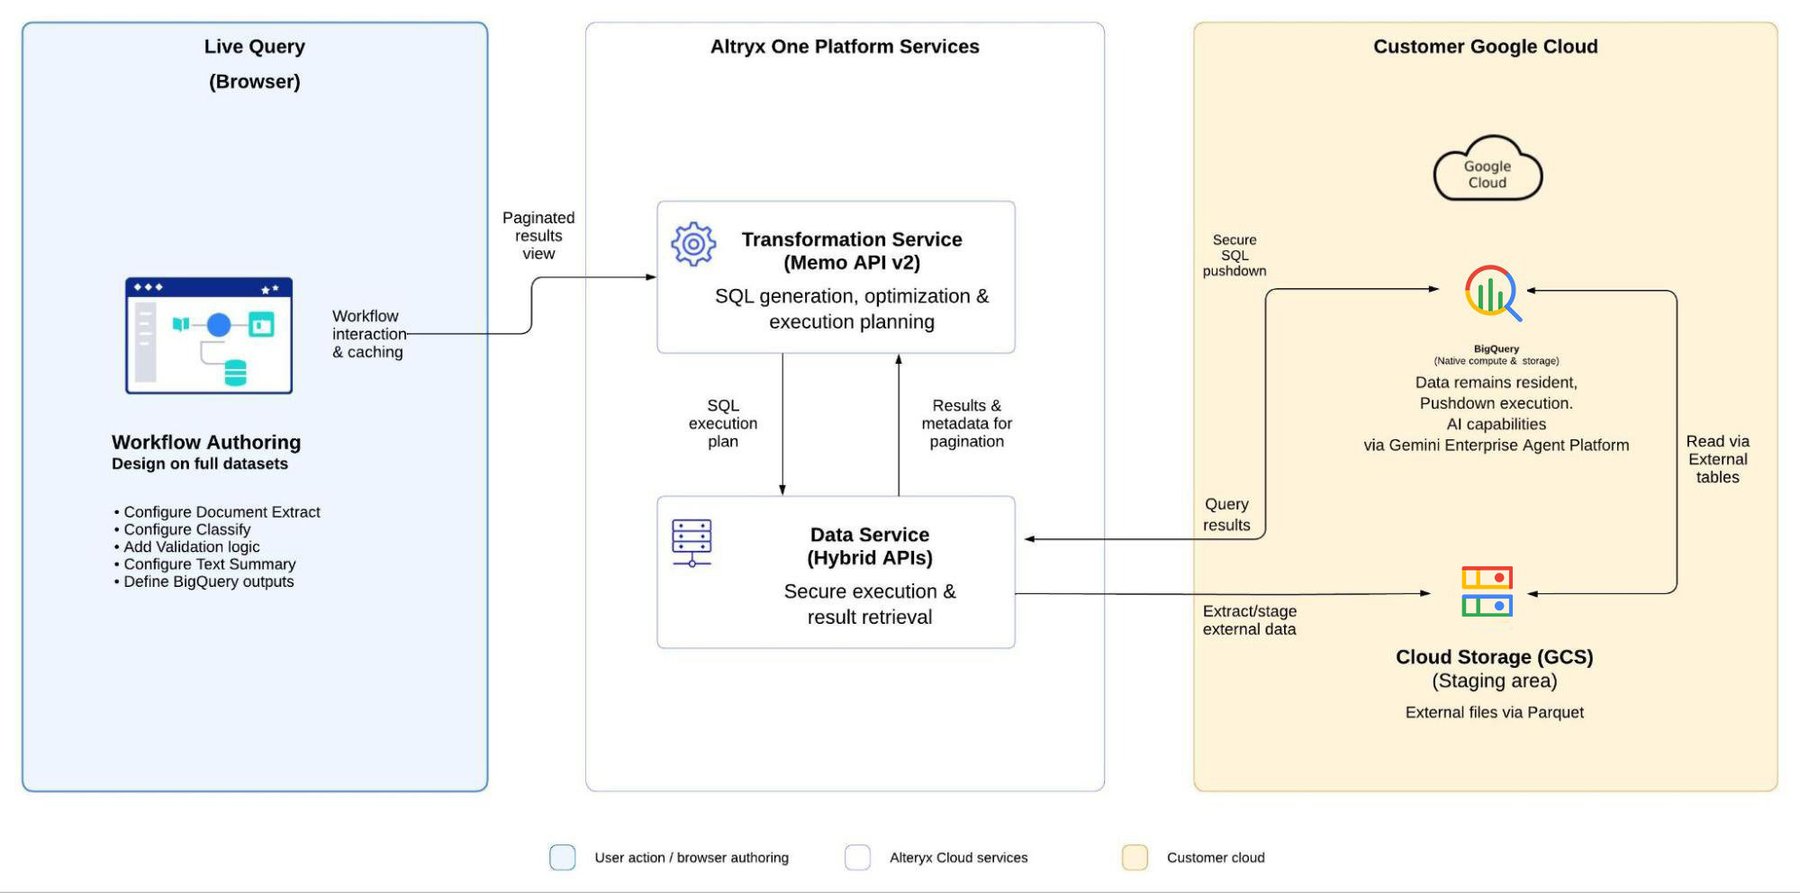
大まかに言うと、請求書 PDF は Cloud Storage にステージングされ、ブラウザ上の Live Query ワークフローで処理された後、BigQuery にすでに格納、ガバナンス管理されている請求書履歴と照合され、ファイナンス チームの最終的な業務出力として書き戻されます。このパターンのアーキテクチャ上の主な利点は、ワークフローの作成をブラウザ上で行える一方、変換や照合のロジックは、プラットフォーム サービスを通じて、ガバナンス管理されたデータ環境に対して実行されることです。
Live Query アーキテクチャは、ウェアハウス規模の処理とガバナンス管理された実行を目的として設計されています。安全な SQL プッシュダウンを使用して、変換と照合のロジックを BigQuery 内で直接実行し、Gemini と連携することで、ドキュメントの抽出、分類、要約といった高度な AI 機能を実現します。
-
Live Query(ブラウザ): ユーザーはブラウザ上でワークフローを視覚的に作成し、ドキュメントの抽出、分類、クレンジング、検証、ルーティングのロジックを構成します。
-
Alteryx One Platform Services: 変換サービスは、ブラウザ ワークフローとお客様のデータ環境の間におけるリクエスト処理、実行計画、結果取得を調整します。また、これらのサービスにより、ワークフローの実行全体にわたるトレーサビリティとオブザーバビリティが向上し、運用モニタリングと監査可能性の両方が強化されます。
-
お客様の Google Cloud: 請求書 PDF は Google Cloud Storage(GCS)にステージングされ、請求書の履歴データは BigQuery でガバナンス管理された状態で保持されます。AI を活用した抽出はその環境に対して実行され、ワークフローの出力は BigQuery に書き戻されます。
このパターンでは、ブラウザがオーサリング レイヤ、Alteryx One Platform Services が調整レイヤ、Google Cloud がガバナンス管理されたデータおよび実行レイヤとなります。この構成により、Live Query でワークフロー ロジックを視覚的に作成しながら、BigQuery でガバナンス管理されたデータおよびウェアハウス規模の処理と連携して実行できます。
Live Query ワークフロー解説: PDF から分析情報まで
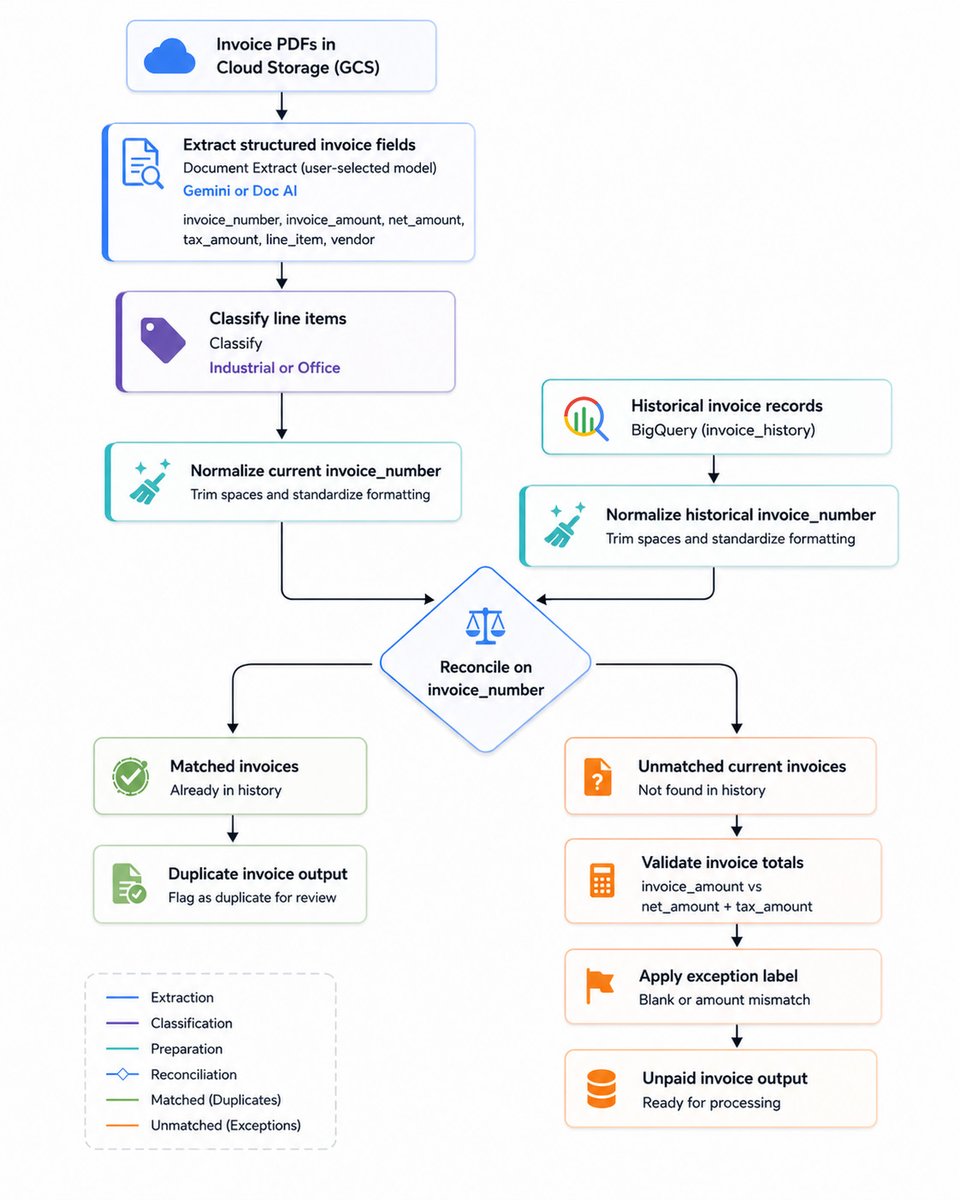
請求書を例に、Live Query ワークフローが非構造化 PDF をどのように処理するかを詳しく見ていきましょう。
請求書 PDF を取り込むワークフローは、未加工の PDF ファイルが格納されている Google Cloud Storage のディレクトリ入力を指定することから始まります。実際には、このステップではフォルダを特定するだけでなく、PDF の場所を列挙し、絶対ファイルパス、サイズ、作成 / 更新タイムスタンプといったファイルレベルのメタデータを返します。これにより、ワークフローは適切なドキュメント セットをダウンストリームの抽出ステップに確実に渡すことができます。
主要なフィールドを抽出するAlteryx の Document Extract ツールを使用して、ワークフローは Google Cloud Storage に格納されている PDF 請求書を処理し、構造化または半構造化された結果を BigQuery 内で直接抽出します。抽出ステップでは、ワークフローの構成に応じて、ユーザーが選択したモデル(Document AI または Gemini AI)が使用されます。このツールは、内部で入力ドキュメントの URI から一時的な外部オブジェクト テーブルを構築し、適切な関数(Document AI モデルの場合は ML.PROCESS_DOCUMENT、Gemini AI モデルの場合は AI.GENERATE)を実行します。このワークフローでは Gemini の処理ルートが使われており、AI.GENERATE がリクエストされた請求書フィールドをダウンストリームの Live Query ワークフローに返します。
インタラクティブな設計時、Live Query はプレビューのためにドキュメント URI のごく一部のみに処理を制限しますが、ランタイム実行ではすべての請求書 PDF を処理します。
抽出されたデータの内容を分類する抽出後、ワークフローは Alteryx の Classify ツールを使用して、抽出された請求書テキストにゼロショット分類を適用します。このユースケースでは、BigQuery の AI.CLASSIFY を使用して、明細項目の内容を、工業用品や事務用品などの事前定義されたビジネス カテゴリに分類します。これにより、予測ラベルが新しい列としてダウンストリーム ワークフローに返されます。このビジネス コンテキストにより、抽出されたデータは、ダウンストリームでの照合、例外処理、レポート作成においてより有用なものとなります。
データを正規化する抽出された請求書番号はクレンジングされ、標準化されます。これにより、空白文字や書式の不一致といった軽微な表記の違いによって照合中に重複の可能性が見落とされることがなくなります。
履歴と比較するワークフローは、正規化された現在の請求書レコードを、すでに BigQuery に格納されている請求書の履歴データと結合します。この照合ステップでは、履歴にすでに存在する請求書番号と一致するレコードを特定し、重複の可能性があるものとしてフラグを立てます。
例外にフラグを立てる次に、数式ステップで、残りのレコードにビジネスルール ロジックを適用します。これらのルールはワークフローによって異なり、金額の不一致、必須フィールドの欠落、無効な合計額、その他の財務特有の例外に対するチェックなどが含まれます。この例では、1 つのルールで invoice_amount が net_amount + tax_amount と一致するかどうかを確認し、不一致があれば確認対象としてフラグを立てます。
業務出力を生成するこのワークフローでは 2 つの業務出力が生成されます。1 つは、履歴レコードと一致し、重複の可能性があるとしてフラグが立てられた請求書に関するものです。もう 1 つは、履歴と一致しなかった今回の請求書に関するもので、検証と必要に応じて例外のラベル付けが行われ、未払い請求書の処理に回されます。
その結果得られるのは、単に抽出されたデータにとどまらず、ファイナンス チームがすぐに確認して対応できる、ガバナンス管理された業務出力です。
まとめ: ドキュメントから意思決定まで、ガバナンス管理されたワークフロー
私たちの共通のお客様は、ビジネス プロセスの改善に役立つこれらの新機能に大きな期待を寄せています。
「Alteryx One: Google エディションで特に印象的だったのは、Google Cloud のエクスペリエンスに自然にフィットしている点です。ビジネス ユーザーが直感的でガバナンス管理されたエクスペリエンスを通じて BigQuery データを操作できるようにすることで、分析をより身近なものにする機会が得られることを嬉しく思います。」 - Papa Johns、エンタープライズ データおよびコーポレート ソリューション担当バイス プレジデント、Michael Wyant 氏
これは、単なる抽出ツールのユースケースにとどまりません。非構造化ドキュメントを実用的な業務出力に変換する、強力な Google Cloud ネイティブ パターンを表しています。このワークフローは、分断された準備ツールにウェアハウス データを移動するのではなく、ストレージ、抽出、照合、出力生成を、BigQuery にすでに格納されているガバナンス管理された企業データと整合させます。Alteryx One Live Query の直感的な設計と BigQuery のスケールおよび AI 機能を組み合わせることで、ファイナンス チームは手作業による負担を減らし、例外処理を迅速化して、より価値の高い戦略的な取り組みに注力できるようになります。
- Alteryx、シニア プロダクト マネージャー、Kira Droganova 氏
- Google、データ分析スペシャリスト、Rama Vundela