BigQuery でエージェント時代の未来に備える: 継続的なコスト パフォーマンスの向上を、手間をかけずに実現
Joe Yong
Product Manager
Manan Goel
Group Product Manager
※この投稿は米国時間 2026 年 8 月 7 日に、Google Cloud blog に投稿されたものの抄訳です。
現代のデータ環境において、クエリ パフォーマンスのチューニングやシステムのコスト パフォーマンスの管理は、大きな課題になっています。特に、エージェント型ワークロードの増加に伴い、その難易度はさらに高まっています。データの量、多様性、速度が爆発的に増加し続けるなか、クエリ実行プランの分析やスキーマの調整、クエリヒントの追加といった作業は、経験豊富な開発者や DBA にとっても終わりのないルーチンワークとなり、ビジネスの機動力を削いでいます。
パフォーマンス チューニングは一般的な手法ですが、最新のデータ プラットフォームに求められるのは、それだけではありません。データ プラットフォームが「インテリジェンス システム」から「アクション システム」へと進化し、分析ワークロードの主体が「人間による 1 日数回の実行」から「無数のエージェントによる毎分数千回の実行」へと移行するなか、従来の手動によるクエリ調整はもはや限界を迎えています。ユーザーのアクションに応じてエージェントやアプリケーションがクエリを自動生成するようになると、手動での最適化は事実上不可能です。
BigQuery は、データ ウェアハウスからエージェント型 AI 時代の主要なエンジンへと進化しました。ストレージとコンピューティングを真に分離した独自のアーキテクチャ、サーバーレス処理、きめ細かいコンピューティング管理を基盤に、BigQuery は自律的なクエリ処理の限界を押し広げ続けています。Google の究極の目標は、クエリ、スキーマ、データ、ワークロードを問わず、人間とエージェントの双方が手間をかけずに最適なコスト パフォーマンスを享受できる、自律型クエリ プロセッサを実現することです。2025 年だけでも、クエリのパフォーマンスが最大 35% 向上し、クエリ処理コスト(スロット使用量)が最大 40% 削減されました。
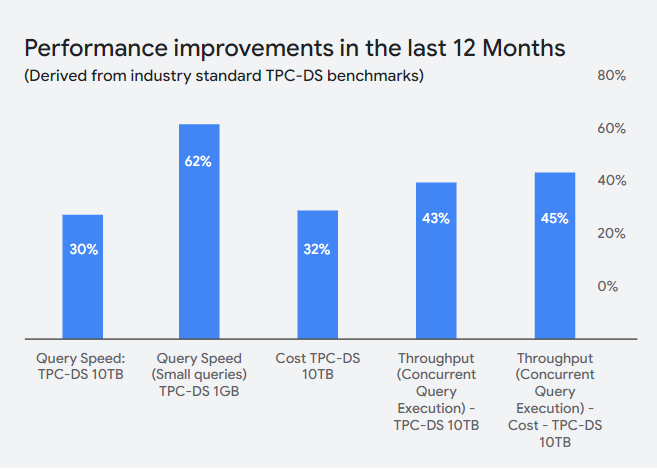
図 1. 業界標準のベンチマークに基づく、2025 年の BigQuery コスト パフォーマンス向上の概要。
以下は、パフォーマンスと総所有コスト(TCO)の改善に貢献する主なイノベーションの一部です。これには、回帰に対する組み込みのガードレールも含まれます。
BigQuery の自己学習エンジン: 履歴ベースの最適化(HBO)
BigQuery の自律型クエリ プロセッサの基盤となる機能の一つが、履歴ベースの最適化です。
従来のクエリ オプティマイザーは、静的な統計情報やメタデータ、カーディナリティ推定に依存しています。そのため、非常に複雑な複数テーブルの結合や、急速に増加または変化するデータに直面すると、その精度が著しく低下することがあります。これらに対応することは、管理者にとって極めて重要な業務であり、効果的かつ効率的な運用には、ワークロードごとに自動化をきめ細やかに調整する必要があります。すべてが最新かつ正確であっても、自然なデータスキューや利用可能なコンピューティング リソースの変化により、クエリの動作が大きく異なることがあります。履歴ベースの最適化は、これまでのパラダイムを転換します。クエリ実行中にプランやリソース割り当てを変更できる BigQuery の既存の適応型クエリ実行に加え、過去の実行から学習し、将来の実行に向けてさらなる最適化を自動的に適用します。
過去のクエリのランタイム統計を追跡して、どの最適化が有益だったかを「記憶」し、それらを適用し続けます。また、以前のミスから学習して、同じミスを繰り返さないようにします。同じまたは類似のクエリが再度実行されると、BigQuery は効果が実証されている最適化手法を自動的に適用し、回帰を引き起こす可能性のある手法を回避します。
ユーザーの操作が不要、安全ガードレールが標準実装
履歴ベースの最適化では、アプリケーションの書き換え、SQL の修正、スキーマの変更は必要ありません。ユーザーは文字どおり何もする必要がなく、定期的なダッシュボード、ELT パイプライン、エージェント ワークロード、事業部門モジュールがより高速に実行されます。
重要なのは、これが安全ガードレールを標準実装した、自己メンテナンス型、自己改善型のクローズドループ システムであるということです。履歴ベースの最適化は、パフォーマンスの向上が確実に見込まれる場合にのみ適用されます。もし最適化の判断を誤った場合は、どうなるでしょうか?この機能には本質的に自己修正能力が備わっています。最適化が適用されると、システムが結果を測定します。期待される改善が確認された場合、最適化が承認されます。パフォーマンスが大幅に向上しない場合、またはさらに悪いことに、パフォーマンスが低下したり、失敗につながったりした場合、その最適化は直ちに拒否され、取り消され、そのクエリに対して再度試行されることはありません。これにはデータスキューの検出も含まれます。これにより、パラメータ依存のプランを持つクエリにおいて、WHERE 句などのパラメータを一つ変更しただけでパフォーマンスが大幅に低下する、といった事態を防ぐことができます。
その結果、実行時間の短縮とスロットの削減が実現します。ある企業のお客様は、P90 の実行時間が最大 50% 短縮され、スロット使用量が最大 15% 削減されたと報告しています。これにより、コスト パフォーマンスが大幅に向上し、回帰も発生しなくなりました。
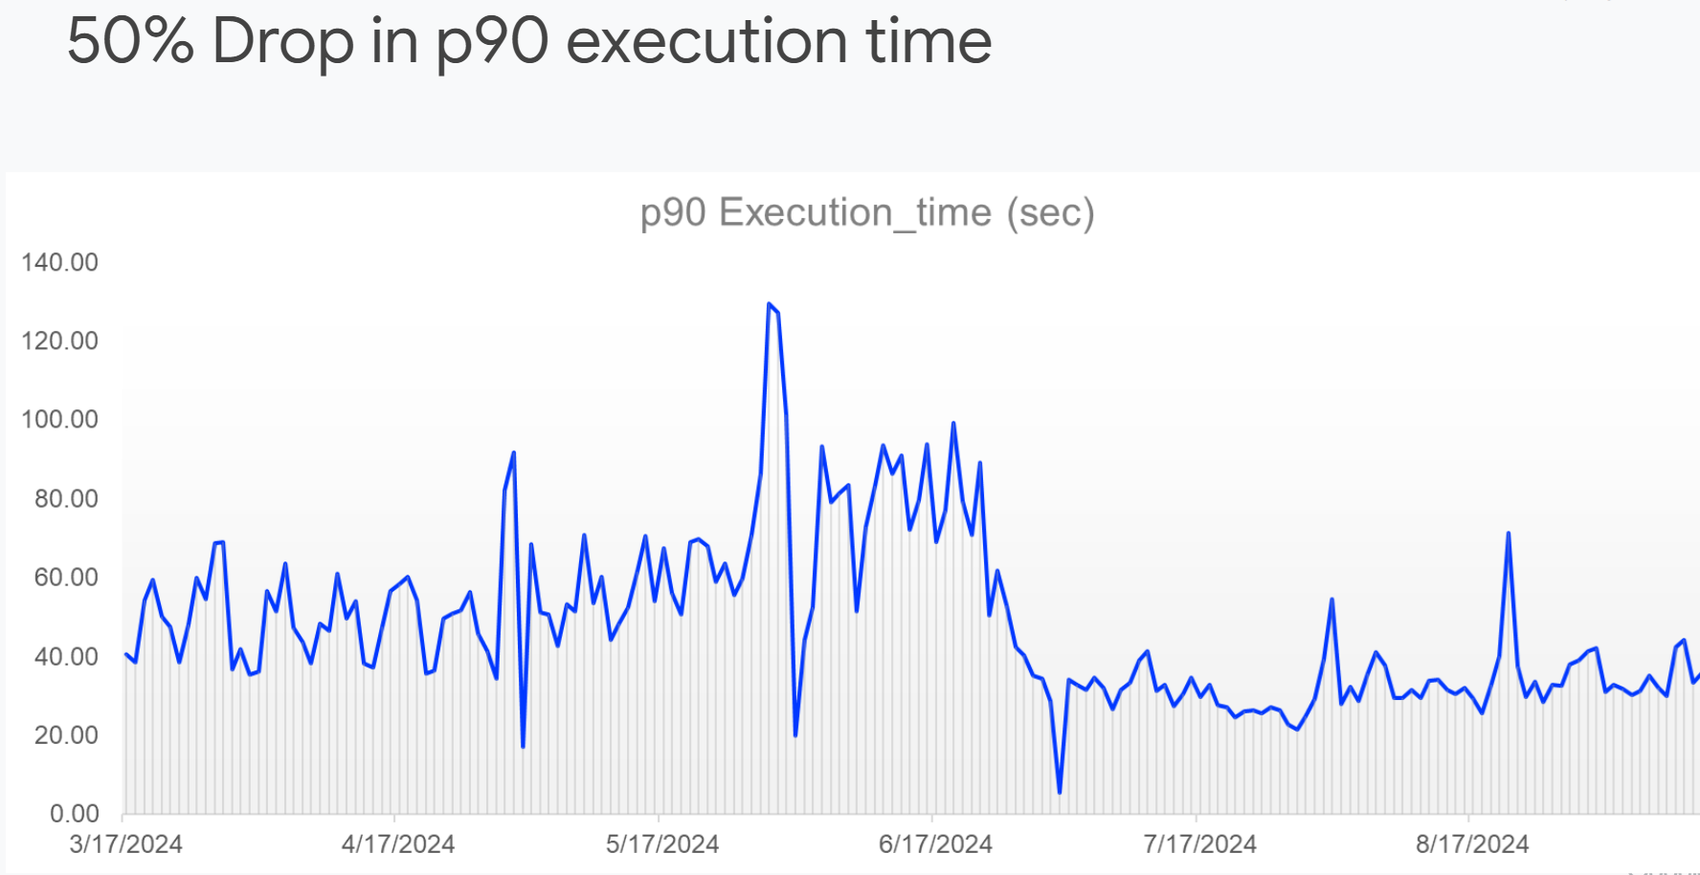
図 2. 企業のお客様から報告された、履歴ベースの最適化によるパフォーマンス改善の一例。
BigQuery 実行エンジンに新しいトリックを教える: 高度なランタイム
BigQuery の自律型機能は、BigQuery の高度なランタイムによって、実行レイヤの深部にまで及びます。このエンジンのアップグレードにより、手動での細かなチューニングを一切行うことなく、クエリに最適な物理実行パスが自動的に決定されます。
1. ベクトル化の強化
ベクトル化実行自体は新しいコンセプトではありませんが、BigQuery は単一命令複数データ(SIMD)命令による最新のプロセッサ処理効率を活用することで、その実装を強化しました。エンジンは、重複する計算を回避する機会を自律的に特定し、辞書とランレングス圧縮でデータをネイティブに処理します。最先端の並列アルゴリズムと組み合わせ、対象となるクエリステージに適用することで、高速化の機会を増やします。効果: 完全に自動化されたプロセスを通じて、対象となるクエリを最大 10 倍まで安全に高速化し、全体のスロット時間を最大 40% 削減することに成功しています。
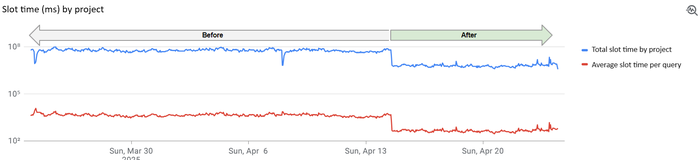
図 3. 高度なランタイム - ベクトル化の強化
2. 短いクエリの最適化
高い同時実行性と低レイテンシが求められる BI ダッシュボードや、1 秒未満のレイテンシを必要とし、数千件のクエリを生成するエージェント型アプリケーションの場合、分散処理に伴うオーバーヘッドがボトルネックになる可能性があります。BigQuery は、同時実行されている他のクエリに影響を与えることなく、対象となる「短い」クエリを自律的に高速化できるようになりました。ステージ数を減らしてデータ シャッフルを減らすことで、BigQuery はクエリのレイテンシとリソース効率を全体的に向上させます。BigQuery は、スケーラブルな大規模並列処理(MPP)分散データベースにおいて、効率的な対称型マルチプロセッシング(SMP)クエリパスを透過的に実現しています。効果: 短いクエリのスロット使用量が最大 10 分の 1 に減少し、P99 のクエリ レイテンシが 1 秒未満になります。各クエリのスロット占有時間が短縮されることで、一部のお客様のワークロードではスループットが最大 3 倍向上しました。これらはすべて、エンドユーザーが一切意識することなく、透過的に実現されます。
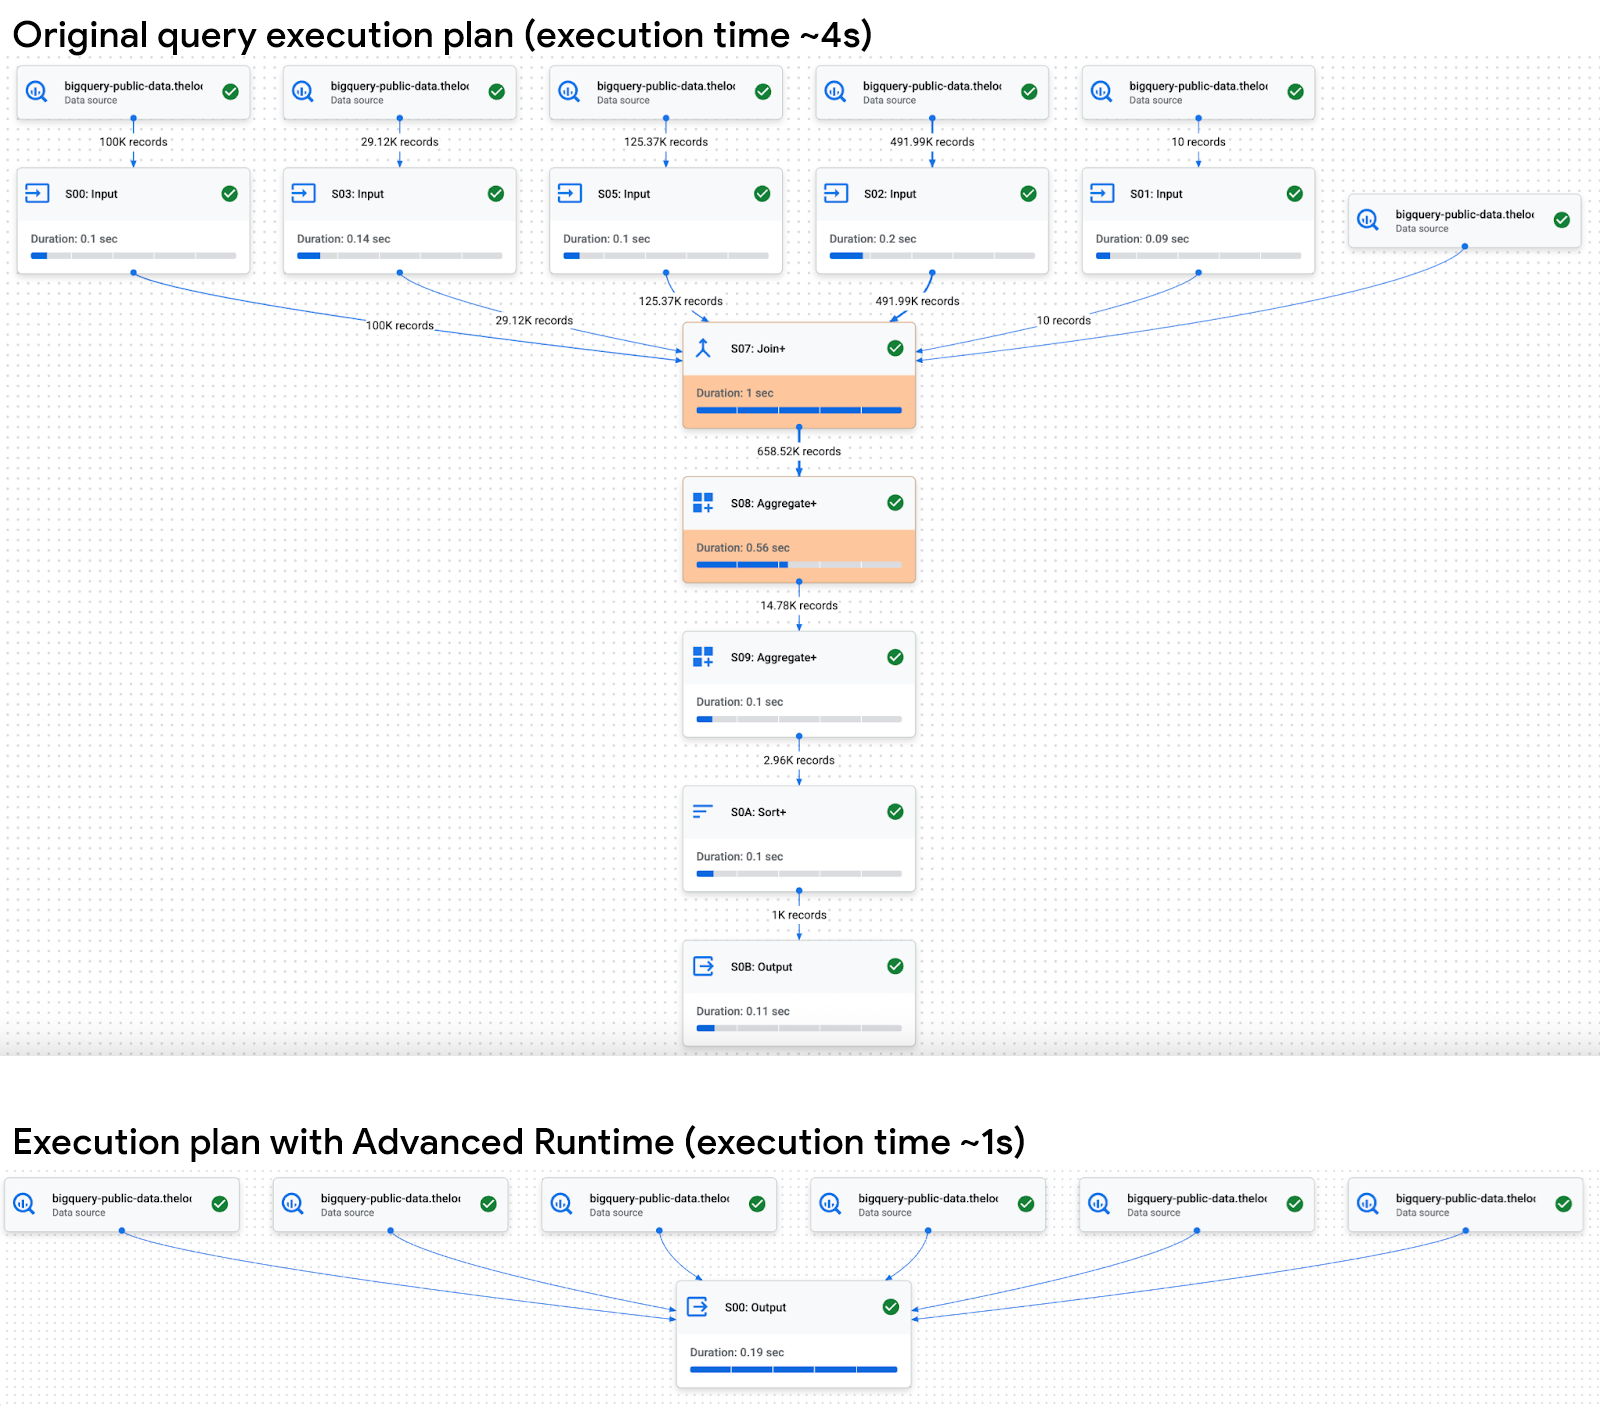
図 4. 高度なランタイム - 短いクエリの最適化
データ形式を問わない共通のメリット
Apache Iceberg のようなオープン テーブル形式を使用してオープン レイクハウス アーキテクチャを採用する場合でも、自律的なパフォーマンスを犠牲にする必要はないと Google は考えています。BigQuery のパフォーマンス向上は、基盤となるテーブルやデータ形式に関係なく同じように機能します。すなわち、BigQuery のネイティブ Capacitor ストレージ形式を使用する場合でも、基盤となるデータが Parquet 形式の Iceberg テーブルを使用する場合でも、同じメリットが得られるということです。
フィルタの自動プッシュダウン、列メタデータ インデックス(CMETA)の枝刈り、ページスキップと非同期読み取りによる I/O レイヤの最適化、同じ拡張ベクトル化の採用など、オープン形式でもネイティブ テーブルと変わらない自動高速化の恩恵を受けられます。
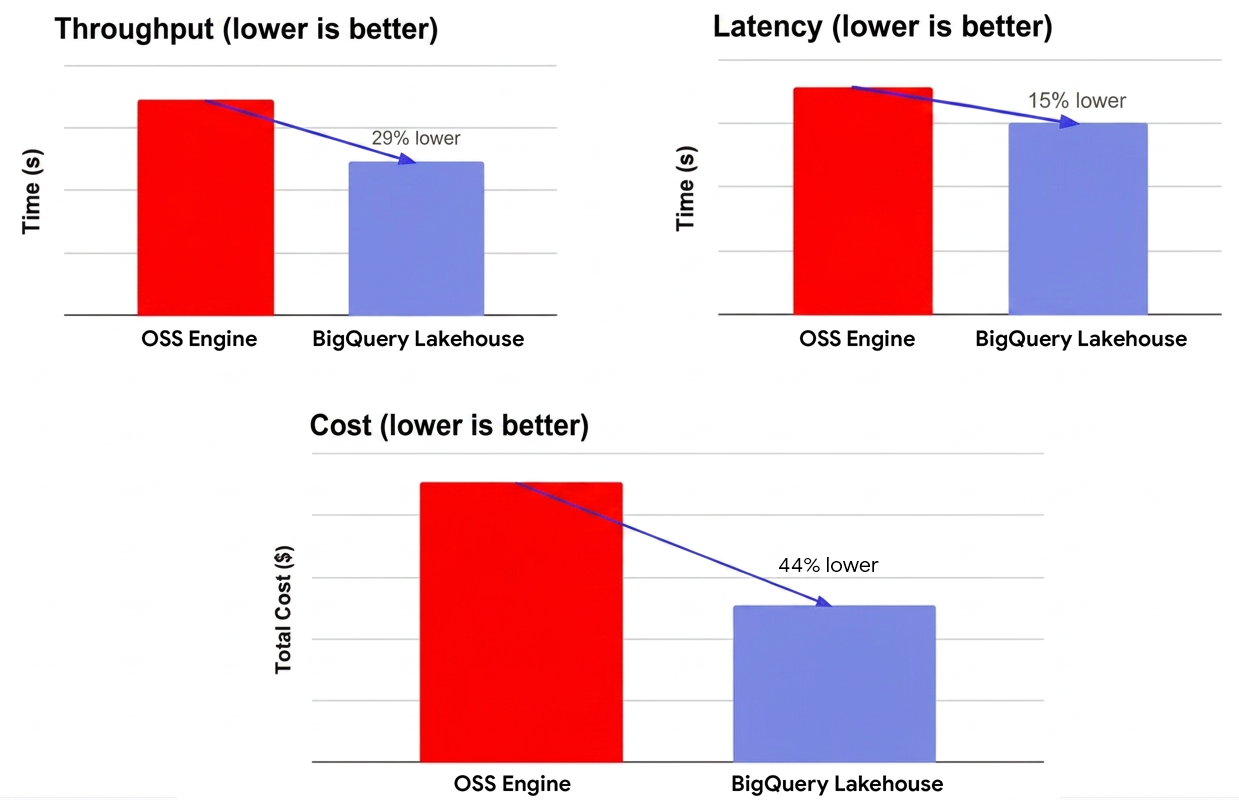
図 5. レイクハウス Iceberg テーブルでの BigQuery のパフォーマンスとコストを、TPC-DS(10 TB)から派生したベンチマークを使用して、一般的なオープンソースの分散 SQL クエリエンジンに対して社内でテスト
流動的なスケーリング: 実際の使用量のみを支払うオートスケーラー
BigQuery のコンピューティング モデルは、ノードやクラスタのスライスではなく、消費されたスロット秒に直接結びついているため、自律的なパフォーマンスの向上は直接的なコスト削減につながります。流動的なスケーリングで強化された BigQuery オートスケーラーを使用すると、コストとパフォーマンスのトレードオフを解消した優れた自動スケーリング モデルで、変動の大きいワークロードを柔軟に組み合わせて実行できます。BigQuery の流動的なスケーリングにより、消費されたコンピューティング リソース(スロット)に対して厳密な秒単位の課金が可能になり、自動スケーリング ワークロードのコストが平均で最大 34% 削減されます。
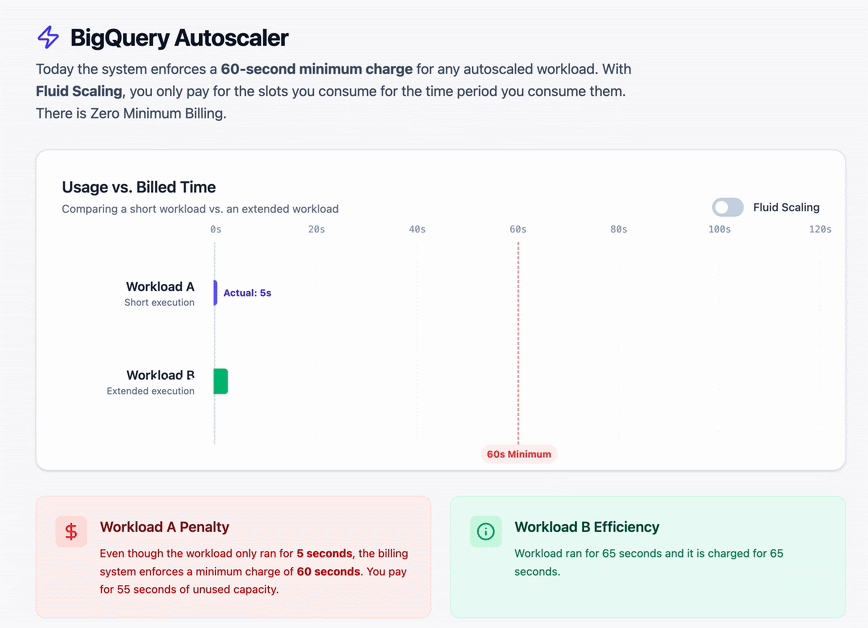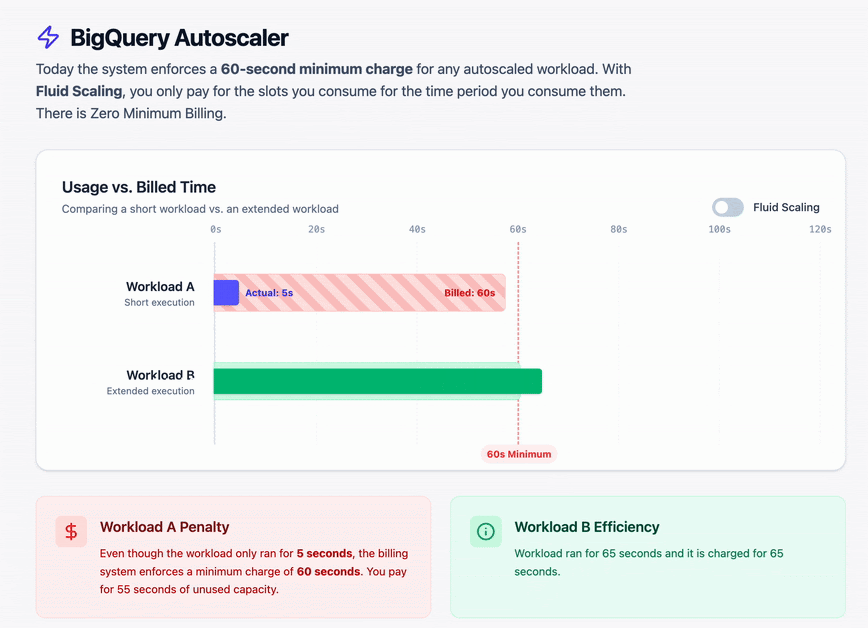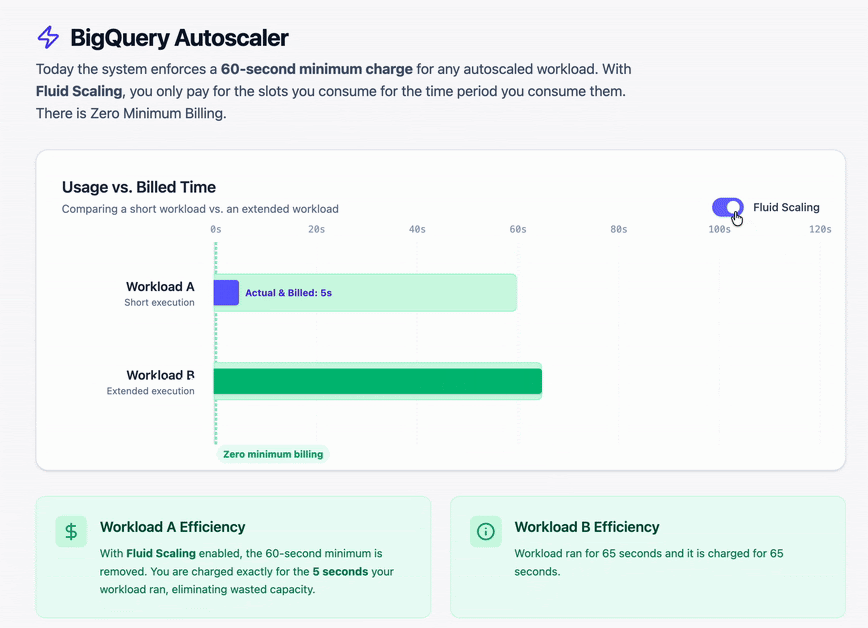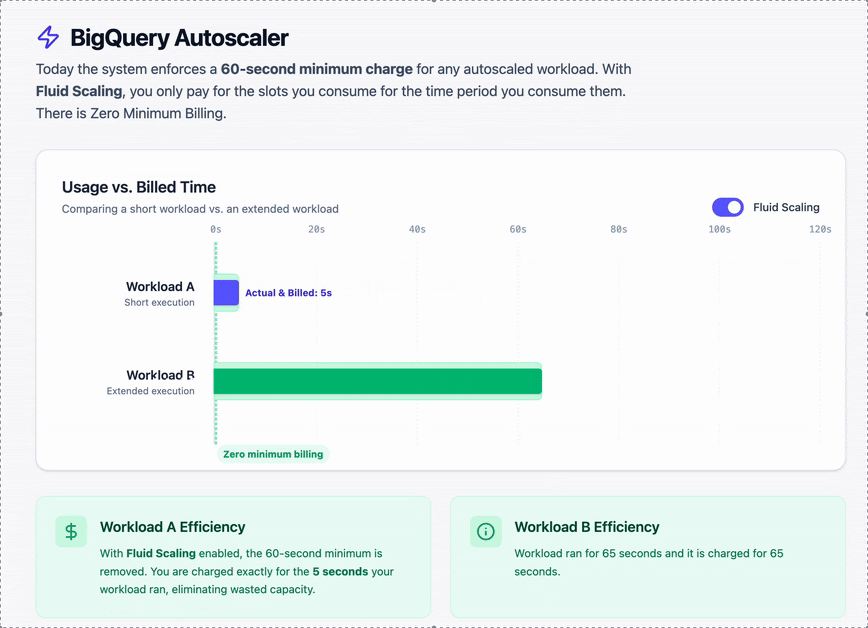
図 6. 流動的なスケーリングを可能にする拡張オートスケーラー
流動的なスケーリングがもたらすコストパフォーマンスのメリットについて、1 日 1 PB 以上のデータを処理し、月間 3 兆件を超える入札を管理する大手アドテック企業 RISE の CEO / 共同創業者である Chen Shalit 氏は次のように述べています。「広告の世界は競争が激しく、1 セントも無駄にできません。BigQuery の流動的なスケーリングにより、インフラストラクチャのコストが 25% 削減され、スロット消費をスケールしてワークフロー全体を加速できるようになりました。モデルの結果をより迅速に提供し、1 時間あたりのデータ処理スループットを向上させることで、お客様に可能な限り最新のデータを提供できるようになりました。」
エージェント時代の未来に向けた基盤
これらの自律型機能は、現在のビジネス インテリジェンス ダッシュボードや分析クエリの実行を高速化するだけでなく、最新のデータ プラットフォームの未来を支える基盤となります。AI や ML の導入が急速に進むなか、組織のワークロードはエージェント型へと移行しつつあります。
AI エージェントによるデータの扱いは、人間とは根本的に異なります。クエリのレイテンシや同時実行数(QPS)に対する要件水準は、人間のユーザーが生成するものよりも桁違いに厳しく、人間を基準に設計された従来の分析プラットフォームの限界を超えています。自律型エージェントがリアルタイムの意思決定を行うために、1 秒間に数千もの異なる秒間クエリを発行するような状況では、人間参加型のクエリ チューニングなど到底不可能です。
自己チューニングや自己学習システムといった BigQuery の差別化された機能には、回帰に対する組み込みの安全ガードレールが組み込まれています。こうした自律性が基準となることで、インフラストラクチャの手動管理、事後対応的なクエリの最適化、急増するコンピューティング費用の抑制といった作業に、貴重なエンジニアリング サイクルを浪費する必要がなくなります。その分、高度なエージェント アプリケーションでユーザーに最高のエクスペリエンスを提供するという、真に価値のある業務に時間と労力を集中させることができます。
BigQuery が TCO に与える総合的な効果: 高速化とコスト パフォーマンスのさらなる向上
履歴ベースの自己学習型オプティマイザーと、高度にスケーラブルなメタデータ プラットフォーム(CMETA)でサポートされる自動スケーリングの高度なランタイム エンジンを組み合わせることで、パフォーマンスと総所有コスト(TCO)に大きな効果がもたらされます。
まとめ
Google が目指しているのは、ユーザーの手を煩わせることなく BigQuery がクエリを自動的かつ安全に最適化することです。それにより、ユーザーが「出勤するだけで、BigQuery が前日よりも速くなっている」と感じられるような体験を提供したいと考えています。
データスキューや古い統計情報によるパフォーマンス低下の心配は無用です。どのクエリにどのプランガイドが最適か、時間帯や時期(日次、月次)に合わせて頭を悩ませる必要はなくなります。低価格なスポット インスタンスが不足して予算が足りなくなるのでは、と気をもむ必要はもうありません。組織の目標に集中するだけで、あとは BigQuery データ プラットフォームがエージェントと人間のワークロードの両方に最適なコスト パフォーマンスを自律的に提供します。特別な操作や設定は一切不要です。
BigQuery のデータと AI 機能の詳細を確認し、無料トライアルを開始しましょう。
- プロダクト マネージャー、Joe Yong
- グループ プロダクト マネージャー、Manan Goel