Data Agent Kit でエージェントを駆使した問題分析
Jeff Nelson
Developer Advocate, Google
※この投稿は米国時間 2026 年 9 月 9 日に、Google Cloud blog に投稿されたものの抄訳です。
想像してみてください。月曜の朝、出社早々、上司からチャット メッセージが入ります。曰く、「1 月の平均注文額は 7% 減だけど、総収益は横ばいだね。なんでかな?」
データ実務者であれば、このような質問が一筋縄ではいかないことは、よくご存じなのではないでしょうか。しかも、答えは単純明快ではありません。根本原因を示す単一のダッシュボードがあるわけでもありません。ウェブのログにエラーが記録されているのか。プロモーション コードの設定に誤りがあったのか。深掘りするまで皆目見当がつかないし、1 か所や 2 か所、調べただけでは答えはまず見つからないでしょう。
答えにつながる鍵は、環境内のさまざまな領域に散在しています。
-
販売履歴(注文と明細項目)はデータ ウェアハウスに保存されています。
-
有効な顧客レコードは本番環境の PostgreSQL インスタンスに保存されています。
-
マーケティング キャンペーン ルールは、オブジェクト ストア内の未加工 JSON ファイルに保存されています。
これらの情報を引き出すクエリを 1 つだけ作成するなら簡単です。実際には、同じクエリを何度も記述し、WHERE 句を調整したり、サブクエリを追加したりして、答えを見つけ出す必要があります。1 つのシステムが終わったら次のシステムに移動し、別の方法で再びクエリを行います。気づけばブラウザのタブが 10 個も開いていて、1 つの質問に答えるだけで丸一日がつぶれてしまいます。
Data Agent Kit
まさにこのような問題を解決するために構築されたのが、Data Agent Kit です。MCP サーバーとエージェント スキルを組み合わせた Data Agent Kit を使用することで、データ デベロッパーは IDE からデータ ワークフローを実行できるようになります。VS Code フォーク(Antigravity IDE、Cursor)の拡張機能としても、他のツール(Antigravity 2.0、Antigravity CLI、Claude Code、Codex)のプラグインとしても利用できるため、IDE を離れることなく、答えを見つけ出せます。
Data Agent Kit は、次の 2 つのコア メカニズムを基盤としています。
-
Model Context Protocol(MCP): エージェントをツール、データベース、リモート クラウド インフラストラクチャに接続するオープン スタンダード。
-
エージェント スキル: AI エージェントに特定スタックとのやり取りの方法を教え、エージェントの知識を補強する Markdown ファイル。
Data Agent Kit を使用すると、SQL スニペットを生成してコンソールにコピーして貼り付ける代わりに、エージェントがクエリを実行して結果を読み取ることができます。
これを平均注文額(AOV)のシナリオに適用したら、どのようになるのか見てみましょう。この場合、データ ウェアハウスには BigQuery が、Postgres インスタンスには Cloud SQL が相当し、キャンペーン ルールは Cloud Storage に保存されています。
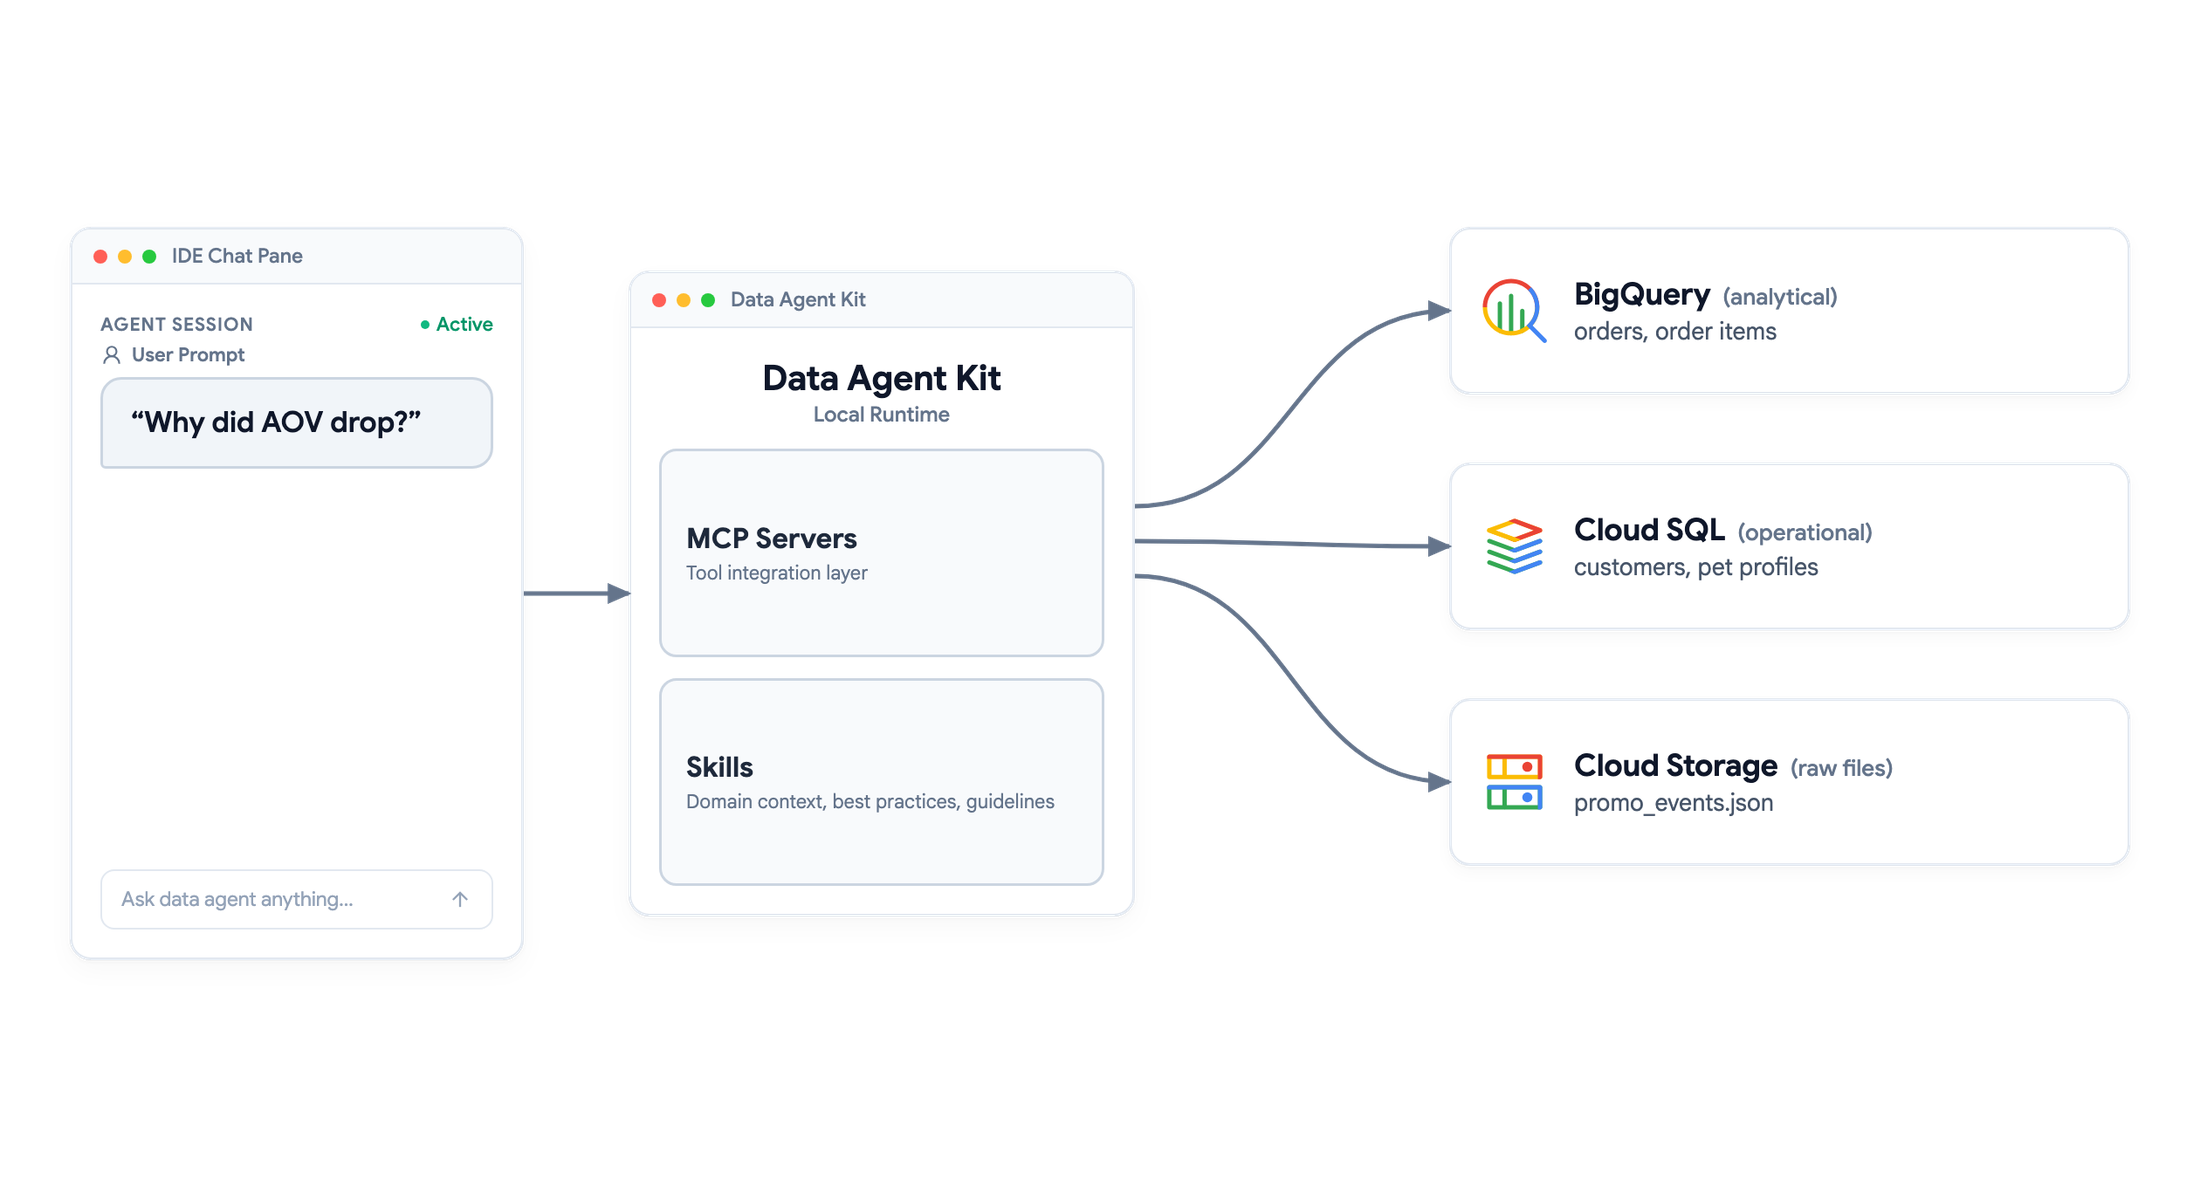
Data Agent Kit のサンプル アーキテクチャ
事象を把握する
調査は、まず IDE のチャットペインで、次の自然言語プロンプトを使用して、基本的な数値の確認から始めます。
結果を確認する
エージェントがプロンプトを処理し、関連スキルを呼び出して、データのクエリを開始する準備をします。しかし、まだ実行はせず、IDEを一時停止して必要な MCP ツール(execute_sql_readonly など)の使用許可を求めます。ユーザーは、監査のために 1 回だけ許可することも、[常に許可] を選択してワークフローを継続することもできます。許可すると、エージェントはクエリを送信します。
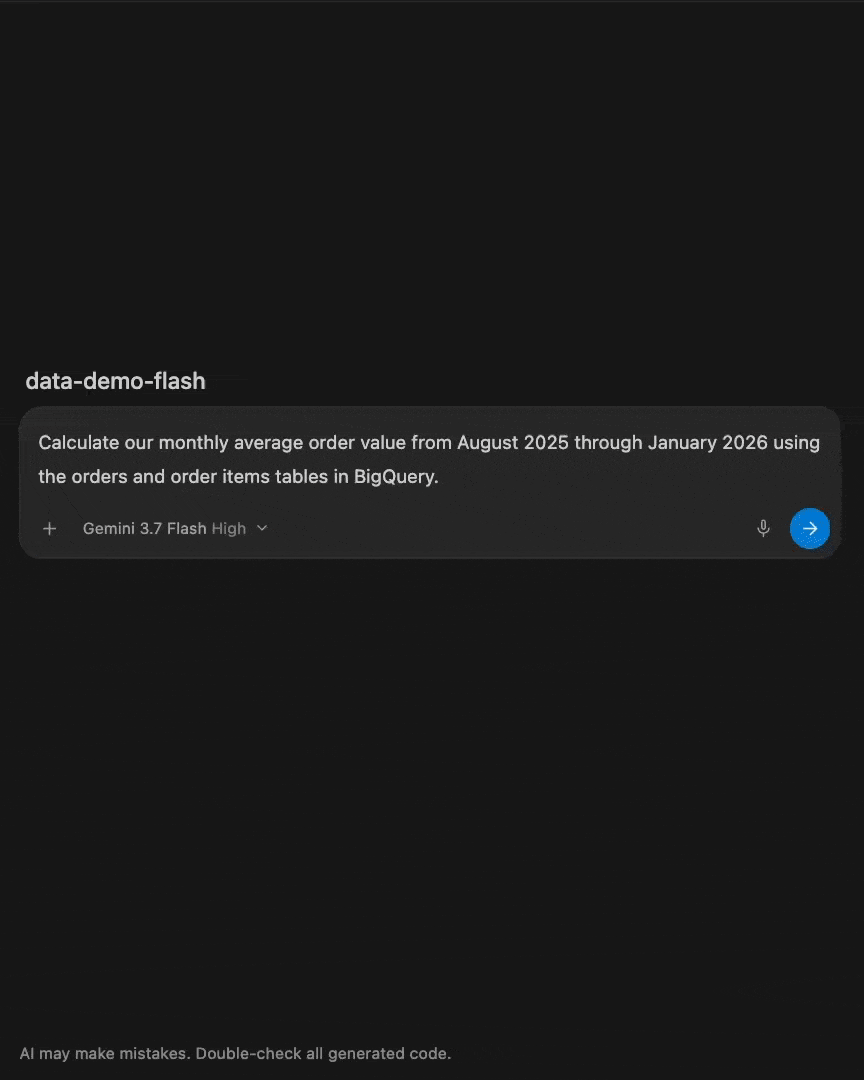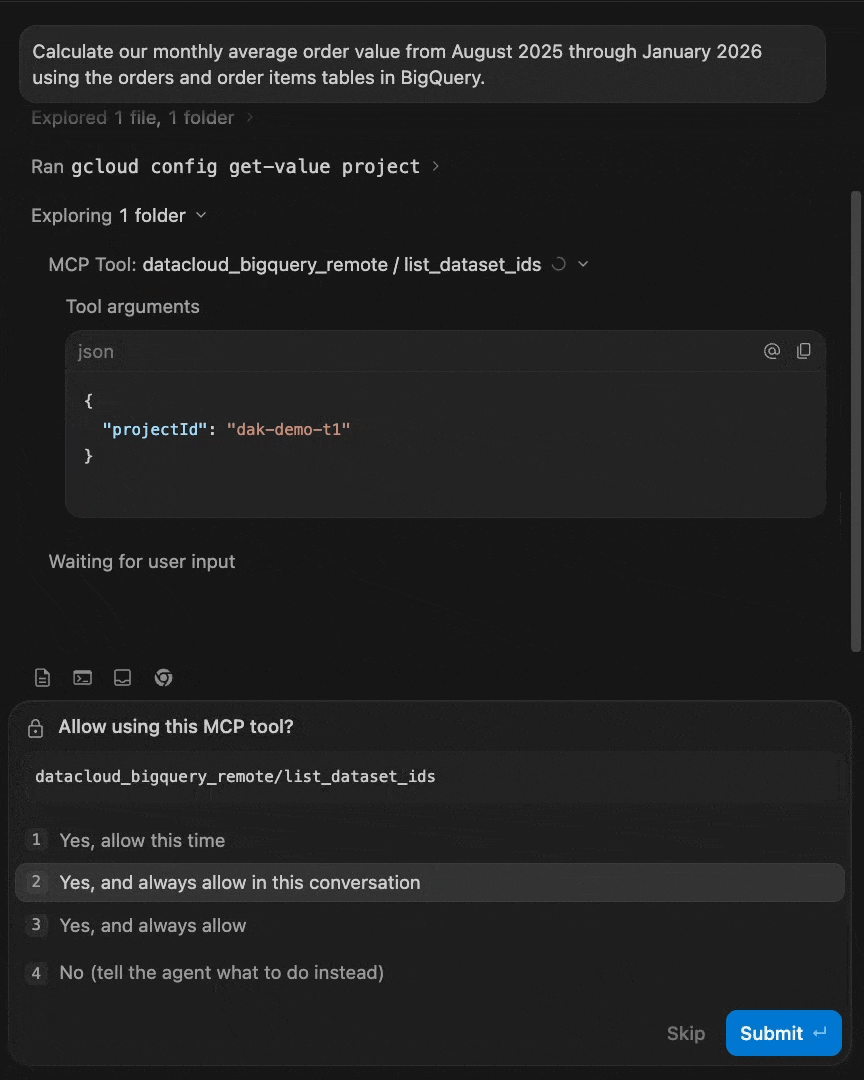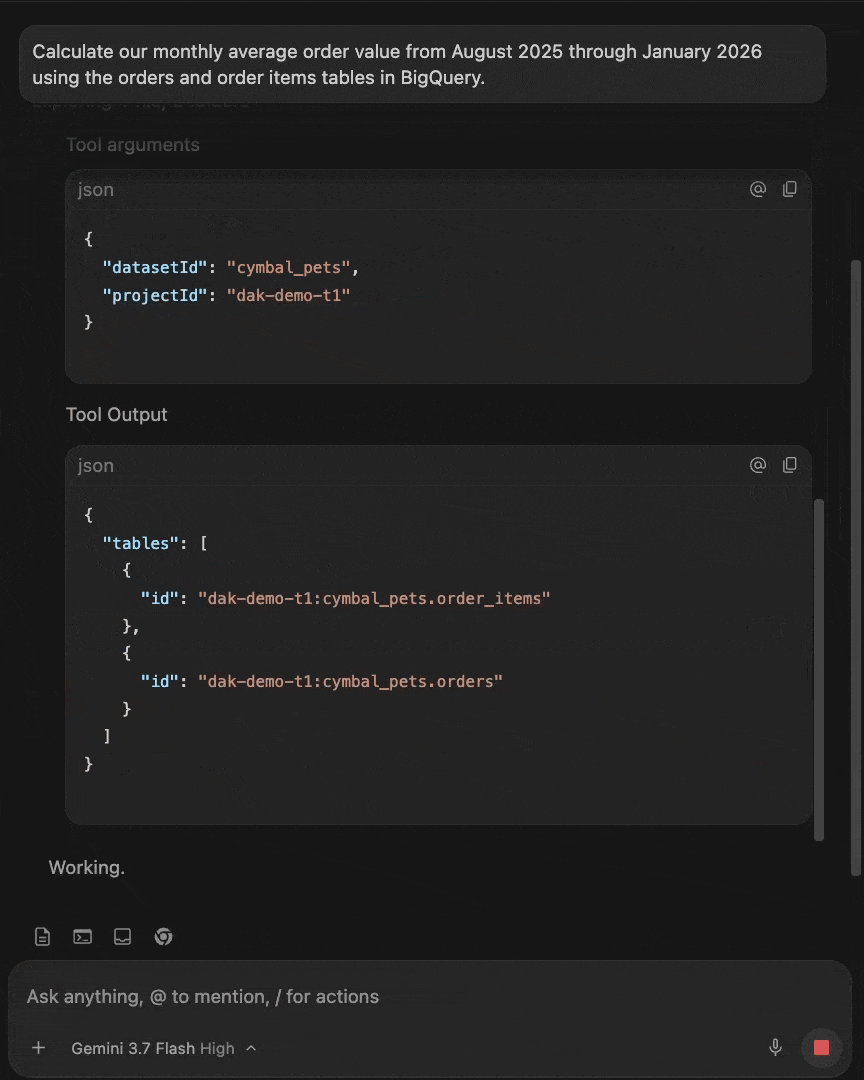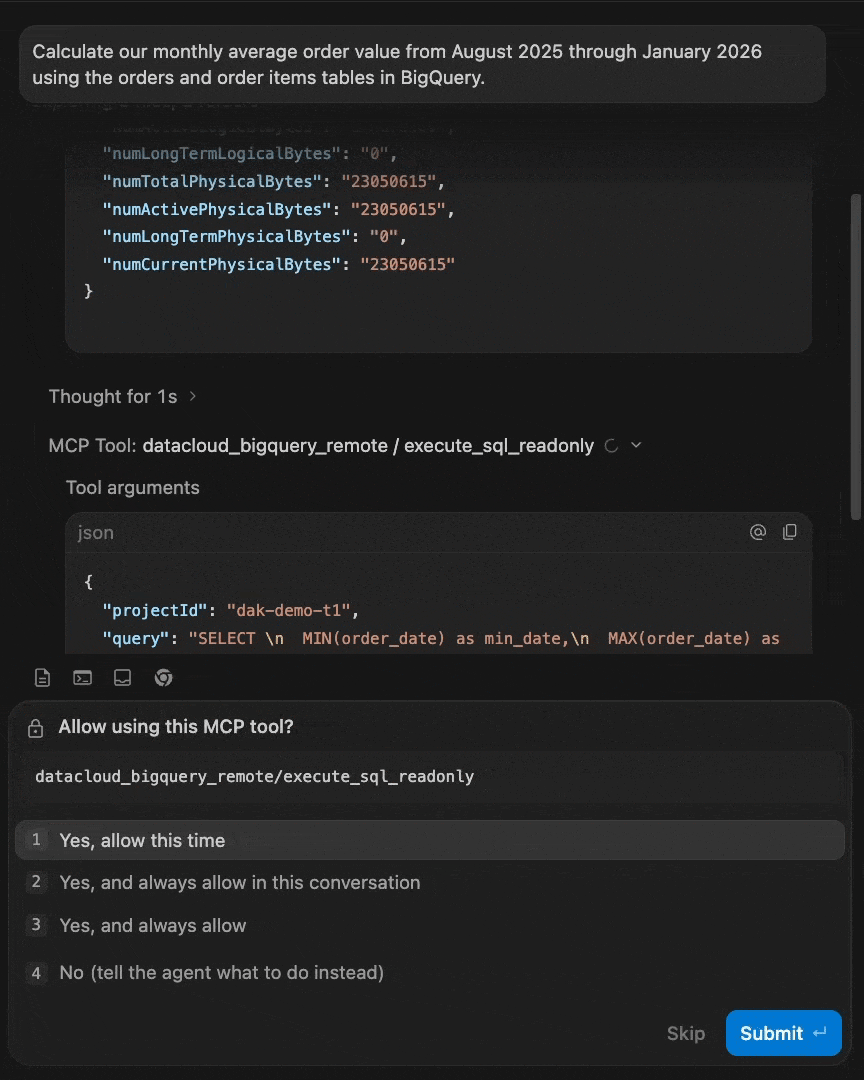
チャットでエージェント スキルと BigQuery MCP を呼び出す
エージェント IDE では、実行トレイルを検査して、各 MCP ツール呼び出しの記録や BigQuery に送信された未加工 SQL などを確認できます。エージェントが生成したコードは人間の目で再確認する必要がありますが、不慣れなスキーマに対して一からクエリを記述するの比べれば、大幅な時間の節約になるはずです。
数値を深掘りする
数値を見ると、平均注文額(AOV)は 8 月から 12 月まで 110 ドル前後を維持していましたが、1 月には 103 ドルに減少しています。この理由を調べるために、エージェントにドリルダウンを依頼します。
結果は、ビジネスの衰退ではなく、平均値の偏りを示しています。オンライン注文とオフライン注文は約 110 ドルで堅調に推移していますが、1 月に B2B-Wholesale という新しいチャネルが登場し、その AOV はわずか 75 ドルほどでした。注文が減少したのではなく、プロダクト構成の変化が AOV の見た目を押し下げました。
Cloud SQL に調査を広げる
AOV の低下につながった要因がわかりました。次に、卸売業者のバイヤーの実体を把握する必要があります。顧客レコードは Cloud SQL Postgres の運用データベースに保存されています。同じチャット スレッドで、次のように続けましょう。
エージェントは MCP を Cloud SQL MCP に切り替え、customers テーブルを調査します。100 件の卸売アカウントはすべて、過去 30 日以内に作成された新しい事業体です。12 月には、これらの事業体はいずれも存在していませんでした。
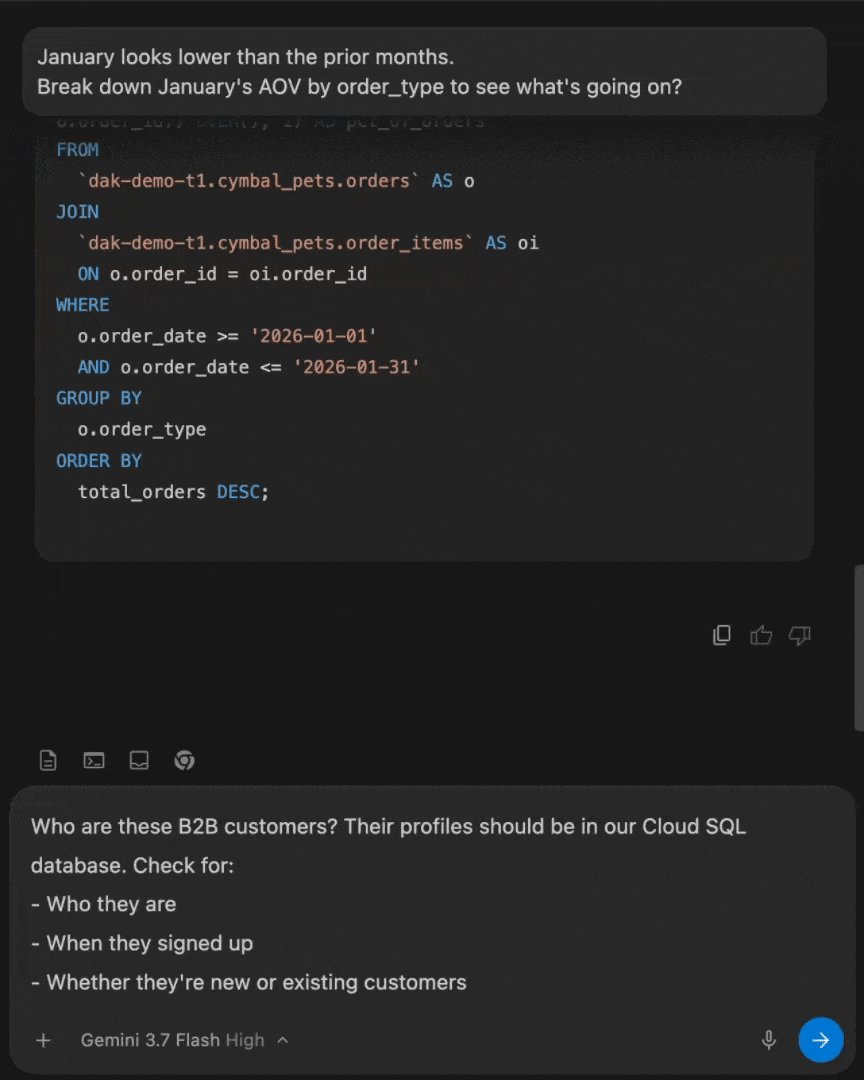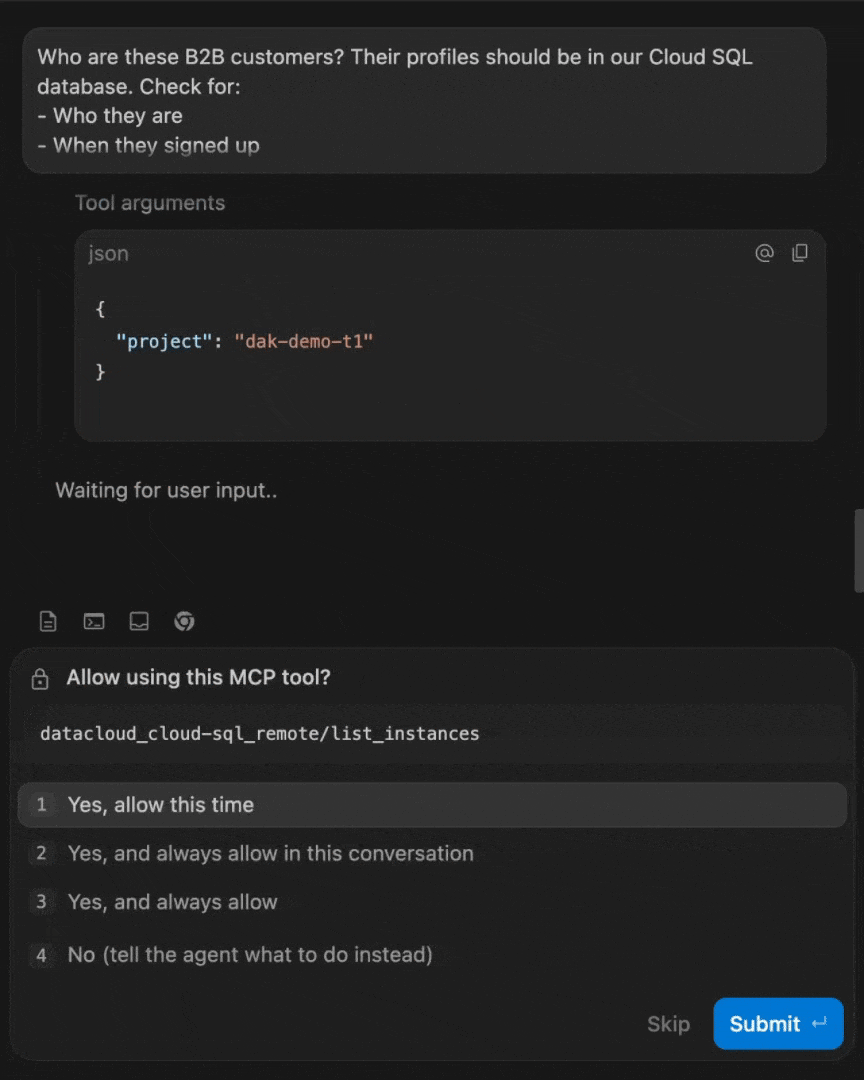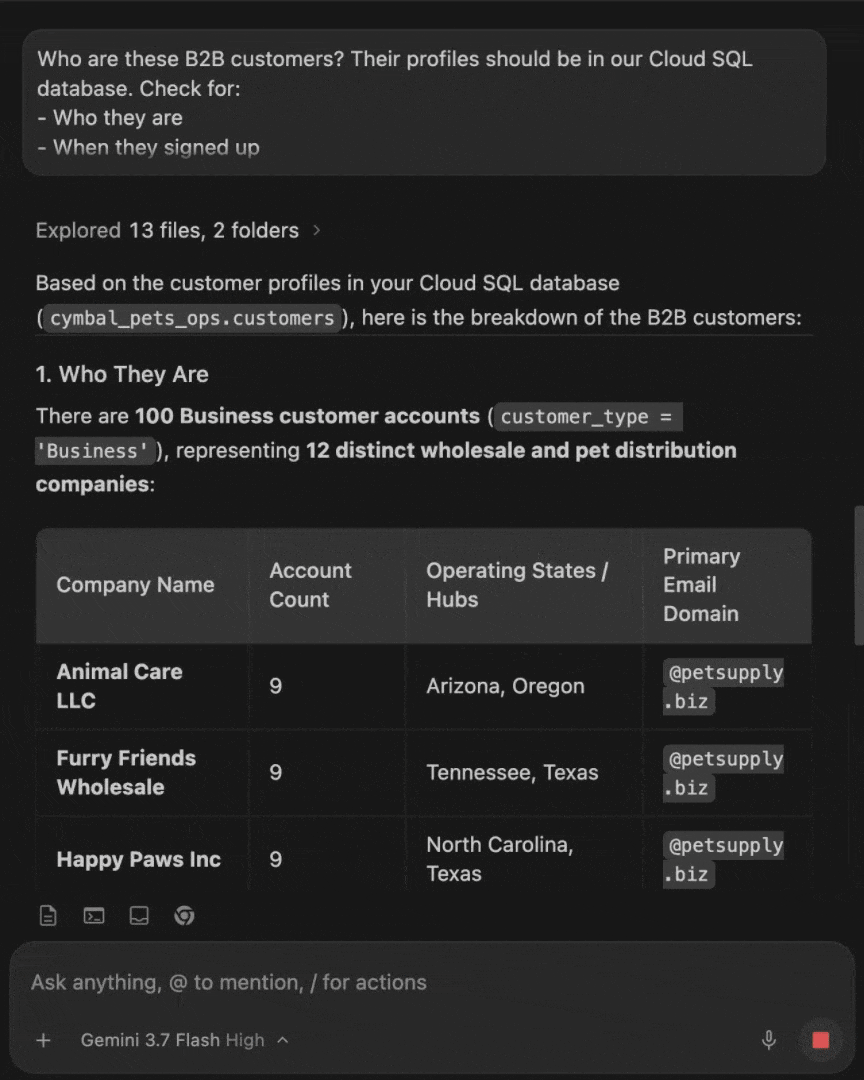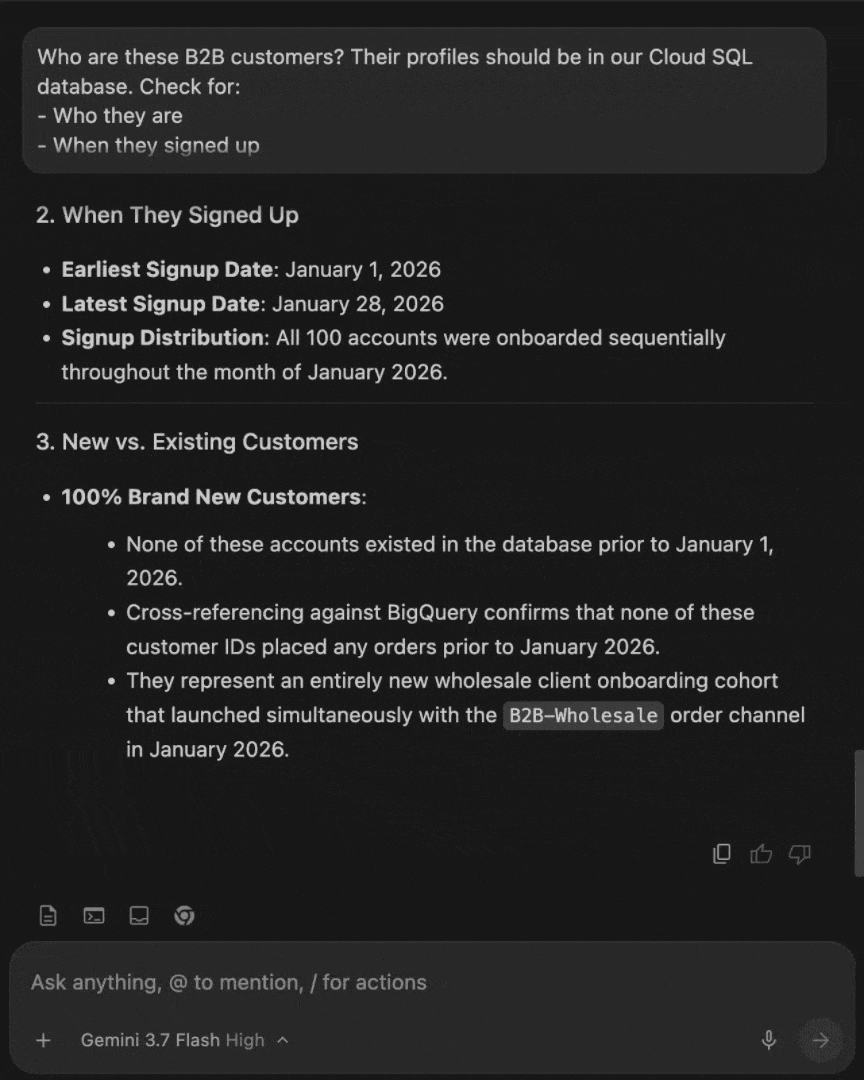
Cloud SQL で運用顧客レコードをクエリする
コードを探求する
BigQuery で B2B 注文を簡単に確認すると、92% が promo_code = BIGORDER25 を適用していることがわかります。次に、エージェントにそのコードを追跡してキャンペーン ファイルを確認するよう依頼すると、エージェントは Google Cloud Storage MCP サーバーを使用してファイルにアクセスします。
マーケティング キャンペーンでは、25% 割引コードにより低価格の卸売注文が大量に発生し、総収益は横ばいだったものの、総合的な AOV は減少しました。
このように、エージェントは、1 回のチャット セッションで、分析データ(BigQuery)、運用記録(Cloud SQL)、非構造化メタデータ(Cloud Storage)をクエリして、根本原因を特定しました。
調査結果を報告する
調査が終わったので、上司に短いエグゼクティブ サマリーを提出するようエージェントに指示します。
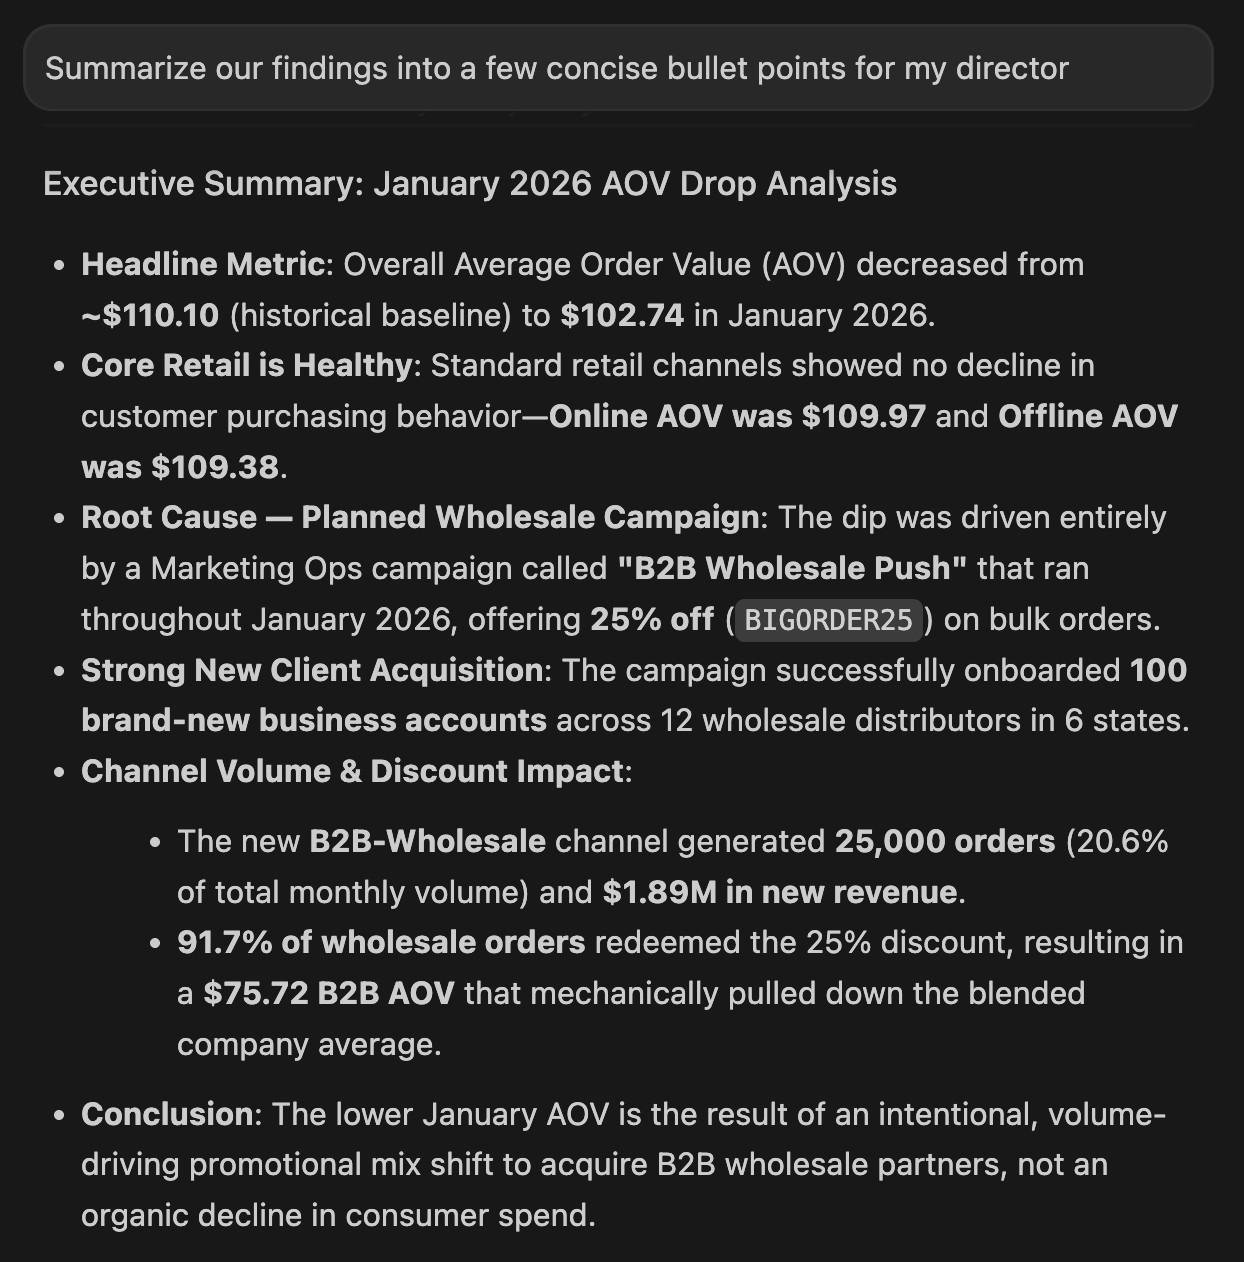
エージェントが生成したエグゼクティブ サマリー
これで完了です。IDE から直接、自然言語のプロンプトをいくつか入力するだけで、上司からの一筋縄ではいかない質問に答えることができました。
しかし、このような根本原因の分析作業は、日常業務のごく一部であり、その都度、時間を費やすわけにはいきません。次にまた作業が必要になったときに、同じプロセスを繰り返すのは非効率です。代わりに、この調査を再現可能なデータモデルに変換すると便利です。
再現可能なパイプラインを構築する
エージェントに、アドホック分析を永続的な dbt プロジェクトに変換するよう依頼することができます。AOV はペット関連商品の平均注文額なので、ここでは顧客のペット プロファイルを分析に組み込みます。
エージェントは、1 つのプロンプトから dbt-bigquery を使用して仮想 Python 環境を作成し、プロジェクト モデルとテストを記述します。しかし、dbt build は、一意性テストで order_id の重複が検出され、失敗に終わります。
これは、顧客によっては複数のペットを飼っている場合があるためです。モデルの最初のバージョンでは、これらのプロファイルを各注文に直接関連付けたため、3 匹のペットを飼っている世帯からの注文は 3 行になりました(一意ではありませんでした)。
エージェントは自身のターミナル出力を読み取り、失敗を検出します。その後、dbt ロジックを書き換え、ビルドが成功するまで再実行を繰り返します。
これは、エージェント ワークフローに関して特記すべき点です。エージェントは大量のコードを記述できますが、パイプラインへのデータ品質チェックの適用は不可欠です(幸い、エージェントはそれも記述できます)。
次に上層部から平均注文額の変動理由を尋ねられたときには、dbt モデルが回答を準備してくれます。
まとめ
エージェント IDE を使用すると、ウェアハウス、データベース、オブジェクト ストア、ターミナルを行き来する必要がなくなります。
MCP などのオープン スタンダードと、柔軟な構成と編集が可能なエージェント スキルを組み合わせることで、Data Agent Kit は質問と回答をスムーズに連動させて問題解決へと導きます。不慣れなスキーマを調べたり、多様なコードを使い分けたりすることはもちろん、これまで何度も記述してきた結合の生成も、これからはすべてエージェントに任せられます。エージェントが行う調査の指揮をするのが、あなたの役目です。
実際に試す
Data Agent Kit は現在プレビュー版で提供され、Antigravity(2.0、CLI、IDE)、Claude Code、Codex、Cursor、その他の一般的なツールでネイティブに動作します。
-
シナリオを試す: Data Agent Kit と Antigravity IDE を使用した分析の Codelab で、詳しい設定手順を確認する。
-
ドキュメントを読む: Google Cloud Data Agent 拡張機能のドキュメントで詳細を確認する。
-
プラグインを試す: GitHub のオープンソース リポジトリでスキルとツールを確認する。
- Google、デベロッパー アドボケイト、Jeff Nelson