BigQuery ObjectRef の一般提供を開始: 会話分析用のマルチモーダル データ プラットフォームをすべて SQL で構築
Gaurav Soni
Engineering Manager
Jamy Su
Product Manager
※この投稿は米国時間 2026 年 10 月 22 日に、Google Cloud blog に投稿されたものの抄訳です。
データ サイエンス、データ エンジニアリング、ML を担当する各チームにとって、画像、動画、音声、ドキュメントなどの非構造化データの価値を引き出すということは、これまで、サイロ化されたデータ パイプラインを管理することを意味していました。構造化データと非構造化データを別々に、さらには、分析と AI / ML のユースケースを別々に扱う必要があると考えられてきました。たとえファイルが Cloud Storage 内にあっても、推論を実行するには外部の ML ワークロードをオーケストレートする必要があり、その後、構造化された推論出力を再度データ ウェアハウスに結合させるという、複雑で脆弱な課題に取り組まなければなりません。この事後的なデータ結合は、運用上のオーバーヘッドを増大させるばかりか、データベースの整合性も危うくします。
この問題を解決するために、このたび、BigQuery の ObjectRef とマルチモーダル データ分析が一般提供(GA)となり、BigQuery が包括的なマルチモーダル エージェント データ プラットフォームとして確立されました。
ObjectRef を使用すると、Cloud Storage と分析エンジンのギャップを BigQuery でネイティブに埋めることができます。非構造化データを ObjectRef 列としてネイティブに取り込み、従来のリレーショナル データベースの構造化データ列と並列で扱うことが可能になったのです。会話分析において、単一の SQL クエリまたは自然言語クエリでマルチモーダル、複数列の入力を Gemini モデルに直接受け渡せるので、スタンドアロン モデル API と比較しても大きなメリットが得られます。BigQuery AI、BigQuery の会話型分析、そして Gemini Enterprise で ObjectRef を使用できるようになったことで、Cloud Storage のファイルを、構造化データベースの豊富なコンテキストや、メタデータ、タイムスタンプ、カスタム エージェントへの指示などと簡単に組み合わせることができます。
これにより、完全なサーバーレス コンピューティング、低い総所有コスト、大規模な処理が可能な組み込みの推論といった、BigQuery ならではの強みを活用しながら、非構造化から構造化、非構造化から非構造化、そしてマルチモーダルからマルチモーダルへの高度なパイプラインをフルに構築、実行、管理できるようになりました。しかも、これらに個別のコンピューティング クラスタは必要ありません。重要なのは、ObjectRef を非構造化オブジェクトと同じ行に保存することで、抽出された特徴とアノテーションを非構造化オブジェクト自体と直接組み合わせることができる点です。この結合されたデータを会話分析と AI エージェントで直接使用することで、非構造化ファイルを純粋な構造化形式に変換する際に発生しがちな、データやコンテキストのニュアンスの喪失を回避できます。多くのお客様はすでにこのアプローチを使用して、マルチモーダル ベクトル検索用のエンベディングを生成し、生成 AI を使用して大規模な分類を実行し、膨大なドキュメントやメディアのアーカイブから正確なデータと特徴を抽出しています。これらは、以下のように、すべて標準 SQL で実行できます。
ObjectRef で非構造化データも構造化データ同様に処理
ObjectRef は、BigQuery の外部オブジェクトを参照する(ポインタとなる)組み込みの事前定義された STRUCT データ型です。
これらのポインタを従来の構造化データの列とともに標準の BigQuery テーブルにネイティブに保存することで、BigQuery は非構造化ファイルを第一級オブジェクトのデータとして扱います。さらに、このアーキテクチャは独立したデータ ライフサイクルをサポートします。これは、GCS データと BigQuery テーブルが、他のシステムの基盤となるデータに影響を与えることなく、独立して変更できることを意味します。
このアプローチは、複数のデータペルソナに対し、大きなメリットをもたらします。
- ゼロコピー アーキテクチャ: 大量のメディア ファイルを Cloud Storage に安全に保管し、BigQuery で即座にクエリを実行できます。データ グラビティを尊重し、コストのかかるデータ重複を回避できます。
- SQL と Python の相互運用性: 標準 SQL または BigQuery DataFrames を使用して非構造化データをクエリできます。重要なのは、ObjectRef を BigQuery Python UDF に受け渡すことができる点です。これにより、OpenCV などのオープンソース Python ライブラリをデータに直接適用し、データを移動することなくカスタム ロジックを実行できます。
- 独立したライフサイクルとバージョニング: ObjectRef は、特定の GCS 世代番号を追跡することで、推論の再現性を確保します。基盤となる GCS ファイルが変更された場合でも、クエリは、行が書き込まれたときに存在していたファイルの正確なバージョンを参照できます。
- ガバナンスの統一: BigQuery の既存のセキュリティ ポリシーと IAM 制御を使用して、構造化された列とそれに関連する非構造化ファイルの両方へのアクセスを保護、監査、共有できます。
SQL で完全な忠実度の ETL を構築
ObjectRef のプレビュー版をリリースして以来、ユーザーの間で、SQL のみで完全な忠実度の ETL パイプラインを構築する、盤石で非常に効果的なパターンが醸成されています。
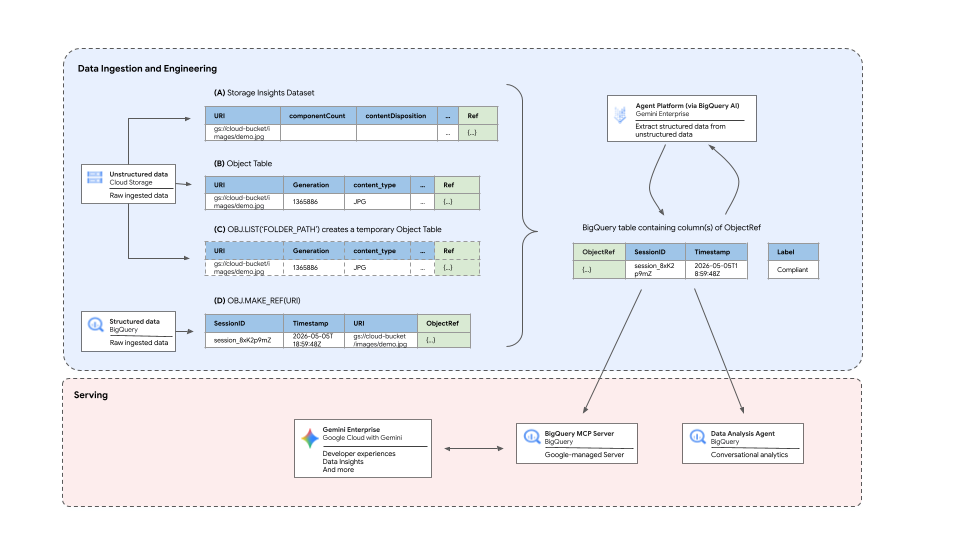
データや ML の担当チームは BigQuery のサーバーレス アーキテクチャを活用して、AI / ML をデータ環境に直接統合できます。データの移動や推論の処理のために個別のコンピューティング クラスタを用意する必要はありません。GCS 内の非構造化データを標準の BigQuery 列として管理することで、べき等性のあるパイプラインの構築、再現性の確保、シームレスなバックフィルの実行といったデータ エンジニアリングの基本的なベスト プラクティスを、画像、動画、音声、ドキュメントに直接適用できます。
このようにデータを盤石の状態で準備できたら、いつでも BigQuery 内で Gemini を使用して、完全な忠実度の ETL を実行できます。元の ObjectRef を同じ行に固定したまま、特徴を抽出して非構造化データにアノテーションを付けることで、2 層式の分析が可能になります。つまり、構造化された出力が高速フィルタリング、レポート、BI ダッシュボードを可能にし、アタッチされた非構造化オブジェクトは、コンテキストを重視した詳細な推論に利用できます。たとえば、顧客との通話録音のアーカイブから感情スコアとトピックタグを抽出し、BI ダッシュボード(構造化レイヤ)でリスクのある顧客アカウントにすばやくフラグを立てることも可能です。同時に、エスカレーション プロセスを評価する会話分析エージェントは、元の音声ファイルにシームレスにフォールバックして、発信者とカスタマー サービス担当者のやり取りを分析できます。これにより、非構造化から構造化への ETL パイプラインで発生しがちな、重要なニュアンスの喪失を防ぐことができます。
業界リーダーの声(実証済みユースケース)
「Snap では、コミュニティの安全を最優先に考えており、コミュニティ ガイドラインに違反するコンテンツをユーザーから遮断できるよう取り組んでいます。そこで、公開投稿のサンプルを定期的に審査しているのですが、ObjectRef と BigQuery AI の活用により、単純なランダム サンプリングから事後層別サンプリングへの移行を実現しました。この移行により、人間による審査プロセスの効率が向上し、時間と労力が節約できて新しいワークフローや既存ワークフローの拡充に再投資できるようになったため、有害リスクのコンテンツを検出して対処する能力がさらに向上しました。」 - Snap、データ サイエンティストCarlos Ortiz 氏
BigQuery ObjectRef は、すでにプレビュー段階において多岐にわたる重要なワークロードに導入されています。お客様は、これらの試験運用パイプラインを本番環境に移行し、非構造化データを実用的な構造化されたインサイトに変換することに成功しています。代表的な事例をいくつか挙げます。
- コンテンツの管理: 各種オンライン プラットフォームが、BigQuery を活用してマルチメディア アセットを標準テレメトリー データとともに単一パイプラインに統合し、管理機能と安全性を抜本的に向上させています。
- プロアクティブな脅威検出: 多くの企業では、セキュリティ チームが BigQuery を使用して、ウェブの視覚的要素と構造的要素をネットワーク ログとともに分析し、脅威をプロアクティブに特定する仕組みを劇的に進化させています。
- インベントリ コンプライアンス: 各種オンライン小売業者が、膨大な画像リポジトリからテキストとコンテキストを直接抽出して、規制やブランド コンプライアンスに関わる問題の大規模な自動フラグ付けを実現しています。
- カスタマー エクスペリエンスの向上: サービス指向の企業は、BigQuery AI を使用してサポート エージェントと顧客の音声によるやり取りを分析し、顧客の感情評価をサービスの向上につなげています。
一般提供で追加された新機能
一般提供リリースでは、お客様の幅広いユースケースのサポートに重点を置き、デベロッパー エクスペリエンスを効率化しました。
- 柔軟な認証:
- 一般提供(GA)では、ObjectRefs のエンドユーザー認証情報(EUC)サポートが導入されました。ユーザーが自分の IAM ID を使用して非構造化データを直接すばやくクエリ、探索できるアドホック分析が可能になりました。
- プレビュー版では、非構造化ファイルに対してクエリを実行するには、ObjectRef 用に明示的な BigQuery 接続の設定が必要でした。この接続は、サービス アカウント主導の堅牢な本番環境パイプラインの推奨ベスト プラクティスとして引き続き完全にサポートされますが、追加設定の手間を省くため、GA ではアドホック分析サポートが追加されました。
- Cloud Storage メタデータの統合サポート: 非構造化データのメタデータは、Google Cloud のさまざまな場所に存在します。ObjectRef は、これらのデータソースをすべてネイティブにサポートするようになりました。メタデータが現在 BigQuery オブジェクト テーブルにあろうが、Cloud Storage Insights データセット、あるいは標準 BigQuery テーブル内の生文字列 URI として存在していようが、ObjectRef をシームレスに作成、管理でき、基となるデータを分析することができます。
- 比較分析のための配列サポート: 配列に含まれる ObjectRef の処理をネイティブにサポートできるようになりました。これにより、複数ドキュメントを相互比較したり、一連の画像を分析したり、1 回のセマンティック呼び出しで複数アイテムをバッチ処理したりするなど、これまでできなかったタイプのワークロードを処理できます。
実用例: エンドツーエンドのマルチモーダル分析
これらの GA アップデートの機能性を確認するために、簡素化された SQL 演算子を使用して実践的なマルチモーダル パイプラインを構築する方法を見てみましょう。
- 完全な忠実度の ETL: コールセンターの音声分析
カスタマー サービスの通話分析において、従来は、音声ファイルを文字起こしと自然言語処理のための専用クラスタに移動する必要がありました。しかし、ObjectRef を使用すると、音声ファイルを解析して構造化されたビジネス インテリジェンスを抽出し、標準的なリレーショナル データベースの列として直接追加できます。
GA で追加された OBJ.MAKE_REF() 関数を使用して、生文字列 URI から音声形式を自動的に検出し、一般的なユースケースに BigQuery のマネージド AI 関数を適用できます。たとえば、AI.CLASSIFY() を使用して顧客の通話タイプを分類することができます。BigQuery は AI 関数向けに最適化モードをデフォルトで使用して、消費されるトークン数を削減します。
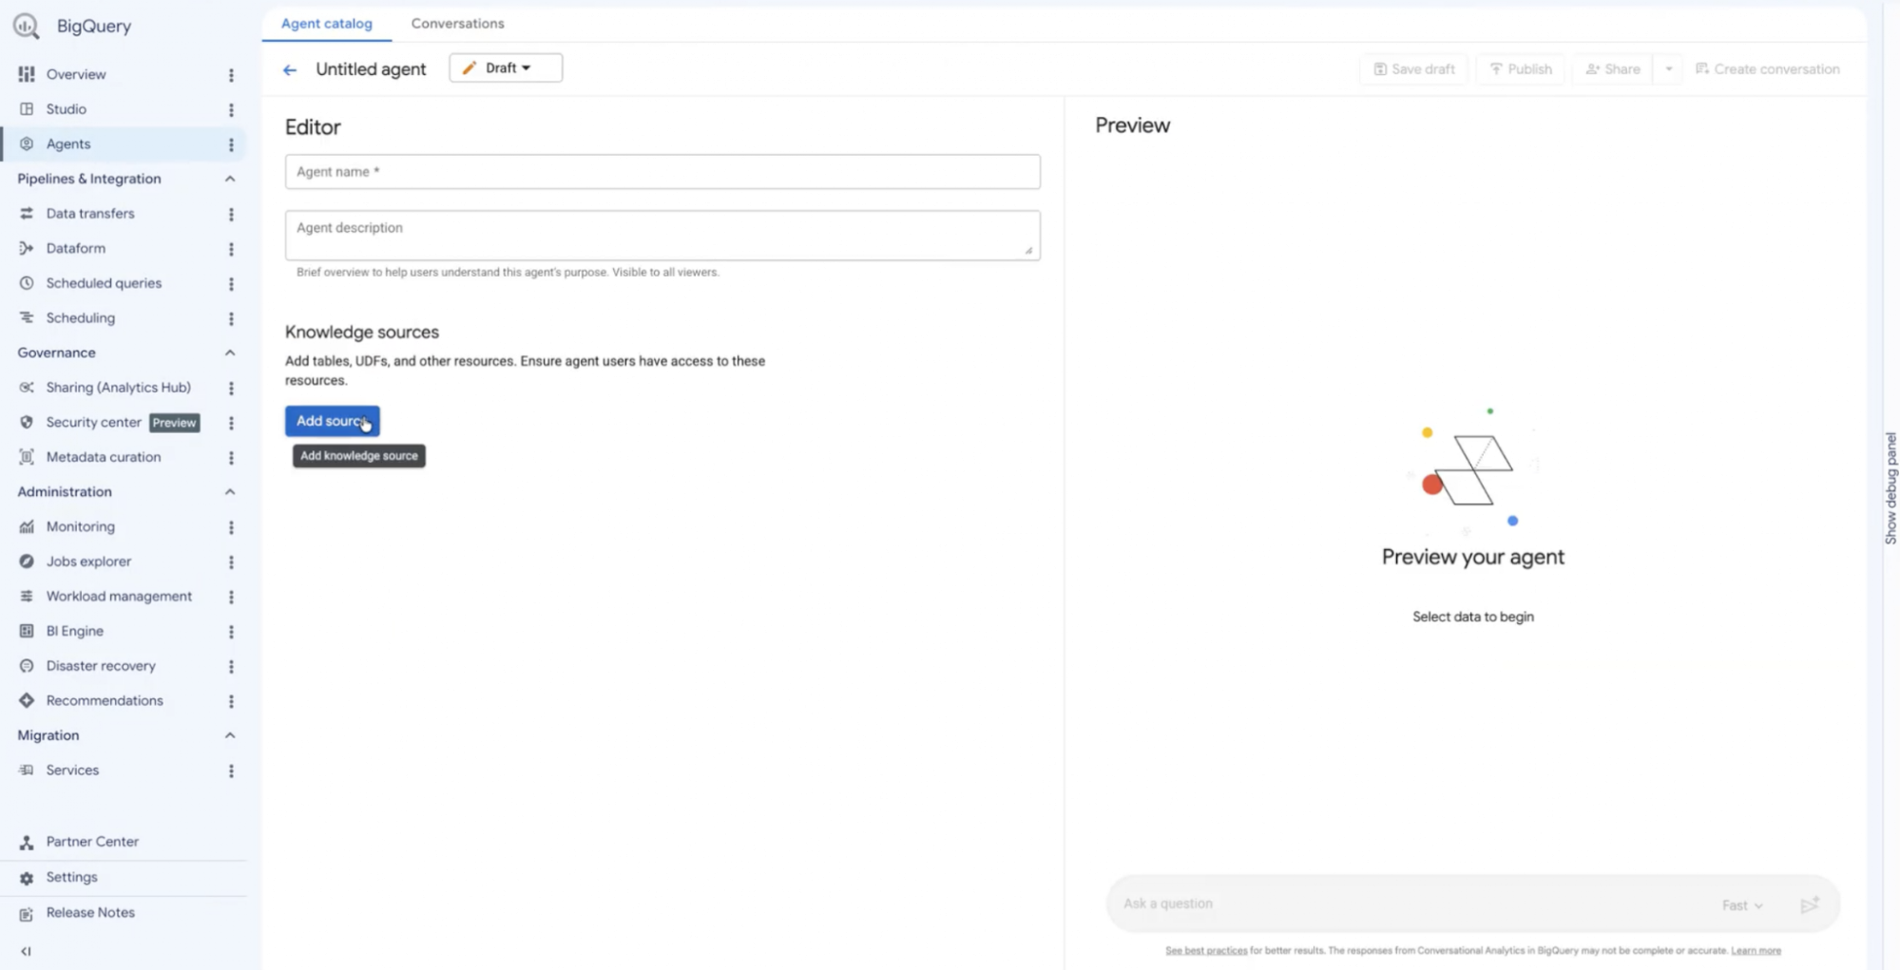
このテーブルは、BigQuery 会話型分析エージェントのマルチモーダル データソースとして機能します。エージェントは自然言語クエリを SQL に変換しますが、追加情報が必要な場合は BigQuery AI 関数を使用して音声ファイルを分析します。
2.大規模な生成 AI フィルタリング: プロダクト コンプライアンス
データ エンジニアは、画像やドキュメントの内容に基づいて大規模データセットのフィルタリングを頻繁に行う必要があります。そこで GA では、重い生成クエリを実行してテキスト出力を解析する代わりに、WHERE 句で標準 SQL とともに宣言型の AI.IF() 演算子をネイティブに使用できるようになりました。デフォルトの最適化モードでは、消費されるトークンの数が削減され、ワークロードもさらに最適化されます。
3. 複数オブジェクトの推論: プロアクティブな脅威検出
GA で配列がネイティブにサポートされたことで、Gemini を 1 度だけ呼び出して ObjectRef の配列を受け渡し、複数のファイルを同時に分析できるようになりました。
これにより、複雑な比較ロジックを SQL で直接実行することができます。たとえば、セキュリティ チームは、公式ログインページのスクリーンショットと、新たに発見された不審なウェブページのスクリーンショットを同時に Gemini に渡すことで、フィッシングの検出を大規模に実施できます。
ObjectRef を使用して今すぐ分析を開始する
BigQuery ObjectRef は、BigQuery のすべてのエディションとオンデマンド料金ティアで一般提供されています。
現在 Cloud Storage ファイルで ML 推論を実行するためだけに断片化された複雑なインフラストラクチャを管理されているのなら、ぜひ統合を検討することをおすすめします。AI はストレージに直接組み込めます。既存のデータ エンジニアリング手法を活用して、堅牢でスケーラブルかつ安全なマルチモーダル分析パイプラインを BigQuery 内に直接構築しましょう。
ObjectRef およびマルチモーダル分析のご利用を開始するには、以下のリソースをご覧ください。
- ハンズオン チュートリアルで、合成データを使用して画像キャプションを生成し、商品カテゴリを割り当てる方法をご確認ください。
- Cloud Next のライブデモで、非構造化データと構造化データの統合と、LLM を使用したテキストの生成とベクトル検索の実行をご覧ください。
- BigQuery ドキュメントで ObjectRef の操作方法をご確認ください。
- エンジニアリング マネージャー、Guarav Soni
- プロダクト マネージャー、Jamy Su