[운영관점 Spanner 시리즈] HarbourBridge와 데이터 검증 툴을 활용하여 Cloud Spanner로 마이그레이션 하기
Google Cloud Korea Team
최근 MySQL이나 PostgreSQL과 같은 기존 오픈소스 관계형 데이터베이스에서 Google Cloud Spanner로 마이그레이션하여 수평 확장을 지원하는 방안에 대한 관심이 커지고 있습니다. 이러한 유형의 이기종 마이그레이션은 다소 복잡할 수 있지만 HarbourBridge 및 데이터 검증 도구와 같은 두가지 오픈소스 도구가 도움이 될 수 있습니다. HarbourBridge는 MySQL 또는 PostgreSQL에서 스키마와 데이터를 수집하여 Spanner로 마이그레이션하는 독립형 도구 입니다. 이 도구는 Spanner에서 지원되는 데이터 타입과 기능을 매핑하고 지원되지 않는 것은 무시합니다. 데이터 검증 도구는 이름 그대로의 기능을 합니다. 소스 및 대상 데이터베이스에 연결하여 다단계 검증 또는 커스텀 쿼리를 통해 두 테이블의 데이터가 일치하는지 확인하는 Python CLI 도구입니다. 프로세스를 간략히 소개하겠습니다. 프로세스 전반에 대한 전체 엔드 투 엔드 튜토리얼이 곧 제공되니 기대해 주세요.
HarbourBridge
HarbourBridge를 설치하려면 Google Cloud SDK, Go, GCC가 필요합니다.
도구를 다운로드하여 설치합니다.
HarborBridge는 덤프 파일로 실행하거나 데이터베이스에 직접 연결할 수 있습니다. 덤프 파일을 사용할 경우 파일이 표준 일반 텍스트 pg_dump 또는 mysqldump 형식을 사용해야 합니다. 소스에 직접 연결하면 HarbourBridge에서 데이터베이스를 쿼리하여 테이블 스키마 및 데이터를 가져옵니다.
mydb라는 이름의 PostgreSQL 데이터베이스 덤프에서 도구를 사용하려면 다음 명령어를 실행합니다.
mydb라는 이름의 MySQL 데이터베이스 덤프에서 도구를 사용하려면 -driver=mysqldump로 바꿉니다.
PostgreSQL 데이터베이스에서 바로 도구를 사용하려면 --driver='postgres'를 설정하고 환경 변수 PGHOST, PGPORT, PGUSER, PGDATABASE를 제공합니다.
MySQL 데이터베이스에서 바로 도구를 사용하려면 --driver='mysql'을 설정하고 환경 변수 MYSQLHOST, MYSQLPORT, MYSQLUSER, MYSQLDATABASE를 제공합니다.
이 도구는 GCLOUD_PROJECT 환경 변수에 있는 Cloud 프로젝트를 사용하고 변환된 스키마를 사용해 Spanner 인스턴스에 새 데이터베이스를 만든 후 데이터를 로드합니다. 스키마, 세션, 보고서, 삭제된 파일 등 여러 출력 보고서 파일도 생성합니다. 이 파일에는 도구에서 수행한 작업과 데이터 또는 스키마에서 발생한 오류에 대한 자세한 정보가 포함되어 있습니다.
HarbourBridge는 지속적인 데이터 마이그레이션이나 CDC가 필요 없는 최대 100GB 정도의 중간 규모 데이터베이스를 마이그레이션할 때 적합합니다. Spanner 또는 더 큰 규모의 데이터베이스로 데이터를 지속적으로 마이그레이션할 때는 3rd Party 파트너 제품인 Striim이 적합할 수 있습니다. Striim은 초기 적재는 물론 CDC 스트리밍도 가능합니다.
데이터 검증 도구
데이터 검증 도구(DVT)를 설치하려면 Google Cloud SDK, git, python3, python3-dev, pip, gcc가 필요하며 원하는 경우 terraform도 사용할 수 있습니다. DVT는 기본적으로 stdout에 결과를 출력하지만 BigQuery에 쓰는 것도 가능합니다. BigQuery를 보고서 핸들러로 활용하여 출력을 저장하고 살펴보는 것이 좋습니다.
로컬 머신에 저장소를 클론하고 terraform 폴더에 액세스합니다. 폴더 안에 있는 terraform 파일을 수정하고 사용하여 BigQuery 데이터 세트 및 출력용 테이블을 만들 수 있습니다. 또는 Google Cloud SDK에서 bq 명령줄 도구를 사용하여 result_schema.json 파일로 테이블을 만들 수도 있습니다.
이후 pip를 사용해 DVT를 설치할 수 있습니다.
DVT를 실행하려면 먼저 소스 MySQL(다른 데이터베이스도 지원됨)에 대한 연결을 만들어야 합니다.
다음으로, 대상 Cloud Spanner에 대한 연결을 만듭니다.
그런 다음 검증을 실행하려면 검증 유형, 소스 연결, 대상 연결, 비교할 테이블 목록, BigQuery 출력 테이블을 지정합니다.
BigQuery의 출력은 다음과 같이 표시됩니다.
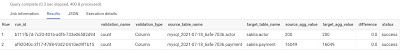
기본적으로 컬럼 유형 검증에서는 지정된 테이블에 단순한 COUNT(*)를 실행합니다. 경우에 따라서는 열마다 집계를 실행하는 것이 더 적절할 수 있습니다. --count columnName, --sum myFirstColumnName, --avg anotherColumnName 또는 이러한 조합을 추가하면 다양한 검사를 쉽게 빌드할 수 있습니다. DVT에서 유연성을 높이기 위해 사용할 수 있는 다른 집계, 필터 절, 커스텀 SQL도 있습니다. 다양한 유형에 대한 자세한 내용은 GitHub의 DVT 관련 페이지에서 확인할 수 있습니다.
추가적으로 -c validate.yaml 인수를 더하면 DVT에서 지정한 구성이 저장된 yaml 파일을 대신 출력합니다. 손쉽게 수정하고 저장하여 이후에 참조하거나 재현할 수 있습니다.
저장된 구성을 실행하는 것은 다음과 같이 간단합니다.
추가 정보
HarbourBridge를 통해 MySQL에서 Cloud Spanner로 마이그레이션하기
HarbourBridge의 Schema Assistant를 사용한 빠른 Cloud Spanner 마이그레이션
Striim을 사용한 Cloud Spanner로 지속적인 데이터 복제
HarbourBridge 및 데이터 검증 도구는 현재 개발이 진행 중입니다. 사용해 본 후 의견을 제공하거나 문제를 신고하거나 해결 및 개선에 대한 PR을 보내 개발을 도와주세요. 이 오픈소스 도구는 사용자 커뮤니티에 속하며 Google Cloud에서 공식적으로 지원되지 않습니다.
다음 게시물 예고
다음 게시물에서는 Cloud Spanner의 백업 복구에 대해서 알아보도록 하겠습니다. 많은 관심 부탁 드립니다.