에이전트형 데이터 클라우드 커넥터로 Gemini에서 대화형 분석 활용하기
Leigha Reid
Senior Product Manager, Data Cloud
Mohsin Imam
Senior Product Manager, Data Cloud
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
현재 프리뷰 버전으로 제공되는 Gemini for business의 데이터 클라우드 커넥터를 사용하면 비즈니스 사용자와 분석가가 자연어로 실시간 엔터프라이즈 데이터를 직접 쿼리할 수 있습니다. 대부분의 조직에서 데이터 관련 질문은 분석가가 처리할 수 있는 속도보다 훨씬 빠르게 늘어납니다. 이로 인해 프로젝트는 티켓 대기열에 쌓이고, 리더는 데이터 대신 추측에 의존하게 되며, 관리되지 않는 스프레드시트가 팀 전체로 확산됩니다. 초기 생성형 AI 도구는 데이터에 대한 대화형 액세스를 약속했지만, 복잡한 스키마에서 정확한 SQL을 생성하거나 거버넌스 규칙을 준수하는 데 어려움을 겪는 경우가 많았습니다. 데이터 클라우드 커넥터를 사용하면 행 및 열 수준 보안을 적용하고 최종 사용자 인증 정보를 준수하면서 작업공간에서 거버넌스가 적용된 데이터를 직접 쿼리할 수 있습니다.
엔터프라이즈 데이터를 쿼리하는 새로운 방법
Gemini는 두 가지 경로를 통해 대화형 분석을 일상적인 워크플로에 직접 통합합니다. 대화형 분석 에이전트를 사용하면 특정 사용 사례에 대한 질문에 효과적으로 답변할 수 있도록 컨텍스트와 요청 사항이 포함된 데이터 에이전트를 만들 수 있으며, 데이터 클라우드 커넥터를 사용하면 Gemini로 실시간 데이터를 직접 쿼리할 수 있습니다. 최종 사용자는 BigQuery(프리뷰) 그리고 Spanner, AlloyDB, Cloud SQL(프리뷰)과 같은 운영 데이터베이스에서 직접 데이터를 가져오고 Looker(프리뷰)에서 거버넌스가 적용된 데이터를 가져올 수 있습니다. 발견 사항을 일상적인 도구로 바로 만들 수 있습니다. 예를 들어 쿼리 결과를 Google 문서로 만들거나, Gmail의 이메일 초안 또는 Google 슬라이드의 발표 자료로 변환하는 것이 가능합니다.
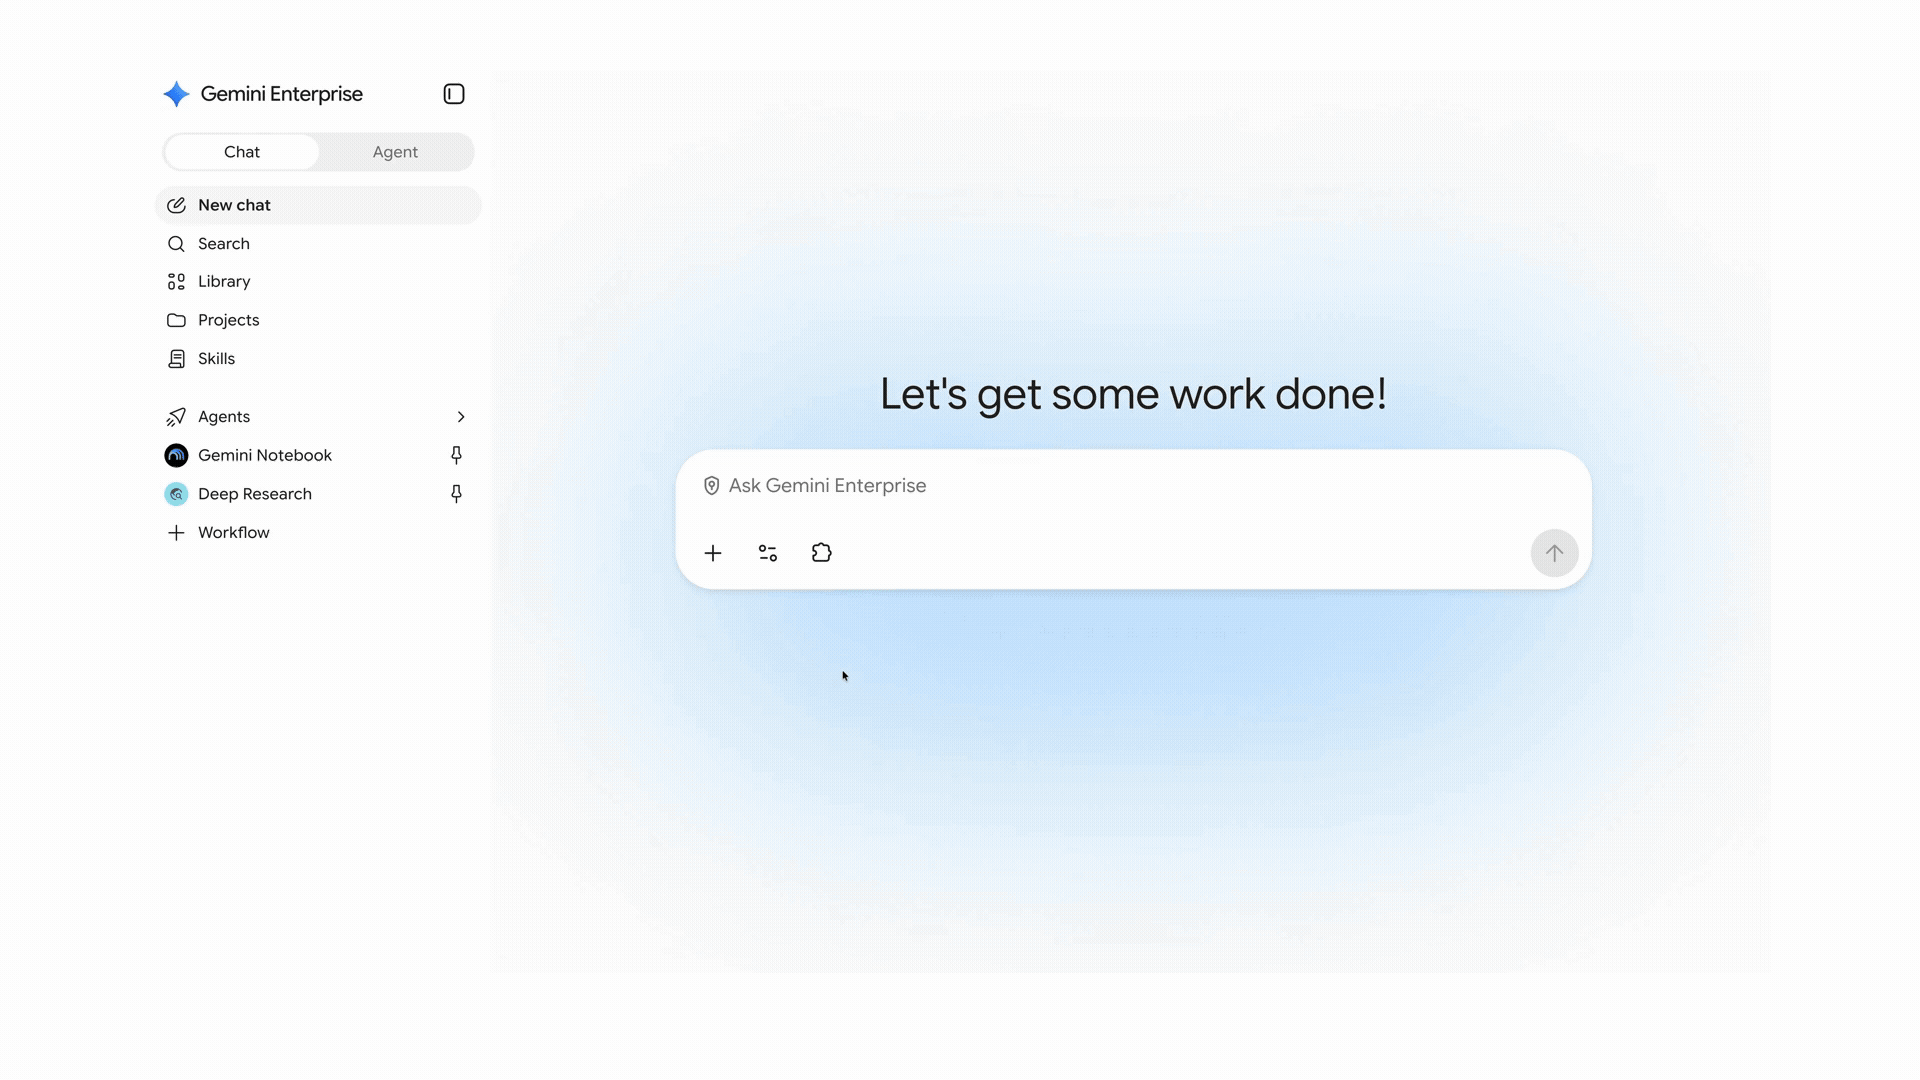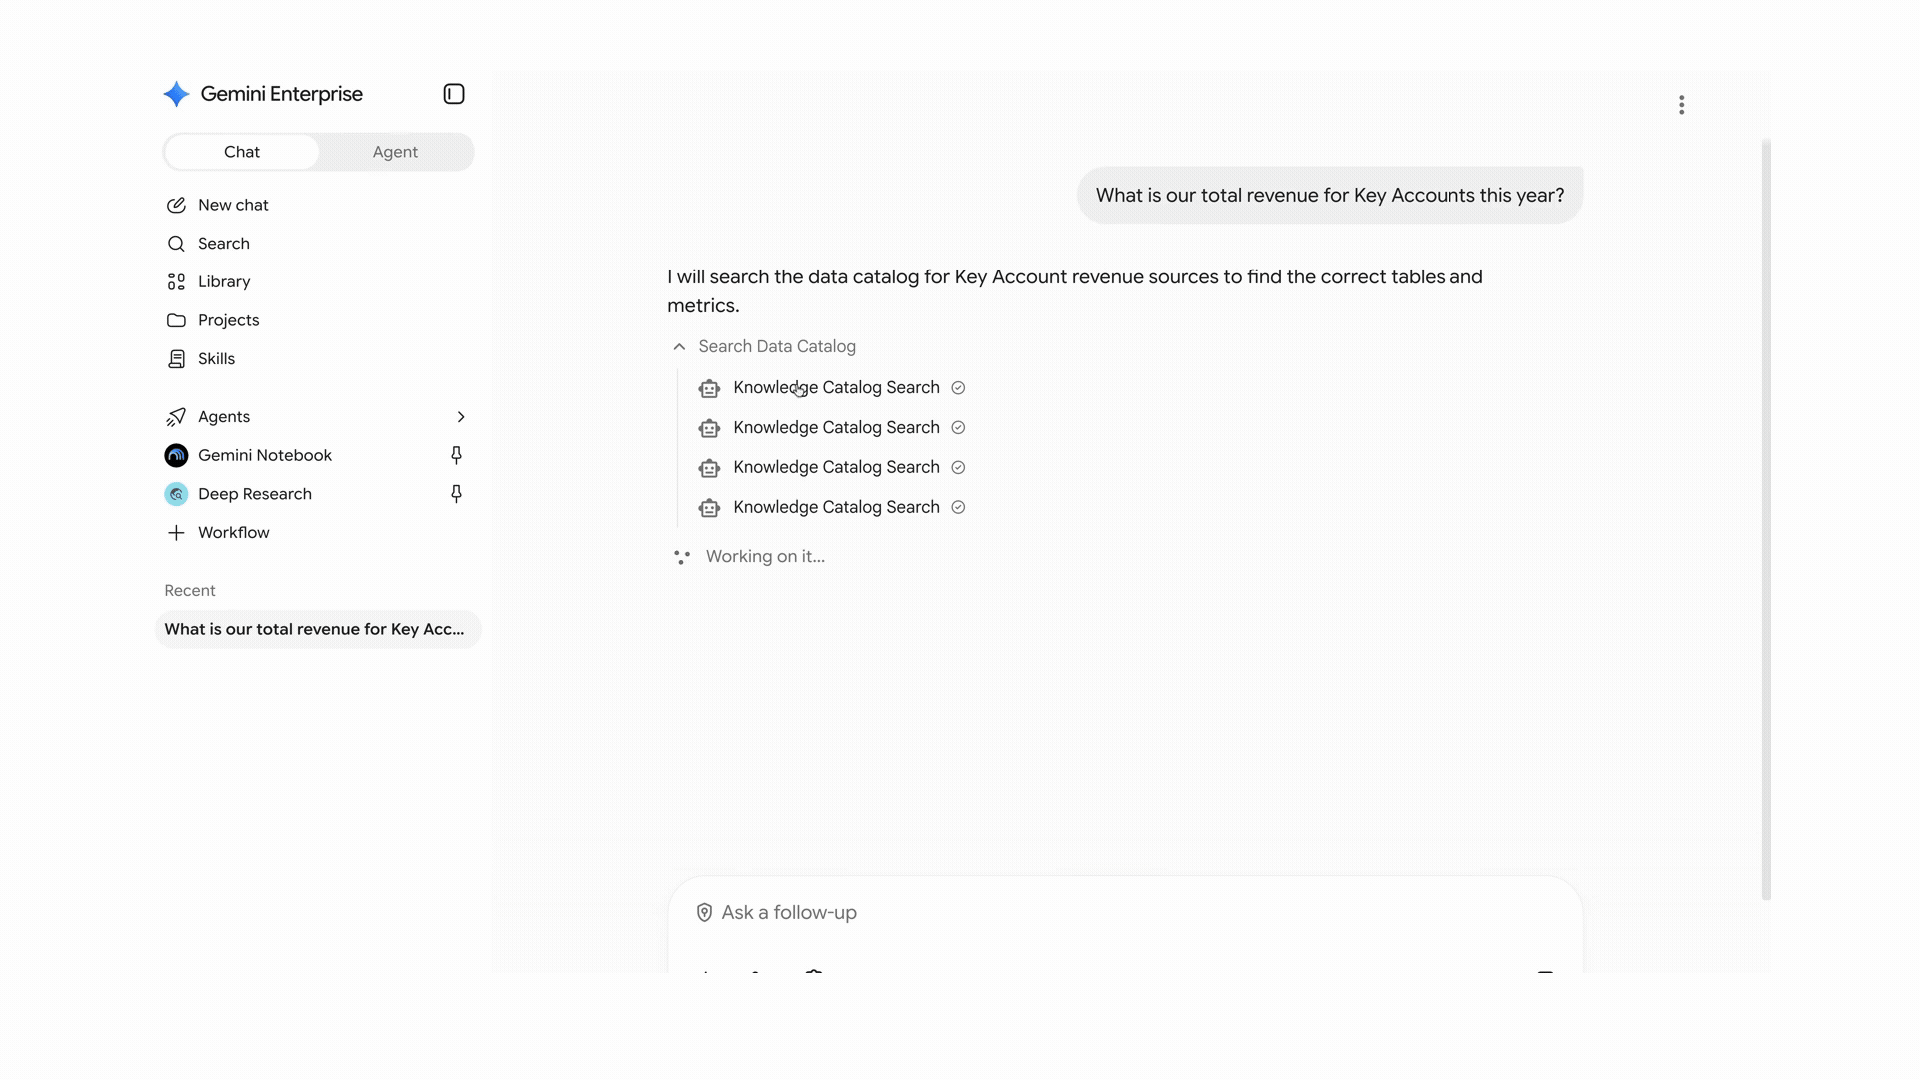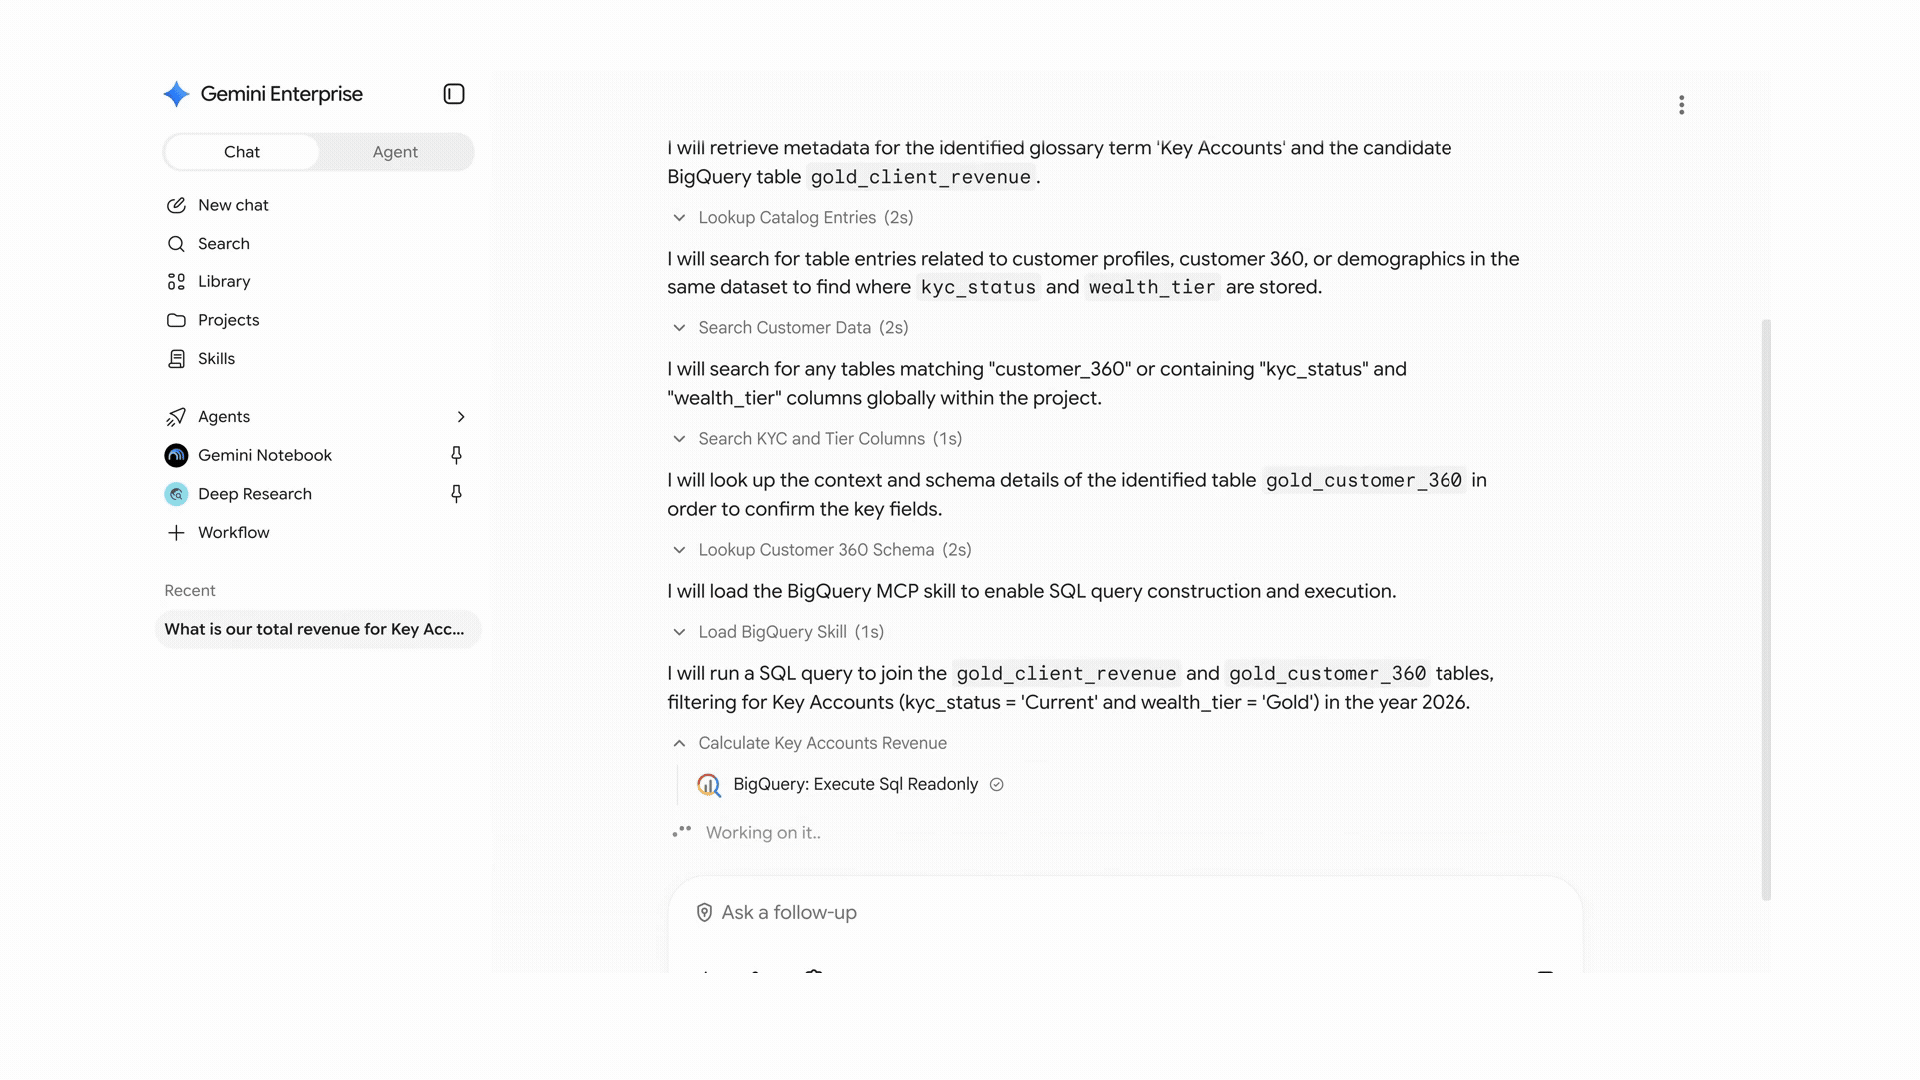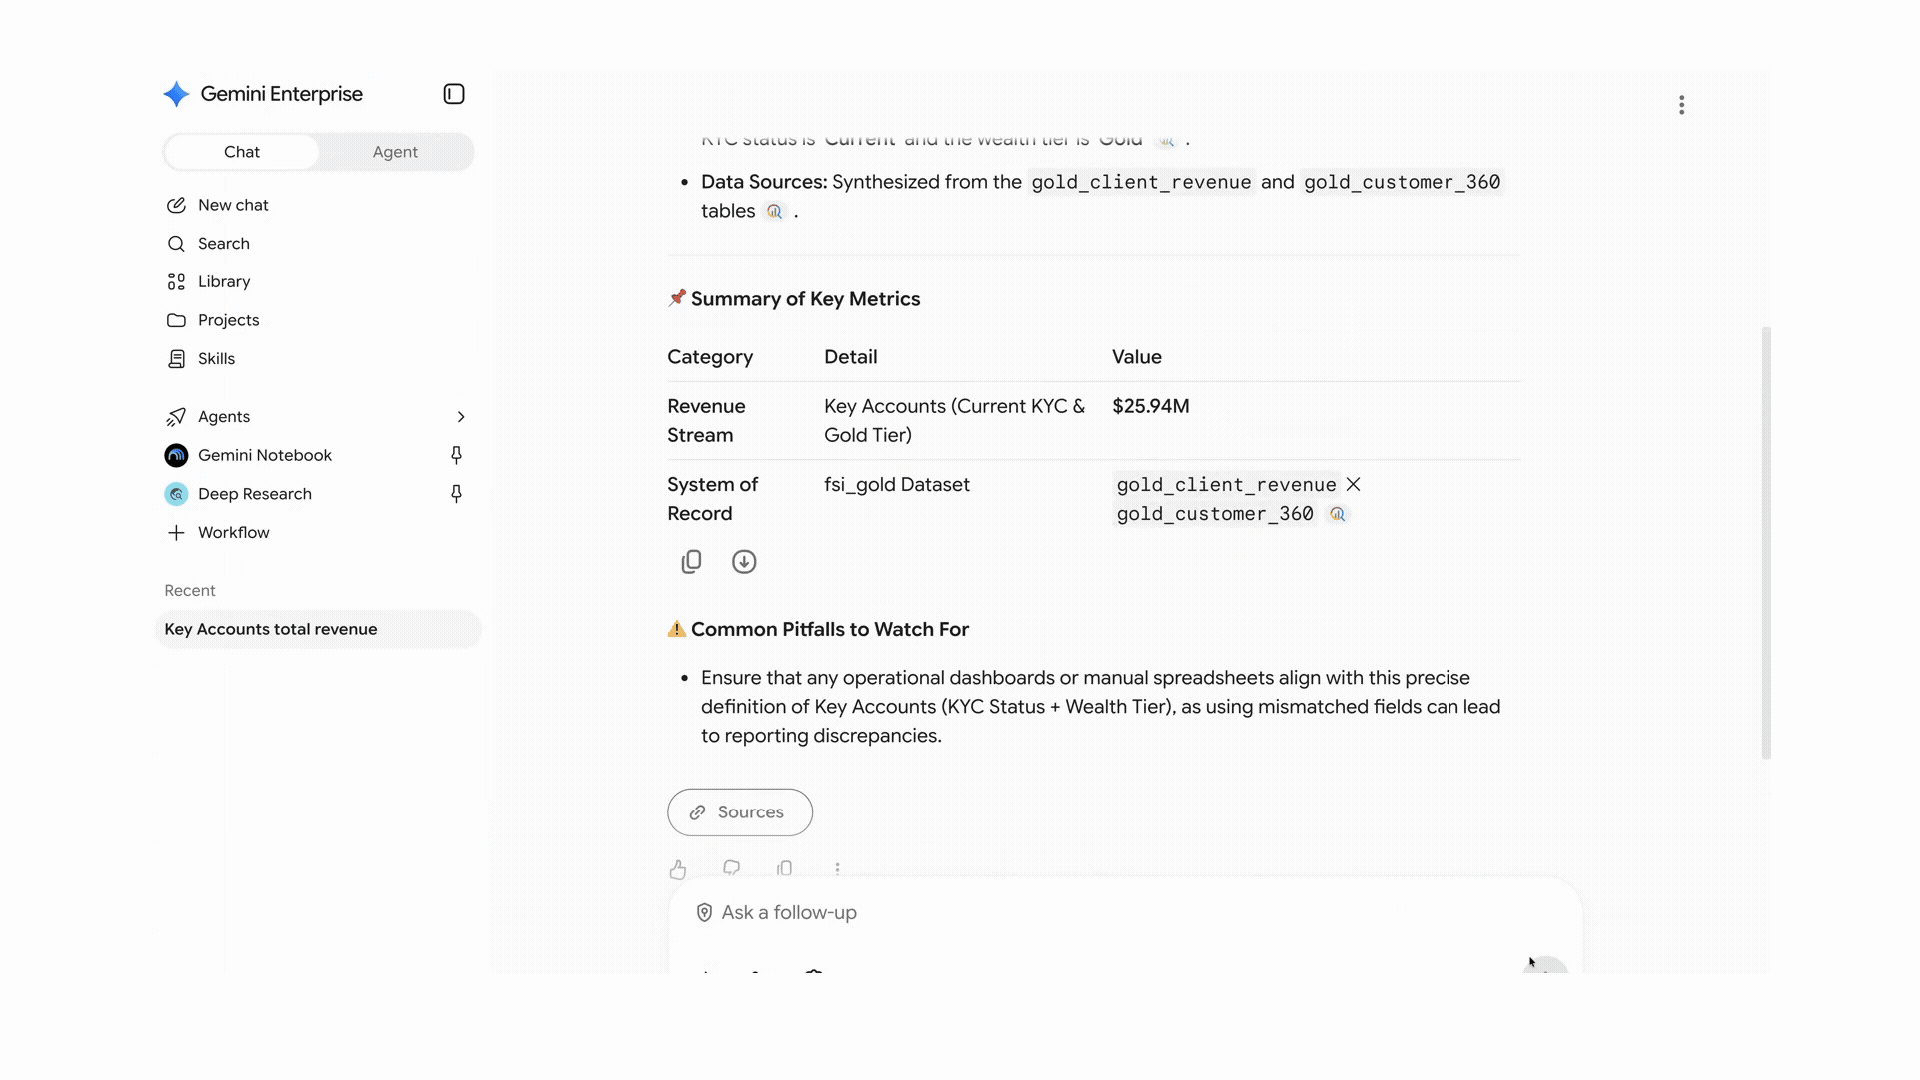
데이터 클라우드 커넥터를 사용하여 엔터프라이즈 데이터 전반에서 자연어로 질문하세요.
데이터 클라우드 커넥터의 작동 방식
데이터 클라우드 커넥터는 Knowledge Catalog와 연동하여 관련 데이터를 찾고, 질문을 해석하고, 사용자 ID로 권한 범위가 지정된 쿼리를 실행합니다.
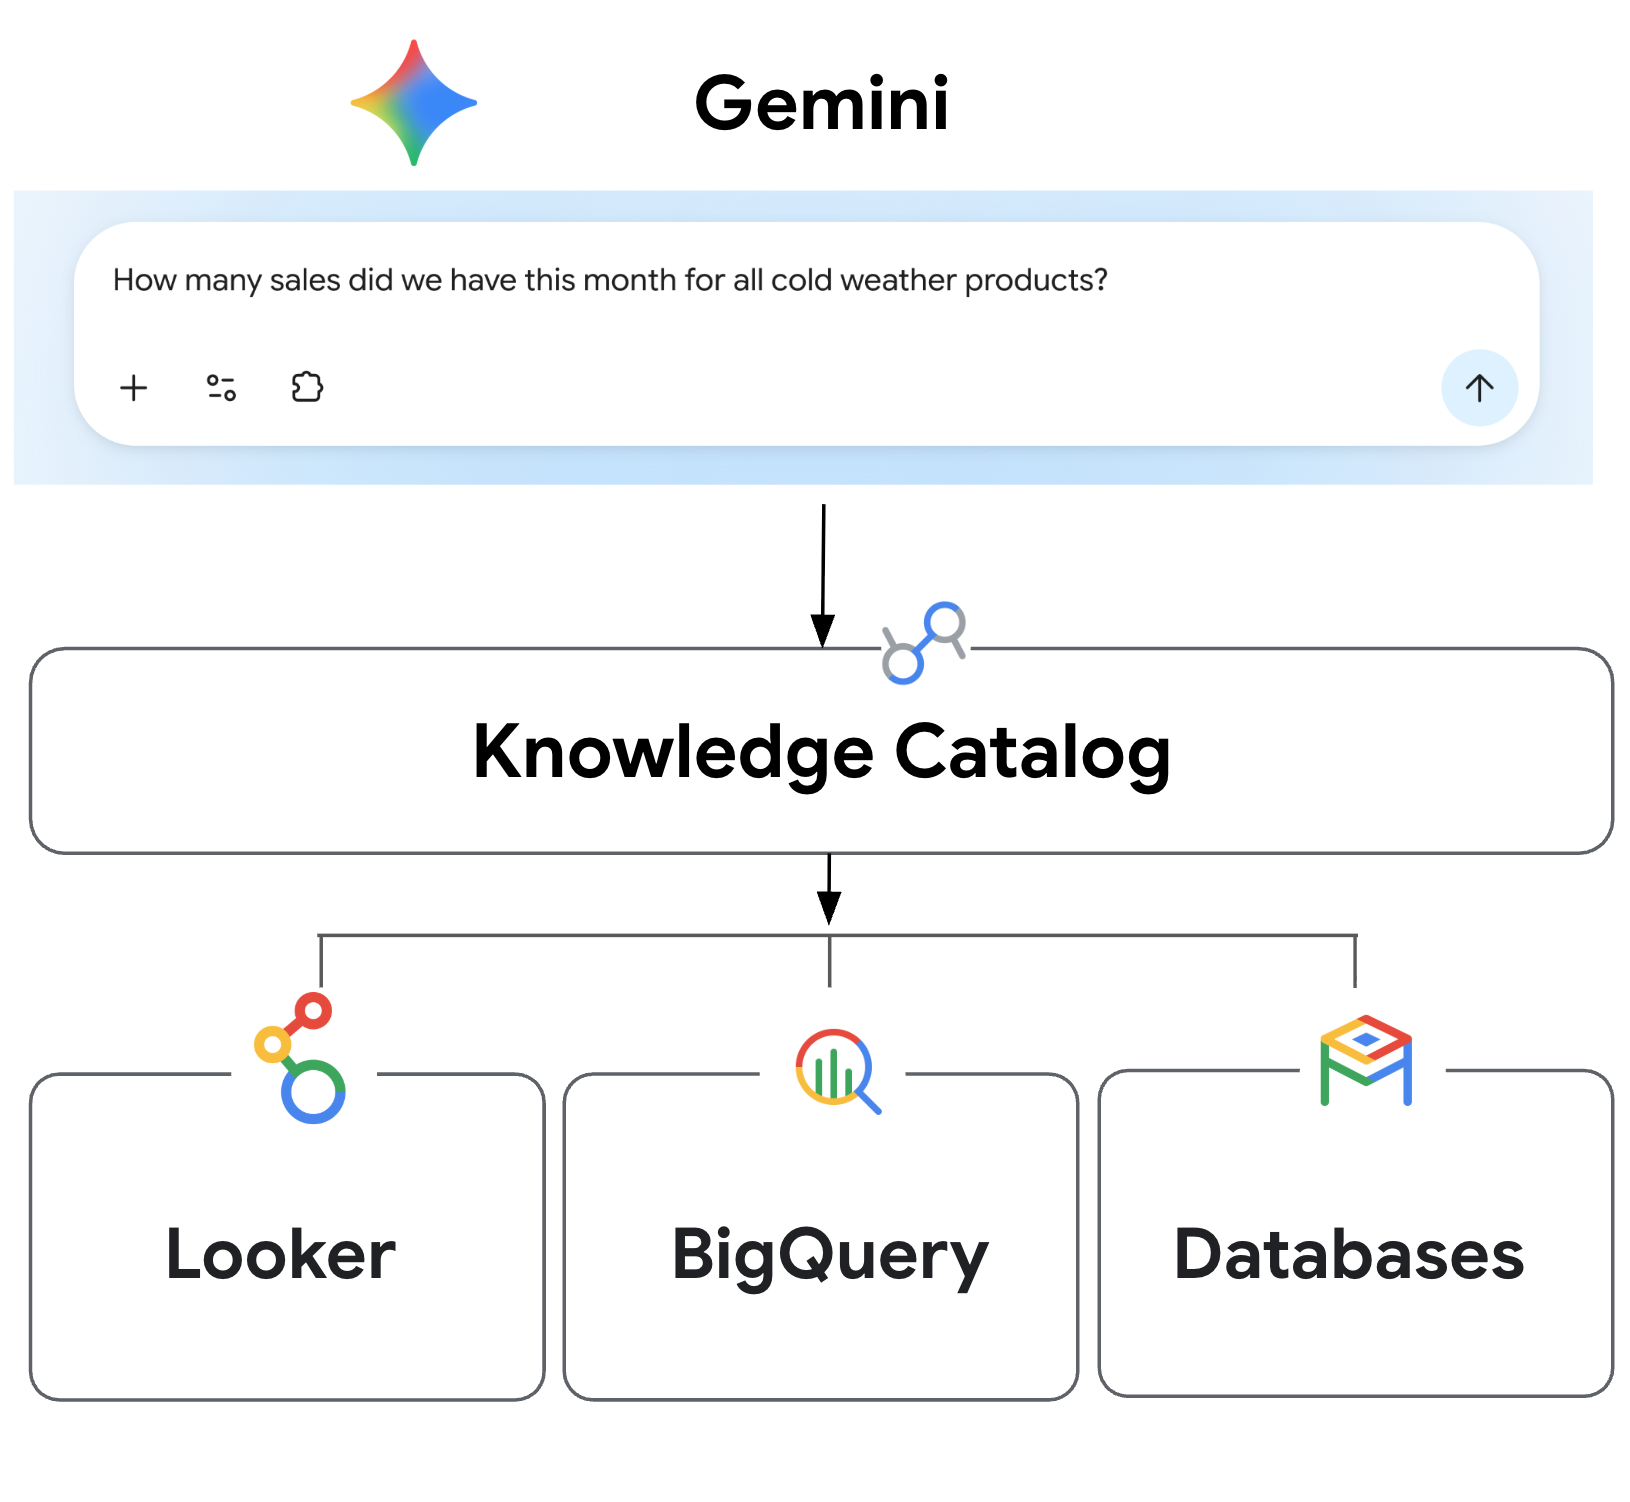
Knowledge Catalog는 사용자 프롬프트를 해석하고 쿼리에 적합한 데이터 소스를 식별합니다.
Gemini에 질문하면 시스템은 다음 기능을 사용하여 검색, 시맨틱 해석, 쿼리 실행을 조정합니다.
-
자연어 질문: 일상 언어로 탐색 질문을 합니다(예: '이번 달에 모든 방한 제품의 판매량은 얼마인가요?'). 최종 사용자는 사용할 테이블이나 프로젝트를 알 필요가 없습니다.
-
시맨틱 검색: Gemini는 사용 패턴과 같은 주요 속성을 고려해 Knowledge Catalog를 검색하고 조직 내 자산 전반에서 후보 데이터를 찾아냅니다.
-
컨텍스트 매핑: 시스템은 기술 메타데이터, 비즈니스 용어집, 시맨틱 모델을 사용하여 일상 용어를 정확한 데이터베이스 구조에 매핑합니다. 예를 들어 '방한 제품'을 전자상거래 카탈로그의 스웨터, 코트, 재킷과 같은 특정 카테고리로 해석합니다.
-
권한 인식 실행: Gemini는 SQL 쿼리를 생성하고 사용자 인증 정보로 커넥터를 통해 실행하며, 기존 행 및 열 수준 데이터베이스 권한을 준수합니다.
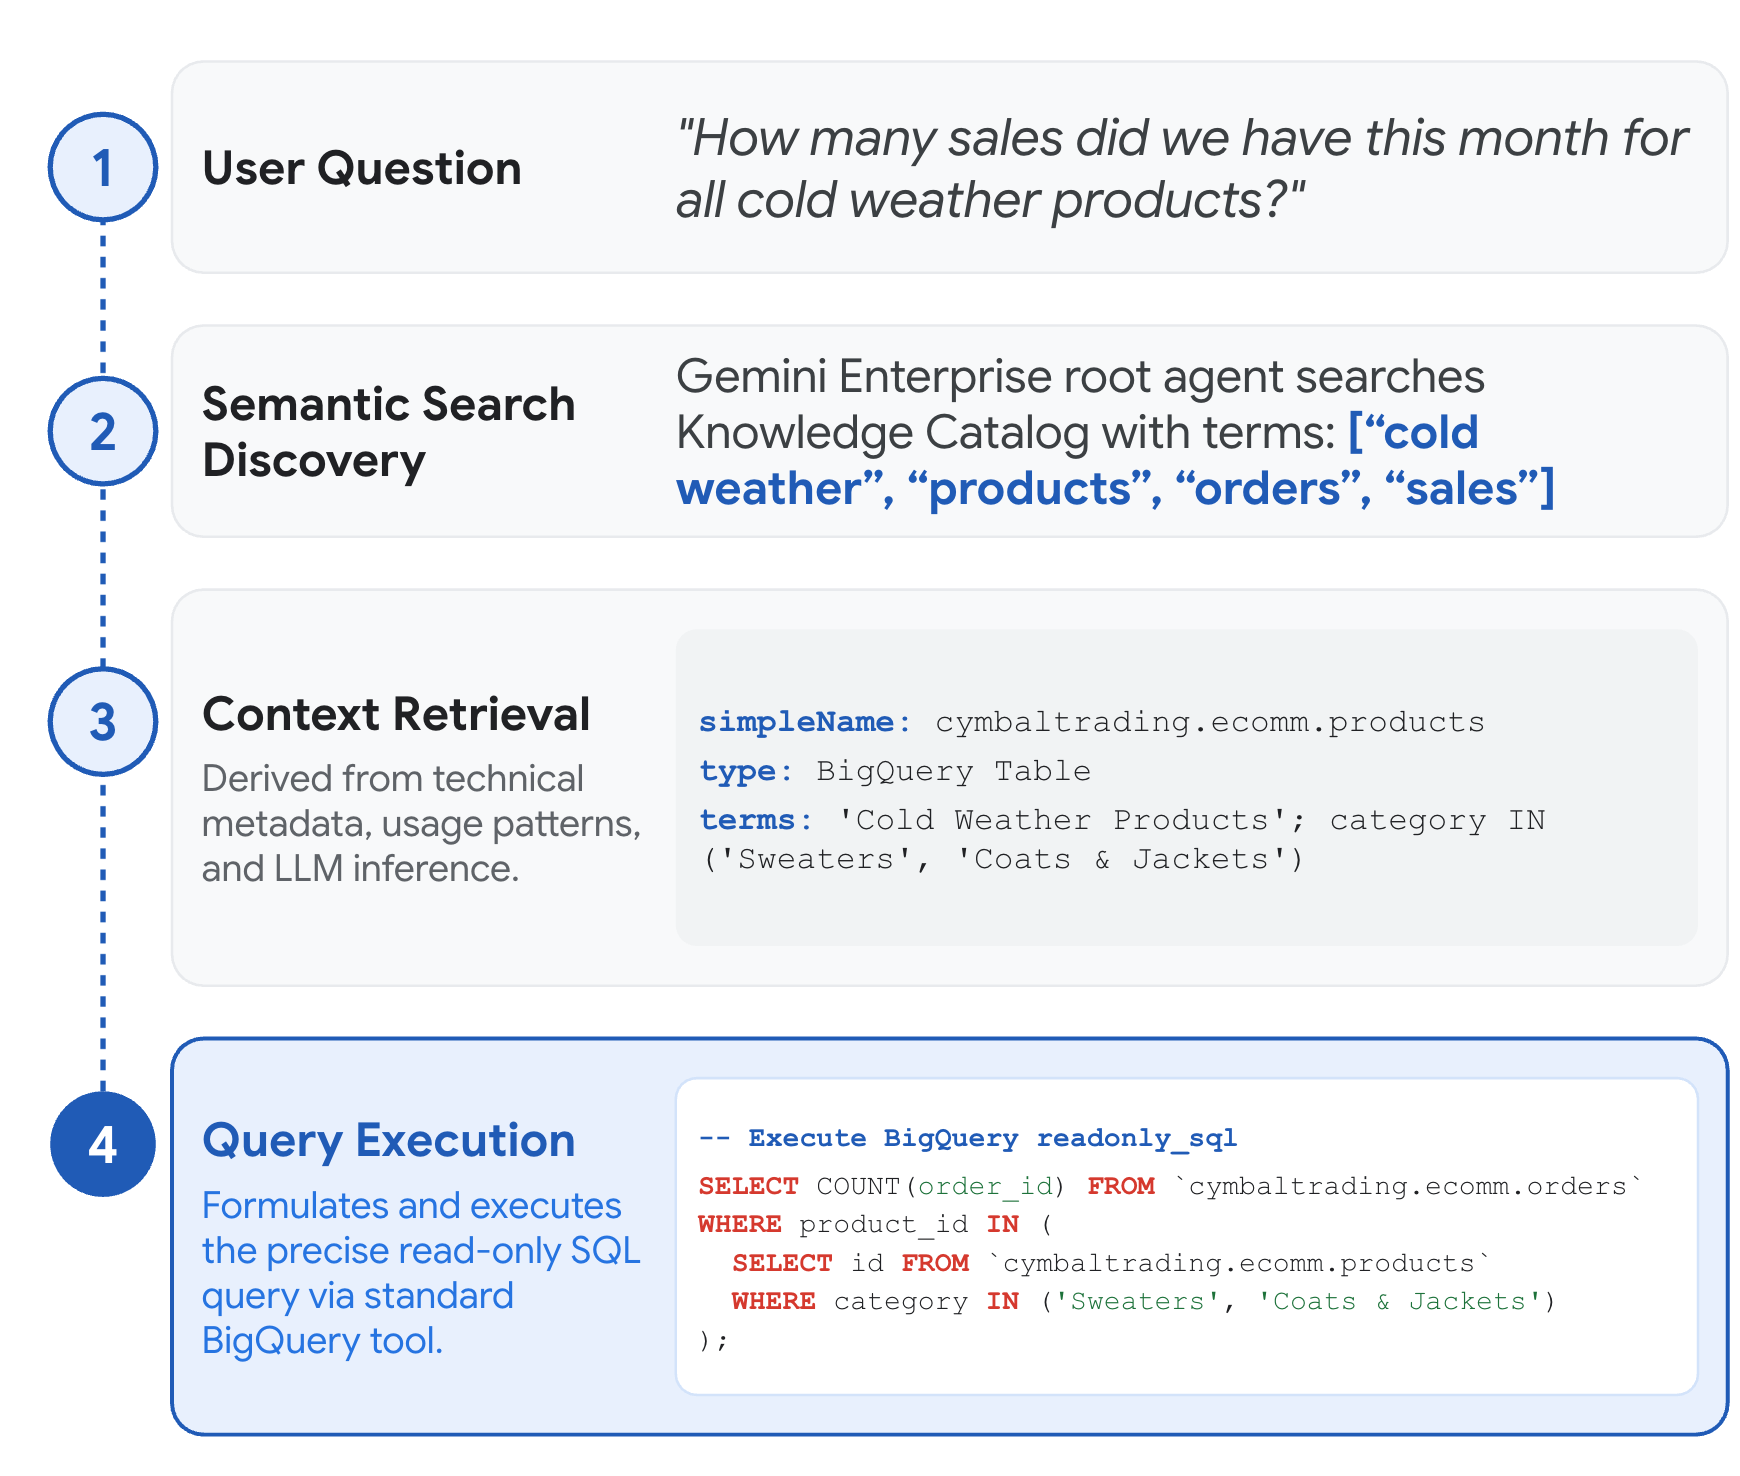
Gemini에서 쿼리 실행까지 사용자 프롬프트의 단계별 흐름
엔터프라이즈 데이터 자산을 정확하게 탐색하려면 언어 모델에 원시 데이터베이스 액세스 권한과 함께 비즈니스 컨텍스트가 필요합니다. Knowledge Catalog는 기술 메타데이터, 비즈니스 로직, 테이블 관계, 검증된 쿼리를 포함한 선별된 컨텍스트 번들을 제공하여 쿼리 정확성을 개선하는 동시에 지연 시간과 토큰 소비를 줄입니다.

Knowledge Catalog에서 컨텍스트 그래프를 시각적으로 탐색합니다.
엔터프라이즈 분석은 오랫동안 물리적 경계로 인해 파편화되어 왔습니다. 독점 사일로에 갇힌 데이터, 클라우드 객체 스토리지의 개방형 레이크하우스 테이블, 멀티 클라우드 환경에 분산된 데이터 세트 등이 그 예입니다. BigQuery 커넥터는 네이티브 BigQuery 스토리지를 넘어 경계 없는 레이크하우스에 대화형 분석을 제공하여 이러한 환경을 단일 대화형 인터페이스로 통합합니다. 이를 통해 BigQuery를 사용하여 개방형 테이블 형식(Apache Iceberg, Delta Lake, Parquet 포함)과 AWS 또는 Azure의 크로스 클라우드 데이터 세트를 쿼리할 수 있습니다. 커넥터는 BigQuery 및 Knowledge Catalog에서 세분화된 액세스 정책을 이어받으므로, 네이티브 테이블이나 개방형 레이크하우스 파일을 쿼리할 때 행 및 열 수준 액세스 제어가 적용됩니다.

Gemini는 AWS Glue 페더레이션 카탈로그를 통해 BigQuery 및 AWS S3 전반의 데이터에 액세스하여 일상 언어로 질문에 답변합니다.
커넥터와 데이터 에이전트 비교 및 선택
직접적인 데이터 클라우드 커넥터를 사용하여 일상 언어로 데이터를 쿼리하는 것 외에도 대화형 분석 에이전트를 사용하여 이러한 경험을 지원할 수 있습니다. 데이터 클라우드 커넥터가 사용자에게 탐색 및 임시 분석 기능을 제공한다면, 대화형 분석 에이전트는 조직 내 데이터팀이 직접 빌드하고 인증한 범위 지정 에이전트입니다. 이러한 에이전트는 BigQuery, Looker와 같은 데이터 클라우드 제품과 Spanner, AlloyDB, Cloud SQL 등 운영 데이터베이스 전반에서 빌드할 수 있습니다.
이러한 사전 구성된 에이전트를 활용하면 특정 데이터 하위 집합으로 범위를 한정하여, 거버넌스가 철저히 적용된 다단계 전략 분석을 수행할 수 있습니다. 이를 통해 규정 준수 요건을 충족하는 것은 물론, 보고에 필요한 예측 가능한 결과도 확보할 수 있습니다. 이러한 데이터 에이전트는 Gemini에 게시하여 사용하거나 API를 통해 기업에서 자체 대화형 앱을 빌드하는 데 사용할 수도 있습니다.
이러한 접근 방식은 상호 보완적입니다. Gemini 직접 연결은 중앙 데이터팀에서 만들어 게시한 관련 에이전트도 함께 제안하므로, 사용자는 커넥터를 활용해 임시 분석을 수행할지 아니면 범위가 지정된 에이전트를 사용할지 직접 선택하면 됩니다. 각 워크로드에 적합한 접근 방식을 선택할 수 있습니다.
기본 제공되는 액세스 제어 및 거버넌스
데이터 클라우드 커넥터 쿼리는 최종 사용자의 ID로 실행됩니다. 임원 급여 데이터나 보호 대상 의료 기록에 대한 액세스 권한이 없는 직원은 자연어 프롬프트를 사용해 해당 데이터를 쿼리할 수 없습니다. 에이전트는 Knowledge Catalog에서 액세스 권한이 있는 메타데이터만 검색하고 계정에 실행 권한이 있는 쿼리만 실행합니다.
데이터 클라우드 커넥터를 만드는 방법
관리자는 Gemini 관리 콘솔에서 데이터 클라우드 커넥터를 구성할 수 있습니다. 이후 관리자는 BigQuery, 운영 데이터베이스 또는 Looker의 데이터 세트에 대한 기본 읽기 전용 연결을 설정할 수 있으며, 이때 Knowledge Catalog는 자동으로 사용 설정됩니다. 구성이 완료되면 최종 사용자는 Gemini에서 커넥터를 사용 설정하여 일상 언어로 데이터를 쿼리하고 보고서를 작성할 수 있습니다.
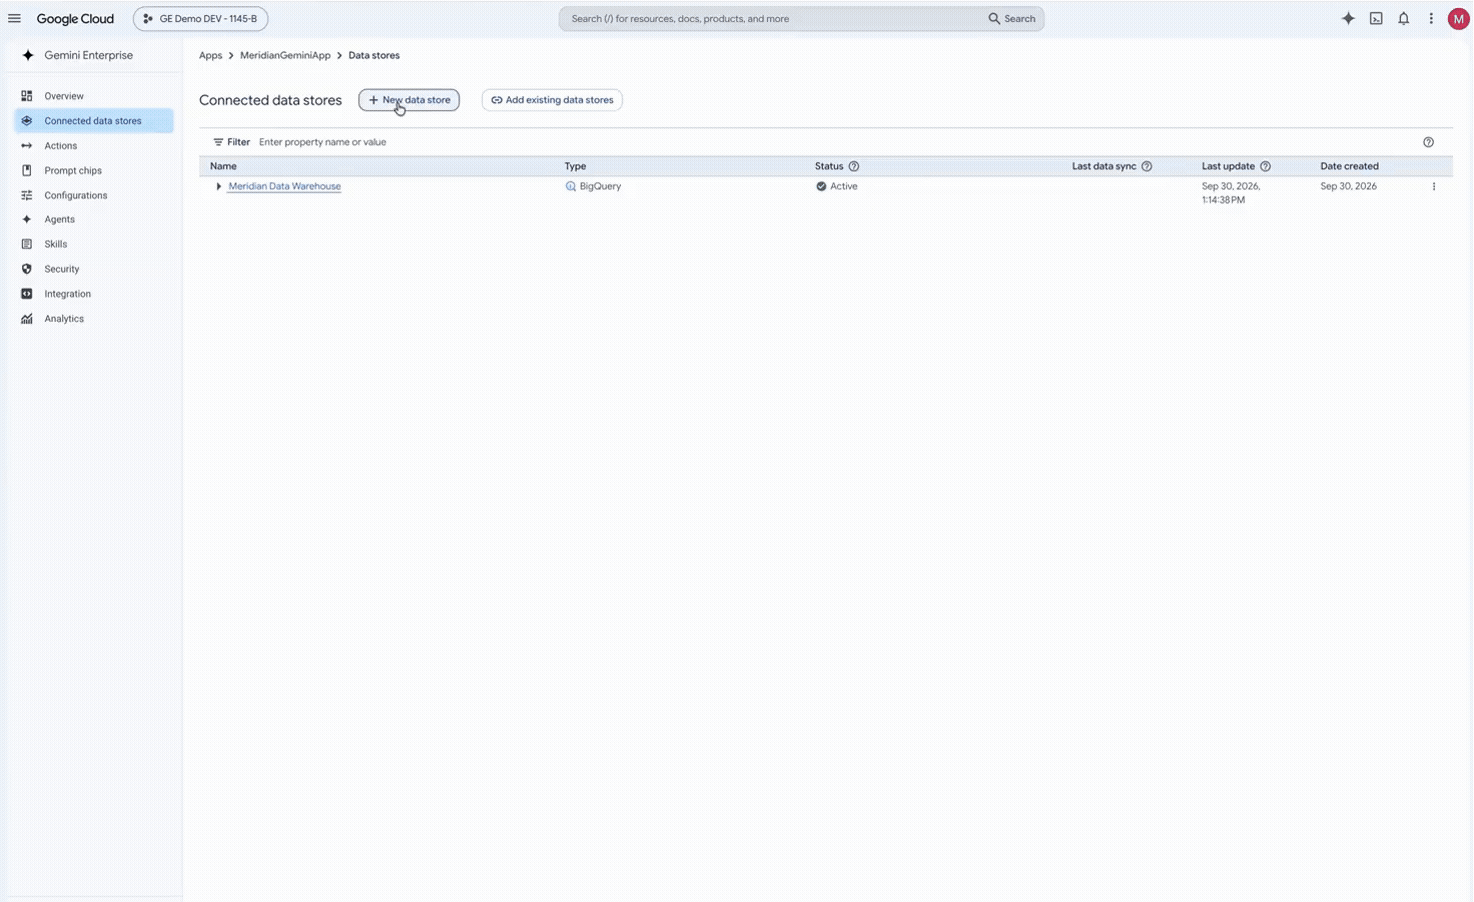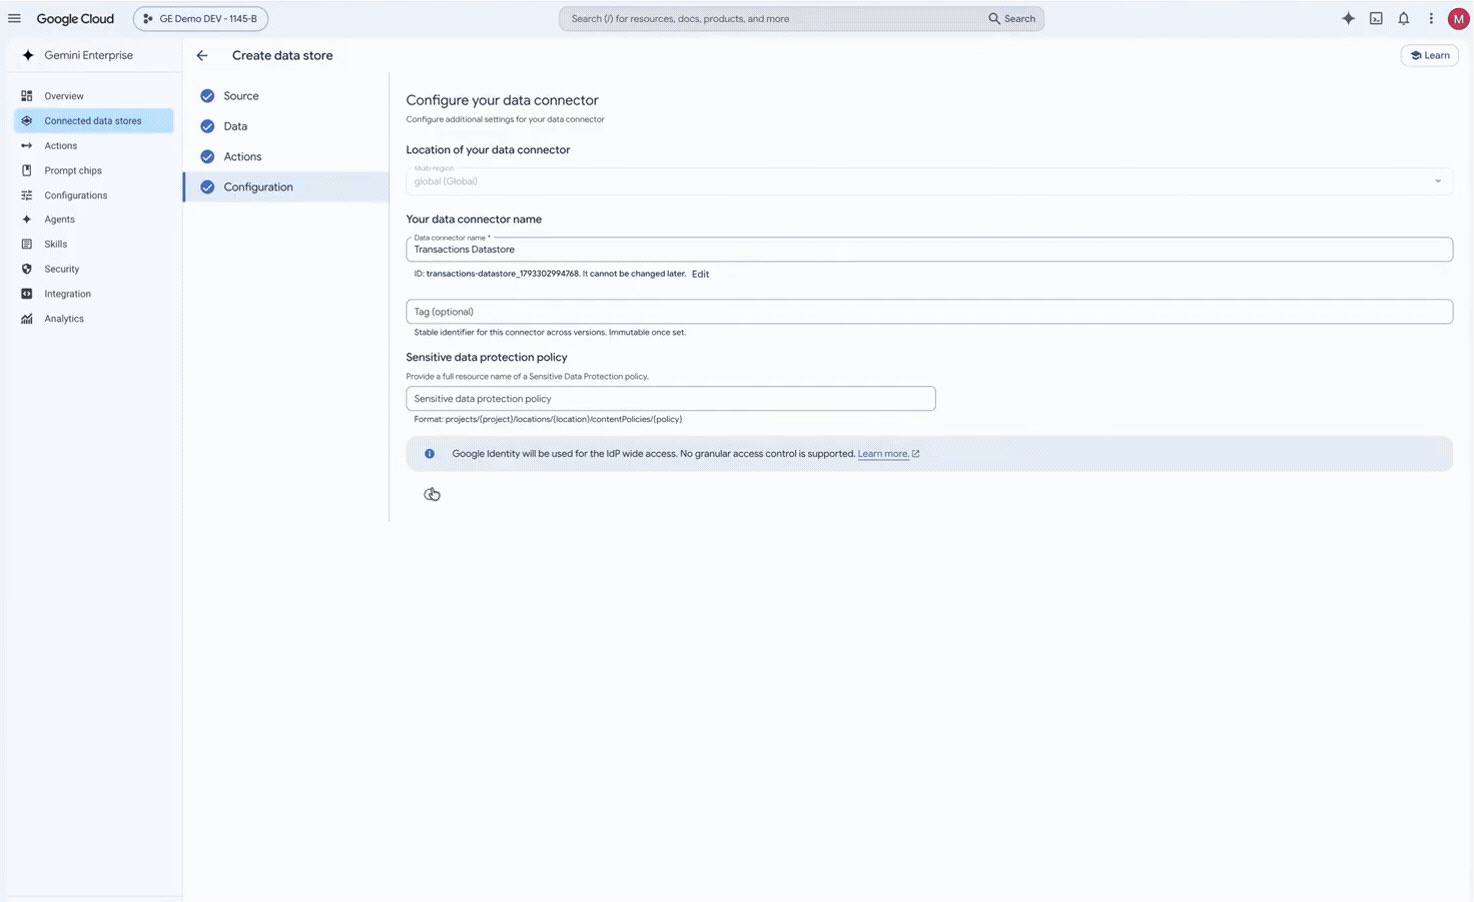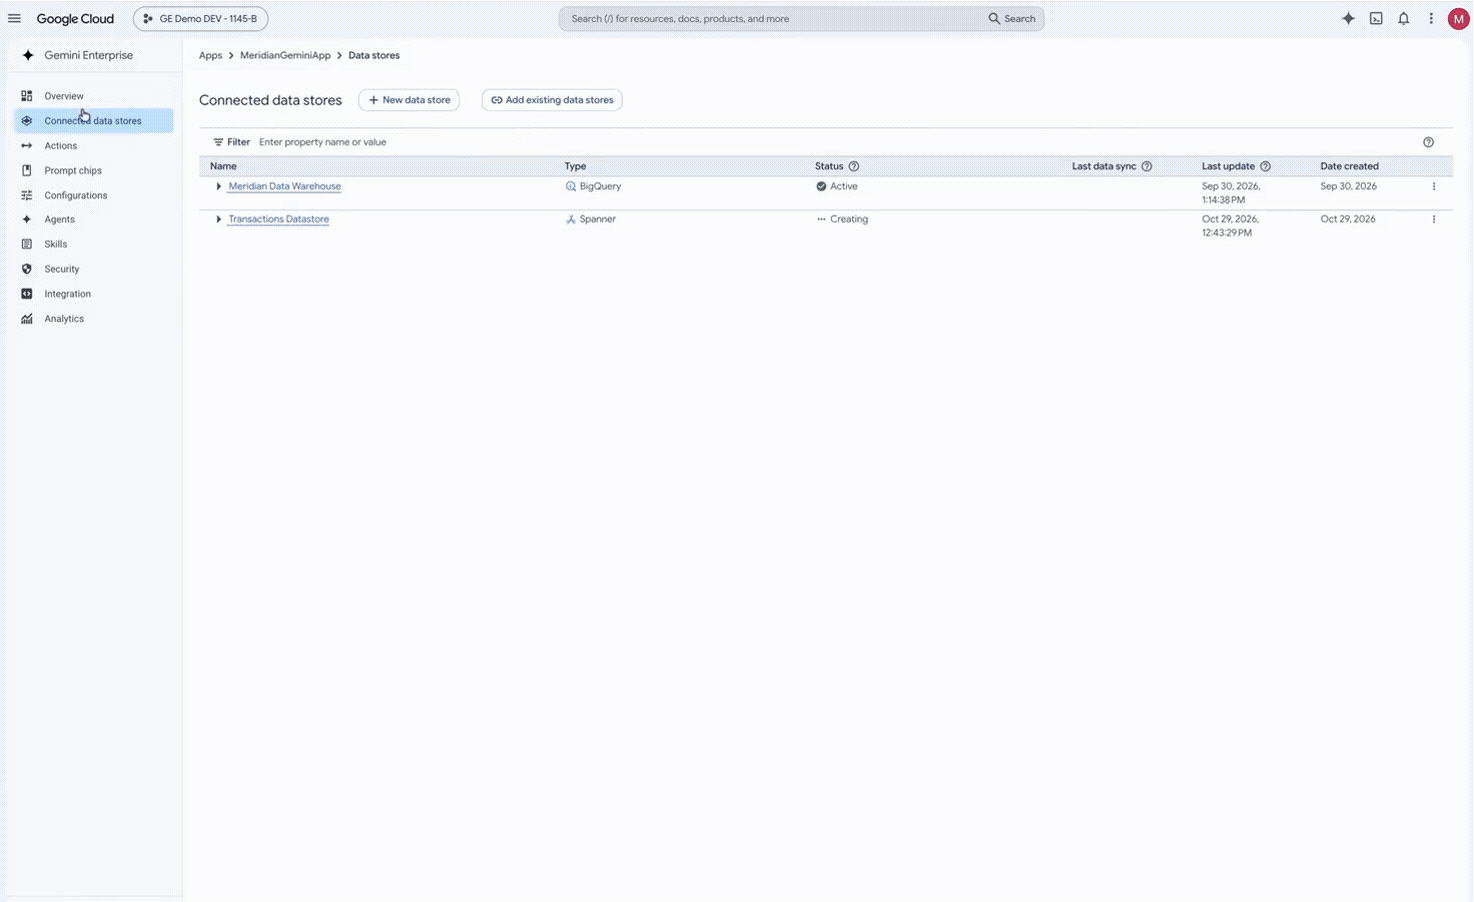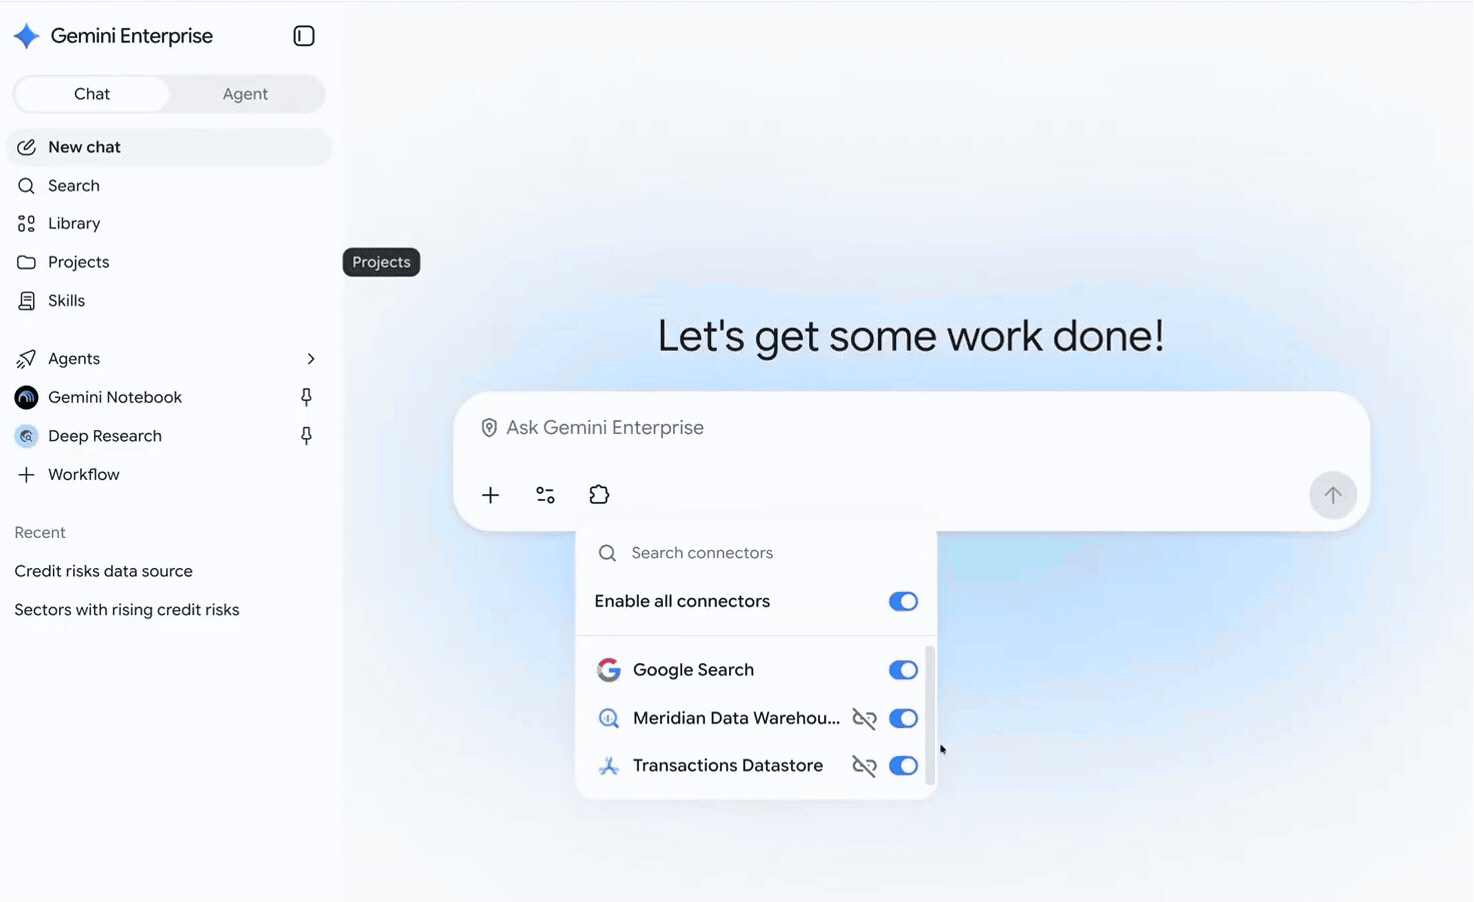
Gemini에서 연결된 데이터 스토어를 생성하고 처음 사용할 때 승인하세요.
BigQuery, Spanner, Cloud SQL, PostgreSQL용 AlloyDB 커넥터에 대한 설정 문서가 제공되며 Looker도 프리뷰 버전으로 제공됩니다.
데이터를 Gemini 데이터 스토어에 복사하는 데이터 수집 모드와 달리 데이터 클라우드 커넥터는 페더레이션 쿼리 모드를 사용하여 데이터를 복사하거나 색인을 생성하지 않고도 있는 그대로 쿼리합니다. 이때 Knowledge Catalog를 자동으로 사용하여 액세스 가능한 메타데이터를 검색하고 비즈니스 컨텍스트를 조회합니다.
커스텀 MCP 대신 데이터 클라우드 커넥터를 사용해야 하는 이유
공개 또는 자체 관리형 모델 컨텍스트 프로토콜(MCP) 서버를 연결하는 방식과 비교할 때, 퍼스트 파티 데이터 클라우드 커넥터는 다음과 같은 두 가지 주요 이점을 제공합니다.
-
대답 품질 향상을 위한 기본 제공되는 스킬: 데이터 클라우드 커넥터에는 BigQuery 및 운영 데이터베이스를 위한 고급 SQL 및 AI 함수 생성과 같이 각 데이터 엔진에 맞게 사전 구성된 에이전트 스킬이 포함되어 있어, 쿼리 정확성과 대답 품질을 개선할 수 있습니다.
-
단계별 설정 및 관리형 인증: 퍼스트 파티 커넥터는 Google Cloud 데이터베이스 및 BigQuery에 대해 관리형 인증이 포함된 단계별 설정 환경을 제공하므로, MCP 미들웨어를 배포하거나 Google Cloud 서비스용 OAuth 클라이언트 구성을 직접 관리할 필요가 없습니다. 또한 BigQuery 쿼리 실행을 위한 기본 Google Cloud 결제 프로젝트를 지정하는 등 커넥터별 설정을 통해 관리자가 거버넌스를 시행하고 쿼리 비용을 관리할 수 있습니다.
지금 시작하기
데이터 클라우드 커넥터를 사용하면 백로그 대기 없이 엔터프라이즈 데이터 소스에서 필요한 답을 바로 찾을 수 있습니다. 시작하려면 데이터 클라우드 커넥터 문서를 검토하거나 대화형 분석 에이전트에 대해 알아보세요.