Google의 에이전트형 데이터 클라우드로 에이전트를 대규모로 지원하는 새로운 기능
Sirish Chandrasekaran
VP, Product Strategy & Growth, Data Cloud
Raj Pai
VP, Product Management
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
얼마 전까지만 해도 에이전트 시대에 접어들고 있었지만, 오늘날 조직은 프로덕션 환경에서 에이전트를 실행하여 상당한 가치를 창출하고 있습니다. 새로운 수익원을 확보하고, 효율성을 개선하고, 위험을 관리할 수 있는 기회는 기업 리더가 에이전트를 통해 운영 방식을 혁신할 수 있는 가장 중요한 요소입니다.
이것이 바로 Google Cloud가 에이전트형 데이터 클라우드를 구축한 이유입니다. 이는 폐쇄적인 환경 간의 장벽을 허물어 모든 데이터를 활용하고, 높은 정확성과 신뢰성을 제공하며, 저렴한 비용으로 선제적으로 운영되도록 설계된 실행 시스템입니다. PayPal, Siemens, Telus, Vodafone, Walmart 등 선도적인 조직은 이미 Google Cloud와 함께 비즈니스 성과를 창출하고 있습니다.
오늘은 Google의 에이전트형 데이터 클라우드에 대한 주요 업데이트를 공유해 드리고자 합니다. Google Cloud는 어디서나 에이전트를 지원하고, 엔터프라이즈 컨텍스트에 그라운딩하여 정확하고 신뢰할 수 있는 답변을 제공하며, 실무자와 비즈니스 사용자 모두에게 향상된 에이전트 중심 경험을 제공합니다.
경계 없는 레이크하우스로 에이전트를 위한 모든 데이터 활성화
엔터프라이즈 데이터는 멀티 클라우드 환경, 온프레미스 시스템, Confluent, SAP, Salesforce, Workday와 같은 SaaS 플랫폼 등 모든 곳에 존재합니다. 개방형 Apache Iceberg 형식을 기반으로 빌드된 경계 없는 레이크하우스를 사용하면 데이터가 어디에 있든 모든 데이터를 활용할 수 있으므로 에이전트가 하나의 거버넌스 적용 기반을 갖출 수 있습니다. 데이터를 이동하거나, 커넥터를 연결하거나, 예상치 못한 가변 이그레스 수수료를 지불할 필요 없이 인프라부터 모델까지 모든 레이어에서 조정된 스택을 사용할 수 있습니다. 실제로 관리 중인 Apache Iceberg 데이터는 지난 한 해 동안 3배 이상 증가했습니다.
오늘 Google Cloud는 경계 없는 레이크하우스에 대한 몇 가지 새로운 개선사항을 발표합니다. 이제 Gemini가 경계 없는 레이크하우스에서 직접 작동하므로 비즈니스 사용자는 자연어를 사용해 여러 클라우드에 있는 레코드를 쿼리할 수 있으며, 에이전트는 추론을 그라운딩하고 비즈니스 워크플로를 실행할 수 있습니다. 이제 정식 버전으로 제공되는 AWS 및 Azure용 Cross-Cloud Interconnect 및 캐싱을 사용하면 비공개 보안 연결을 통해 클라우드 간에 데이터를 쿼리할 수 있으며 가변적인 이그레스 비용이 발생하지 않습니다. 원격 클라우드 데이터를 쿼리하면 레이크하우스가 검색된 데이터 블록을 Google Cloud 내에 로컬로 자동 캐시합니다. 또한 고객은 Databricks Unity, Snowflake Horizon, AWS Glue와의 개방형 Iceberg 카탈로그 제휴뿐만 아니라 SAP, Workday, Salesforce와의 제로 카피 통합도 사용할 수 있습니다.
AI에 컨텍스트를 제공하기 위해 경계 없는 레이크하우스는 Knowledge Catalog와 직접 통합되어 클라우드 스토리지에 분산된 비정형 데이터를 자동으로 색인화합니다. 이를 통해 에이전트는 정확성을 유지하는 데 필요한 컨텍스트를 확보할 수 있으며, 토큰 비용을 관리하여 지능적이고 지속 가능한 에이전트 전략을 수립할 수 있습니다.
"Delivery Hero의 talabat은 Amazon S3 테이블의 단일 사본 Apache Iceberg 데이터를 BigQuery에 제휴하는 경계 없는 레이크하우스를 구현하여 데이터 이동 비용을 약 40% 절감하는 동시에 스트리밍 트랜잭션 이벤트가 생성된 후 몇 분 이내에 두 클라우드에서 모두 쿼리할 수 있게 되었습니다." - Harish Ramesh, Delivery Hero talabat 선임 데이터 엔지니어
에이전트가 즉각적인 조치를 취하려면 과거 분석 데이터와 실시간 트랜잭션 데이터에 동시에 액세스할 수 있어야 합니다. 이에 따라 오늘 Google Cloud는 경계 없는 레이크하우스와 통합된 새로운 AlloyDB를 발표합니다. AlloyDB의 직접 Iceberg 액세스를 사용하면 이제 ETL 파이프라인이나 복사본 없이 클라우드 스토리지에 저장된 Iceberg 테이블을 직접 쿼리하고 단일 PostgreSQL 쿼리에서 실시간 운영 데이터를 과거 레이크하우스 데이터와 조인할 수 있습니다. AlloyDB의 트랜잭션 기능과 직접적인 Iceberg 테이블 액세스를 결합하면 시스템이 트랜잭션 데이터와 분석 데이터를 효율적으로 연결하여 에이전트의 엄격한 요구사항을 충족할 수 있습니다. 이 기능은 Lakehouse 런타임 카탈로그와 완전히 통합되어 AlloyDB에 Iceberg 테이블을 다른 테이블과 함께 등록할 수 있습니다. 모든 항목이 Knowledge Catalog에 자동으로 표시되므로 에이전트가 동일한 거버넌스 적용 컨텍스트를 얻을 수 있습니다. AlloyDB의 Iceberg 직접 액세스는 집계 쿼리에서 Amazon의 동급 PostgreSQL 호환 서비스보다 최대 7배 더 빠릅니다.
이러한 경계 없는 전략을 완성하는 정식 버전의 Spanner Omni는 온프레미스, 에지 노드, 멀티 클라우드 환경 전반에서 하이브리드 에이전트형 애플리케이션에 Google 수준의 일관성, 확장성, 멀티 모델 기능을 제공합니다.
엔터프라이즈 컨텍스트에 모든 에이전트를 그라운딩하여 정확하고 신뢰할 수 있는 답변 제공
에이전트의 정확성은 그라운딩된 비즈니스 컨텍스트에 따라 달라집니다.Knowledge Catalog는 Google Cloud의 범용 컨텍스트 엔진으로, 원시 데이터를 공유 비즈니스 컨텍스트로 변환하여 에이전트가 더 높은 정확성, 신뢰성, 토큰 효율성을 바탕으로 답변하고 작업을 수행할 수 있도록 지원합니다. 오늘 Google Cloud는 자체 학습, 재사용 가능한 컨텍스트 세트, 새롭게 설계된 사용자 경험을 통해 AI 기반 컨텍스트 큐레이션 기능을 확장하여 Knowledge Catalog를 한 단계 더 발전시켰습니다. 이를 통해 컨텍스트 레이어가 비즈니스의 변화에 맞춰 자동으로 빌드되고 발전하는 동시에 사용자가 데이터 거버넌스를 완전히 제어할 수 있습니다. 내부 벤치마크에 따르면 Knowledge Catalog는 AI 에이전트의 정확성을 약 4배 높이고 지연 시간을 최대 33% 줄이며 토큰 사용량을 최대 75% 줄입니다.
기업의 조직 지식 중 상당 부분은 데이터베이스 외부의 운영 플레이북, 문서, 티켓에 존재하며, 에이전트의 컨텍스트는 사람들이 실제로 질문하는 내용을 중심으로 큐레이션해야 합니다. 프리뷰 버전으로 제공되는 Knowledge Catalog의 새로운 자체 학습 보강 기능을 사용하면 에이전트가 컨텍스트 큐레이션이라는 까다로운 작업을 수행할 수 있습니다. Knowledge Catalog는 Google Workspace, GitHub, Jira, Confluence, SharePoint와 같은 비정형 소스를 지속적으로 마이닝하여 사용자 의도와 사람 및 에이전트의 모든 상호작용을 학습함으로써 컨텍스트 격차를 해소하고 컨텍스트를 자동으로 발전시킵니다. 또한 도메인 지식을 재사용 가능한 Open Knowledge Format(OKF) 컨텍스트 세트로 패키징하여 컨텍스트 엔지니어와 데이터 관리 책임자가 이렇게 보강된 컨텍스트를 손쉽게 관리할 수 있도록 지원합니다. 데이터 관리 책임자와 데이터팀을 위해 프리뷰 버전으로 제공되는 Knowledge Catalog의 새로운 스튜디오 환경도 도입했습니다. 이 환경은 자연어로 컨텍스트를 탐색하고, 클라우드 환경과 SaaS 애플리케이션 전반에서 전체 데이터 자산을 시각화하며, 전체 버전 관리 및 롤백을 통해 제안된 보강 업데이트를 검토, 감사, 승인할 수 있는 대화형 사용자 인터페이스를 제공합니다.
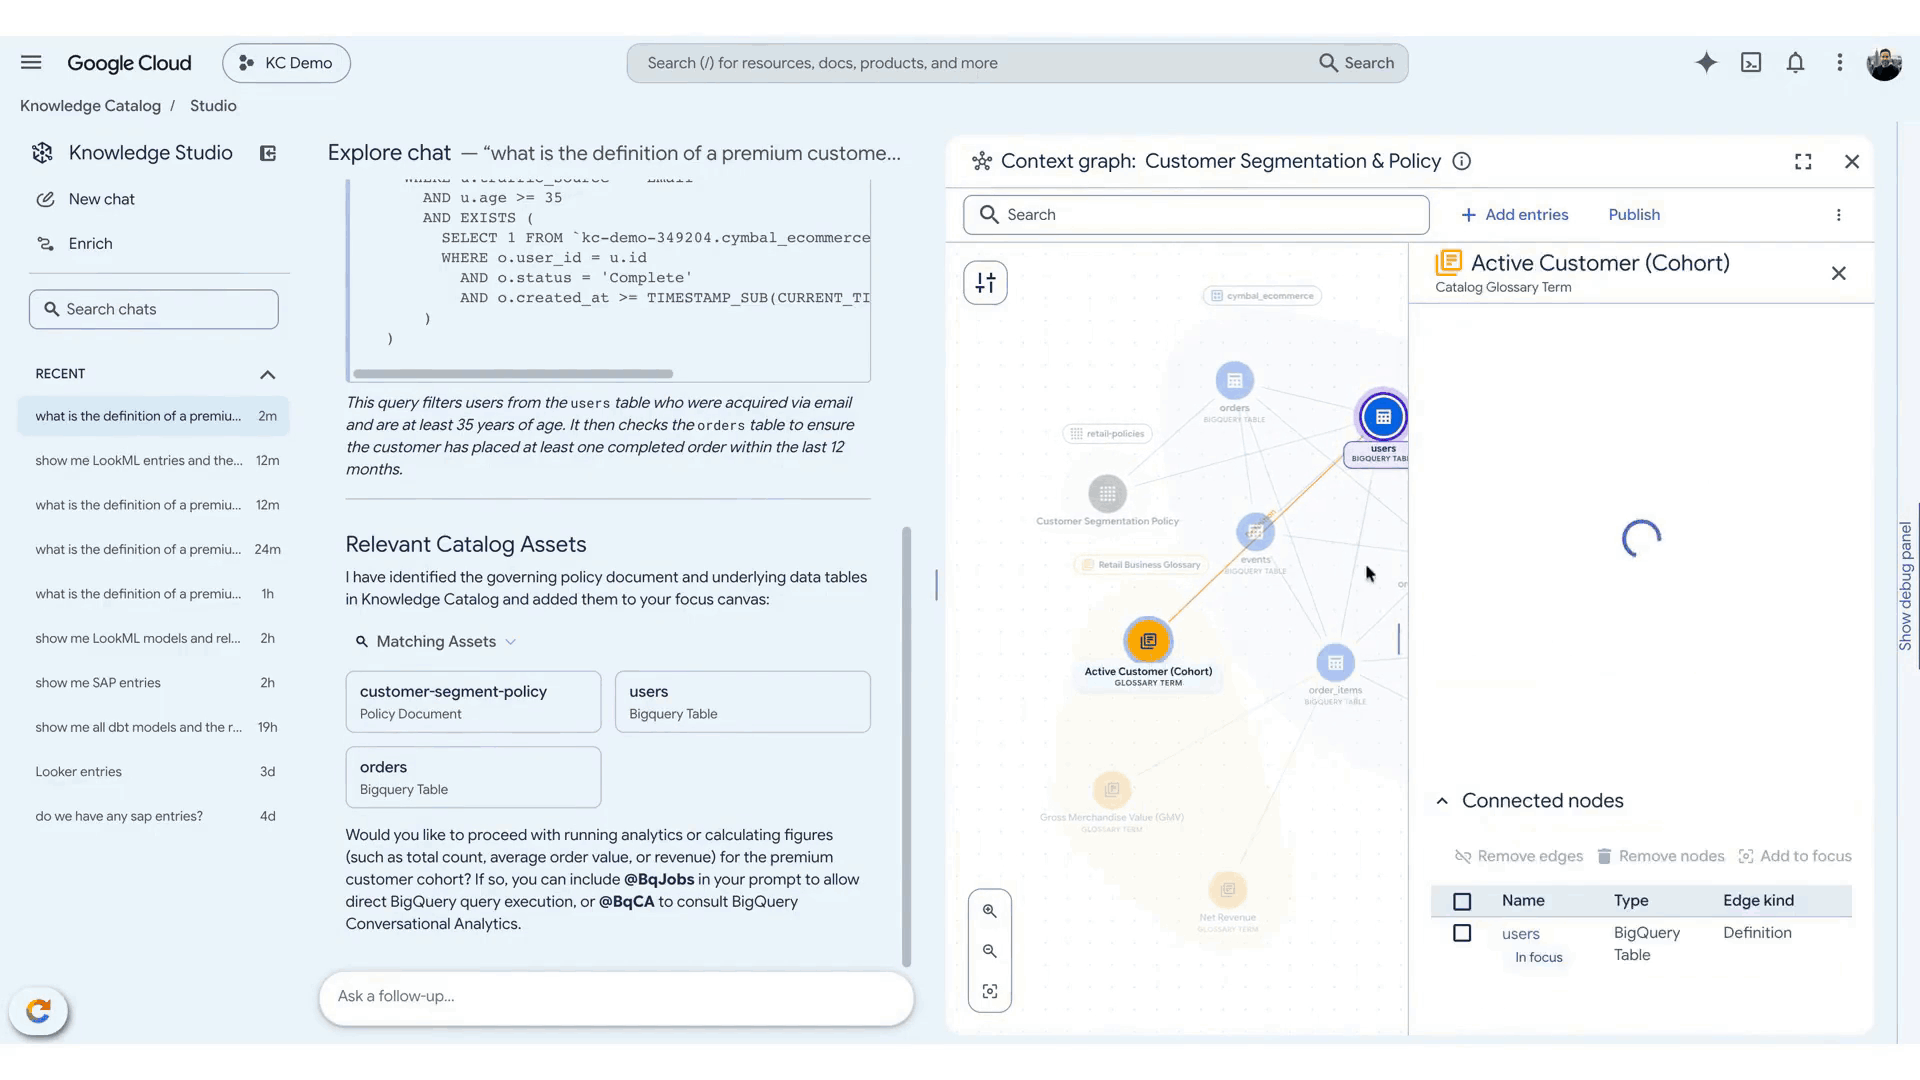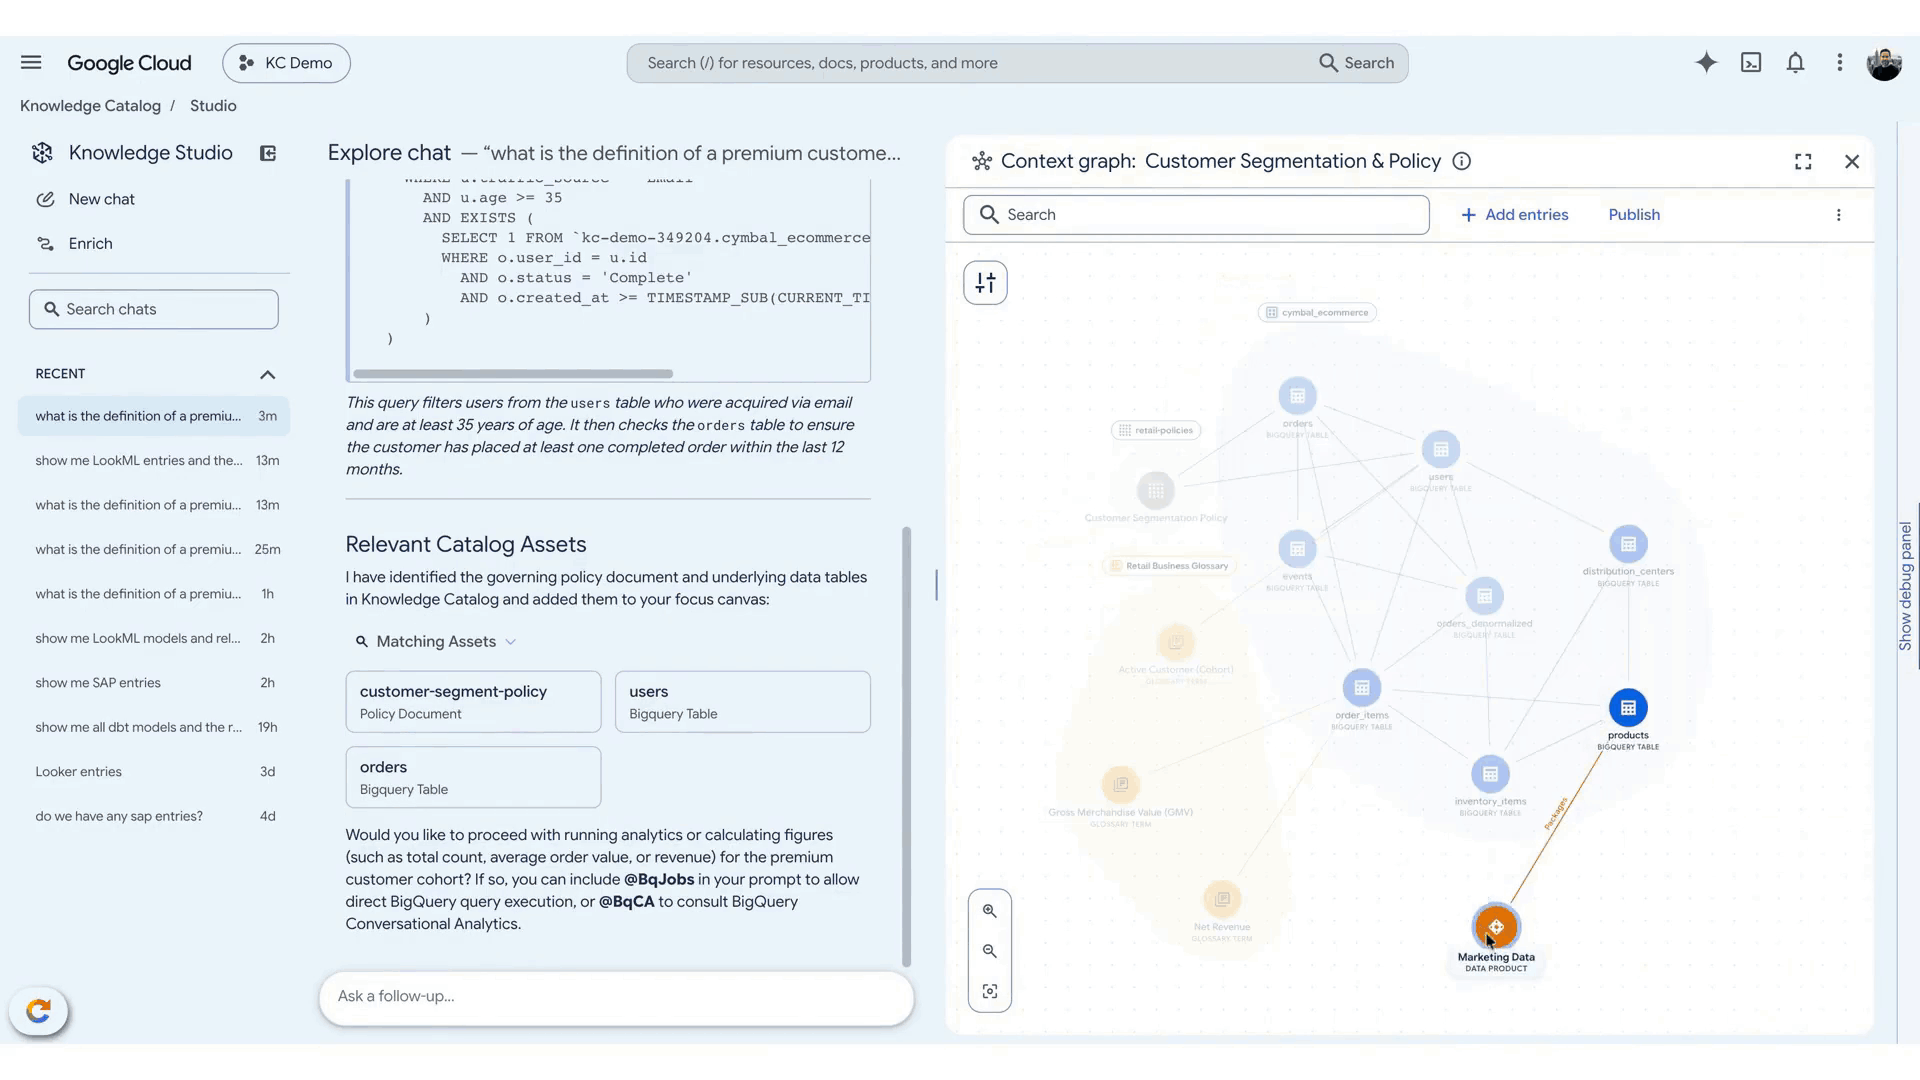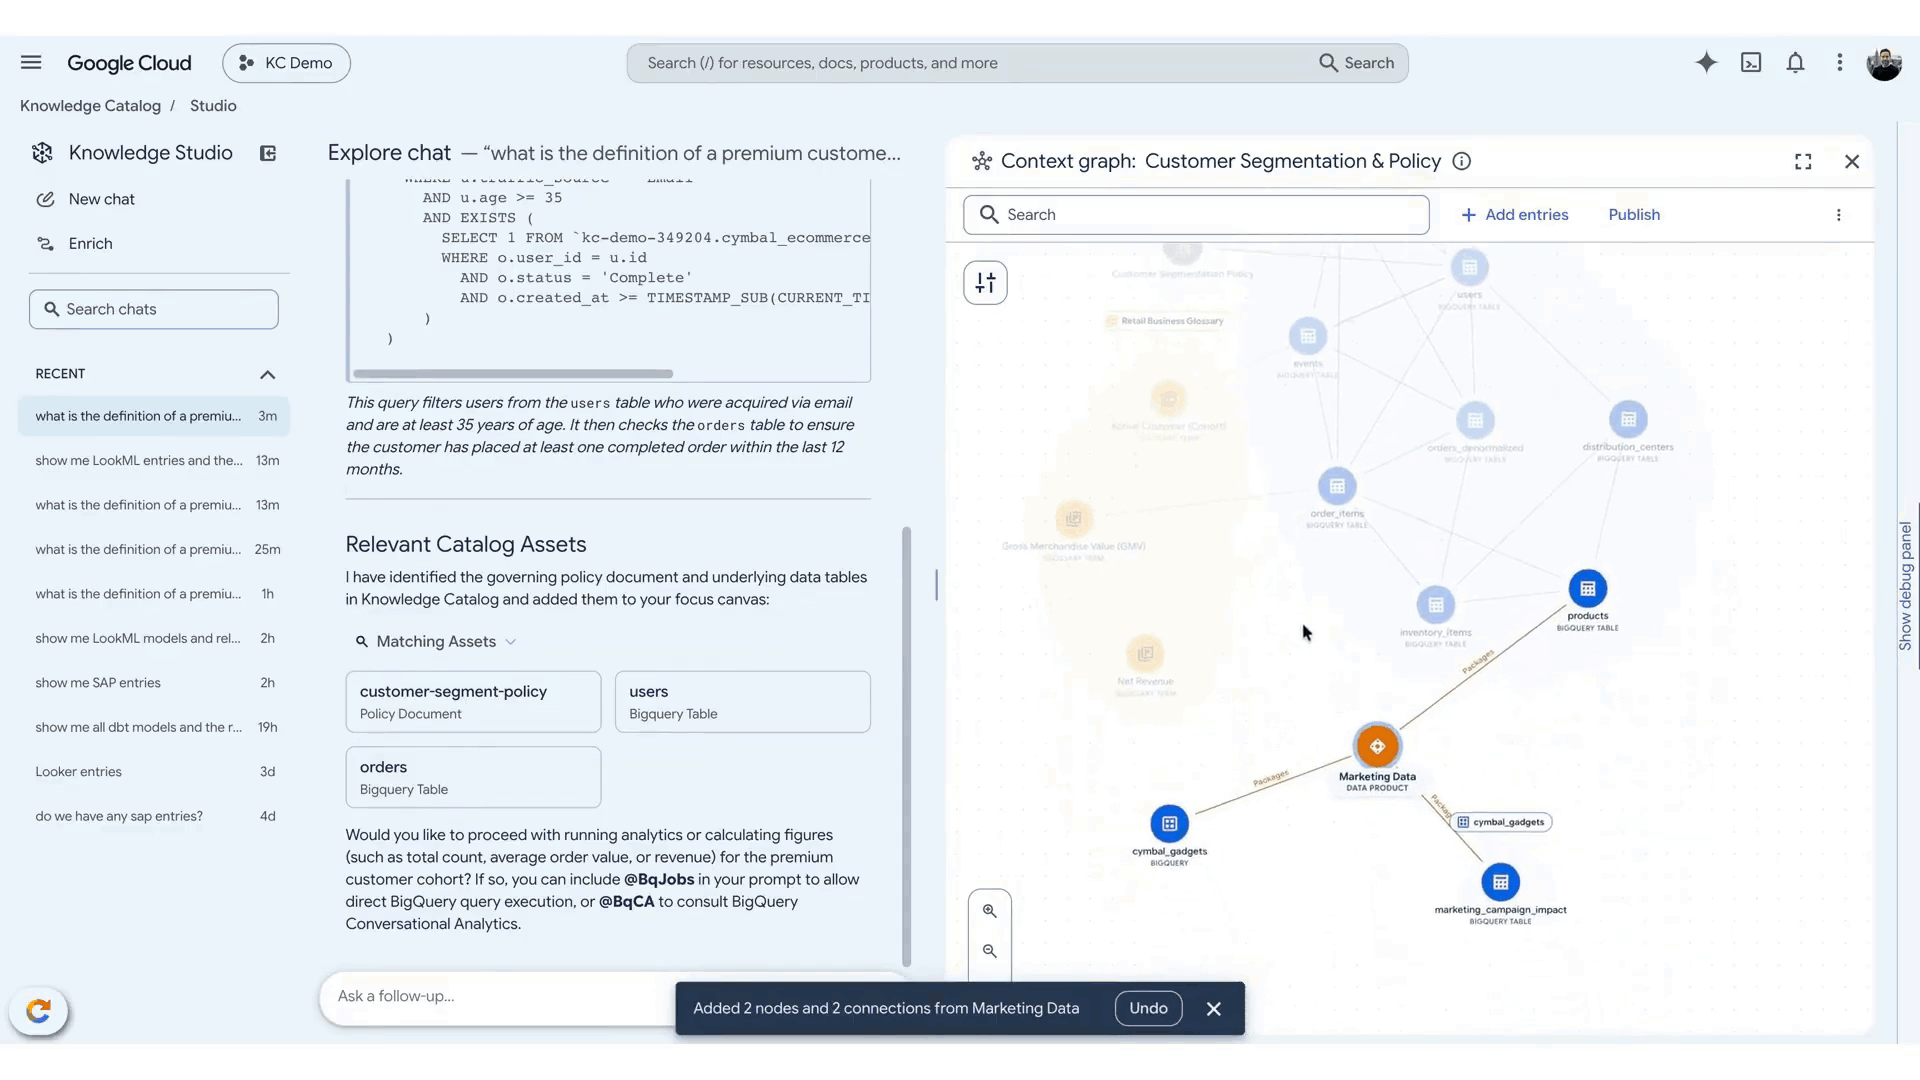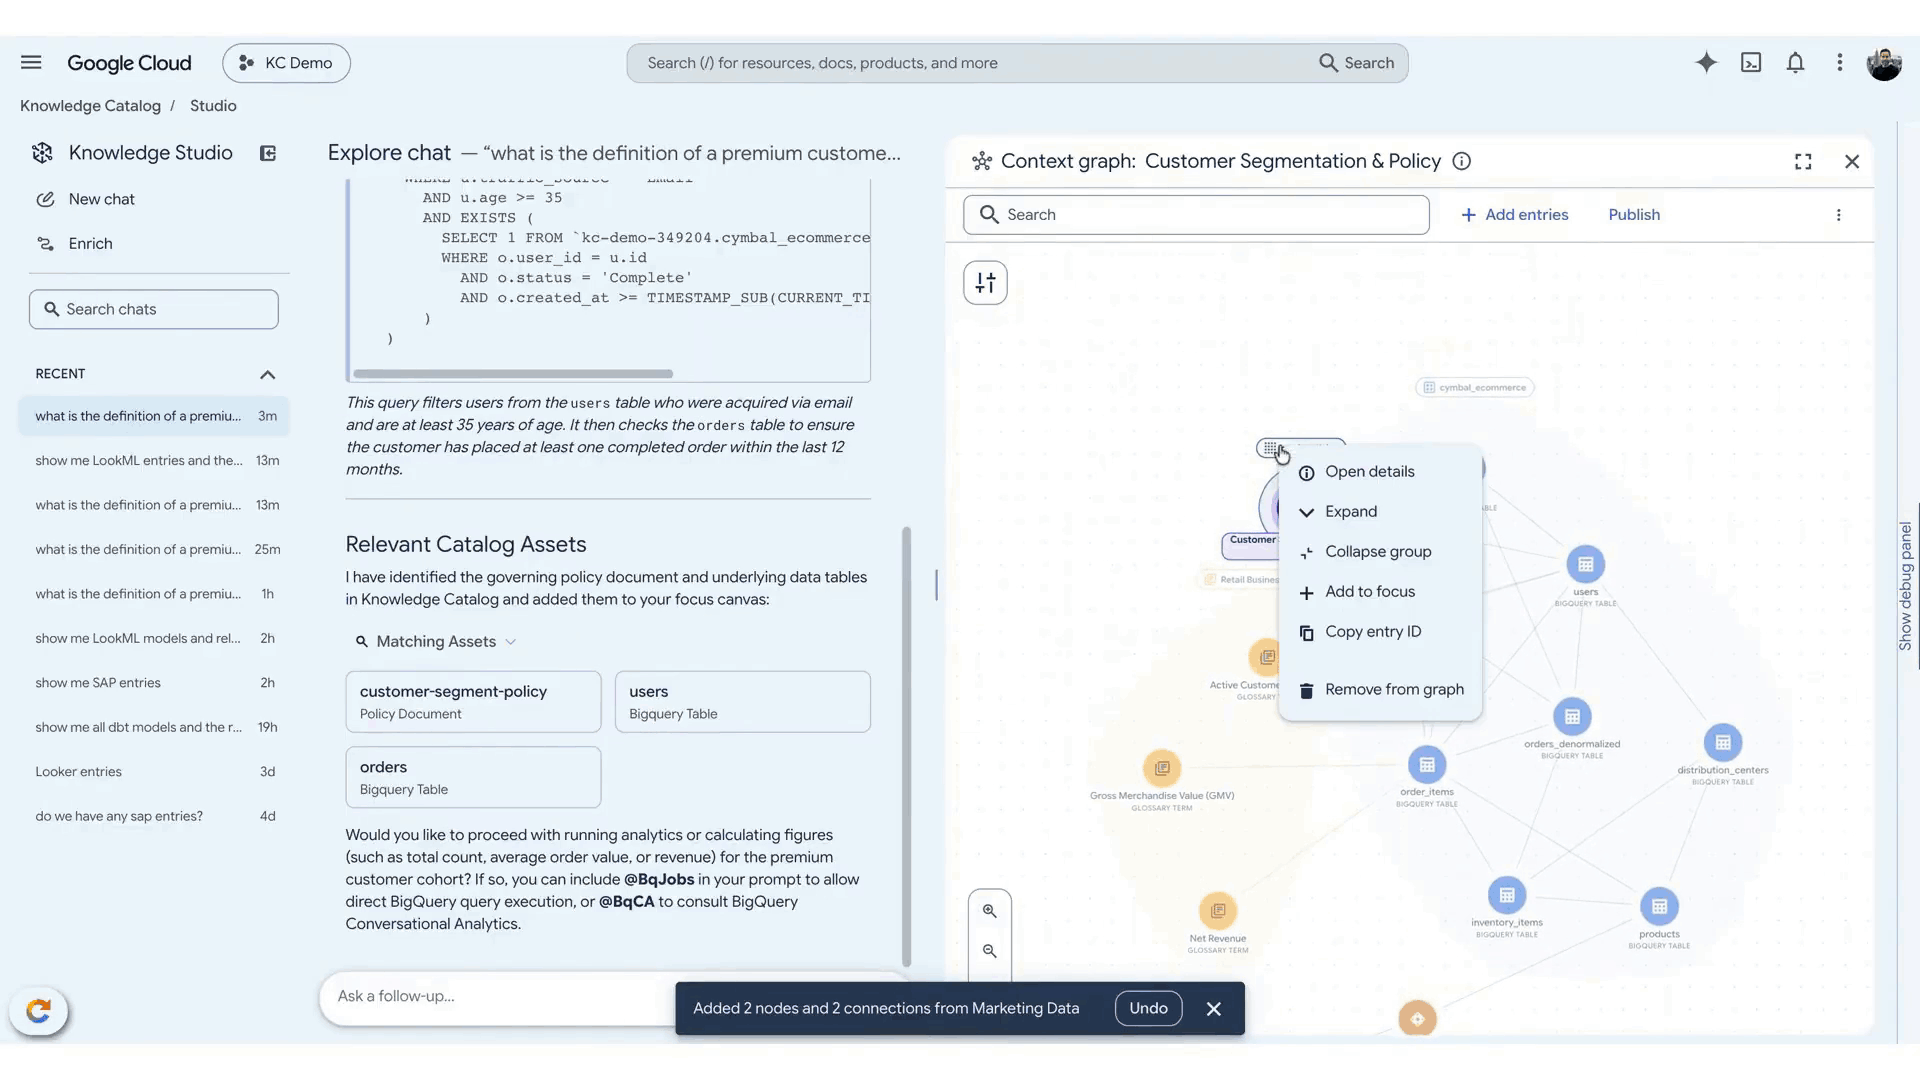
대화형 컨텍스트 탐색과 상호작용형 그래프를 보여주는 Knowledge Catalog의 새로운 스튜디오 환경
또한 이제 Gemini에서 프리뷰 버전으로 제공되었던 Knowledge Catalog가 기본적으로 사용 설정된다는 소식도 발표했습니다. 이제 모든 데이터 관련 질문이 거버넌스가 적용된 비즈니스 컨텍스트에 자동으로 그라운딩됩니다. BigQuery, AlloyDB, Cloud SQL 또는 Spanner를 연결하면 Knowledge Catalog가 각 사용자의 액세스 권한에 따라 SQL을 생성하기 전에 비즈니스 용어를 확인하고, 신뢰할 수 있는 테이블을 찾고, 조인 경로를 결정합니다. 이를 통해 조직은 에이전트가 공유되고 등록된 컨텍스트 세트를 활용하여 일관된 정확성, 짧은 지연 시간, 토큰 비용 절감을 실현할 수 있으므로 엔터프라이즈 규모로 에이전트를 배포할 수 있다는 확신을 갖게 됩니다.
마지막으로, 중요한 비즈니스 정의를 LLM의 추측에 맡길 수 없기 때문에 Knowledge Catalog는 데이터를 이동하지 않고도 BigQuery, Looker(LookML), Databricks, Snowflake, dbt, SAP의 신뢰할 수 있는 시맨틱 모델에 에이전트를 그라운딩하며, 이 기능은 현재 정식 버전으로 제공됩니다. 에이전트가 재무팀을 위해 순수익을 계산하든 운영팀을 위해 고객 이탈을 계산하든, 비즈니스팀이 신뢰하는 것과 정확히 동일한 거버넌스 적용 공식을 사용합니다. 또한 Knowledge Catalog는 메타데이터 검색 및 제휴를 Oracle AI Database@Google Cloud, Snowflake, Databricks Unity Catalog와 Atlan 및 Collibra 등의 서드 파티 카탈로그로 확장하여 이미 투자한 카탈로그를 기반으로 모든 에이전트가 전체 데이터 자산을 보편적으로 이해할 수 있도록 합니다.
에이전트를 통한 실무자 경험 혁신
Google Cloud는 데이터 전문가와 비즈니스팀의 업무 방식을 재정의하고 있습니다. 보조 어시스턴트의 지원을 받으며 개별적으로 업무를 수행하던 실무자들을 이제 의도 기반 비즈니스 성과를 이끌어내는 자율 에이전트의 오케스트레이터로 격상시키고 있습니다.
최근에 열린 Gemini at Work 이벤트에서 Google Cloud는 기술팀과 일반 비즈니스 사용자를 위해 Gemini에 두 가지 새로운 특화 기능을 도입했습니다. 데이터 및 ML 엔지니어를 위해 Google Cloud는 모든 데이터 과학자와 데이터 엔지니어를 지원하는 머신러닝 스킬과 도구를 통해 Gemini를 확장하고 있습니다. 엔지니어가 원하는 결과를 일상적인 언어로 설명하면 Gemini가 PySpark 코드를 생성하고, 이를 편집하고 테스트할 수 있는 노트북을 제공하고, 모델을 학습시키고, 파이프라인 문제를 스스로 진단하고 수정합니다. 비즈니스 사용자의 경우 조직의 누구나 질문만 하면 신뢰할 수 있는 실시간 운영 보고서를 생성할 수 있습니다. Gemini는 BigQuery 및 Knowledge Catalog와 통합된 운영 보고 스킬을 사용하여 쿼리를 구성하고 저장합니다. 한 번 저장된 보고서는 필요할 때마다 언제든지 추가 토큰 비용 없이 다시 실행할 수 있으며, 매번 일관되고 검증된 답변을 얻을 수 있습니다.
자체 도구를 사용하려는 개발자를 위해 최근 Data Agent Kit의 정식 버전이 출시되었습니다. 이 도구는 Google 데이터 클라우드 도구를 VS Code, Claude Code, Antigravity와 같이 개발자가 선호하는 IDE 및 CLI에 직접 통합하여 콘솔 간 이동과 ETL 상용구 작성의 필요성을 없애줍니다. 실무자는 네이티브 MCP 도구를 활용하여 비즈니스 의도를 정의하고 에이전트가 데이터 파이프라인을 생성, 조정, 테스트하도록 할 수 있습니다.
에이전트 규모에 맞게 빌드된 데이터 인프라 엔지니어링
조직이 워크플로 전반에서 협업하는 수백만 개의 에이전트로 확장함에 따라 기존 데이터베이스 아키텍처는 한계에 직면하고 있습니다. 이에 에이전트 규모에 맞게 특별히 설계된 맞춤형 인프라를 소개합니다.
빠른 테스트와 프로토타입 제작을 가속화하기 위해 오늘 AlloyDB Express프리뷰 버전을 발표합니다. 이는 매우 빠른 개발 속도가 필요한 빌더와 코딩 에이전트를 위해 설계된 새로운 AlloyDB 버전입니다. 2초 미만의 즉각적인 프로비저닝, Scale-to-zero 방식의 일시중지 및 재개, 안전한 비공개 IP 연결, 통합된 관측 가능성 기능을 제공하며, 1~2개의 vCPU와 20GB의 스토리지를 사용하는 소규모 공간 구성도 지원합니다. 이제 AlloyDB는 에이전트 개발 및 테스트를 위한 개발자 중심의 PostgreSQL 환경을 제공합니다.
프로덕션 환경을 위해 최근 프리뷰 버전으로 발표된 AlloyDB의 에이전트용 PostgreSQL은 수천 개의 협업 AI 에이전트가 완전한 워크로드 격리를 통해 실시간 트랜잭션 데이터를 쿼리할 수 있도록 지원합니다. 에이전트형 데이터베이스 아키텍처를 통해 에이전트는 밀리초 미만의 I/O와 초당 테라비트의 합산된 스캔 처리량을 달성하여 초당 300만 개 이상의 쿼리를 지원할 수 있습니다. 컴퓨팅은 활성 추론 세션에 따라 자동으로 확장되며, 유휴 상태일 때는 프로덕션 시스템에 영향을 주지 않고 0으로 축소됩니다.
오픈소스 데이터 인프라를 실행하는 경우 Managed Service for Apache Spark는 Lightning Engine의 추가 개선을 통해 시중의 대안 솔루션보다 가격 대비 성능이 3배 이상 뛰어난 이점을 제공합니다. Spark 4.0의 최근 개선사항에는 추가 비용 없이 시작 시간을 단축하는 기능이 포함되어 있어 대화형 워크로드와 소규모 배치 ETL 작업에 유용합니다. 또한 프리미엄 등급은 업그레이드된 하드웨어와 Lightning Engine의 소프트웨어 가속을 결합하여 성능을 향상시키며, 이 기능은 기본적으로 사용 설정되어 있습니다.
마지막으로, Google Cloud는 에이전트 규모에 맞게 BigQuery를 지속적으로 개선했습니다. 지난 한 해 동안 Google Cloud는 유연한 확장, 기본 제공되는 워크로드 가속화와 같은 지능형 최적화를 통해 쿼리 속도를 40% 이상 높이고 쿼리 처리 비용을 50% 이상 절감했습니다.BigQuery Graph가 정식 버전으로 출시되어 ETL 없이 관계형 테이블에서 직접 페타바이트 규모의 그래프 분석을 수행할 수 있습니다. 조직은 데이터를 노드와 에지로 모델링하여 데이터를 별도의 그래프 데이터베이스로 이동하지 않고도 복잡하고 숨겨진 관계를 발견할 수 있습니다. 오늘부터 Google 연구팀의 새로운 모델 두 가지가 BigQuery에서 기본적으로 실행됩니다. 첫 번째는 현재 프리뷰 버전으로 제공되는 TimesFM 3.0으로, 학습시키거나 관리할 커스텀 모델 없이 SQL에서 직접 예측을 생성할 수 있습니다. 두 번째는 역시 프리뷰 버전으로 제공되는 TabFM으로, 예측 머신러닝을 BigQuery에 직접 가져옵니다.
지금 시작하기
이러한 발표 외에도 Google Cloud는 더 광범위한 데이터 생태계 전반에서 핵심 성능, 비용 관리, 운영 복원력을 지속적으로 개선하고 있습니다.
데이터 자산을 능동적인 실행 시스템으로 전환할 준비가 되셨나요? Google Cloud의 에이전트형 데이터 클라우드 페이지를 살펴보고, 데이터 전략 워크숍에 등록하고, Google Cloud와 함께 무료로 에이전트형 엔터프라이즈를 구축해 보세요.
Trusted Agents, Real Outcomes 디지털 이벤트에서 에이전트형 데이터 클라우드의 비전과 최신 혁신 기술을 확인하실 수도 있습니다. 포트폴리오의 실제 작동 방식을 확인하고, Yahoo의 실제 청사진을 통해 배우고, 데이터베이스, 데이터 분석, BI 전반의 제품 리더들이 진행하는 심층 분석 세션을 살펴보세요.