PostgreSQL용 AlloyDB에서 직접 Iceberg 액세스를 통해 운영 데이터와 Lakehouse 데이터 통합
Nikhil Gaekwad
Product Management Lead, Databases
Bala Narasimhan
Group Product Manager, Databases
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
올바른 비즈니스 의사 결정을 내리려면 운영 데이터베이스의 실시간 비즈니스 상태와 레이크하우스 또는 데이터 웨어하우스와 같은 분석 시스템에 저장된 과거 컨텍스트라는 두 가지 종류의 데이터가 필요합니다. 전통적으로 이러한 시스템은 분리되어 있었지만, 이제는 빠르게 통합되고 있습니다. 이에 따라 오늘 PostgreSQL용 AlloyDB에서 Iceberg에 직접 액세스하는 기능의 프리뷰 버전을 발표합니다. 이제 개발자는 단일 SQL 쿼리만으로 AlloyDB에서 직접 Cloud Storage 버킷에 저장된 Apache Iceberg 테이블을 쿼리하고 이를 실시간 운영 데이터와 조인할 수 있습니다.
또한 AlloyDB 동기화 및 Lakehouse 제휴의 정식 버전을 발표합니다. 이러한 기능을 통해 AlloyDB는 경계 없는 Lakehouse와 세 가지 방식으로 연동할 수 있으며, 이를 통해 모든 엔진에서 데이터의 개방형 사본 하나를 사용할 수 있습니다.예를 들어 Etsy는 경계 없는 Lakehouse로 3페타바이트의 데이터를 통합하여 데이터를 이동 없이 조인함으로써 파이프라인 쿼리 속도를 60% 향상했습니다. AlloyDB에서 사용할 접근 방식은 데이터가 있는 위치와 애플리케이션이 데이터를 읽는 방식에 따라 달라집니다.
-
직접 Iceberg 액세스: AlloyDB 열 기반 엔진으로 가속화된 Iceberg 테이블을 그대로 읽을 수 있습니다.
-
AlloyDB 동기화: 지연 시간에 가장 민감한 워크로드를 위해 AlloyDB에서 레이크하우스 데이터를 제공하며, 사용자가 설정한 일정에 따라 데이터가 새로고침됩니다.
-
Lakehouse 제휴: BigQuery에서 처리를 수행하여 네이티브 BigQuery 테이블을 그대로 쿼리합니다.
이번 출시를 통해 앱과 에이전트는 커스텀 파이프라인을 빌드하거나 관리하지 않고도 운영 데이터와 레이크하우스 데이터를 함께 처리할 수 있습니다.
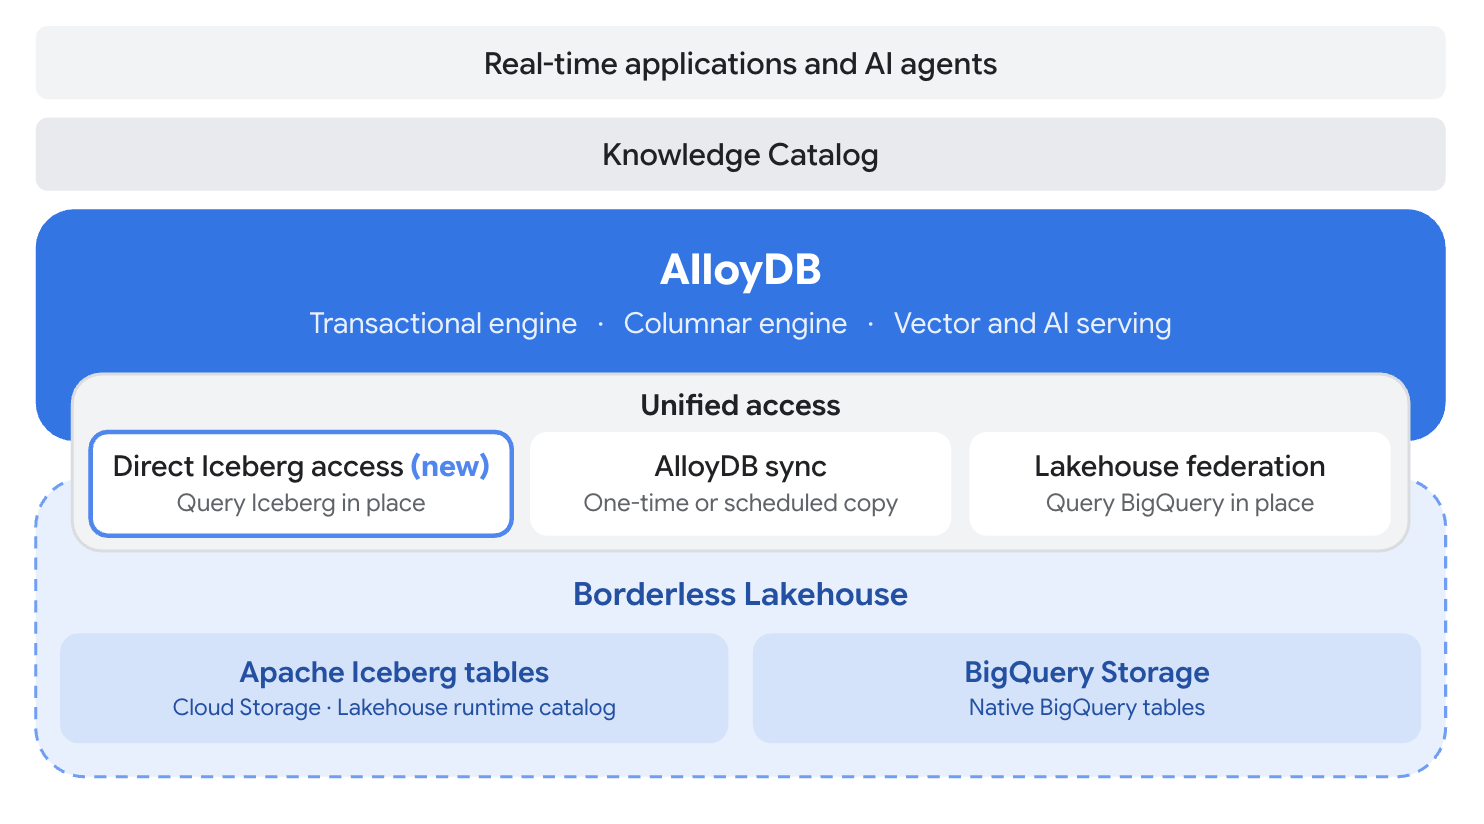
AlloyDB 및 경계 없는 Lakehouse: Apache Iceberg 및 BigQuery 데이터를 제자리에서 쿼리하거나 AlloyDB에 동기화하여 실시간 애플리케이션과 AI 에이전트가 운영 데이터와 레이크하우스 데이터에 함께 액세스할 수 있도록 제어합니다.
조치 시점의 의사 결정
AlloyDB와 경계 없는 Lakehouse 간의 이러한 통합을 통해 과거 컨텍스트가 실시간 트랜잭션과 함께 제공되므로 커스텀 파이프라인을 빌드하거나 관리할 필요 없이 작업 시점에 의사 결정을 내릴 수 있습니다. 예를 들면 다음과 같습니다.
-
사기 및 위험: 사기 방지 에이전트가 결제를 승인하기 전에 데이터베이스에 저장된 최근 30일 기록 외에도 Iceberg에서 5년간의 고객 거래 내역을 대조하여 확인합니다.
-
맞춤설정: 쇼핑 에이전트가 쇼핑객이 페이지에 머무는 동안 레이크하우스에 저장된 평생 가치 및 반품 내역과 실시간 장바구니 데이터를 결합하여 적절한 혜택을 선택합니다.
-
유동 가격: 가격 책정 에이전트가 AlloyDB의 실시간 인벤토리와 레이크하우스에 저장된 수년간의 수요 및 날씨 기록을 결합하여 상황 변화에 따라 가격을 조정합니다.
-
데이터 제품: 데이터팀이 선별된 테이블을 Iceberg에 한 번만 게시하면 수십 개의 애플리케이션이 각자 사본을 유지할 필요 없이 그대로 테이블을 읽습니다.
각각의 경우 기록은 레이크하우스에 유지되고 의사 결정은 데이터베이스에서 이루어집니다. 에이전트는 AlloyDB에서 사용자가 부여한 테이블과 권한만 사용하여 사용자를 대신해 작업을 수행합니다.
세 가지 통합 방식을 각각 자세히 살펴보겠습니다.
AlloyDB에서 직접 Iceberg 액세스(프리뷰)
직접 Iceberg 액세스를 사용하면 AlloyDB가 버킷 경로 또는 Lakehouse 런타임 카탈로그를 사용하여 Cloud Storage에서 직접 Apache Iceberg 테이블을 읽습니다. Iceberg 테이블을 한 번만 등록하면 실시간 운영 테이블과의 조인을 포함하여 다른 PostgreSQL 테이블과 마찬가지로 쿼리할 수 있습니다.
AlloyDB는 Iceberg 테이블을 제자리에서 읽고, 나머지 레이크하우스와 동일한 사본을 사용하여 실시간 운영 데이터와 조인합니다.
Iceberg 지원은 AlloyDB에 기본 제공되며 AlloyDB 열 기반 엔진으로 가속화되므로 레이크하우스 데이터에 대한 쿼리가 빠르게 처리됩니다. 이러한 쿼리는 애플리케이션과 동일한 데이터베이스 인스턴스에서 실행되며, 별도의 리더 인스턴스를 관리할 필요가 없고, 팀이 레이크하우스에 게시한 최신 데이터를 읽습니다.
Cloud Storage의 1TB 데이터 세트를 대상으로 한 테스트에서 AlloyDB의 직접 Iceberg 액세스는 집계 쿼리에서 Amazon의 유사한 PostgreSQL 호환 서비스보다 최대 7배 더 빠르고, 오픈소스 PostgreSQL 확장 프로그램보다 최대 3.5배 더 빠른 것으로 나타났습니다.
최저 지연 시간 읽기를 위한 AlloyDB 동기화(정식 버전)
모든 테이블을 제자리에서 읽을 필요는 없습니다. 예를 들어 소매업체 위험 점수는 매 결제 전에 확인되지만, 데이터팀이 야간에 다시 계산할 때만 변경됩니다. 이와 같이 모든 요청에서 읽고 일정에 따라 새로고침되는 데이터는 AlloyDB의 로컬 테이블로 관리할 때 가장 빠르게 처리됩니다. 문제는 별도의 파이프라인을 빌드하고 유지보수하지 않고도 해당 사본을 최신 상태로 유지하는 것입니다.
AlloyDB 동기화는 BigQuery에서 AlloyDB로 레이크하우스 데이터를 한 번 또는 일정에 따라 복사하고 최신 상태로 유지합니다. 이 사본은 로컬 AlloyDB 테이블이므로 앱에서 다른 테이블만큼 빠르게 읽을 수 있으며, 색인을 생성하거나, 읽기 풀에서 제공하거나, 열 기반 엔진 및 벡터 검색과 함께 사용할 수 있습니다. BigQuery 콘솔 또는 SQL에서 클릭 한 번으로 동기화를 시작할 수 있습니다.
Lakehouse 제휴(정식 버전)
이미 BigQuery에 수년간의 분석 기록이 축적된 조직의 경우 Lakehouse 제휴를 통해 AlloyDB가 네이티브 BigQuery 테이블을 제자리에서 쿼리하고, 단일 쿼리로 실시간 운영 데이터와 조인할 수 있습니다. AlloyDB는 필터, 집계, 제한을 BigQuery로 푸시하고, BigQuery는 대부분의 처리를 수행하고 결과만 다시 전송합니다. 또한 이러한 쿼리에 대해 비용이 청구되는 프로젝트를 설정하고 쿼리를 사용할 수 있는 역할을 제한할 수 있습니다.
Loyal Guru와 같은 Google Cloud 고객들이 이미 이러한 방식으로 AlloyDB와 BigQuery를 함께 사용하고 있습니다.
"AlloyDB는 BigQuery와 같은 다른 Google Cloud 제품과 함께 단순한 대응을 넘어 플랫폼 기능을 지속적으로 개선하고 새로운 트렌드를 예측하는 데 필요한 민첩성과 성능을 제공합니다." - 하비 페르난데스, Loyal Guru 공동 설립자 겸 CTO
적절한 접근 방식을 선택하고 시작하세요
운영 시스템과 분석 시스템의 융합이 일어나고 있습니다. Google Cloud 환경에서 이 접근 방식을 선택하는 방법은 사용 사례에 따라 다릅니다.
-
직접 Iceberg 액세스: 앱이 Iceberg의 과거 데이터를 실시간 데이터와 조인할 때 가장 적합하며, AlloyDB 열 기반 엔진으로 가속화됩니다.
-
사용해 보기: PostgreSQL 18 인스턴스에서 직접 Iceberg 액세스를 사용 설정하고 AlloyDB에서 Iceberg 데이터에 액세스해 보세요.
-
AlloyDB 동기화: 앱이 지속적으로 읽고 가장 짧은 지연 시간이 필요한 테이블에 가장 적합합니다. 사본은 마지막 새로고침 시점의 최신 상태입니다.
-
빌드: BigQuery에서 테이블을 선택하고 Google Cloud 콘솔 또는 psql을 사용하여 AlloyDB에 동기화하도록 설정합니다.
-
Lakehouse 제휴: BigQuery 테이블에 저장되어 BigQuery에서 처리되는 네이티브 기록에 가장 적합합니다.
-
시작하기: BigQuery의 실시간 데이터에 대한 AlloyDB 액세스 구성을 따르세요.
자세한 내용은 AlloyDB에서 BigQuery 데이터에 액세스하는 방법 선택하기를 참고하세요.