OLAP에서 OLTP로: Copel이 BigQuery의 AlloyDB로 기본 내보내기를 사용하여 역방향 ETL을 간소화한 방법
Jelson A. Cordeiro
Solutions & Cloud Architect, Copel
Vinod Ramachandran
Product Manager, BigQuery
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
분석 시스템(OLAP)과 트랜잭션 데이터베이스(OLTP) 간의 격차를 해소하는 것은 매우 복잡한 작업입니다. 두 시스템 간에 데이터를 동기화하는 것을 흔히 역방향 ETL(추출, 변환, 로드)이라고 하며, 기존에는 특히 엔터프라이즈 규모에서 무거운 미들웨어, 스테이징 버킷, 복잡한 조정이 필요했습니다.
AlloyDB로 BigQuery 내보내기가 정식 버전(GA)으로 출시되었습니다. 이제 데이터 엔지니어링팀은 단일 선언적 SQL 문을 사용하여 BigQuery에서 AlloyDB로 데이터를 내보낼 수 있습니다. 이 접근 방식을 사용하면 복잡한 ETL 미들웨어가 전혀 필요하지 않습니다.
이 기능의 이점을 보여드리기 위해 브라질의 전력 공급업체인 Copel이 고성능의 기본 제공 역방향 ETL로 마이그레이션하여 대규모 조정 병목 현상을 제거하고 스마트 미터 원격 분석을 확장한 방법을 공유합니다.
스마트 미터 원격 분석 확장의 과제
Copel에서 수백만 개의 스마트 전력 미터에서 수집되는 원격 분석 데이터를 관리하는 것은 매우 중요한 작업입니다. 이 데이터는 지속적으로 스트리밍되고 BigQuery의 분석 골드 레이어에 통합됩니다. 그러나 Copel의 '작업 시스템'인 지연 시간이 짧은 고객 지원 대시보드, 모바일 애플리케이션, 운영 결제 시스템을 구동하려면 이 풍부한 데이터 세트를 고성능 트랜잭션 데이터베이스인 PostgreSQL용 AlloyDB에 지속적으로 다시 동기화해야 합니다.
최근까지 Copel은 Google의 Managed Service for Apache Airflow에서 복잡한 DAG를 사용하여 이 역방향 ETL 아키텍처를 조정했습니다. 그러나 BigQuery에서 AlloyDB로 수억 개의 레코드를 보강하고 내보내는 과정에는 불안정하고 중간 단계가 많았습니다.
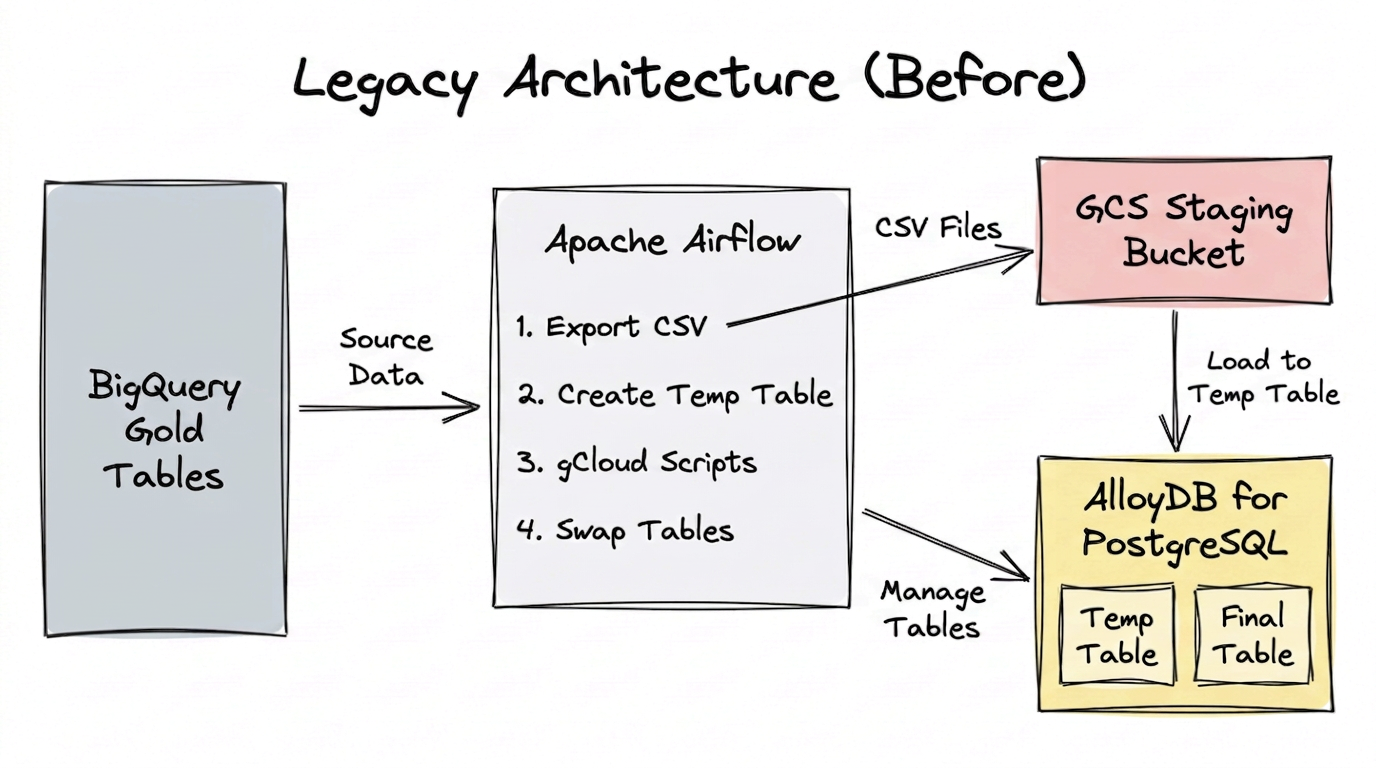
그림 1: Cloud Storage 파일 덤프와 순차적 gCloud 스크립트가 필요한 Copel의 기존 다단계 아키텍처
-
BigQuery는 보강 및 추출 쿼리를 실행하여 SQL 결과를 Google Cloud Storage 버킷 내의 수십 개의 단편화된 CSV 파일에 덤프했습니다.
-
Apache Airflow는 프로덕션 테이블의 쓰기 잠금 또는 데이터 손상을 방지하기 위해 AlloyDB에서 임시 테이블을 만드는 SQL을 실행했습니다.
-
순차적으로 실행되는 gcloud 스크립트가 Cloud Storage의 CSV 파일들을 검색하여 각 AlloyDB 클러스터와 샤드에 데이터를 로드했습니다.
-
마지막으로 SQL 트랜잭션 블록이 프로덕션 테이블을 안전하게 삭제하고 임시 테이블의 이름을 프로덕션으로 변경했습니다.
이 레거시 아키텍처를 운영하기 위해 Copel의 팀은 파이프라인을 유지 관리하고, 파일 스테이징을 세심하게 관리하며, 여러 서비스에 걸쳐 복잡한 IAM 가장을 수행하는 한편, 시스템의 엔드 투 엔드 상태를 지속적으로 모니터링해야 했습니다.
혁신: 기본 제공되는 역방향 ETL
BigQuery의 EXPORT DATA를 AlloyDB에 사용한 덕분에 Copel은 이 전체 다단계 파이프라인 인프라를 하나의 깔끔한 SQL 문으로 대체할 수 있었습니다.
현재 BigQuery의 내보내기 기능은 고도로 최적화된 병렬 연결을 통해 AlloyDB 인스턴스와 직접 통신하므로, Cloud Storage의 스테이징 파일이나 gcloud 스크립트가 필요 없으며, 임시 테이블을 관리할 필요도 없습니다.
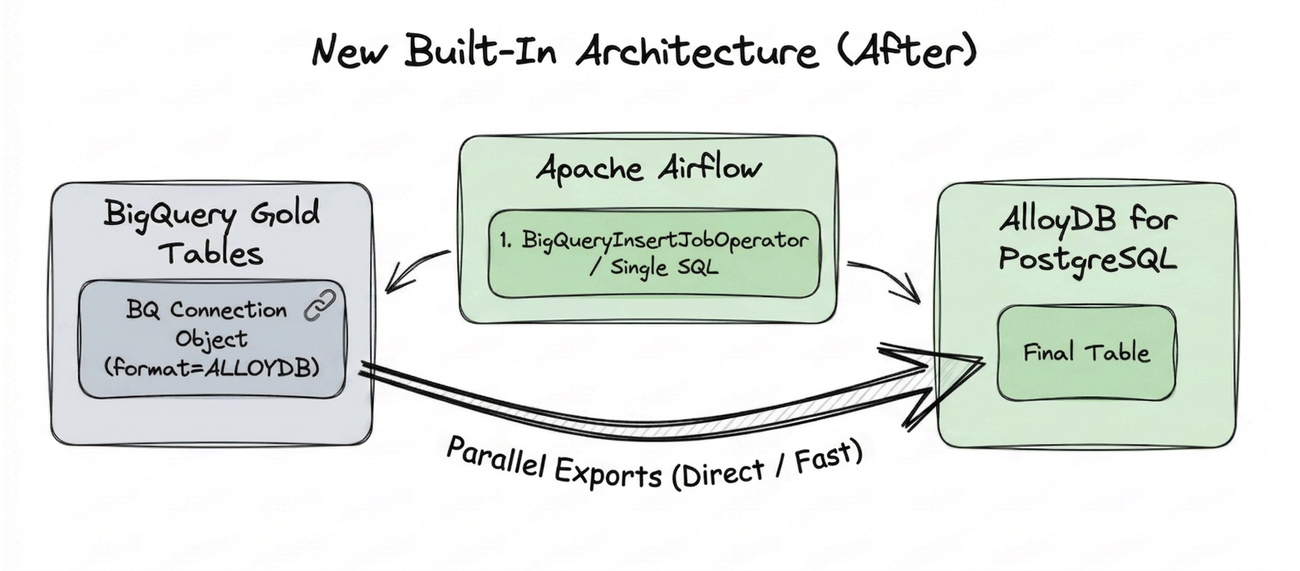
그림 2: BigQuery와 AlloyDB 간의 직접적인 병렬 역방향 ETL 연결을 보여주는 새로운 아키텍처
새로운 역방향 ETL 프로세스를 코드로 보면 다음과 같이 간단합니다.
결과로 생성된 BigQuery 값은 내보내기 중에 AlloyDB의 열에 완벽하게 매핑되므로 중첩된 구조를 PostgreSQL 측에서 완전히 쿼리하고 색인을 생성할 수 있습니다.
성능 및 확장성 평가
이 새로운 아키텍처를 검증하기 위해 Copel은 두 가지 대규모 역방향 ETL 벤치마크를 실시했습니다. 즉, 소규모 증분 역방향 ETL 내보내기와 훨씬 더 큰 규모의 전체 테이블 역방향 ETL 내보내기를 실행하여 각각의 성능과 확장성을 비교했습니다.
성능 결과는 초기 기대치를 모두 뛰어넘었습니다.
수집에 관한 고급 기능 사용 팁: 복잡한 JSONB 원격 분석 필드에서 분당 약 420만 행의 내보내기 처리량을 유지하는 것은 뛰어난 기술적 성과입니다. BigQuery의 분산 처리 엔진과 AlloyDB의 고급 스토리지 계층 간의 하위 수준 최적화를 강조합니다.
핵심 내용 및 이점
이러한 선언적 SQL 접근 방식을 채택함으로써 Copel은 수십 줄의 복잡한 스크립팅과 커스텀 오류 처리 블록을 성공적으로 삭제했습니다. 이제 Airflow DAG에는 내보내기 쿼리를 실행하는 간소화된 단일 BigQueryInsertJobOperator 태스크가 포함됩니다.
이러한 기본 제공 접근 방식은 다음과 같은 몇 가지 핵심 비즈니스 이점을 제공합니다.
-
직접적인 비용 절감: Cloud Storage를 완전히 우회하므로 스테이징 스토리지 비용과 관련 API 읽기/쓰기 작업 수수료가 발생하지 않습니다.
-
향상된 데이터 보안: 데이터가 읽을 수 있는 CSV 파일로 덤프되지 않고 Google의 안전한 내부 네트워크 내에서 BigQuery에서 AlloyDB로 직접 이동합니다.
-
유지보수 최소화: 이제 파이프라인 오류가 단일 SQL 문 내에서만 발생하므로 문제 해결과 로깅이 훨씬 간단해집니다.
-
대규모 분산 쓰기: 직접 내보내기는 BigQuery의 대규모 병렬 처리와 AlloyDB의 최적화된 PostgreSQL 쓰기 성능을 결합하여 분당 400만 개 이상의 레코드를 기록하는 쓰기 속도를 달성했습니다.
이제 데이터 엔지니어링팀은 파이프라인 장애와 중간 스토리지 버퍼를 모니터링하는 데 귀중한 엔지니어링 시간을 허비하는 대신 고객에게 스마트 분석과 프리미엄 경험을 제공하는 중요한 일에 집중할 수 있습니다.
지금 시작하기: 역방향 ETL 현대화
이제 BigQuery의 AlloyDB 내보내기 기능이 정식 버전으로 제공되므로, 데이터 아키텍처를 간소화하기에 더할 나위 없이 좋은 시기입니다. BigQuery 데이터를 다운스트림 OLTP 데이터베이스로 전송하기 위해 복잡한 다단계 파이프라인을 운영하며 어려움을 겪고 계신다면, 지금 바로 AlloyDB, Bigtable, Spanner 또는 Pub/Sub의 기본 제공 내보내기 기능을 사용해 보세요.