BigQuery의 Vertex AI 모델을 사용한 텍스트 생성을 위한 SQL 전용 LLM

Abirami Sukumaran
Staff Developer Advocate
*본 아티클의 원문은 2023년 8월 4일 Google Cloud 블로그(영문)에 게재되었습니다.
많은 코드를 작성하지 않으면서 SQL 쿼리만 사용해서 데이터를 찾고, 보안이나 개인 정보 보호 및 규정 준수 문제에 대해 걱정할 필요 없이 빠르게 생성형 AI 작업을 수행하고 싶은가요? BQML(BigQuery ML)은 Vertex AI에서 대규모 언어 모델(LLM)을 사용하여 BigQuery에 저장된 데이터에 대해 분석을 수행할 수 있도록 도와줍니다. 즉, CSV 파일과 기타 외부 데이터 소스의 데이터에 대해 SQL 전용 LLM 분석을 사용하는 것 이외에도 BigQuery에서 페더레이션을 통해 검색할 수 있는 Cloud SQL과 Spanner 같은 다른 데이터베이스에 저장된 데이터에 대해서도 LLM 기반 분석을 수행할 수 있습니다.
본문에서는 텍스트 생성을 위한 Vertex AI 대규모 언어 모델(text-bison)을 BigQuery의 호스팅 원격 함수로 사용하여 GitHub 저장소의 소스 코드 요약과 저장소의 프로그래밍 언어 식별을 수행하는 단계가 나열되어 있습니다. GitHub Archive Project 덕분에 이제 Google BigQuery 공개 데이터 세트에 280만 개 이상의 오픈소스 GitHub 저장소에 대한 전체 스냅샷이 구비되었습니다.
1. 시작하기 전에 Google Cloud 프로젝트를 만들고, 결제를 사용 설정하고, Cloud Shell을 활성화하고, 필요한 API(BigQuery API, Vertex AI API, BigQuery Connection API)를 사용 설정해야 합니다.
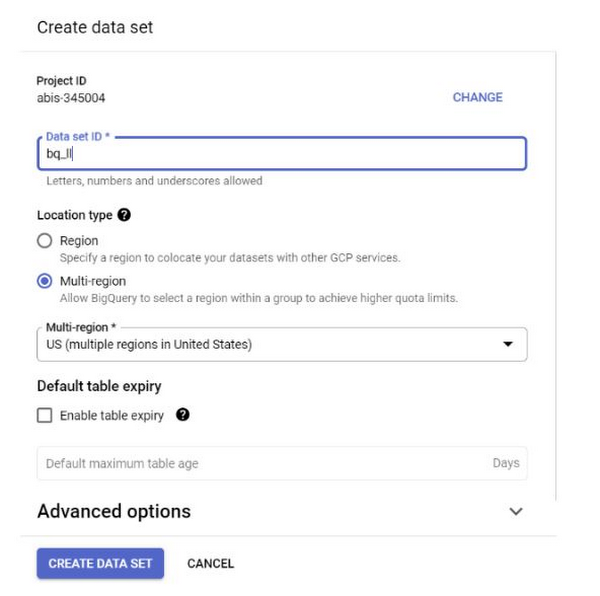
2. '미국' 리전(또는 원하는 리전)에 bq_llm이라는 이름으로 BigQuery 데이터 세트를 생성합니다.
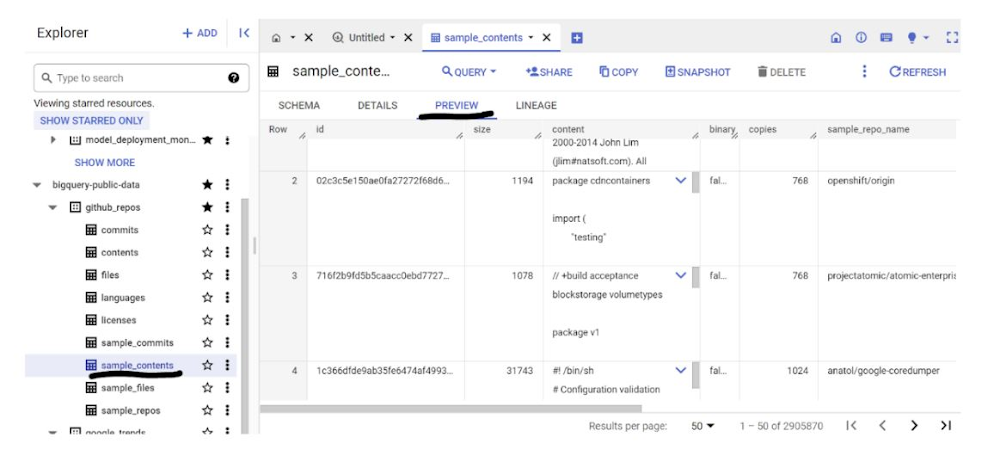
3. 이 사용 사례에서는 Google BigQuery 공개 데이터 세트의 github_repos 데이터 세트에 있는 소스 코드 콘텐츠를 사용합니다. 이를 위해 BigQuery 콘솔에서 'github_repos'를 검색하고 Enter 키를 누릅니다. 검색 결과로 나열되는 데이터 세트의 옆에 있는 별표를 클릭합니다. 그런 다음 공개 데이터 세트의 데이터 세트만 표시되도록 '별표표시된 리소스만 표시' 옵션을 클릭합니다.

데이터 세트의 테이블을 확장하여 스키마와 데이터 미리보기를 확인합니다. 여기서는 콘텐츠 테이블의 전체 데이터에서 샘플(10%)만 포함하는 sample_contents를 사용합니다. 데이터의 미리보기는 다음과 같습니다.
4. CSV(또는 다른 파일)에 있는 자체 데이터 세트에 대해 동일한 작업을 수행하려면 Cloud Shell 터미널에서 아래 명령을 실행하여 데이터를 BigQuery 테이블로 로드하면 됩니다.
bq load --source_format=CSV --skip_leading_rows=1 bq_llm.table_to_hold_your_data \
./your_file.csv \ text:string,label:string
5. 외부 연결을 만들고(사용 설정되어 있지 않은 경우 BQ Connection API를 사용 설정) 연결 구성 세부정보에서 서비스 계정 ID를 기록해 둡니다.
a. BigQuery 탐색기 창(BigQuery 콘솔의 왼쪽)에서 +추가 버튼을 클릭하고 나열되는 인기 소스에서 'Connection to external data sources(외부 데이터 소스에 연결)'를 클릭합니다.
b. 연결 유형으로 "BigLake and remote functions(BigLake 및 원격함수)"를 선택하고 연결 ID로 'llm-conn'을 제공합니다.
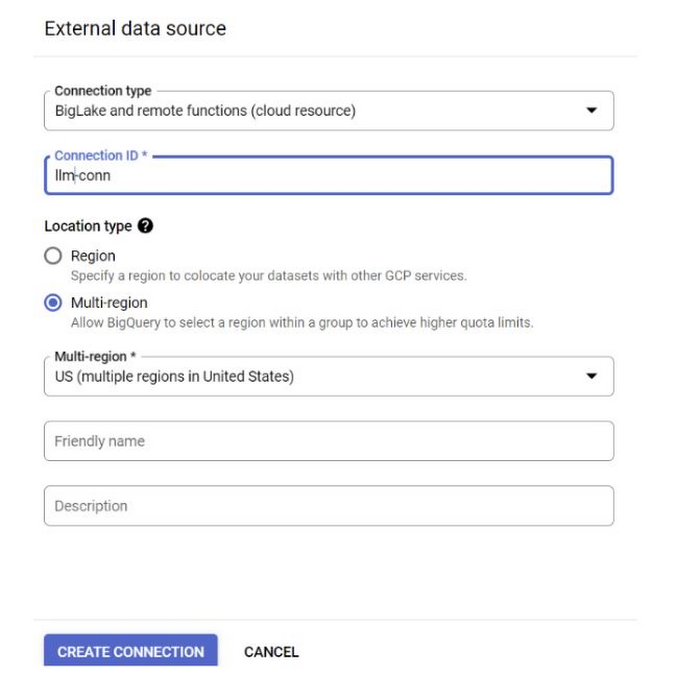
c. 연결이 생성되면 연결 구성 세부정보에서 생성된 서비스 계정을 기록해 둡니다.
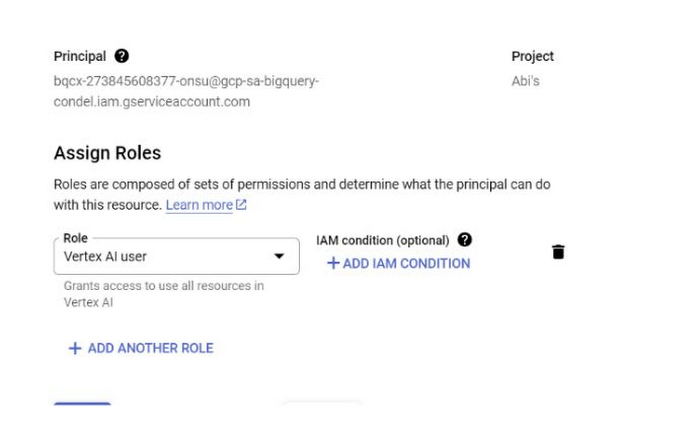
6. SA에 Vertex AI 서비스에 대한 액세스 권한을 부여합니다.
IAM을 열고 복사된 서비스 계정을 주 구성원으로 추가하고 'Vertex AI 사용자' 역할을 선택합니다.
7. 호스팅되는 Vertex AI 대규모 언어 모델을 나타내는 원격 모델을 생성합니다.
완료되는 데 몇 초 정도 걸릴 수 있습니다.
8. 모델이 생성되면 이 모델을 사용하여 텍스트를 생성하고 분류합니다.
설명:
ml_generate_text_result는 콘텐츠와 안전 속성을 모두 포함하는 JSON 형식 텍스트 생성 모델의 응답입니다.
a. 콘텐츠는 생성된 텍스트 결과를 나타냅니다.
b. 안전 속성은 대규모 언어 모델에서 의도하지 않거나 예상치 못한 응답을 방지하기 위해 Vertex AI PaLM API에서 사용 설정되는 조정 가능한 기준점이 있는 기본 제공 콘텐츠 필터를 나타냅니다. 안전 기준점을 위반하는 응답은 차단됩니다.
ML.GENERATE_TEXT는 텍스트 생성 작업을 수행하기 위해 BigQuery에서 Vertex AI LLM에 액세스하는 데 사용하는 구조입니다.
CONCAT는 PROMPT 문과 데이터베이스 레코드를 추가합니다.
github_repos는 데이터 세트 이름이며 sample_contents는 프롬프트 설계에 사용할 데이터가 저장된 테이블의 이름입니다.
Temperature는 응답의 무작위성을 제어하기 위한 프롬프트 매개변수로, 관련성 측면에서는 낮을수록 좋습니다.
Max_output_tokens는 원하는 응답 구성 단어의 수입니다.
쿼리 응답은 다음과 같습니다.
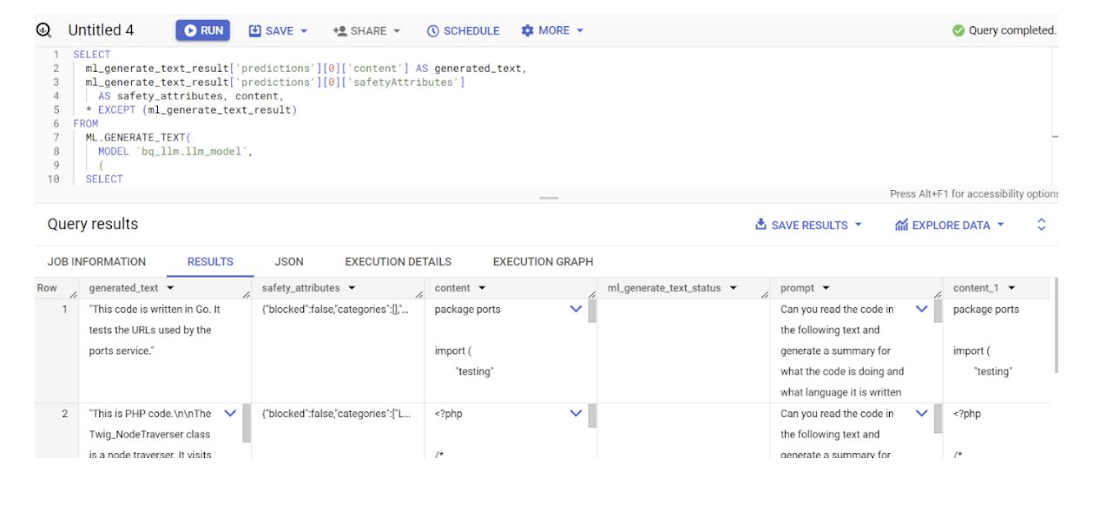
9. 쿼리에서 JSON을 명시적으로 디코딩할 필요가 없도록 결과를 평면화합니다.
결과:
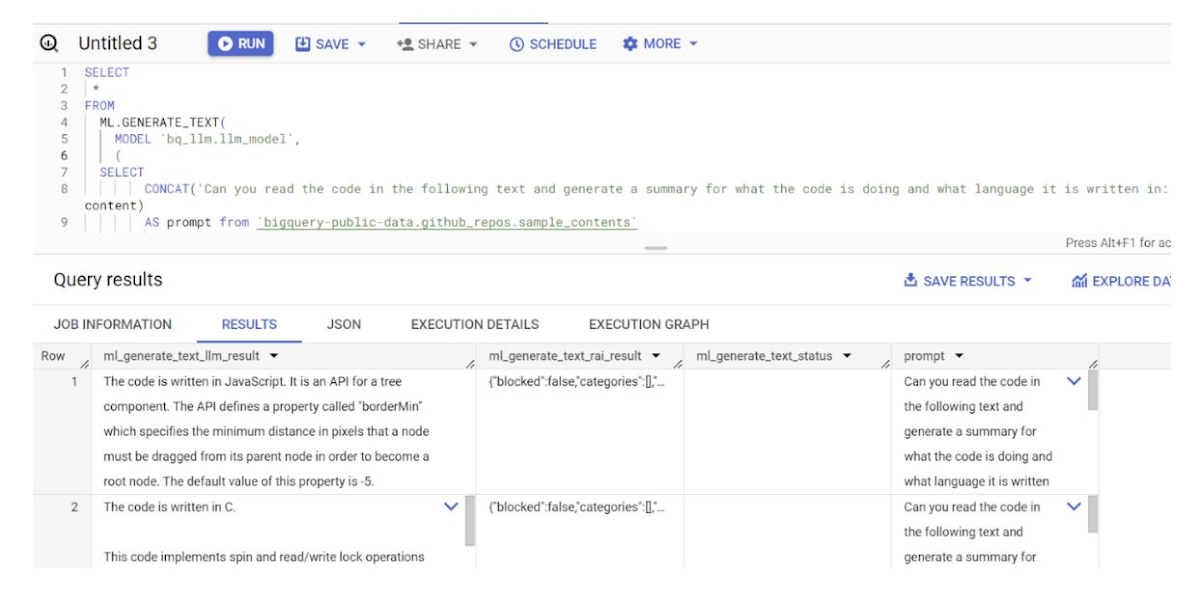
Flatten_json_output은 boolean을 나타냅니다. true로 설정되면 JSON 응답에서 추출된 이해 가능한 평면화 텍스트를 반환합니다.
모든 작업이 완료되었습니다. Vertex AI 텍스트 생성 LLM을 프로그래매틱 방식으로 사용하여 SQL 쿼리만 사용하는 데이터에 대해 텍스트 분석을 수행했습니다. 사용 가능한 모델에 대한 자세한 내용은 Vertex AI LLM 제품 문서를 참조하세요. 직접 사용해 보려는 경우 해당 Codelab을 참조하세요.