Vertex AI Pipelines 向けサーバーレス Spark コンポーネントの発表
Google Cloud Japan Team
※この投稿は米国時間 2022 年 4 月 9 日に、Google Cloud blog に投稿されたものの抄訳です。
デベロッパーと ML エンジニアは Spark ML ワークロードの運用化に関するさまざまな課題に直面しています。課題の一つとして、インフラストラクチャに関するものが考えられます。たとえば、インフラストラクチャ クラスタをどのように事前にプロビジョニングするか、データの準備やモデルのトレーニング、モデルの評価などの多岐にわたるタスクを妥当な時間で実行するための十分なリソースをどのように確保するかといった課題です。ほかにも、タスクのオーケストレーションやデータ処理に関する課題もあるでしょう。たとえば、モデル トレーニングのタスクを実行しているときに、必ず最新機能を使用できるようにするにはどうすれば良いかといったものです。
このような課題は、Vertex AI Pipelines をサーバーレス Spark ワークフローを実行する Dataproc と組み合わせて使用し、ML ワークフローを自動化することで解決できます。たとえば、こちらの記事では、Spark ML モデルをトレーニングおよびデプロイして、事前にインフラストラクチャをプロビジョニングすることなくリアルタイムに近い予測を行う方法について説明しています。特に、カスタムの Python コンポーネントを使用することで Vertex AI Pipelines から Dataproc ジョブを起動し、オーケストレートする方法を取り上げています。
本日、Vertex AI Pipelines 向け Dataproc サーバーレス コンポーネントを新しくリリースしたことをお知らせいたします。これにより、Spark、Spark SQL、PySpark、Spark ジョブの MLOps が簡素化されます。
以下のコンポーネントが利用可能になりました。
DataprocPySparkBatchOp: PySpark バッチ ワークロード
DataprocSparkBatchOp: Spark バッチ ワークロード
DataprocSparkSqlBatchOp: Spark SQL バッチ ワークロード
DataprocSparkRBatchOp: SparkR バッチ ワークロード
これらのコンポーネントには、Vertex AI Pipelines と Dataproc サーバーレスを用いて Spark ベースの ML パイプラインを簡単にオーケストレートするためのネイティブ KFP オペレータがあります。自分で行う必要があるのは、前処理、トレーニング、後処理の各ステップのビルドと、KFP パイプラインのコンパイルだけです。その後、Vertex AI Pipeline と Dataproc サーバーレスを使うことで、インフラストラクチャをプロビジョニングおよび管理する必要なく ML ワークフローをスケーラブルかつ再現可能な、信頼性のある方法で実行できます。
これらのコンポーネントの使用方法についての詳細は、以下の開始チュートリアルをご確認ください。
その他にも、PySpark と DataprocPySparkBatchOp コンポーネントを使用するエンドツーエンドの例を以下で紹介します。
Vertex AI Pipeline で Pyspark と Dataproc サーバーレスを使ってローン審査モデルをトレーニングする
このセクションでは、Spark MLlib と DataprocPySparkBatchOp コンポーネントを使って、顧客の銀行ローン利用資格を判断する Spark ML パイプラインをビルドする方法について説明します。特に、データの前処理から、顧客のローン審査の合格率を予測するランダム フォレスト分類器のハイパーパラメータ調整までの Spark MLlib パイプラインをカバーします。
パイプラインは次の図のとおりです。
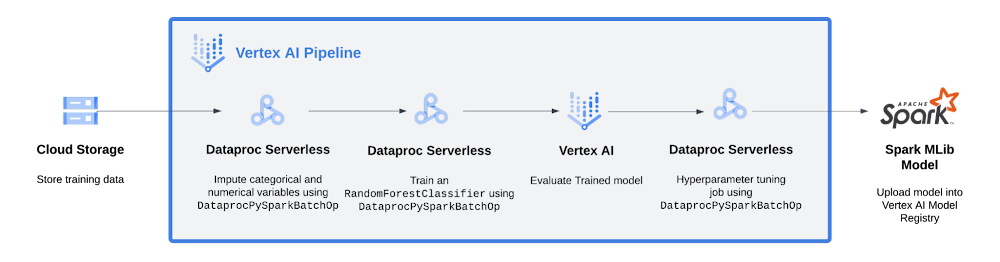
パイプライン ワークフロー(クリックで拡大)
図に示すように、パイプラインには以下の特徴があります。
Cloud Storage にデータを保存する
DataprocPySparkBatchOp を使ってカテゴリ変数と数値変数を代入する
DataprocPySparkBatchOp を使って RandomForestClassifier のトレーニングを行う
カスタム コンポーネントを実行し Vertex AI Pipelines UI のモデル指標を評価して表示する
モデルがパフォーマンス条件(適合率と再現率の曲線、auPR の下側の領域が最小値 0.5 より高い)に一致する場合は、
DataprocPySparkBatchOp を使って RandomForestClassifier のハイパーパラメータ調整を実施する
Vertex AI モデル レジストリにモデルを登録する
DataprocPySparkBatchOp がどのように機能するかわかりやすくするため、トレーニング ステップについて説明します。
DataprocPySparkBatchOp コンポーネントを使って PySpark MLlib モデルをトレーニングする
この例では、PySpark と Spark MLlib をパイプライン ステップとして使ってランダム フォレスト分類器のトレーニングを行います。DataprocPySparkBatchOp コンポーネントを使用して Dataproc サーバーレスでトレーニングを実行するには、まずトレーニングのスクリプトを作成する必要があります。
以下は GitHub リポジトリで手に入るスクリプトです。
完全なコードはこちらのノートブックをご覧ください。
Spark セッションを初期化したら、スクリプトが Spark ML パイプラインをビルドし、前処理済みデータを読み込み、 トレーニング サンプルとテストサンプルを生成します。さらに、モデルのトレーニングを実施し、Cloud Storage バケットにアーティファクトと指標を保存します。
PySpark スクリプトは、使用前に Cloud Storage バケットにアップロードする必要があります。
完全なコードはこちらのノートブックをご覧ください。
スクリプトを Cloud Storage にアップロードしたら、DataprocPySparkBatchOp を使用してトレーニング コンポーネントを定義できるようになります。main_python_file_uri 引数の値は、PySpark スクリプトの Cloud Storage 内の場所にする必要があります。
以下のように定義します
完全なコードはこちらのノートブックをご覧ください。
DataprocPySparkBatchOp には、以下のパラメータの値を指定する必要があります。
project、Dataproc バッチ ワークロードを実行するプロジェクト
batch_id、バッチジョブに使用する一意の ID
main_python_file_uri、Spark ドライバとして使うメインの Python ファイルの HCFS URI
お使いのワークロードに他のパラメータが必要でも、DataprocPySparkBatchOp コンポーネントはそのパラメータを受け入れることができます。コンポーネントの詳細については、ドキュメントをご覧ください。
最後に、dsl.pipeline デコレータを使って、このコンポーネントをパイプラインの定義の他のタスクに統合します。それから、 パイプラインの定義をコンパイルし、Vertex AI SDK を使って実行します。
この実行中に model_traning_op ステップが実行されると、パイプラインがトレーニング ワークロードを Dataproc サーバーレス サービスに送信します。 ジョブの実行が正常に完了すると、バッチ ワークロードの詳細を Cloud Console で確認できます。
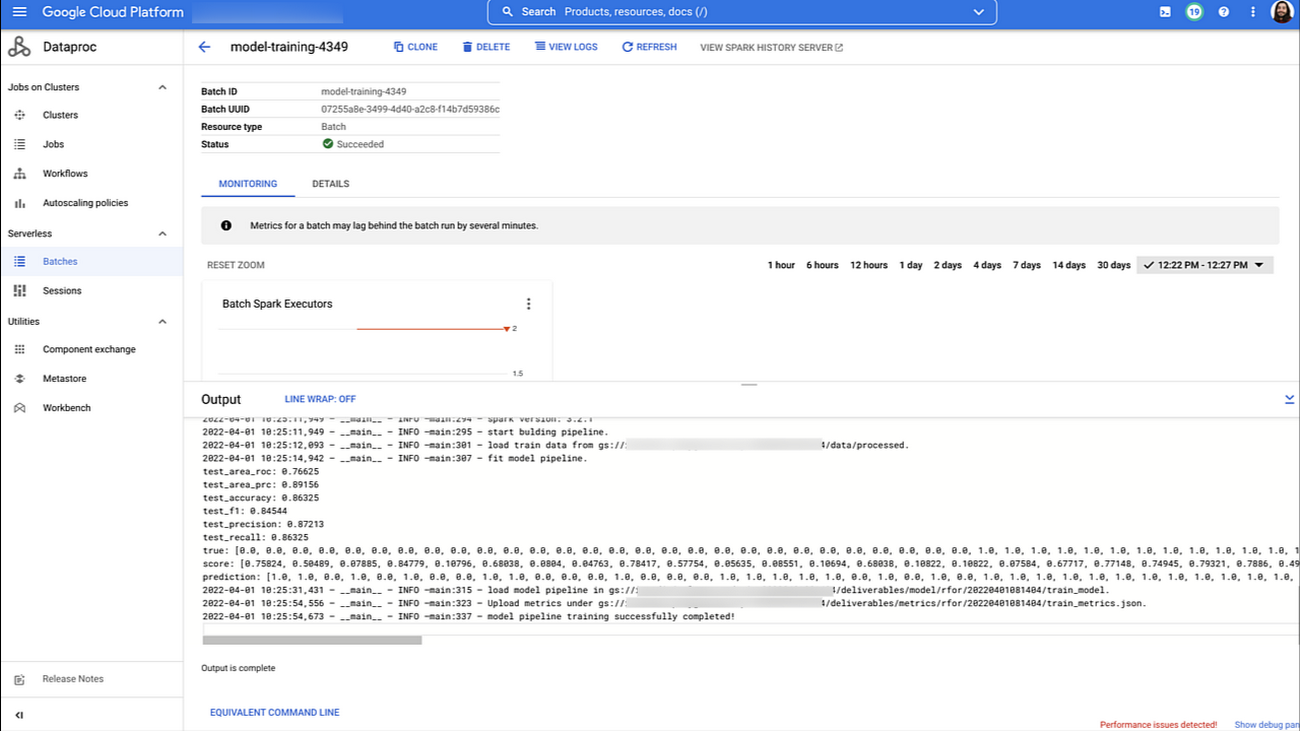
Dataproc UI のトレーニング ジョブのバッチビュー(クリックで拡大)
Vertex AI Pipelines 向け Dataproc サーバーレス コンポーネントを使用することで、Spark ジョブを機械学習ワークフローにいかに簡単に統合できるかご理解いただけたと思います。 Dataproc サーバーレスはインフラストラクチャ全体の管理を引き受けます。さらに、ワークロードのトレーニングでは、実行されるときに必要なリソースしか消費されません。
同様のアプローチを使って、他のタスクをパイプラインに統合できます。下のコードは、完全な機械学習ワークフローを実行するパイプラインの定義の例です。このワークフローには、データの前処理およびデータセットの作成、モデルのトレーニング、モデルの評価、ハイパーパラメータの調整、Vertex AI モデル レジストリへのモデルのアップロードなどが含まれます。パイプラインは Dataproc サーバーレスで PySpark ワークロードを実行するための DataprocPySparkBatchOp と、Google Cloud パイプライン コンポーネント SDK の一部である他のコンポーネントを使用します。
完全なコードはこちらのノートブックをご覧ください
Vertex AI Pipelines によって、実行中の機械学習ワークフローが可視化されます。次の図は、上のパイプラインの定義を使って実行したエンドツーエンドのワークフローの全体図です。
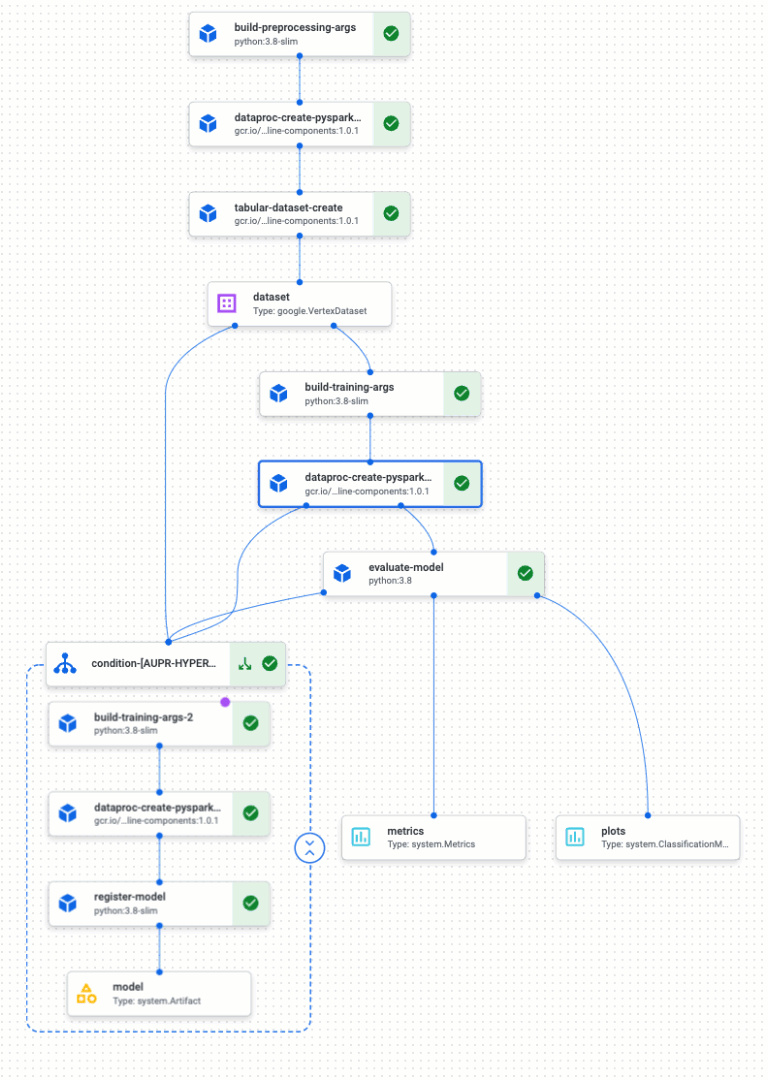
Vertex AI Pipelines UI のパイプライン(クリックで拡大)
まとめ
今回のブログ記事では、Vertex AI Pipelines 向けの新しい Dataproc コンポーネントが利用可能になったことを発表しました。また、DataprocPySparkBatchOp を使ってデータの前処理、ローン審査用の PySpark MLlib モデルのトレーニングとハイパーパラメータ調整を行うエンドツーエンドの例を示しました。
次のステップ
Dataproc サーバーレス、Vertex AI Pipelines、Spark モデルを Vertex AI にデプロイする方法についてもっと知りたい方は、次のリソースをご覧ください。
ドキュメント
Code Labs
動画シリーズ: AI の基礎: Vertex AI
クイックラボ: Vertex AI での機械学習ソリューションの構築とデプロイ
このブログ投稿を書くにあたって協力してくれた Abhishek Kashyap、Henry Tappen、Mikhail Chrestkha、Karthik Ramachadran、Yang Pan、Karl Weinmeister、Andrew Ferlitsch に感謝します。
- カスタマー エンジニア Ivan Nardini
- クラウド ソリューション アーキテクト Win Woo