SRE ブックの 10 年間:『Site Reliability Engineering』第 2 版のご紹介
Betsy Beyer
SRE Program Manager
David Huska
Software Engineer, Site Reliability Engineer
Google が本番環境システムを運用する方法を、現代のクラウドと AI の時代に合わせてアップデートしました
※この投稿は米国時間 2026 年 10 月 13 日に、Google Cloud blog に投稿されたものの抄訳です。
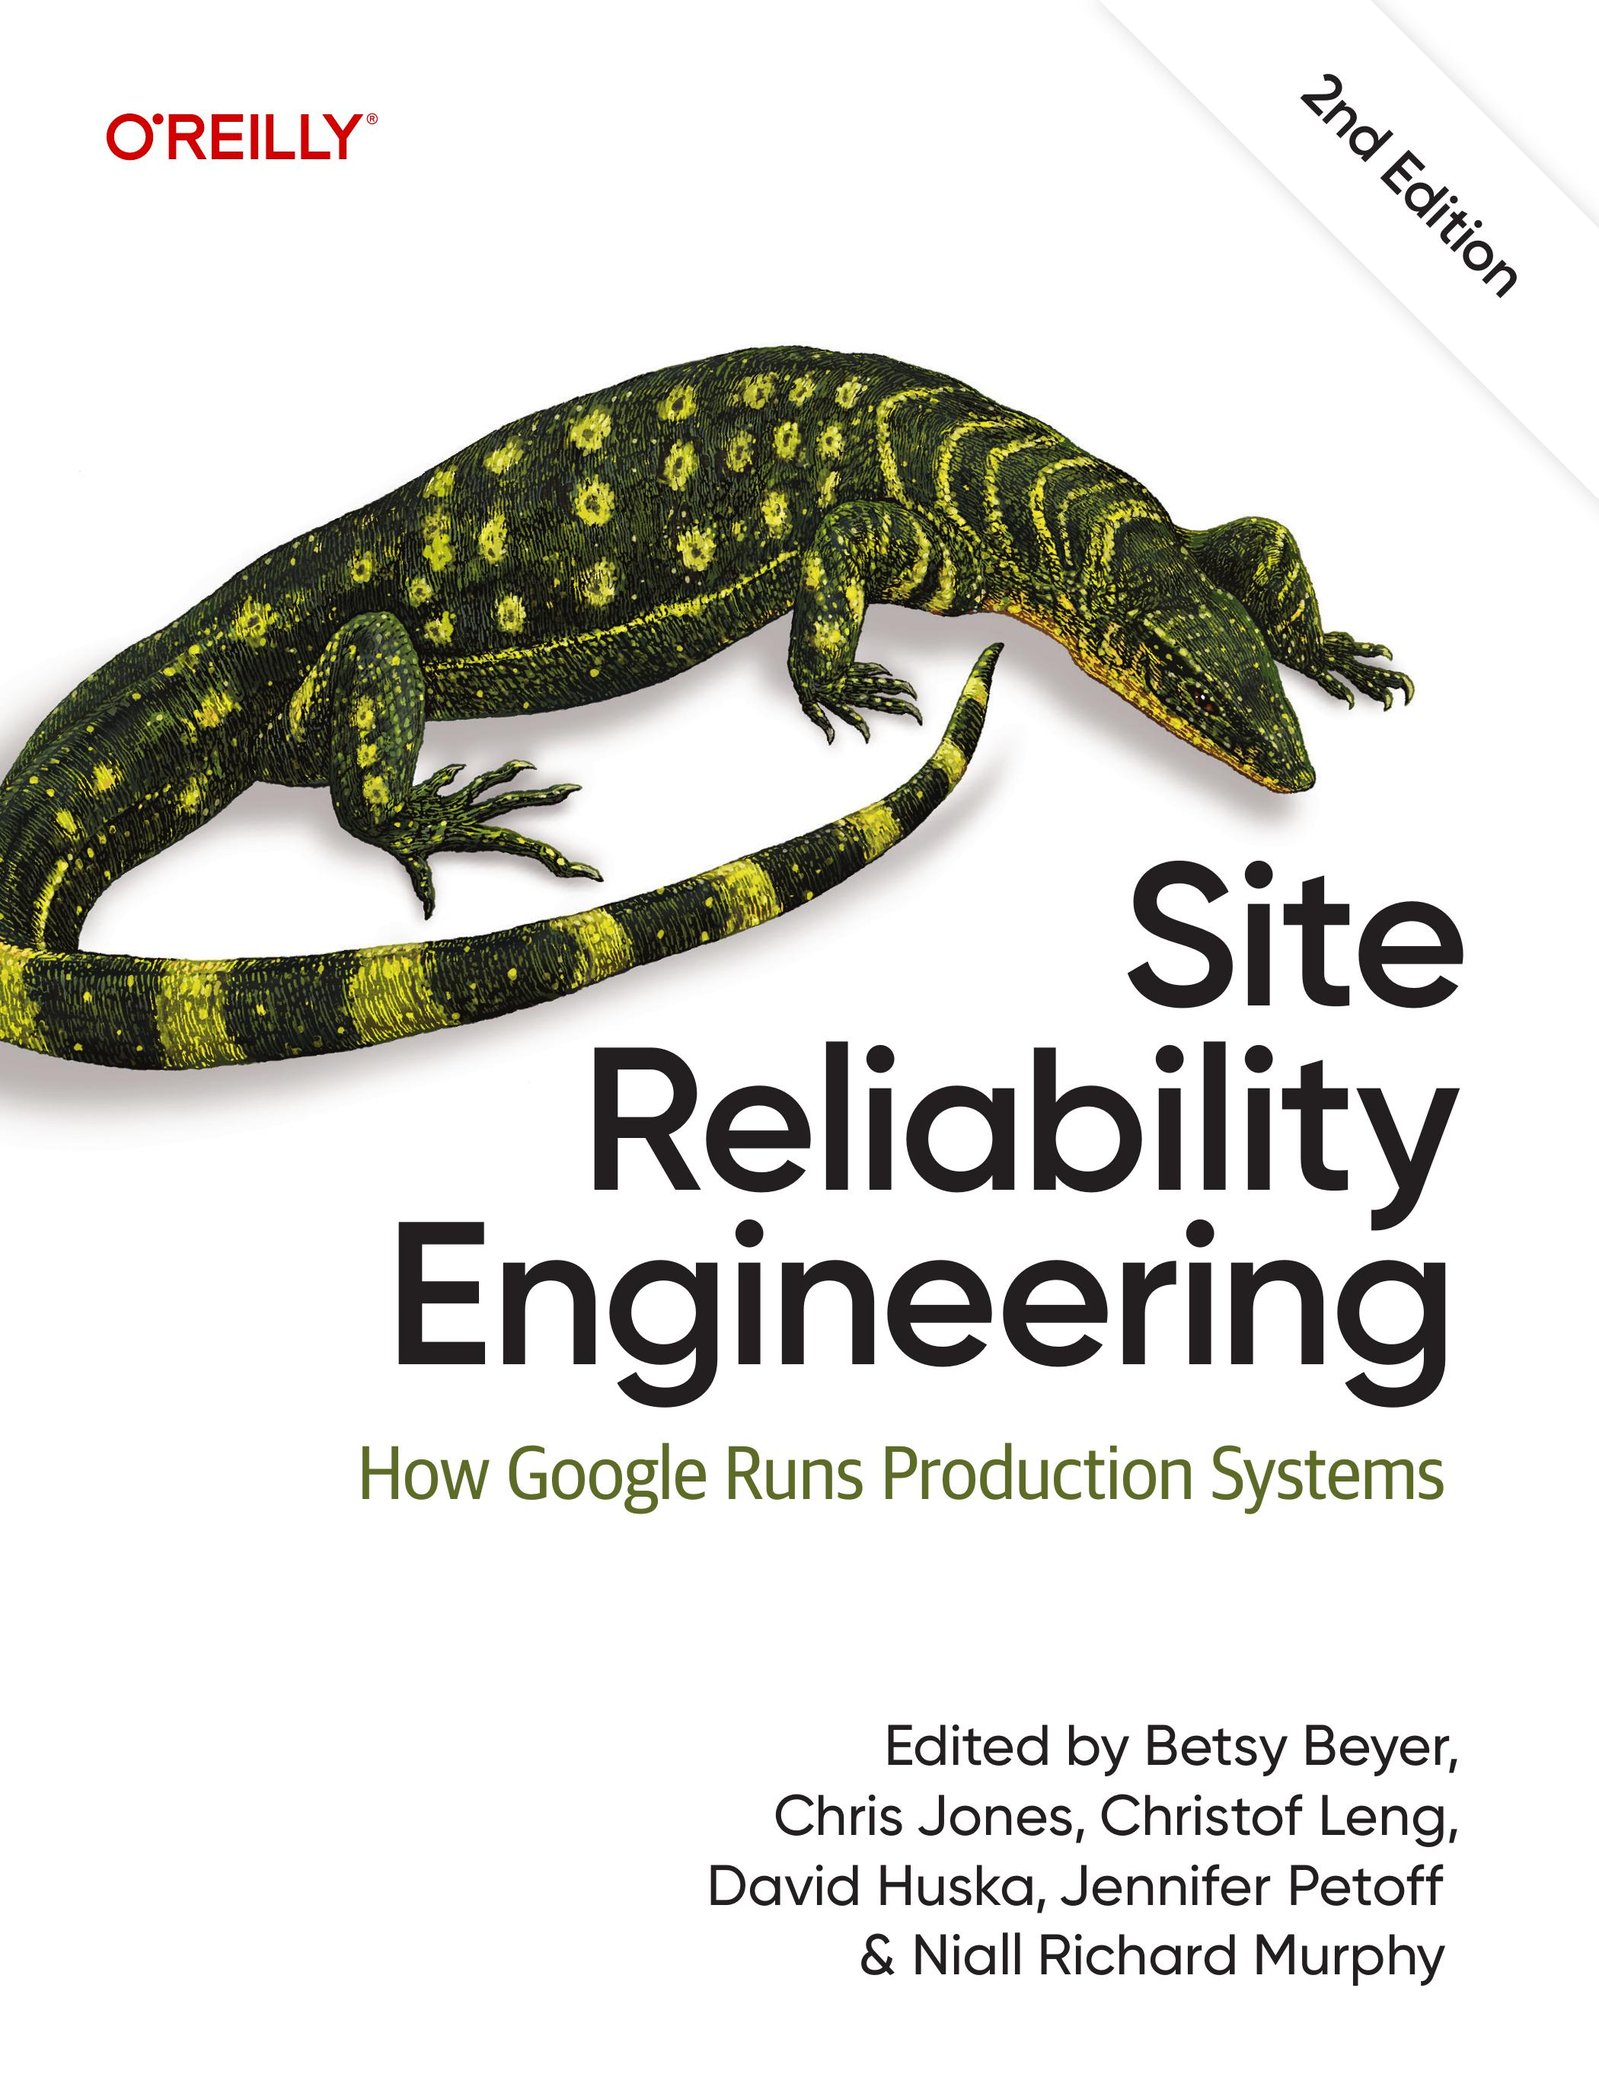
10 年前、Google は O'Reilly Media から『Site Reliability Engineering: How Google Runs Production Systems』を出版しました。大規模なインフラストラクチャを管理する Google の手法を集めたものとして始まった本書はベストセラーとなり、多くの組織がそこに示された信頼性プラクティス(スケーラブルで信頼性が高く、持続可能なシステムを構築するためにソフトウェア エンジニアリングを運用に適用すること)を採用するきっかけとなりました。
過去 10 年間で、コンピューティング環境は大きく変化しました。AI、マイクロサービス、マルチクラウド デプロイ、サーバーレス パラダイム、プラットフォーム エンジニアリングはすべて、ソフトウェアの構築と運用方法を再構築しました。このたび、本書の出版 10 周年を記念して、全面的に改訂された Google SRE ブック第 2 版を発表できることを嬉しく思います。Google 社内および業界全体で得た 10 年間の教訓を反映し、今日の運用上の課題に合わせた最新のガイダンスを提供します。
改訂する理由
初版を出版した当時、多くの組織はクラウドへの初期移行に注力しており、モノリシック アーキテクチャからの脱却を始めたばかりでした。昨今、組織が高速かつグローバル規模でソフトウェアを提供する中で、課題はもはやクラウド インフラストラクチャの導入ではなく、極めて複雑な状況に直面しながらも高い信頼性を維持することです。
最新の本番環境は、常に変化する状況下で運用されています。システムの境界はより複雑になり、依存関係は深まり、障害モードはこれまで以上に複雑化して深刻な被害をもたらすようになっています。生成 AI のようなリソースを大量に消費するワークロードの急増により、インフラストラクチャ管理における経済性と運用要件が変化しています。
この第 2 版を執筆するにあたり、私たちは一度立ち止まって、現代の環境で SRE を適切に実装するために何が必要かを評価する必要がありました。
10 年間の進化: SRE 手法の進歩
第 2 版では、サイト信頼性エンジニアリングの基礎的なプラクティスが過去 10 年間でどのように成熟し、タスク固有の手動作業から、プラットフォーム全体の自動化機能へとシフトしたのかを深く掘り下げて解説しています。以下はその例です。
SLO とエラー バジェット: 2016 年、チームは基本的な可用性指標と手動のエラー バジェット ポリシーに依存していました。現在は、動的なバーンレート アラートと自動化されたポリシー適用を組み込んだ、ユーザー中心の多層 SLO へと成熟しています。
モニタリングとオブザーバビリティ: 初期のセットアップは、静的なダッシュボード、基本的なログ、手動のアラート トリアージが中心でした。最新のオブザーバビリティは、OpenTelemetry、分散トレース、自動化された異常相関を活用して、根本原因を迅速に特定します。
自動化とプラットフォーム: 運用は、個別のタスク用にカスタム スクリプトを作成することから、宣言型の Infrastructure as Code、社内開発者プラットフォーム、復元力のある自己修復システムを使用することへと移行しています。
信頼性テスト: 定期的なゲームデーや合成負荷テストのみに頼るのではなく、最新のエンジニアリングでは、継続的なレジリエンス チェック、自動化されたパイプライン テスト、本番環境でのライブカナリア検証を組み込んでいます。
容量とリソースの管理: 手動でのプロビジョニングや静的な予測は、動的な自動スケーリング、クラウド FinOps との連携、GPU および TPU ワークロードに特化したコストとクラスタの最適化に置き換えられました。
組織モデル: SRE は、特定のアプリケーションに割り当てられた専任チームの枠を超えて拡大しています。昨今の組織は、ハイブリッド モデル、プラットフォーム エンジニアリングとの統合、各プロダクト チームに配置された信頼性チャンピオンを取り入れています。
AI 時代の SRE
さらに、SRE と AI には相互に影響し合う 2 つの関係があります。それは、SRE が AI インフラストラクチャをいかに支えるか、そして SRE チームが AI を活用していかに運用の信頼性を高めるか、という点です。
大規模言語モデル(LLM)や基盤モデルを実行すると、信頼性に関する新たな課題が生じます。本書では、AI インフラストラクチャを大規模に運用するための次の手法を概説しています。
- 大規模な GPU および TPU ハードウェア クラスタの信頼性とネットワーク トポロジの管理
- AI 固有の非決定論的な出力とレイテンシ特性のモニタリング
- 継続的なモデル トレーニング、ファインチューニング、データ処理のためのパイプライン信頼性の確保
AI は、信頼性エンジニアの能力を何倍にも引き上げる存在として急速に浸透しています。第 2 版では、人間の業務効率を向上させるための次の実践的なフレームワークを紹介しています。
- 生成 AI ツールを使用して、リアルタイムのインシデント トリアージと事後分析の生成を支援
- 自然言語クエリを使用して複雑なシステム テレメトリーを調査
- 予測 ML モデルを使用して、サービス停止が発生する前にリソースのボトルネックを特定
変わらない点: 文化の重要性
テクノロジーとアーキテクチャは進化し続けていますが、SRE の基本原則は変わらず、信頼性を重視する文化を確立するための鍵となっています。そのため、第 2 版では、システム エンジニアリングの人的要素と、それを実現する方法を改めて強調し、詳しく解説しています。
この分野の初心者、実務担当者、エンジニアリング マネージャー、テクノロジー エグゼクティブのどなたであっても、改訂された『Site Reliability Engineering』第 2 版は、次世代の本番環境システムの決定版ロードマップとして役立ちます。
書籍版(Google ブックスを参照)またはデジタル版を O'Reilly から今すぐご注文いただけます。
- SRE プログラム マネージャー、Betsy Beyer
- ソフトウェア エンジニア、サイト信頼性エンジニア、David Huska