ボーダーレス Lakehouse で Databricks の Apache Iceberg テーブルにクエリを実行する
Pramod Niralakeri
Strategic Cloud Engineer
※この投稿は米国時間 2026 年 10 月 30 日に、Google Cloud blog に投稿されたものの抄訳です。
大規模組織では多くの場合、Databricks を含む複数のデータ プラットフォームを活用して負荷の高い Apache Spark ジョブを実行しつつ、BigQuery を併用して同時実行性の高い分析ワークロードを処理しています。これまで、これらのシステムを連携させるには、環境間でデータをコピーするための複雑なパイプラインを構築する必要がありました。このアプローチでは、ストレージ費用が増加し、レイテンシが発生し、セキュリティ管理が断片化します。
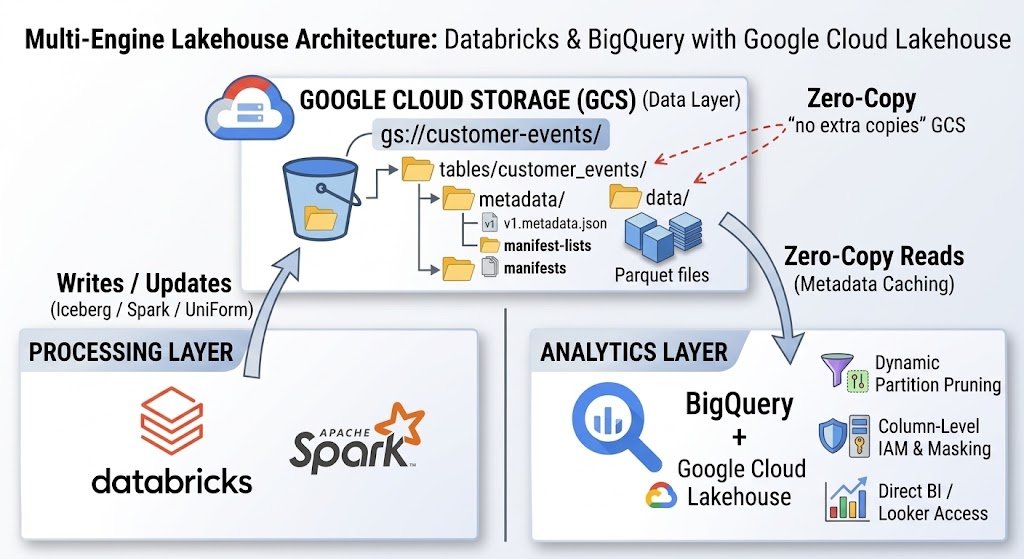
Google Cloud のボーダーレス Lakehouse を使用すると、Databricks で管理されている Apache Iceberg テーブルを BigQuery から直接クエリできるようになります。このゼロコピー アプローチにより、データの複製が不要になります。つまり、BigQuery は Databricks が書き込んだのと同じファイルを読み取り、Lakehouse の次回のスケジュールされたメタデータ更新後(最長 5 分間隔)に新しい変更が反映されます。
Lakehouse と Databricks の連携
マネージド Iceberg テーブルは、ネイティブの Delta ログとともに Iceberg 互換のメタデータを自動的に生成します。データ エンジニアリング チームは、Databricks を使用して Parquet ファイルを Google Cloud Storage(GCS)に一度保存するだけで済みます。Lakehouse はこの情報を BigQuery に読み込むのではなく、Iceberg メタデータを直接読み取って、BigQuery のベクトル化エンジンを GCS 上のオープン形式のファイルに直接適用します。
上の例では Google Cloud Storage(GCS)がプライマリ ストレージ レイヤとして機能していますが、Lakehouse はこのボーダーレスな連携を Amazon S3 や Azure Blob Storage などの外部クラウド環境へも直接展開します。Lakehouse は、オープンな Apache Iceberg REST カタログとクロスクラウド接続を組み合わせることで、BigQuery がデータを移動することなくクラウド間でクエリを実行できるようにします。各連携カタログは、選択した Google Cloud のロケーション(データに最も近いリージョンが理想的)に配置されます。これにより、BigQuery はオープン形式の Parquet ファイルを保存場所で読み取ることができ、レプリケーション パイプラインなしでのマルチクラウド分析を可能にします。リモートクラウドの下り(外向き)料金は引き続き適用されますが、Cross-Cloud Interconnect(AWS)と Lakehouse キャッシュ保存により、この負担を軽減できます。
Lakehouse フレームワークは、単に外部データをクエリするだけでなく、エンジン間で真の読み取り / 書き込み(R / W)相互運用性を実現します。このプラットフォームはオープンな Apache Iceberg 基盤上に構築されているため、データチームは BigQuery 内で直接、マルチステートメントの SQL コマンドを簡単に実行できます。
一元化されたセキュリティとガバナンス
異なるシステム間でアクセス制御を管理すると、脆弱性が生じる可能性があります。Lakehouse は、アクセス権の委任によってこの問題に対処します。管理者は、GCS バケットの IAM 権限を管理するサービス アカウントに関連付けられた BigQuery Cloud リソース接続を構成できます。ユーザーに Lakehouse のテーブル エンティティへのアクセス権を付与すると、Databricks が取り込みを処理する一方で、外部 Iceberg テーブルに行レベルや列レベルのセキュリティ、動的データ マスキングなどの BigQuery の制御機能を適用できます。
カタログの連携とクルデンシャル ベンディング
従来、これらのプラットフォームを接続するには、静的なメタデータパスを指すように BigQuery クエリを手動で構成する必要がありました。現在の構成では、オープンな Apache Iceberg REST Catalog API を活用しています。Databricks Unity Catalog は、一元化されたメタデータ レイヤとして機能し、BigQuery 管理者が連携接続を使用して Lakehouse ランタイム カタログを確立できます。クエリを実行すると、Lakehouse が Unity Catalog に問い合わせて現在のテーブルの状態を確認し、クルデンシャル ベンディングを通じて有効期間の短いトークンを発行して、BigQuery に GCS への一時的な読み取りアクセス権を付与します。
パーティション プルーニング
BigQuery は、各テーブルの Iceberg メタデータを使用してクエリを計画し、関連するデータファイルのみをその場で読み取ります。Iceberg の隠しパーティショニングを使用すると、ディレクトリ レイアウトを知らなくても、タイムスタンプなどの論理列でフィルタリングできます。なお、Databricks マネージド Iceberg テーブルはパーティション変換をサポートしていません。Databricks では、代わりにリキッド クラスタリングの使用が推奨されています。
標準の WHERE 句のフィルタにより、BigQuery は Iceberg マニフェストを使用して、条件に一致しないパーティションをスキップできます。パーティション列をリテラル値と比較して、プルーニングを適用できるようにします。これらのマニフェストは、列レベルの詳細な統計情報を保持しているため、BigQuery は無関係なマニフェスト レコードや不要な Parquet ファイルを即座にスキップできます。その結果、クエリは必要なバイト範囲のみをスキャンするため、クエリの実行が高速化され、オンデマンド スロットの消費量とストレージ スキャンの費用が大幅に削減されます。
Iceberg メタデータと Lakehouse キャッシュ保存による高速クエリ
Iceberg マニフェストは、読み取るデータファイルをすでに識別しているため、BigQuery は Iceberg テーブルのメタデータ キャッシュ保存を必要としません。Amazon S3 などのクロスクラウド テーブルの場合、Lakehouse キャッシュ(プレビュー版)によって取得済みのデータブロックが Google Cloud に保持されるため、繰り返し実行されるクエリではローカルから直接読み取ることができます。BigQuery は、各クエリを計画するときに Iceberg マニフェスト ファイルを直接読み取ります。有効化が必要なメタデータ キャッシュ保存はありません。この動的パーティション プルーニングにより、不要なファイルがスキップされ、実行時間とスキャンされるバイト数が大幅に削減されます。
メンテナンスとライフサイクル管理
現代の Lakehouse には、継続的なメンテナンスが必要です。定期的なケアを怠ると、パフォーマンスが低下し、非効率なリポジトリと化してしまいます。幸いにも、BigQuery と Databricks の両方に、テーブルの健全性を維持し、分析ワークロードを高速化するネイティブ機能が備わっています。
テーブルを最適化された状態に保つ
最適なクエリ パフォーマンスを維持するには、Lakehouse のストレージ フットプリントを継続的にメンテナンスする必要があります。
-
Databricks API を介して定期的なコンパクション パイプラインをトリガーし、小さな Parquet ファイルをより大きな最適化されたレイアウトに統合するか、Predictive Optimization 機能を使用する。
-
Databricks の VACUUM コマンドを実行して、アクティブなスナップショット外の参照されていないファイルをクリアし、余分な GCS ストレージ費用を回避する。
コンパクションと小さなファイルに関する問題
頻繁な書き込みオペレーション、継続的な取り込みジョブ、ストリーミング ワークロードにより、数千もの小さな Parquet ファイルが絶え間なく生成されます。この断片化により、BigQuery の読み取り効率を低下させるストレージのボトルネックが発生します。GCS への数千ものネットワーク接続を確立し、多数の小さなファイルのメタデータ フッターを処理すると、コンピューティング時間が大幅に消費され、ベクトル化されたクエリ実行によるパフォーマンス上のメリットが損なわれます。
Iceberg 内で定期的なコンパクションを実行すると、こうした非効率性が解消されます。Databricks は、アクセス パターンに基づいてファイル レイアウトを動的に調整するリキッド クラスタリングを使用するか、ネイティブのテーブル管理ユーティリティを介して、これを自動的に管理します。
Databricks で小さなファイルを手動で統合(コンパクション)するには、OPTIMIZE を実行します。
このコマンドを実行すると、散在するファイル セグメントが、通常 256 MB~512 MB の構造化された大きなブロックに集約され、BigQuery のスキャン スループット向上に役立ちます。ビンパック アプローチは、合計ファイルサイズのバランスを優先することで迅速に動作しますが、別の並べ替え戦略を使用すれば、特定の列キーに沿ってデータセットの順序を整えることもできます。
孤立したファイルとスナップショット保持の管理(VACUUM)
トランザクションの更新、レコードの変更、テーブルのコンパクションが行われるたびに、Iceberg 内に新しいスナップショットが作成され、データセットの完全性が維持されます。時間の経過とともに、現在のテーブルから参照されなくなった過去の Parquet オブジェクトは孤立します。これらのレガシー ファイルによりタイムトラベル分析が可能になりますが、放置すると GCS ストレージ料金が徐々に増加する原因になります。
データチームは、Databricks の VACUUM オペレーションを使用して、放置されたストレージ ファイルをスキャンおよび削除できます。
標準構成では、VACUUM ルーティンを実行する前に、7 日間の保持期間(deletedFileRetentionDuration)が必須のしきい値として適用されます。この保持期間を維持することで、実行中の分析ジョブでファイルが見つからないエラーが発生するのを防ぎ、過去データの復元オプションも確保できます。定期的な VACUUM ジョブをスケジュールするか、Predictive Optimization に実行を任せることで、参照されていないデータファイルが削除されます。また、Iceberg 読み取りに対応したテーブルの場合は、古い Iceberg メタデータも削除されます。これにより、Lakehouse 全体でストレージ費用を低く抑え、パフォーマンスを高く維持できます。
まとめ
Databricks の Apache Iceberg データセットを Lakehouse に接続すると、BigQuery でデータをさらに活用できるようになります。処理を基盤となるストレージから分離し、オープン フォーマットを採用し、クルデンシャル ベンディングに対応した標準の REST API を使用することで、データの移行やパフォーマンスの低下を伴うことなく、スケーラブルなエンジニアリング ワークロードと同時分析を実行できます。
Databricks Iceberg の読み取り(UniForm)を Lakehouse フェデレーション、Lakehouse キャッシュ保存、定期的な OPTIMIZE および VACUUM メンテナンスと組み合わせることで、効率的なゼロコピー レイクハウスを構築できます。このアプローチは、ストレージ費用の削減、脆弱なパイプラインのメンテナンスの回避、現代の分析や新たな AI ワークロードに対応するデータ環境の準備に役立ちます。
統合アーキテクチャを構築する際、プラットフォーム間でデータファイルを移動する必要はなくなりました。Lakehouse ランタイム カタログに Databricks の Iceberg テーブルを登録して双方向連携を有効にすると、すぐにクエリを開始できます。詳細については、ドキュメントをご覧ください。
- 戦略的クラウド エンジニア、Pramod Niralakeri