Apache Iceberg を自動管理して大規模展開する: Spanner を活用した Lakehouse ランタイム カタログ
Vinod Ramachandran
Product Manager
Mina Mikhail
Software Engineering Manager
※この投稿は米国時間 2026 年 10 月 7 日に、Google Cloud blog に投稿されたものの抄訳です。
企業がレイクハウス アーキテクチャへとモダナイズを進めるなかで、Apache Iceberg などのオープン フォーマットに準拠した共有データ資産を作成し、複数のエンジンで使用できるようにするという動きが広がっています。このように、AI ネイティブなレイクハウスを構築すれば、データをセマンティックな知識に変換したり、プロアクティブにアクションを実行したりするなど、エージェントの規模での運用が可能となります。
レイクハウスの主要コンポーネントの一つはカタログであり、Apache Iceberg 環境では通常、Iceberg REST カタログがこれに該当します。Apache Iceberg カタログは、テーブル ポインタの維持や、アトミック コミットの処理といった役割を担うほか、テーブルの場所に関する信頼できる唯一の情報源となります。しかし、大規模なエンタープライズがレイクハウスへとモダナイズするにしたがって、スケーラビリティと可用性を備えたマネージド カタログがレイクハウス アーキテクチャの一部として必要であるという認識が生まれつつあります。エージェントによるクエリの量が増えるにつれて、この重要性はさらに増していきます。エージェントが繰り返し実行する大量の細かなクエリに対応するために、基盤のマネージド カタログには、アトミック性、整合性、可用性、同時実行性を大規模なスケールで提供する能力が求められます。
このブログ投稿では、エージェント規模へと広がる最新のクラウド環境においてマネージド カタログが直面する課題を考察するとともに、Google Cloud のサーバーレスの Lakehouse ランタイム カタログがこうした課題の解決にどのように役立つかについて説明します。Lakehouse ランタイム カタログは、Google Cloud の常時稼働データベースである Spanner(実質的に無制限で拡張可能)を基盤とし、オープンな Apache Iceberg REST カタログ仕様に準拠しています。これにより、エージェントの時代に必要なスケーラビリティと可用性を提供する基盤となります。
レイクハウスのマネージド カタログが直面する課題
データ エンジニアやインフラストラクチャ責任者の方々に話を伺うと、レイクハウスで大規模に本番環境の分析を行うことに関して、以下のような共通した課題を抱えています。これらはすべて、マネージド カタログにおいて解決すべきものです。
アトミック コミットと同時実行制御: Iceberg は、オプティミスティック同時実行制御(OCC)により、ACID トランザクションを保証しています。したがって、マネージド カタログに強固なアトミック比較交換(CAS)オペレーションを実装し、現在のメタデータ ポインタをスワップする必要があります。
高可用性と運用保守: カタログがダウンすると、クエリはその瞬間からエラーとなります。そのため、マネージド カタログは最重要な Tier-1 サービスに位置付けられます。
カタログを支えるデータベースのスケーリング: カタログの設計者は往々にして、テーブルのメタデータおよび状態の保存用データベースの選択において、難しいジレンマに陥ります。従来のスケールアップ型のリレーショナル データベースは SQL に対応しており、ACID トランザクションを提供しますが、読み取り / 書き込みの同時実行処理が増えると、CPU、メモリ、ストレージ、接続数が垂直方向の限界に達します。これを回避するには、手動でのシャーディングが必要となりますが、その場合は、運用上のオーバーヘッドが膨大になります。一方、スケールアウト型のデータベース システムは、即時整合性が得られない、管理が困難、エンタープライズに対応できない、といった問題があります。
テーブルのメンテナンス作業: カタログは、データの最適化まではしてくれません。人間の担当者が、データの圧縮、古いスナップショットの消去、マニフェストの書き換え、孤立ファイルのクリーンアップといった補助パイプラインを構築して運用する必要があります。
ガバナンスとセキュリティ: カタログは、セキュリティの門番として、以下を実装して維持することが求められます。
-
認証プロトコル(OAuth2 トークン交換、IAM 連携など)
-
名前空間からテーブルレベルまでのアクセス制御
-
一時的なストレージ認証情報(例: クエリエンジンに対して、広範なストレージに直接アクセスできる認証情報ではなく、有効期間の短いトークンを生成する)
Lakehouse ランタイム カタログ
これらの課題を解決するために、Google は Iceberg REST カタログをサポートする Lakehouse ランタイム カタログ(一般提供)を構築しました。Lakehouse ランタイム カタログは、高可用性を備えた完全にサーバーレスな統合メタデータ レジストリであり、Apache Iceberg などの最新のオープンなテーブル フォーマットをサポートするようにゼロから設計されています。 Lakehouse ランタイム カタログでは、Apache Iceberg REST カタログ仕様をネイティブに実装することで、メタデータ検出をコンピューティング エンジンから分離しています。これにより、複数の Iceberg 互換エンジンが共有データ資産にアクセスできるようになり、ワークロードを迅速に本番環境に移すことが可能となります。Google はすでに、多くのお客様がマネージド カタログの移行をスムーズに行えるよう支援してきました。たとえば、Etsy は Lakehouse ランタイム カタログへと移行し、データを動かさずに結合することで、パイプライン クエリを 60% 高速化しています。
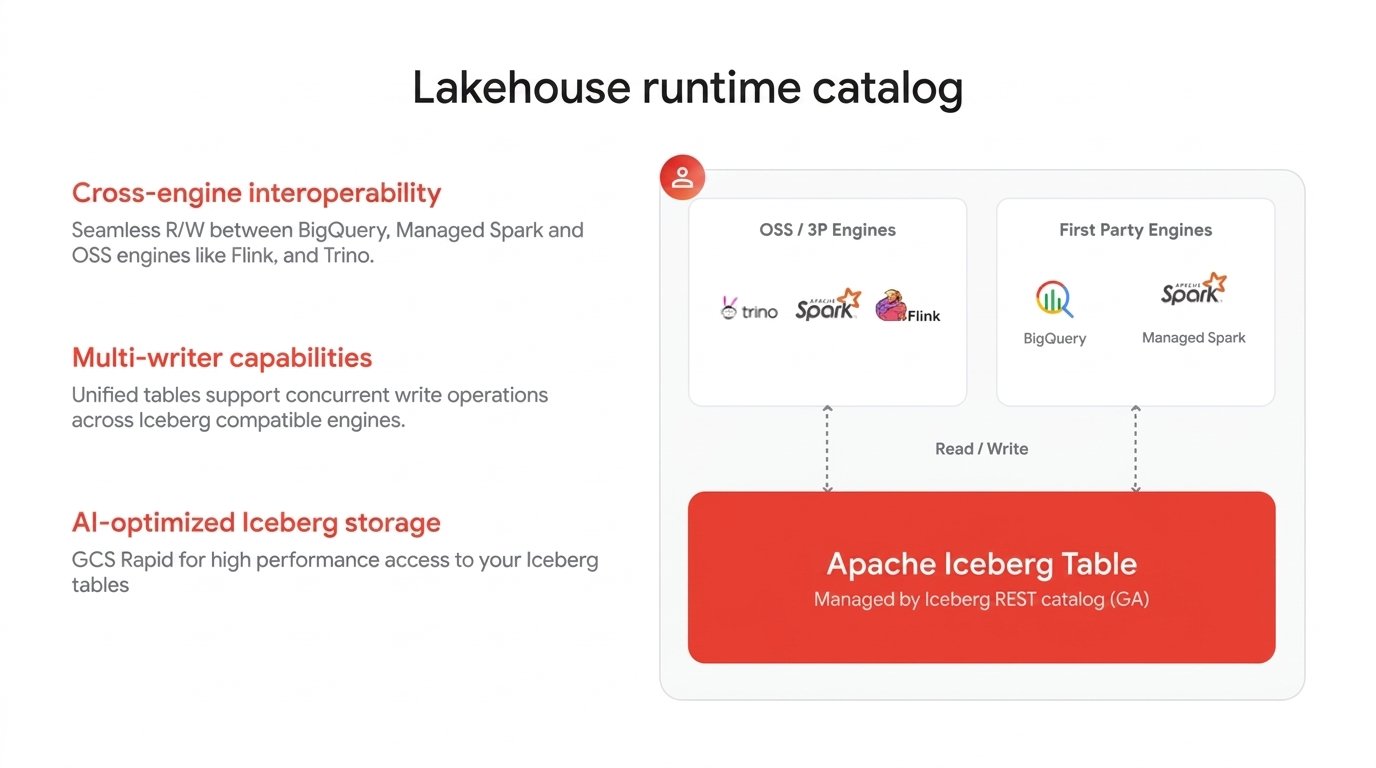
このアプローチには、アーキテクチャ上のメリットが以下のように多数あります。
-
オープン API: Iceberg REST カタログがサポートされているため、ユーザーは単一の統合データセットに対してさまざまな分析ツールを自由に使用できます。
-
マルチエンジンの相互運用性: 登録されたテーブルは、標準の REST インターフェースを介して、Google Cloud Managed Service for Apache Spark、BigQuery、オープンソース エンジンで即座に検出やクエリが可能になります。
-
Iceberg テーブルの読み取り / 書き込みの相互運用性: BigQuery、Managed Spark などの Iceberg 互換エンジンを使用して、Lakehouse ランタイム カタログに登録されている Iceberg テーブルに書き込めます。また、Managed Spark を使用して、外部カタログの Iceberg テーブルに書き込むこともできます。
-
エンタープライズ グレードの機能を備えたフルマネージドの Iceberg ストレージ: Google 独自のインフラストラクチャを使用し、Iceberg テーブルでパフォーマンスの高い分析を実行できます。これにより、オープンソースの柔軟性に加え、パフォーマンス、スケーリング、ガバナンス、マルチモーダル処理のメリットが得られます。
-
データコピー不要: テーブル定義は、基盤となるオブジェクト ストアの既存データを直接参照します。基盤となるデータの移動、書き換え、複製を行う必要はありません。
-
クラウド間の双方向のカタログ連携: 一時的な認証情報と OIDC トークン交換がサポートされており、Databricks Unity、Snowflake Horizon、AWS Glue のデータにアクセスできます。これにより、Google AI を AWS や Azure のデータに直接適用することが可能です。
-
一時的な認証情報によるセキュアなアクセス: カタログは複数の認可メカニズムに対応しており、一時的な認証情報とエンドユーザー認証情報のいずれかを選択できます。そのため、一時的な認証情報などの最新方式を使って、基盤となるオブジェクト ストア(Cloud Storage、AWS S3、Azure Blob Storage)内のファイルに直接アクセスすることなく、テーブルにアクセスすることが可能です。
-
AI を活用したコンテキストとガバナンス: Lakehouse ランタイム カタログは、Knowledge Catalog および Cloud IAM と直接統合されているため、エージェント用の信頼できるコンテキストを定義したり、すべてのコンピューティング エンジンにテーブルレベルのセキュリティを一貫して適用したりできます。また、カタログ内の Iceberg テーブルの検索や、リネージや分析情報の取得にあらかじめ対応しています。
-
アトミック コミットによる同時実行制御、高可用性、スケーラビリティ: Google の地球規模のインフラストラクチャと Spanner を基盤としたアーキテクチャによって、データに合わせてメタデータをスケールするために必要な高可用性、同時実行性、スケーラビリティが得られます。たとえば、Cloud Storage のデュアル リージョン バケットとマルチリージョン バケットのサポートにより、フェイルオーバーのユースケースに対応できます。また、サーバーレスな NoOps 環境によって TCO 削減につながるほか、あらゆるサイズのワークロードに対応可能なスケーラビリティを得られます。
Lakehouse ランタイム カタログの原動力
Lakehouse ランタイム カタログは Spanner 上に構築されているため、高可用性、同時実行性、スケーラビリティに優れているのに加えて、強整合性が保証されています。従来のスケールアップ型のリレーショナル データベースが、単一ノード内で垂直方向の限界に達するのに対し、Spanner は、読み取りと書き込みの両方で水平方向にスケールアウトできるという NoSQL システムならではの柔軟性に加え、完全なリレーショナル SQL のセマンティクス、複数テーブルでの ACID トランザクションというメリットを提供します。
Spanner のリージョン構成では最大 99.99% の可用性が得られ、Lakehouse ランタイム カタログにおいて高可用性を実現できます。さらに、Spanner が自動的なスケーラビリティを Lakehouse ランタイム カタログに提供します。Spanner は水平方向にスケーラブルなデータベースであるため、手動でのシェーディングは必要なく、コンピューティングおよびストレージのリソースが自動的かつ透過的にスケールされます。具体的には、Spanner がデータ量とクエリ負荷を動的にモニタリングし、データ範囲を分割して、ノード間で再分配します。コンピューティング ノードは、CPU 使用率とストレージのしきい値に基づいて、動的にスケールされます。また、スプリット レベルで過負荷を自動検出し、過負荷状態のノードから重いスプリットを移動します。また、Spanner によって、「リレーショナルの整合性」と「分散によるスケーラビリティ」の間の従来のトレードオフが解消され、Lakehouse ランタイム カタログのユーザーは業界最高水準の整合性保証を享受できます。Lakehouse のトランザクションはシリアル化されており、データベース内のトランザクションの順序は、クライアント側でトランザクションのコミットが観察される順序と一致します。この基盤によって、Lakehouse ユーザーは、エージェント規模での運用を実現できます。
さらに、エージェント ユースケースへの対応を強化するため、Lakehouse ランタイム カタログは Knowledge Catalog と直接統合されており、レイクハウス内の Iceberg テーブルを簡単に検出して、信頼できるコンテキストをエージェントに提供することができます。Spanner が提供する全文検索とネイティブのベクトル検索という効率的な組み合わせを Knowledge Catalog で活用して、単一のクエリ内で語彙キーワード検索とセマンティック エンベディングを併用し、検索の再現率を高められます。これらの 2 種類のインデックス タイプは同じベース データセット上に構築されており、ベーステーブルが DML で操作されると、トランザクションの ACID 整合性を厳密に保ちながらインデックスが更新されます。そのため、運用上のオーバーヘッド、たとえば、同期パイプライン、外部ベクトル、全文検索システムの管理といった作業が発生しません。簡潔に言うと、Lakehouse ランタイム カタログを使用すると、エージェントのユースケースを迅速に市場に投入することが可能となります。
分析と運用のワークロードを組み合わせる
Apache Iceberg をベースにした、Google Cloud のボーダーレスな Lakehouse なら、分析データを運用ワークロードと組み合わせることができます。ユースケースとしては、Lakehouse のデータアセットと Spanner からの OLTP データを組み合わせて分析を実行する、Spanner やその他の運用データベースからレイクハウスのアセットにアクセスして低レイテンシのアプリケーションを実現する、ファースト パーティおよびサードパーティのエージェントで会話型分析を行う、など多岐にわたるものがあります。
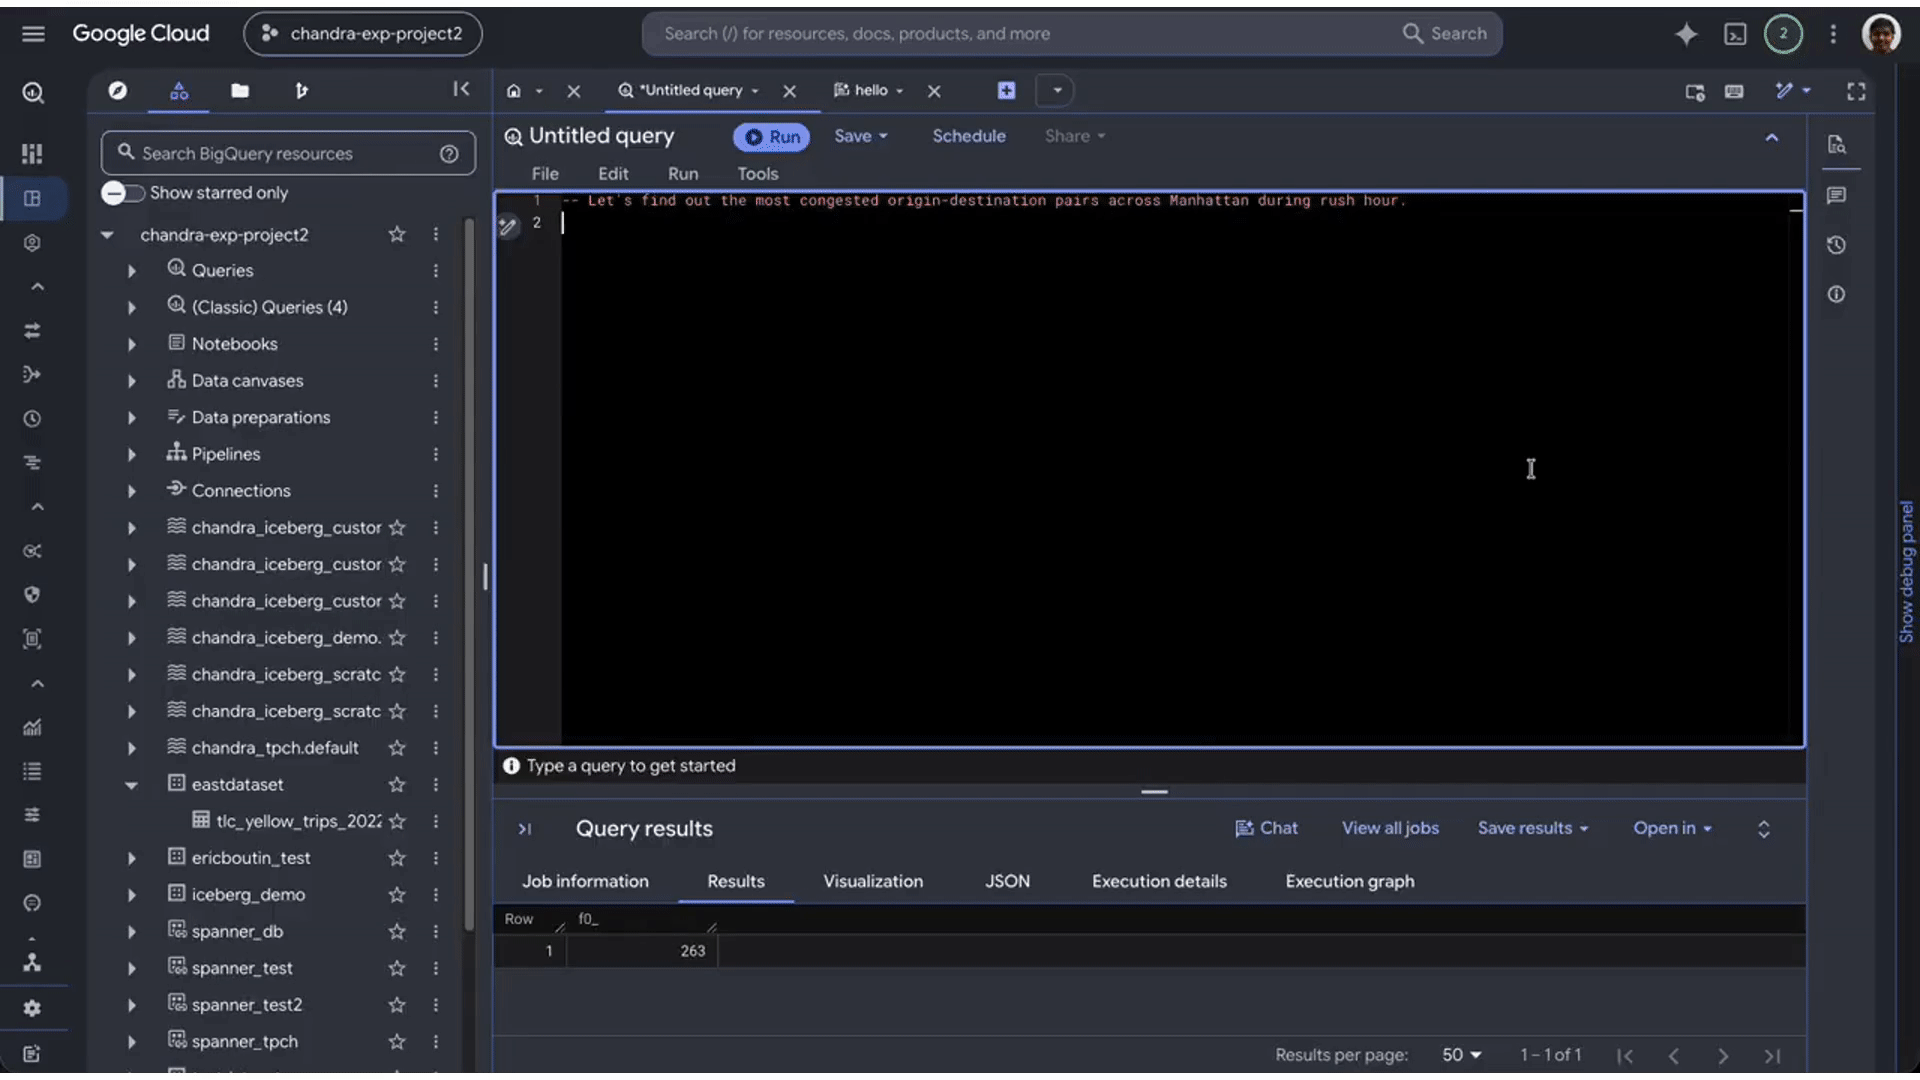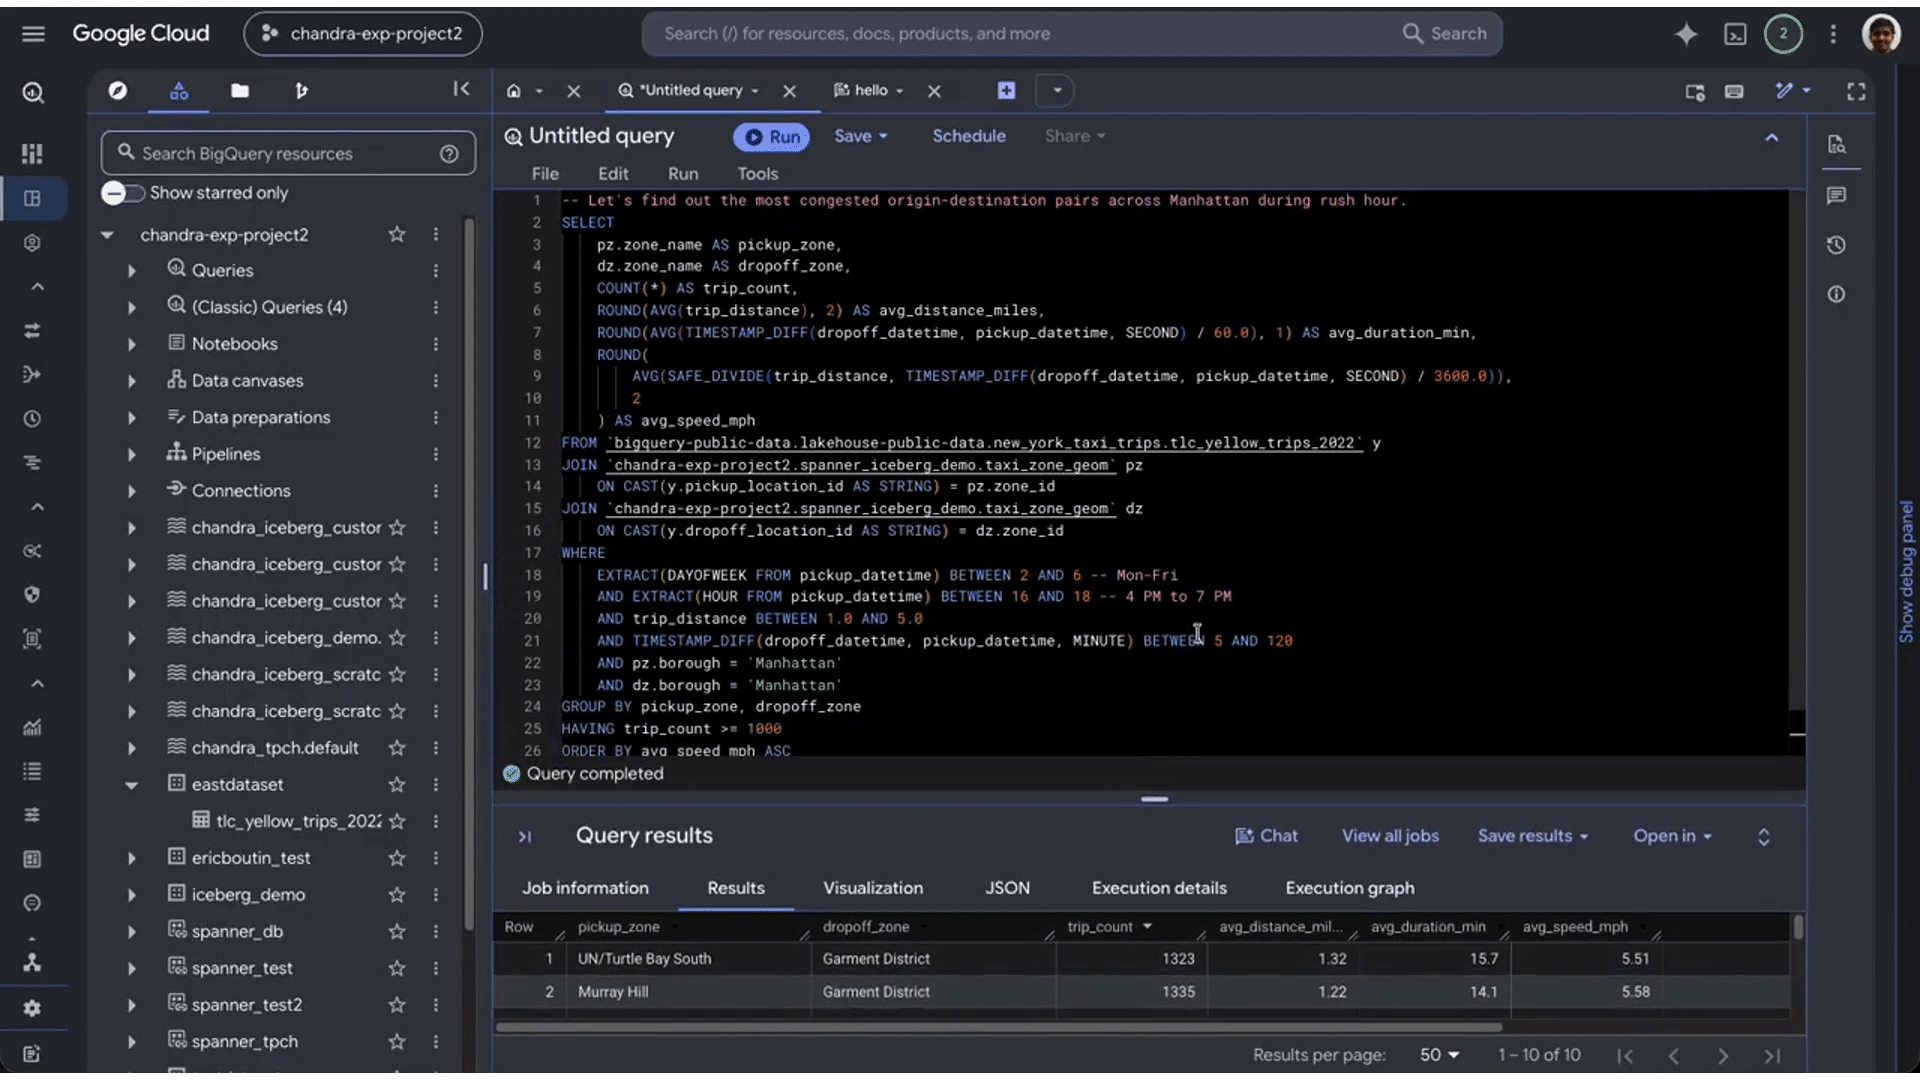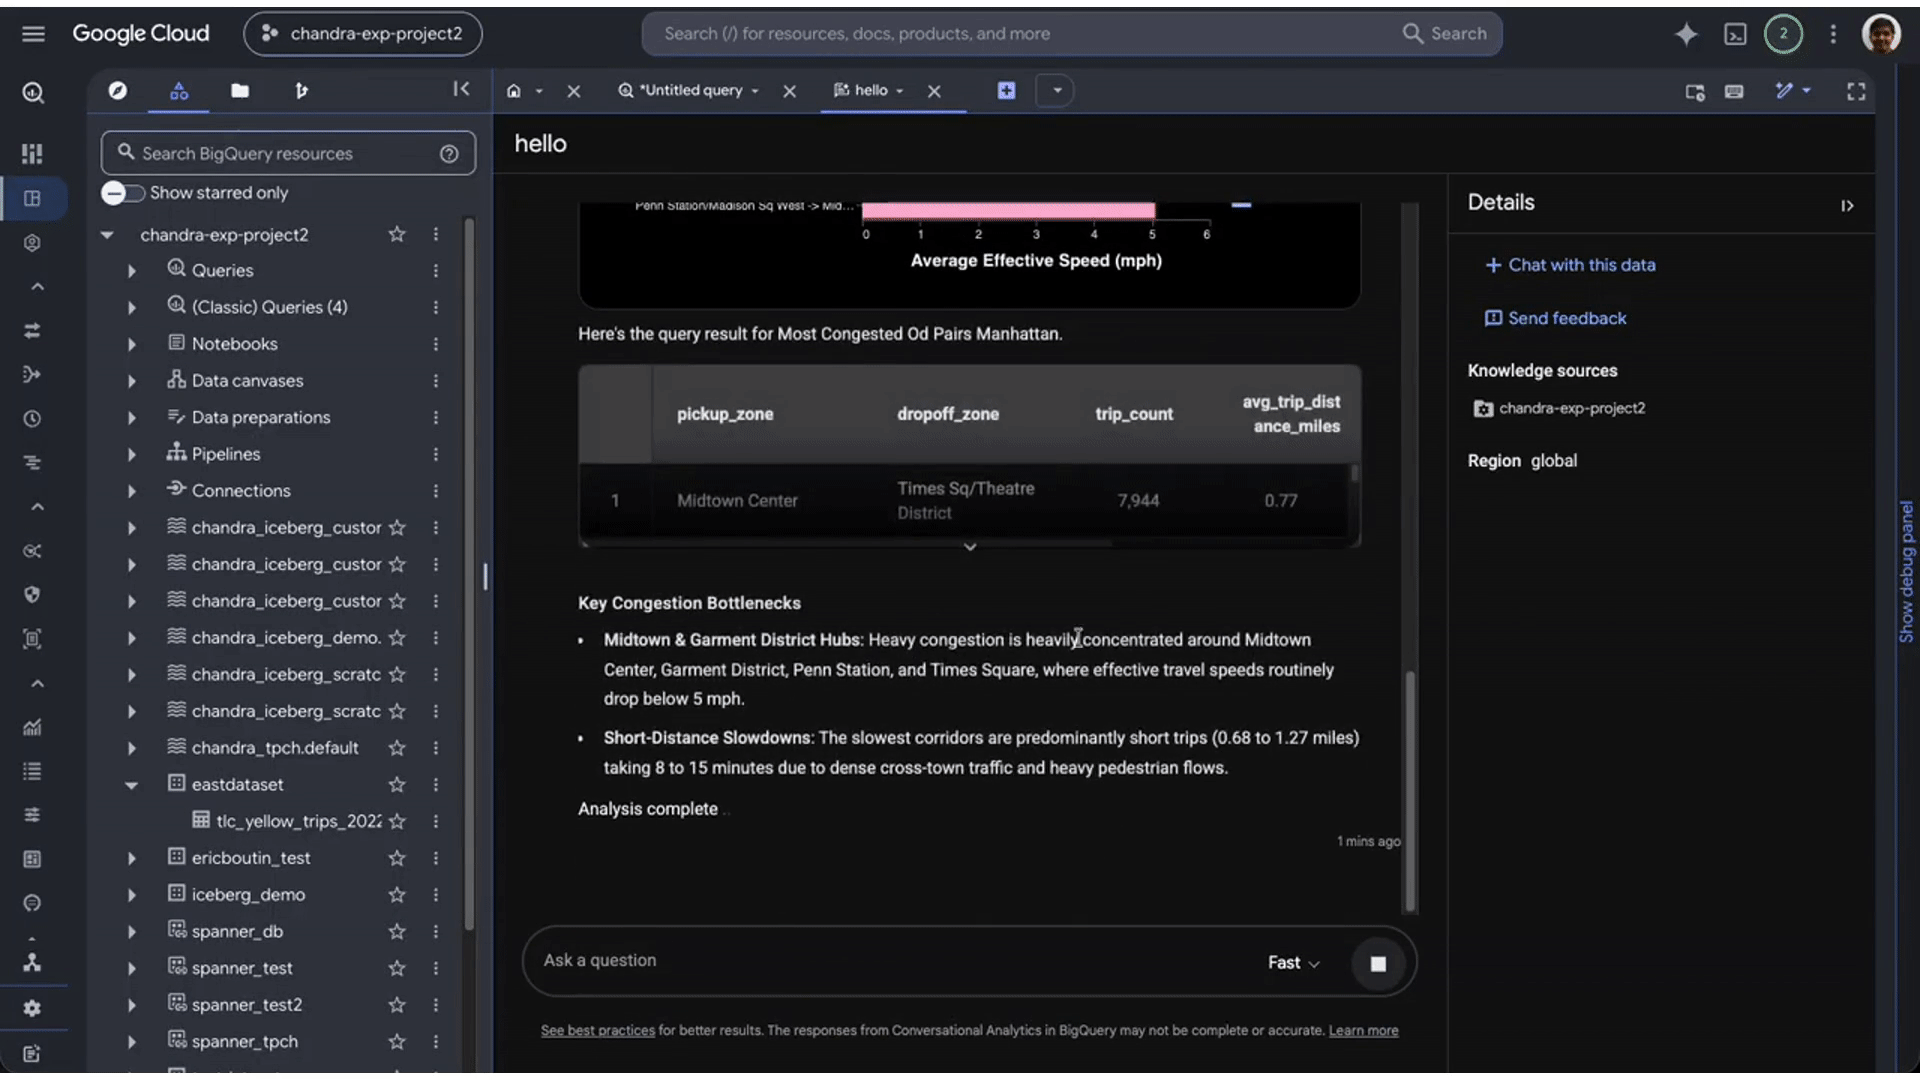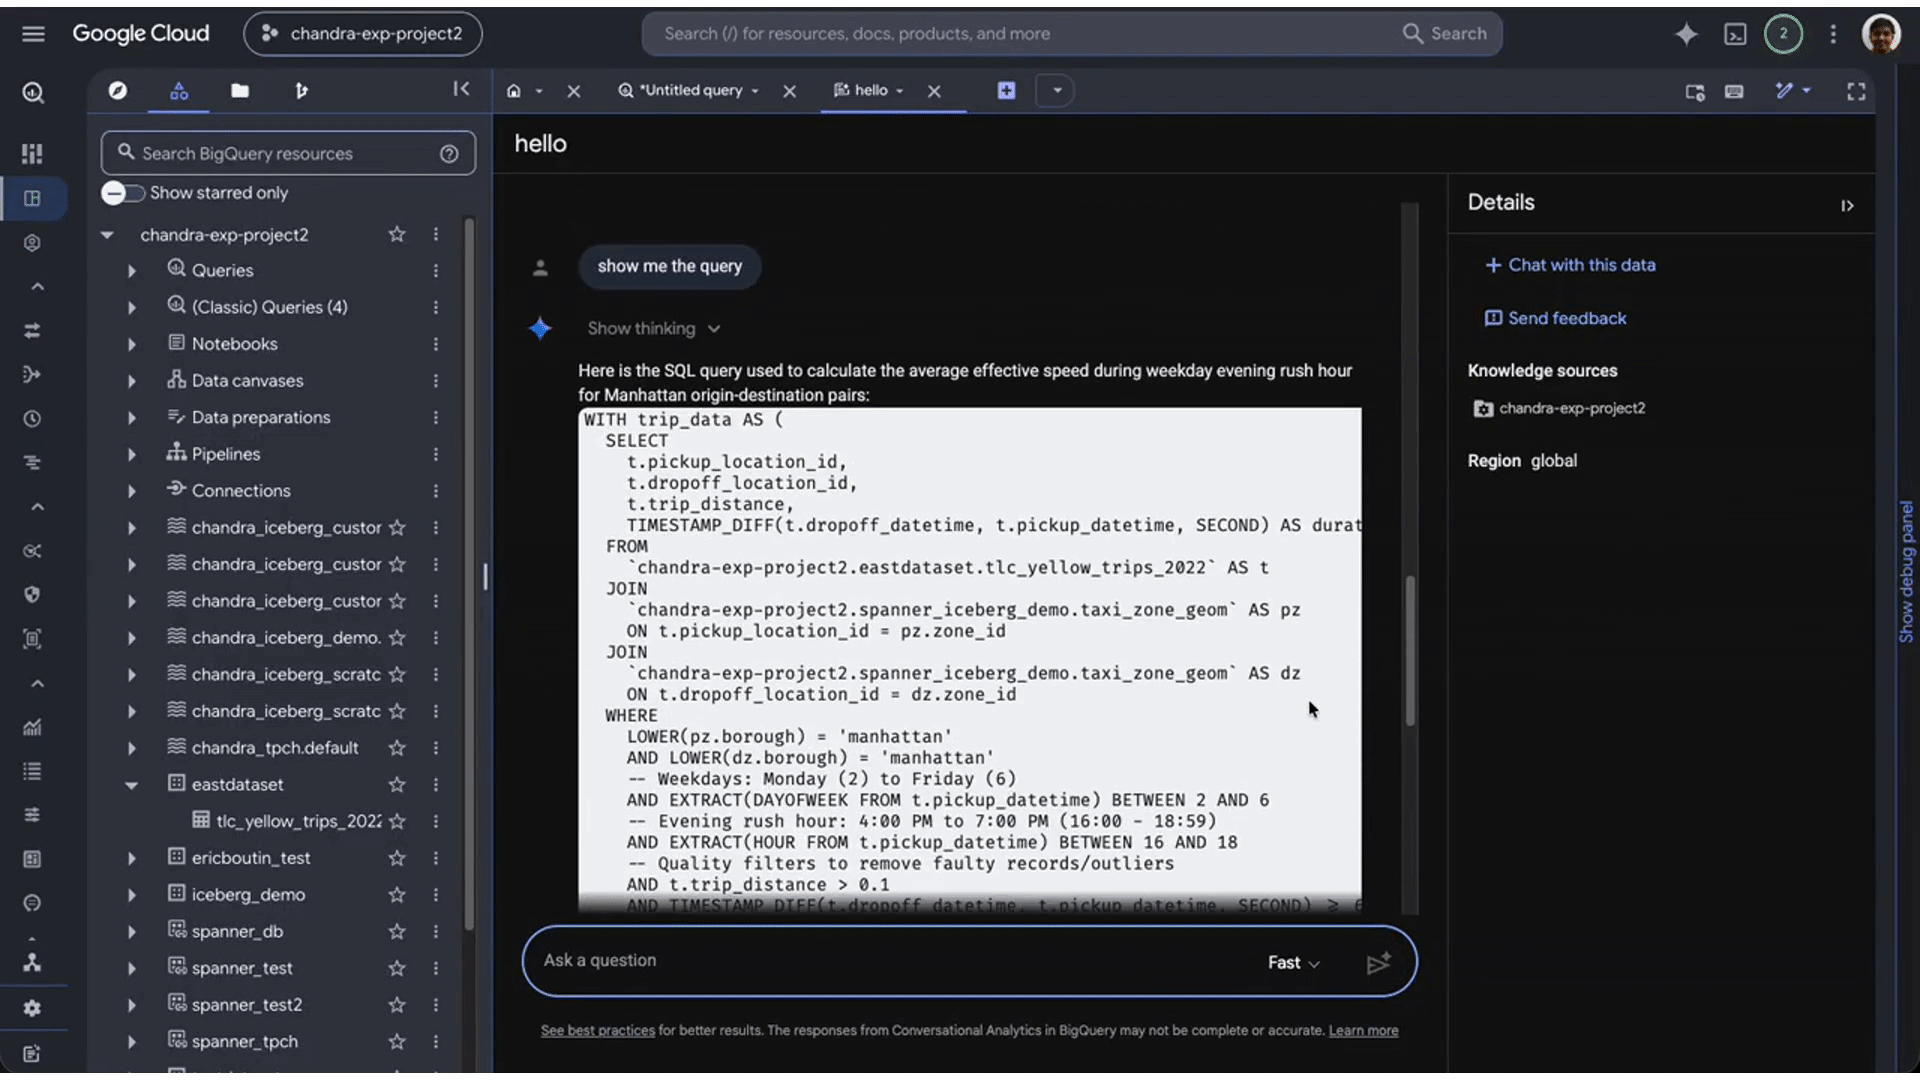
Lakehouse ランタイム カタログと Spanner の動作の例を以下に示します。この例では、マンハッタンのタクシー運行に関する分析データ(Apache Iceberg)と、タクシーのゾーンに関する運用データ(Spanner)を組み合わせて、最も混雑している交通経路を特定しています。さらに、会話型分析エージェントを使ってこの同じデータにアクセスし、二次的な分析情報を取得しています。
マンハッタンで最も混雑している交通ルートを調べる
ボーダーレスな Lakehouse にモダナイズ
Google Cloud の Lakehouse にモダナイズすることによって、分析エンジンやエージェント間のデータサイロを最小限に抑える、マルチエンジンのガバナンスを統合する、信頼できるコンテキストをエージェントに提供する、運用コストを大幅に削減する、といったメリットが得られます。Spanner ベースの Lakehouse ランタイム カタログを活用し、最新のクラウド環境をエージェント規模で運用する基盤を整えましょう。詳細および無料トライアルについては、
Lakehouse のウェブページをご覧ください。Spanner の詳細についてはこちらをご覧ください。
- プロダクト マネージャー、Vinod Ramachandran
- ソフトウェア エンジニアリング マネージャー Mina Mikhail