YugabyteDB と BigQuery を活用したデータドリブンの意思決定
Google Cloud Japan Team
※この投稿は米国時間 2023 年 12 月 2 日に、Google Cloud blog に投稿されたものの抄訳です。
YugabyteDB は分散型 SQL データベースであり、BigQuery と組み合わせることで、データの断片化、データのインテグレーション、スケーラビリティに関するビジネスが直面している問題に対処できるようになります。
データがうまく整理され、またデータが異なる場所に散り散りになることがないため、BigQuery での分析を行いやすい状態になります。YugabyteDB はデータの量に応じて拡張することが可能であり、遅延を発生させることなくさらに多くの情報を処理できます。また、BigQuery の複雑なクエリで信頼性のある結果を得るために重要となる、データアクセスの整合性も維持されます。インテグレーションが効率化されており、単一ソースからのデータの管理および分析を行えるようになるため、全体としての効率を改善して複雑さを低減できます。この組み合わせを活用して、最新で正確な情報に基づいた優れた意思決定を行い、データドリブンの環境での成功につなげることができます。
BigQuery は、SQL に似たクエリを使用して膨大なデータセットを保存、処理、分析することを得意としています。BigQuery は、他の Google Cloud Platform サービスとシームレスに統合されるフルマネージド サービスであり、ユーザーはデータ オペレーションをペタバイト単位までスケーリングすることができます。また、高度な分析機能、リアルタイム ダッシュボード、ML 機能も備えています。これら機能に YugabyteDB を組み込むことで、分析機能をさらに強化して、データ パイプラインを合理化できます。
YugabyteDB は、スケール、可用性、エンタープライズ グレードの RDBMS の機能を、ミッションクリティカルなトランザクション アプリケーション向けに提供するように設計されています。これは強力なクラウドネイティブ データベースであり、あらゆるクラウド環境で活躍します。YugabyteDB ではマルチクラウドおよびハイブリッド クラウド デプロイがサポートされており、YugabyteDB CDC コネクタと Apache Kafka を使用して BigQuery とシームレスに統合できます。このインテグレーションにより、分析用データのリアルタイムでの消費が可能となります。追加のプロセスやバッチ プログラムは不要です。
BigQuery と YugabyteDB のインテグレーションによるメリット
YugabyteDB を BigQuery と統合することのメリットは数多くあります。以下は 6 つの主なメリットです。
- リアルタイムのデータ インテグレーション: YugabyteDB の変更データ キャプチャ(CDC)機能で、データの変更を YugabyteDB と BigQuery テーブルとの間でリアルタイムで同期できます。データをシームレスに流せるため、リアルタイム解析が可能となります。ユーザーは最も新しい情報を利用できるようになるため、最新の情報で分析条件を獲得できるようになります。
- データの正確性: YugabyteDB の CDC コネクタにより、BigQuery 内のデータの正確性が確保され、またデータが常に最新のものになります。このインテグレーションではデータの変更がリアルタイムでキャプチャおよび複製されるため、信頼性の高い情報を意思決定者が自由に使えるようになり、自信をもって情報に基づいた判断を行えるようになります。
- 拡張性: YugabyteDB と BigQuery はどちらも水平スケーリングが可能なソリューションであり、拡大するビジネスの需要に対応できます。データ ボリュームが増加しても、これらのプラットフォームであれば大きなワークロードにシームレスに対応できるため、効率的なデータ処理と分析を維持できます。
- 予測分析: YugabyteDB のトランザクション データと BigQuery の分析機能を組み合わせることで、予測分析の可能性を引き出せるようになります。アプリケーションで傾向の予測、今後のパフォーマンスの予測、問題が発生する前の予防的な対処を行えるため、市場での競争力を高めることができます。
- マルチクラウドおよびハイブリッド クラウド デプロイ: YugabyteDB はマルチクラウドおよびハイブリッド クラウド デプロイをサポートしており、データ エコシステムの柔軟性を上げることができます。そのため、さまざまな環境から来るデータを取得して BigQuery に組み込むことで、統合された包括的なデータのビューを構築できます。
YugabyteDB と BigQuery のインテグレーションのメリットを活用することで、分析機能をさらに強化し、データ パイプラインを合理化して、大規模なデータセットから行動につながる分析情報を獲得できます。データドリブンの意思決定、リアルタイム解析の実行、予測分析の活用など、データ オペレーションのあらゆる用途で YugabyteDB と BigQuery の組み合わせを有効活用できます。
YugabyteDB と BigQuery のインテグレーションに関連する主なユースケース
BigQuery を利用した YugabyteDB の変更データ キャプチャ(CDC)は、重要度の高いさまざまなユースケースで活用されています。主な 2 つの例を見てみましょう。
1.産業 IoT(IIoT): IIoT におけるストリーミング分析とは、生成されるデータレコードをそれと同時に連続的に分析することです。一定の間隔でデータの収集と分析を行うこれまでのバッチ処理とは異なり、ストリーミング分析であればソース(センサー / アクチュエータ、IoT デバイス、Iot ゲートウェイなど)から来るデータのリアルタイム解析を実現できます。このデータは、YugabyteDB に高スループットで書き込むことが可能です。さらに、Google Vertex AI などの AI プログラムを使用した高度な分析用に BigQuery テーブルに連続的にこれをストリーミングすることもできます。
IIoT ストリーム分析の例
BigQuery で産業 IoT デバイスから来るデータの処理と分析を行うことが可能で、効率的な運用とメンテナンスを実現できます。実際の例としては、以下の 2 つがあります。
- サプライ チェーンの最適化: IoT に対応したトラッキング デバイスから来るデータを分析して、在庫のモニタリング、配送の追跡、物流運営の最適化を行えます。
- 優れたエネルギー効率: IoT センサーやメーターから来るデータを分析してエネルギー消費の傾向を特定し、使用を最適化して、コストを削減できます。
2.機器の予測メンテナンス分析: 製造、通信、計測などのさまざまな業界で、機器の予測メンテナンス分析は一般的かつ重要なユースケースになっています。YugabyteDB は、機器の通知やパフォーマンス データのリアルタイムでの収集と保存において、重要な役割を果たします。現場のオペレーター向けの運用に関するレポートの生成がシームレスになり、その時点での作業指示や通知をオペレーターに伝えられるようになります。
メンテナンス分析は、機器の寿命の判断や、メンテナンスの要件を特定するうえで重要になります。YugabyteDB CDC を利用することで、BigQuery 内にある分析データのインテグレーションが簡単になります。通知のストリームと作業指示を BigQuery テーブルにプッシュすることで、履歴データを蓄積させることができるため、ML や AI モデルの開発を行えるようになります。故障確率、リスク評価、機器の健全性スコア、部品の予測在庫レベルなどに関する追跡の目的でこれらのモデルを YugabyteDB にフィードバックすることが可能です。このインテグレーションにおいては、高度な分析が利用できるようになるだけではありません。現場のサイト エンジニアやメンテナンス担当者にとって適したデータが OLTP データベース(この場合は YugabyteDB)に保存されるようになります。
では、CDC を使用した YugabyteDB と BigQuery のインテグレーションがいかに簡単か、見てみましょう。
YugabyteDB と BigQuery とのインテグレーション アーキテクチャ
以下の図(図 1)は、YugabyteDB の BigQuery へのエンドツーエンドのインテグレーション アーキテクチャを示しています。
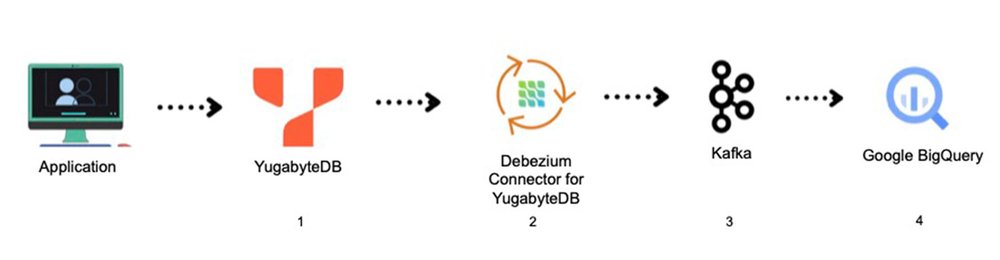
図 1 - エンドツーエンド アーキテクチャ
以下の表は、オペレーションとタスクが実行されている状態でのデータフローのシーケンスを示しています。
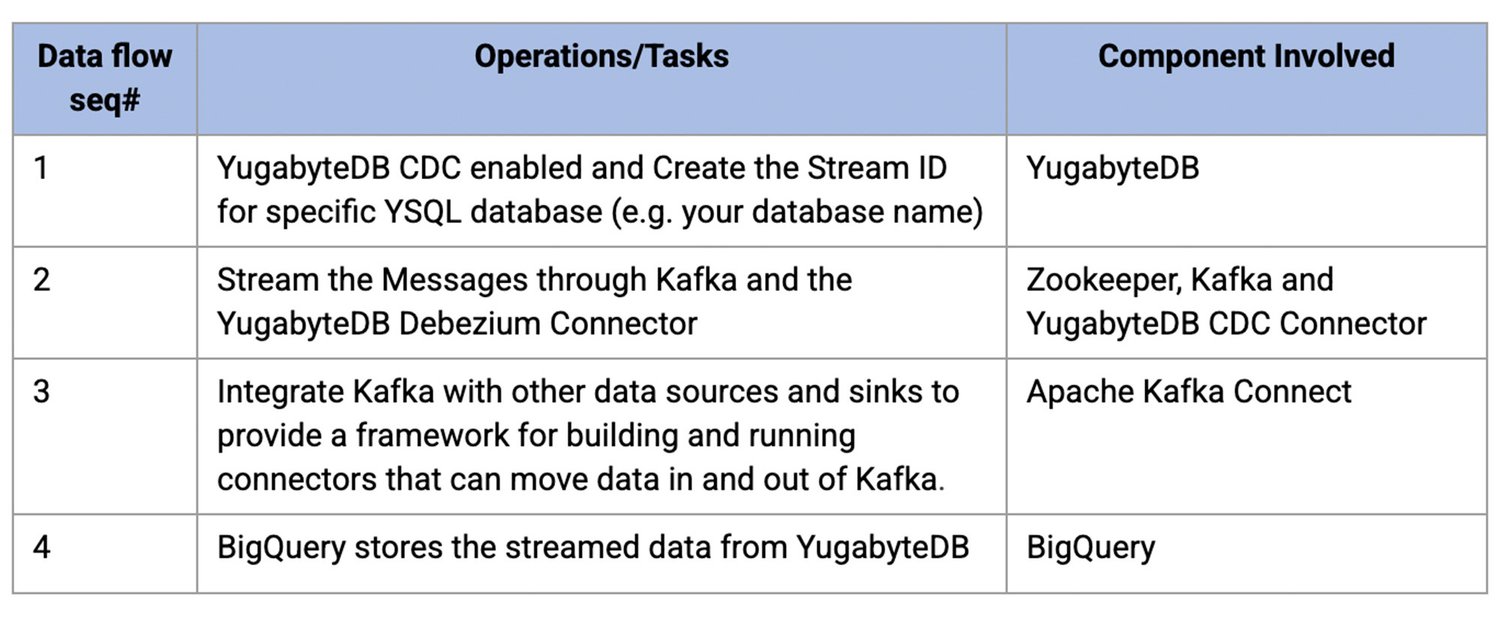
注: #1 で言及されているストリーム ID を作成するためのリンク
- BigQuery シンクを設定する
YugabyteDB をインストールする
このリンクを使用して、Google Cloud Marketplace から入手できる YugabyteDB をデプロイできます。また、YugabyteDB のインストールやデプロイの方法は他にもあります。Windows で実行している場合は、YugabyteDB で Docker on Windows を使用できます。
YugabyteDB CDC と Debezium コネクタをインストールして設定する
(上記のアーキテクチャ図のように)データベースの変更をキャプチャするように YugabyteDB CDC が構成されていて、その依存コンポーネントとともに実行中であることを確認します。このドキュメントのように、Kafka トピック名とグループ名が表示されるはずです。これは、CLI または Kafka UI(たとえば、KOwl を使用した場合)のいずれかを介してストリーミング ログ内に表示されます。
BigQuery コネクタをダウンロードして構成する
BigQuery コネクタをダウンロードします。JAR ファイルの解凍と YugabyteDB の CDC(Debezium コネクタ)Libs フォルダ(例: /kafka/libs)への追加を行います。次に、Docker コンテナを再起動します。
Google Cloud で BigQuery を設定する
Google Cloud で BigQuery を設定することで、スケーラブルでサーバーレスな、統合された分析プラットフォームを構築することが可能であり、これはデベロッパーと DBA の両者にとってのメリットになります。データ分析プロセスの簡素化、コラボレーションの促進、セキュリティとコンプライアンスの確保を図り、リアルタイムの処理をサポートします。これらは究極的には、より効果的で効率的なデータドリブンの意思決定につながります。
次の 5 段階の手順で Google Cloud で BigQuery を設定します。
- Google Cloud Platform アカウントを作成します。アカウントがない場合は、Google Cloud コンソールに移動してプロンプトに従うことで、Google Cloud Platform アカウントを作成します。
- 新しいプロジェクトを作成します(未作成の場合)。Google Cloud コンソールにログインして、ページ上部にある [プロジェクトの選択] プルダウン メニューをクリックして、[新しいプロジェクト] をクリックすることで新しいプロジェクトを作成します。プロンプトに従い、新しいプロジェクトを設定します。
- 課金を有効にします(まだ有効になっていない場合)。注: BigQuery を使用する前に、Google Cloud アカウントで課金を有効にする必要があります。これを行うには、Google Cloud コンソールの [課金] セクションに移動して、プロンプトに従います。
- BigQuery API を有効にする: BigQuery を使用するには、プロジェクトで BigQuery API を有効にする必要があります。これを行うには、Google Cloud コンソールの [API とサービス] セクションに移動して、[API とサービスを有効にする] をクリックします。「BigQuery」を検索して、[有効にする] ボタンをクリックします。
- IAM(Identity and Access Management)でサービス アカウントを作成して BigQuery ロールを割り当てる: 図 4 に示すように、サービス アカウントを作成して BigQuery 用の IAM ロールを割り当てます。BigQuery テーブルを作成するには、以下のロールが必要になります。
- BigQuery データ編集者
- BigQuery データオーナー
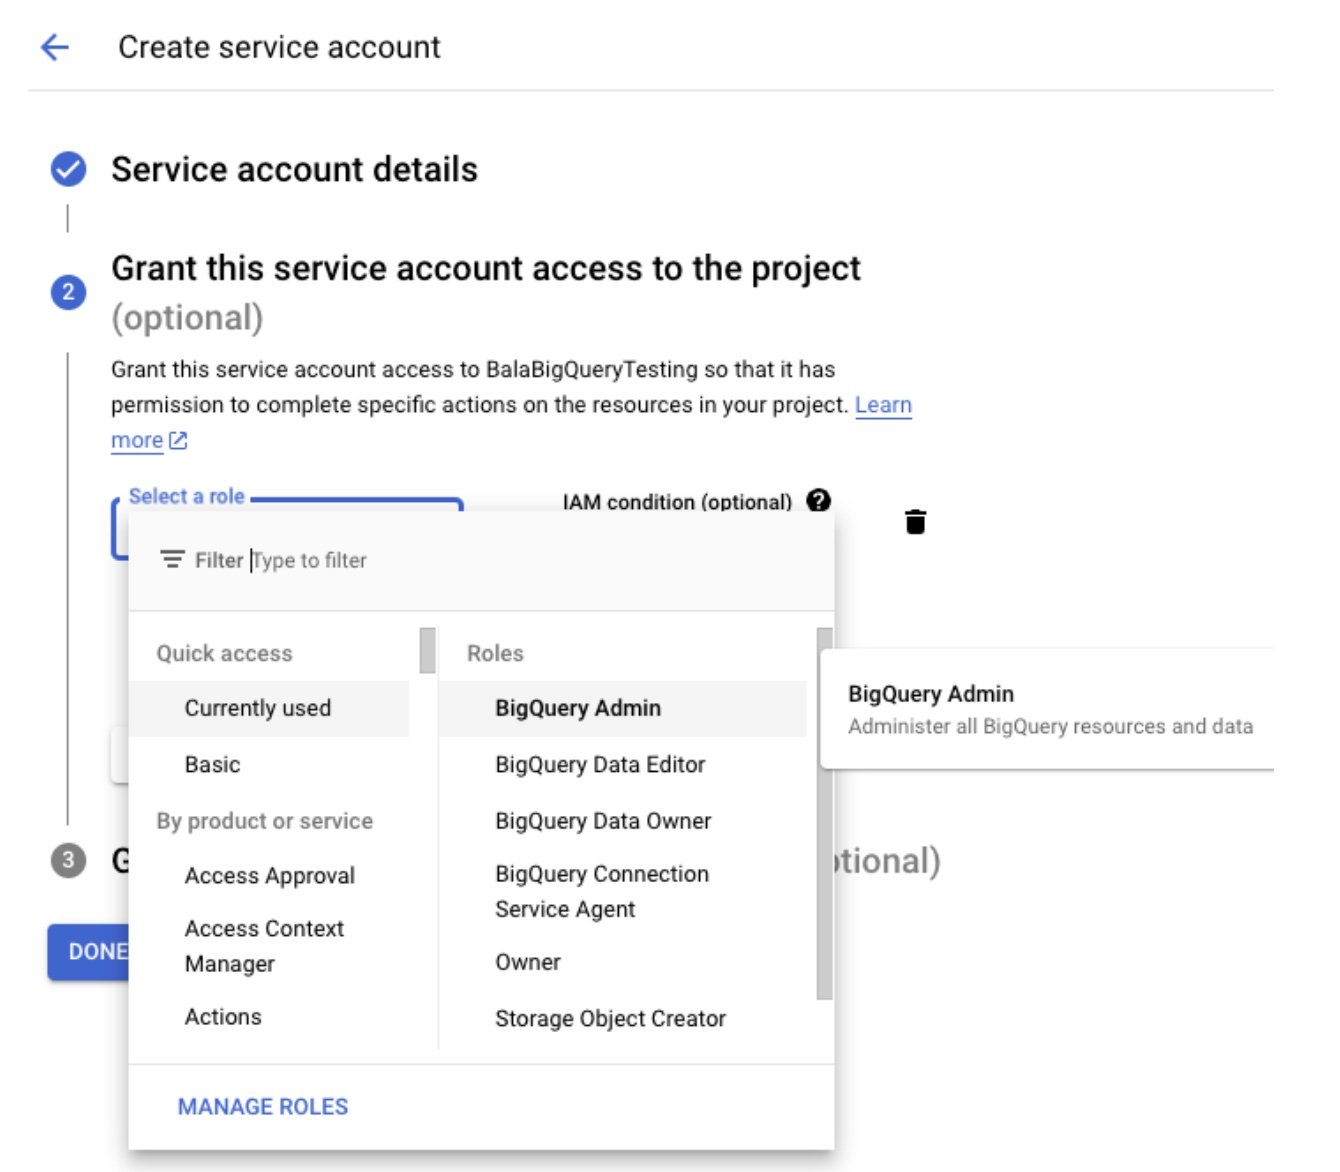
図 2 - Google Cloud - BigQuery 用のサービス アカウント
サービス アカウントを作成すると、図 3 に示されているように詳細が表示されます。サービス アカウントの秘密鍵および公開鍵を作成して、これをローカルマシンにダウンロードします。これを YugabyteDB の CDC Debezium Docker コンテナにコピーする必要があります。これは、指定のフォルダ(例: "/kafka/balabigquerytesting-cc6cbd51077d.json")にあります。コンテナのデプロイ時にこれを参照します。
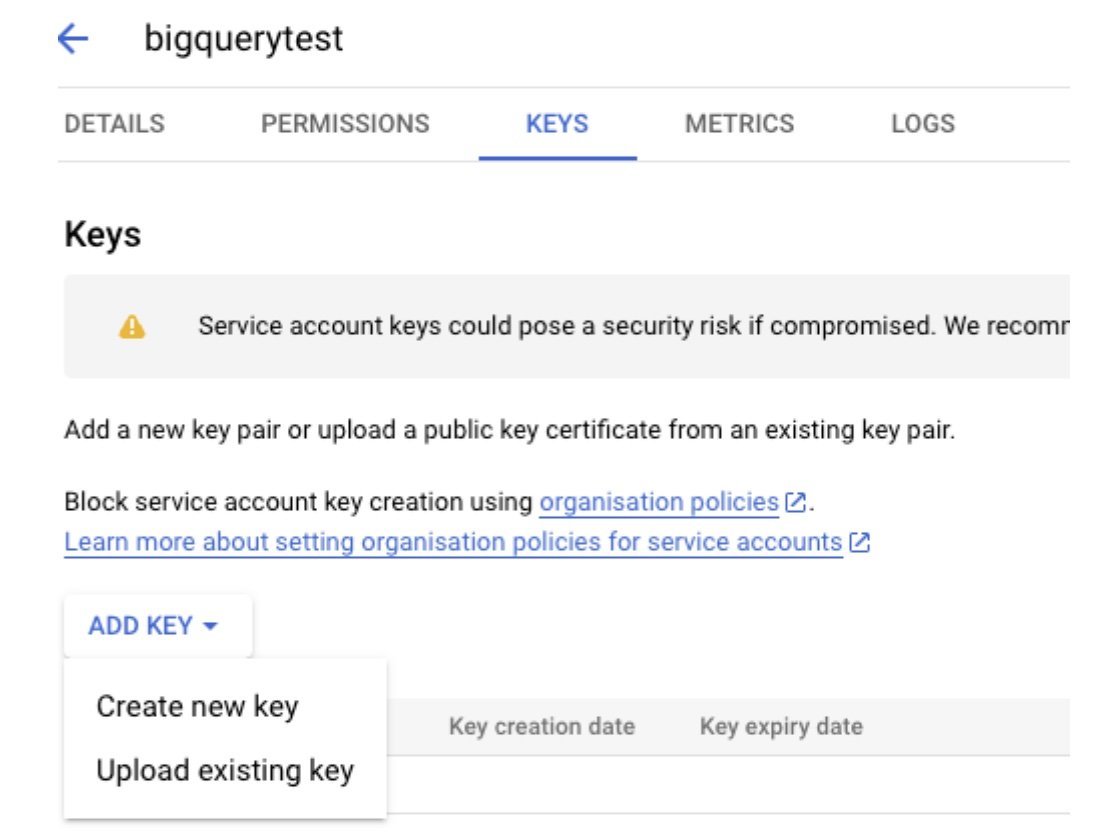
図 3 - Google Cloud - サービス アカウントの鍵の生成
2.BigQuery コネクタ用の構成をデプロイする
ソースコネクタ
以下に示すようにソースコネクタを作成およびデプロイして、データベースのホスト名、データベース マスター アドレス、データベース ユーザー、パスワード、データベース名、論理サーバー名、table include リスト、StreamID を CDC 構成に従い変更します(黄色でハイライト表示されているコードブロックを参照)。
ターゲット コネクタ(BigQuery コネクタ):
以下の構成は、サンプルの BigQuerySink コネクタを示しています。トピック名、Google プロジェクト、データセット名、デフォルトのデータセット名(黄色でハイライト表示)を実際の具体的な構成に応じて置き換える必要があります。
鍵ファイルのフィールドには、Google プロジェクトの秘密鍵の場所が含まれます。これは、YugabyteDB の CDC Debezium Docker コネクタ フォルダ内に保持する必要があります。(例: /kafka)
3.BigQuery コンソールでの出力
デプロイ後、テーブル名(例: dbserver11_public_testcdc)が BigQuery で自動的に作成されます(以下をご覧ください)。
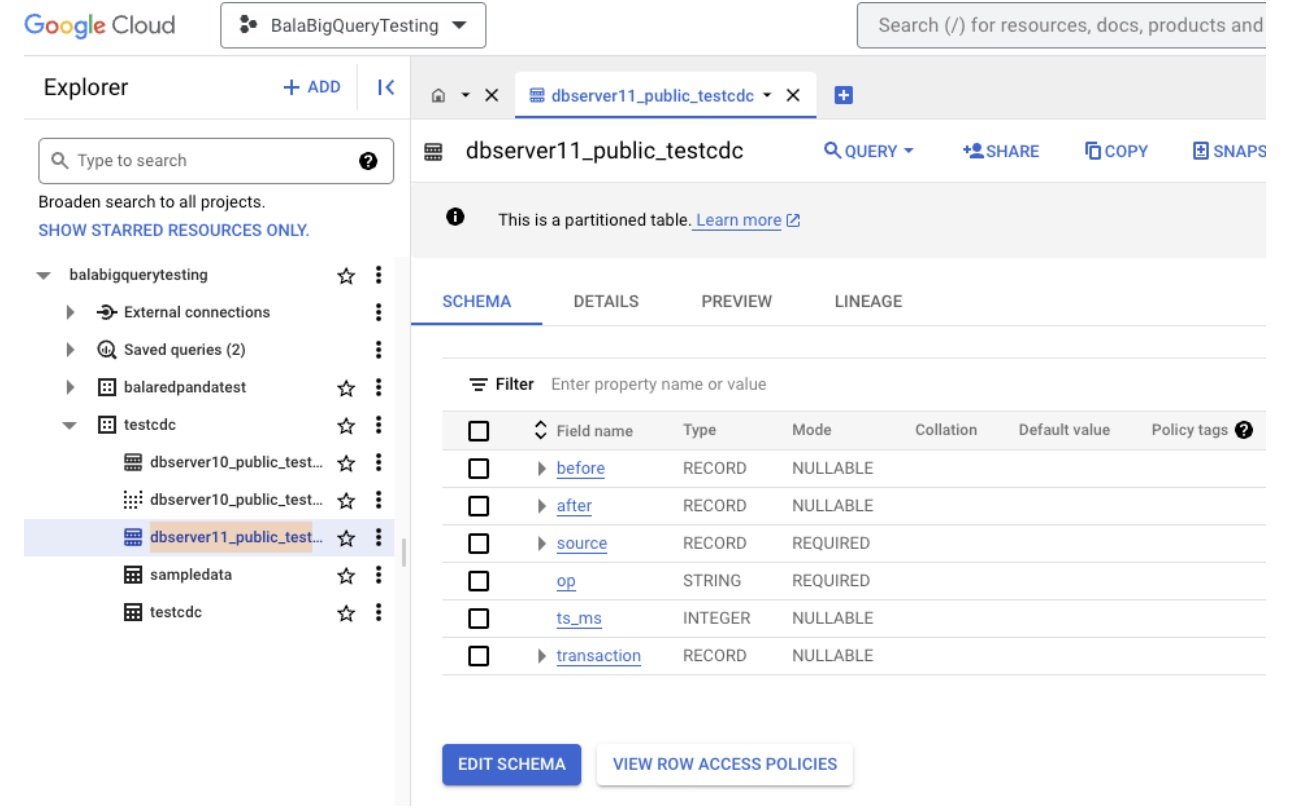
図 4 - BigQuery テーブルに保存されたデータ

図 5 - BigQuery - サンプル BigQuery テーブルの実行の詳細を以下に示します。

図 6 - クエリ実行の詳細
結論とまとめ
上記の手順に沿うことで、YugabyteDB の CDC コネクタを BigQuery に統合できます。
YugabyteDB OLTP のデータと BigQuery のデータを組み合わせることで、リアルタイム解析、ML による高度な分析、履歴の分析、データ ウェアハウジングとレポートなど、さまざまな形でアプリケーションに活用できます。YugabyteDB は、アプリケーションにより生成されるトランザクション データをリアルタイムで保持します。一方で BigQuery のデータは通常、主として分析に用いられる大規模な履歴データセットです。これらの 2 種類のデータを組み合わせることで、アプリケーションが両者の強みを活用できるようになります。このようにしてリアルタイムの分析情報を実現し、情報に基づいた意思決定をより迅速で正確な、優れたものとすることができます。
次のステップ:
- YugabyteDB の詳細を確認する
- Distributed SQL for Dummies で分散 SQL の詳細を確認する
- 実際にお試しになりたい場合は、Google Cloud Marketplace で YugabyteDB を入手し、初めての地理的に分散したアプリケーションを構築しましょう。
ー プリンシパル ソリューション エンジニア Balachandar Seetharaman