混沌としたデータを明確なデータに: Tamr の Data Product による Google 生成 AI の活用法
Dr. Ali Arsanjani
Director, Applied AI Engineering, Google
Alex Pagan
Cofounder and Principal Engineer, Tamr
※この投稿は米国時間 2024 年 5 月 25 日に、Google Cloud blog に投稿されたものの抄訳です。
あらゆる規模の企業が、自社のビジネスを正確、完全、最新の状態で把握することの価値を認識しているため、データ戦略とインフラストラクチャに多額の投資を行っています。最近の生成 AI の進歩に伴い、高品質のデータを求める切迫感は高まり続けています。しかし、データ フットプリントが増大するにつれて、ビジネスを構成する主要な人物、企業、ベンダー、商品が数多くのデータベースやオペレーション システムにおいてそれぞれ異なる方法で表現されるようになったため、多くの組織はデータから約束された価値を得ることができていないと感じています。これは驚くほど難しい課題であり、企業は何十年もの間、従来の MDM ソフトウェア、DIY ソリューション、自社開発のソリューションなどを使用して、ルールおよびガバナンスベースのマスターデータ マネジメントの取り組みによる解決を目指してきましたが、大きな成功にはつながっていません。
幸いなのは、AI を活用することで、一見手に負えないこの問題がついに解決に向かっており、それによって短期間でビジネス価値がもたらされているということです。企業は、分析の改善、成長の加速化、効率性の向上に必要な、信頼できるゴールデン レコードを生成するために、複数のソースシステム間でデータ エンティティを調整できるようになりました。しかも、月単位や年単位の時間をかけず、わずか数週間のうちに、場合によっては時間をかけることもなく、この処理を完了できます。これについてより深く理解するには、この問題とその解決策に関する詳細を調査することが重要です。
エンティティの重複に関する問題
信頼できるゴールデン レコードを手に入れるための最初の課題は、エンティティの重複への対処です。同じシステム内であっても、顧客レコードが大量に重複しているため、信頼性の高いレポートが提供されない可能性があります。これが、Tamr で「難題」と呼ばれている問題です。2 つのレコードが同じエンティティを表しているかどうかを判断できるよう、正しい情報が含まれているデータセットのファセットを特定しなければならない状況で、組織はこの問題に直面します。さまざまな種類のデータソースをまとめて解決する必要がある場合、このプロセスは一気に複雑化します。多くのデータ組織は、スキーマ構造(特に情報の粒度)の違いにより、レコードの同一エンティティへの統合に関する追加のルールを使用して、データを同様に構造化するための複雑なルールベースの ETL パイプラインの開発を余儀なくされています。たとえば、名、ミドルネーム、姓のすべての列を含むテーブルと、フルネームの列のみを含む別のテーブルがあるとします。このデータの重複排除はエラーが発生しやすく、保守が困難で、データドリフトを考慮すると調整はさらに困難です。
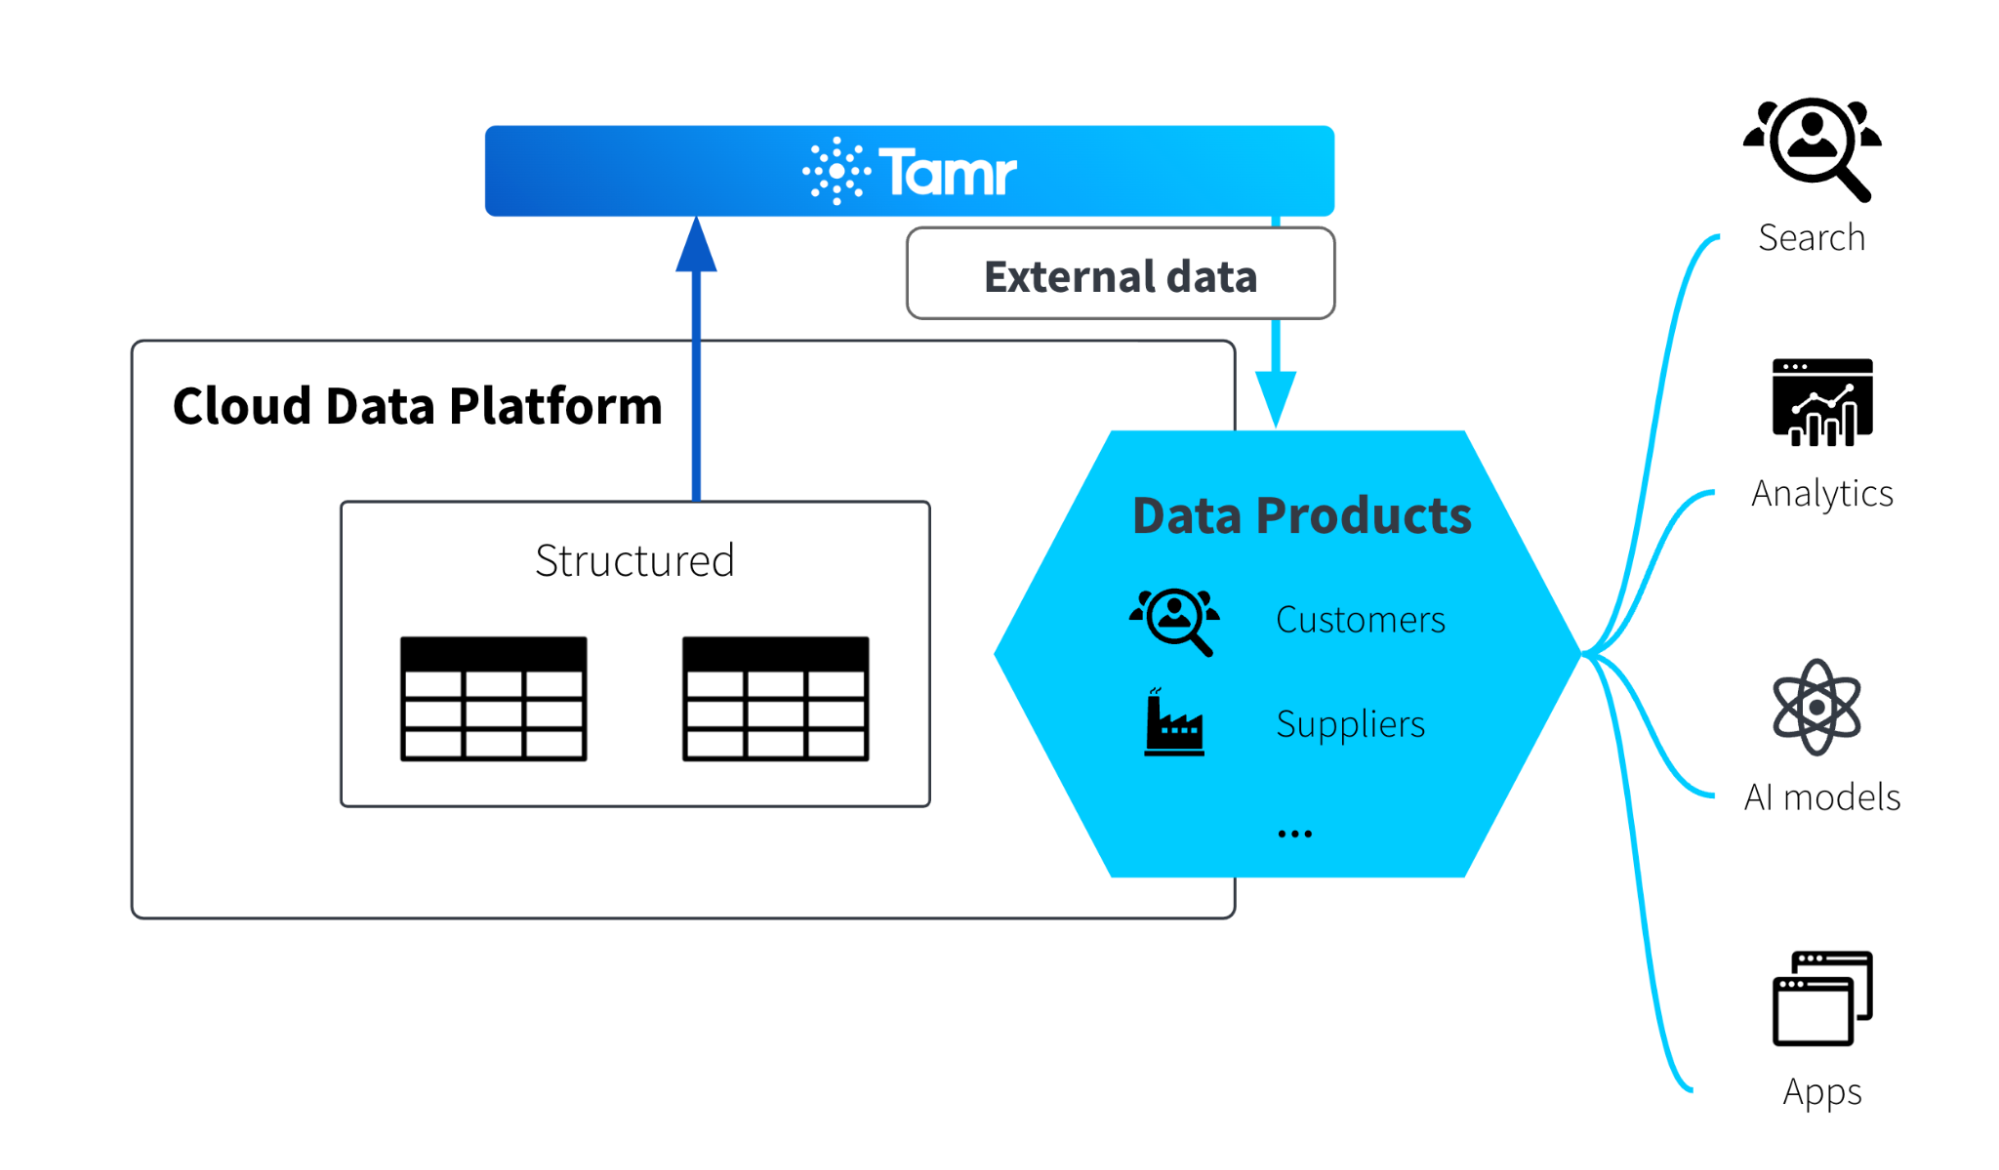
Tamr は、この難題を解決するために AI を活用した Data Product を提供しており、顧客、連絡先、サプライヤー データなどの主要なデータドメインに対して、企業全体にわたる正確なエンティティの解釈と大規模なゴールデン レコードの作成を実現しています。すぐに使用できるテンプレート化されたこれらのソフトウェア ソリューションでは、ML ベースのマスタリング モデル、データ クリーニングと標準化サービス、よく知られた参照データセットによる拡張によって、データを全社的に改善します。Tamr の Data Product は、ユーザーの入力データを特定のドメインの標準スキーマにマッピングすることで、ドメイン固有のパイプラインと ML モデルを活用して、高品質の結果をエンドユーザーに提供できます。これらのソリューションではコード構成がまったく、またはほとんど不要であり、ホストされた SaaS 環境でプロセス全体が実行されます。
AI によるデータ解決の強化
Tamr は 2013 年以来、ML を使用して、競合しやすい異種のスキーマ形式と分類を統合することでボトムアップのデータ マスタリング(ゴールデン レコードの作成)を実行してきましたが、Google Vertex AI と、Gemini などの最先端の基盤モデルを活用してソースシステムに存在するセマンティック情報を利用し、それらのデータアイテムを実世界のエンティティとして解釈するよう、Data Product を強化しました。
Google の Gemini は、コーディング、数学、分類、翻訳、自然言語生成などのタスクにおいて、過去のイテレーションを超える高度な大規模言語モデルです。Gemini の成功の要因は、スケーリング、データセットの多様性、モデルのアーキテクチャの改善です。
これらの機能により、ますます多様化するデータソースからこれまで以上に簡単に価値を得られるようになります。Tamr の Data Product は、基盤モデルを使用して、ソースシステムに存在するセマンティック情報を活用し、データを実世界のエンティティとして解釈します。
また、Gemini によって、ETL や従来の ML モデル開発なしで、ソースデータの可能性を最大限に引き出すことが可能になりました。つまり、Tamr の Data Product は、Google の生成 AI を使用することでより多くのことを実現しながら、構成と本番環境へのデプロイのシンプルで宣言的なエクスペリエンスを維持できます。
ユースケース
Google の生成 AI 機能が Tamr の Data Product をどのように強化しているかを示すために、販売動向をより深く理解したいと考えている e コマース企業の例を見てみましょう。
この会社は、さまざまな市場セグメントで最も効果的な商品の種類を把握したいと考えていますが、商品カタログには分析に役立つ信頼できるメタデータがありません。この情報の多くは商品名に直接含まれています。このサンプルは、BigQuery でホストされている theLook eCommerce の一般公開データセットをダウンロードして確認できます。
ユースケース 1: 構造化されたテキストの抽出
この e コマース企業は、分析に必要なデータを取得するため、高額な費用がかかる手動でのラベル付けプロジェクトを開始することもできますが、このアプローチを導入し、長期にわたって維持することは困難です。戦略的意思決定を行うために属性を追加するには、多大な限界費用と労力を要します。また、商品カタログは時間の経過とともに変化するため、データを最新の状態に維持する必要があります。初期の作業だけでは不十分であり、継続的なプロセスによって高品質のデータを維持する必要があります。
また、プロジェクトを開始するために必要な情報の多くは、カタログに存在する商品名データにすでに含まれています。以下はその例です。
これらの名前には、分析用に抽出できる以下の重要情報が含まれています。
-
ブランドと商品ライン
-
素材
-
スタイルとフィット感
-
柄
-
色
-
個数
しかし、商品名の内容の表現方法は商品やメーカーごとに異なります。同様に、分析に必要なファセットもエンドユーザーごとに異なる場合があります。特定の商品分野(メンズのアウターウェアなど)の売り上げの最適化に重点を置いているグループは、顧客の地理的セグメント全体の行動パターンを総合的に評価しているグループと比較すると、素材やスタイルに関して非常に詳しい情報を必要としている可能性があります。
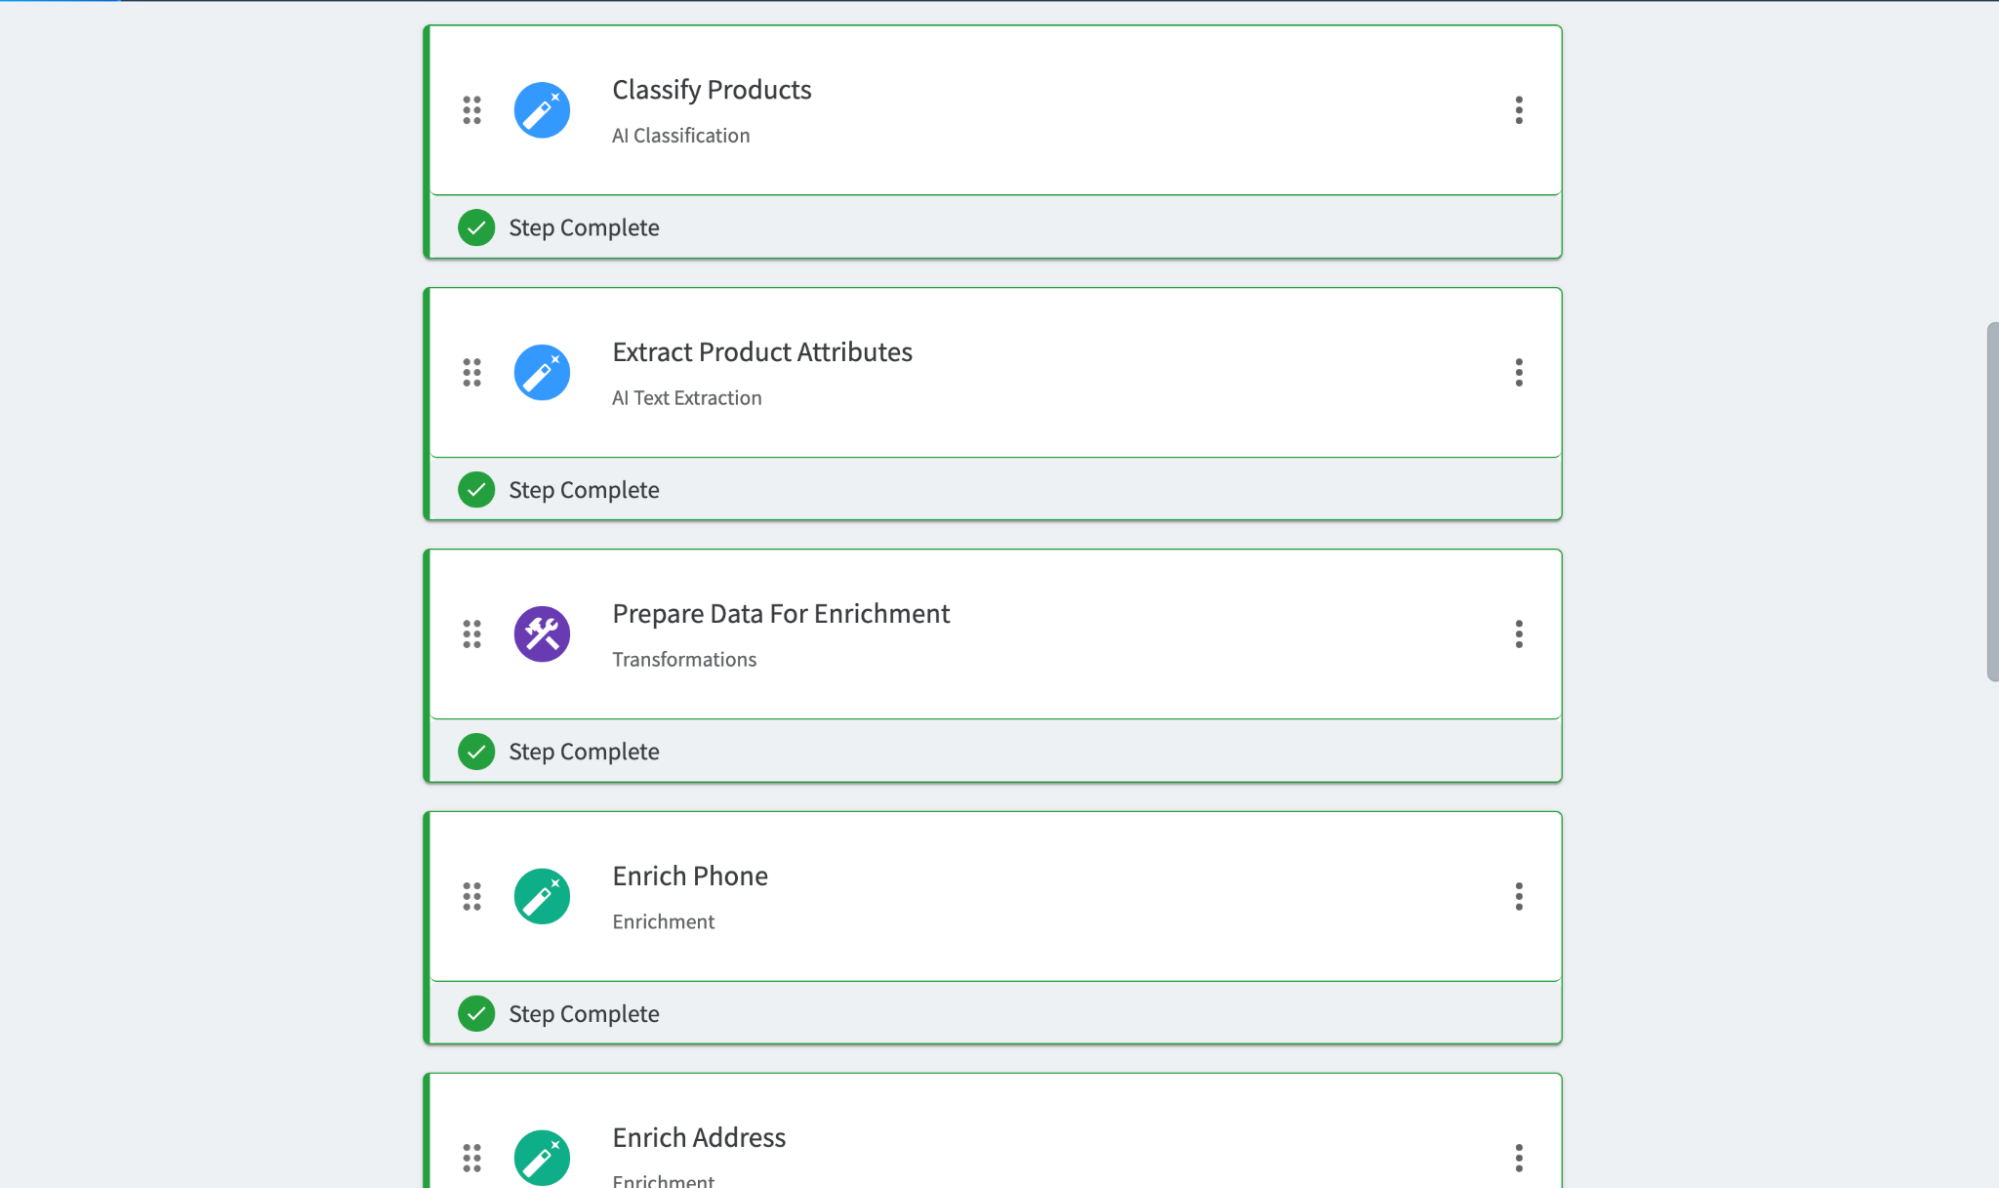
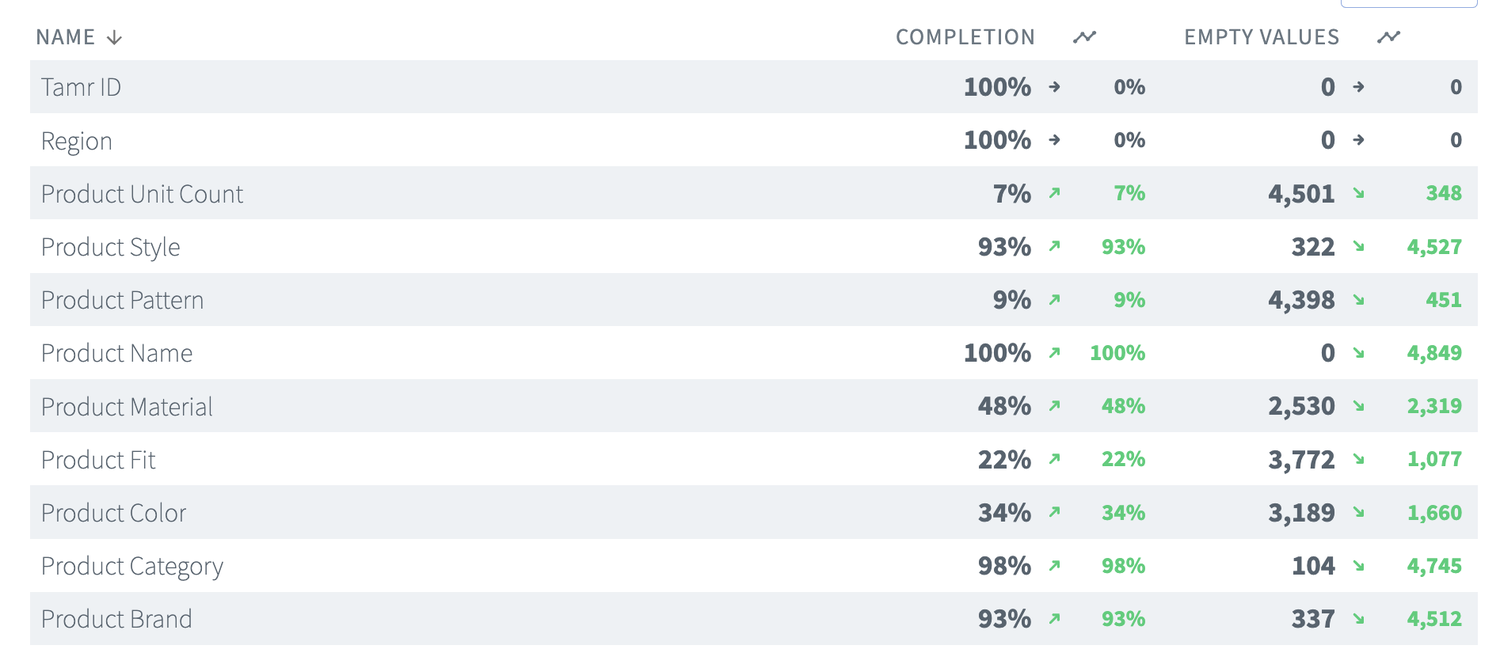
Tamr の Data Product は、Gemini を活用して、商品の素材、寸法やその他の関連プロパティを含む構造化データをテキスト フィールドから自動的に抽出できるようになりました。Data Product のユーザーは、AI テキスト抽出が有効になっている Data Product で使用されるデータモデルに応じてスキーマを調整する際に、商品説明が含まれる属性を識別するだけでこの情報にアクセスできます。
Data Product は、予期される出力スキーマの宣言的定義を使用してすでに構成されており、お客様のデータの特定の特性にテキスト抽出動作を適応させるため、少数ショットのサンプルによって拡張できます。
Tamr が Google 生成 AI を使用することで、お客様はコードや ML のトレーニングを必要とせずに Data Product 内で最先端のテクノロジーを活用できるようになります。その結果、データを把握していても IT 組織との効果的な ETL パイプラインの調整に苦労しているビジネス ユーザーにとって、価値実現までの時間が大幅に短縮されます。
最後に、Data Product を実行した後、下流の分析や追加キュレーションの出力で新しい属性を利用できます。
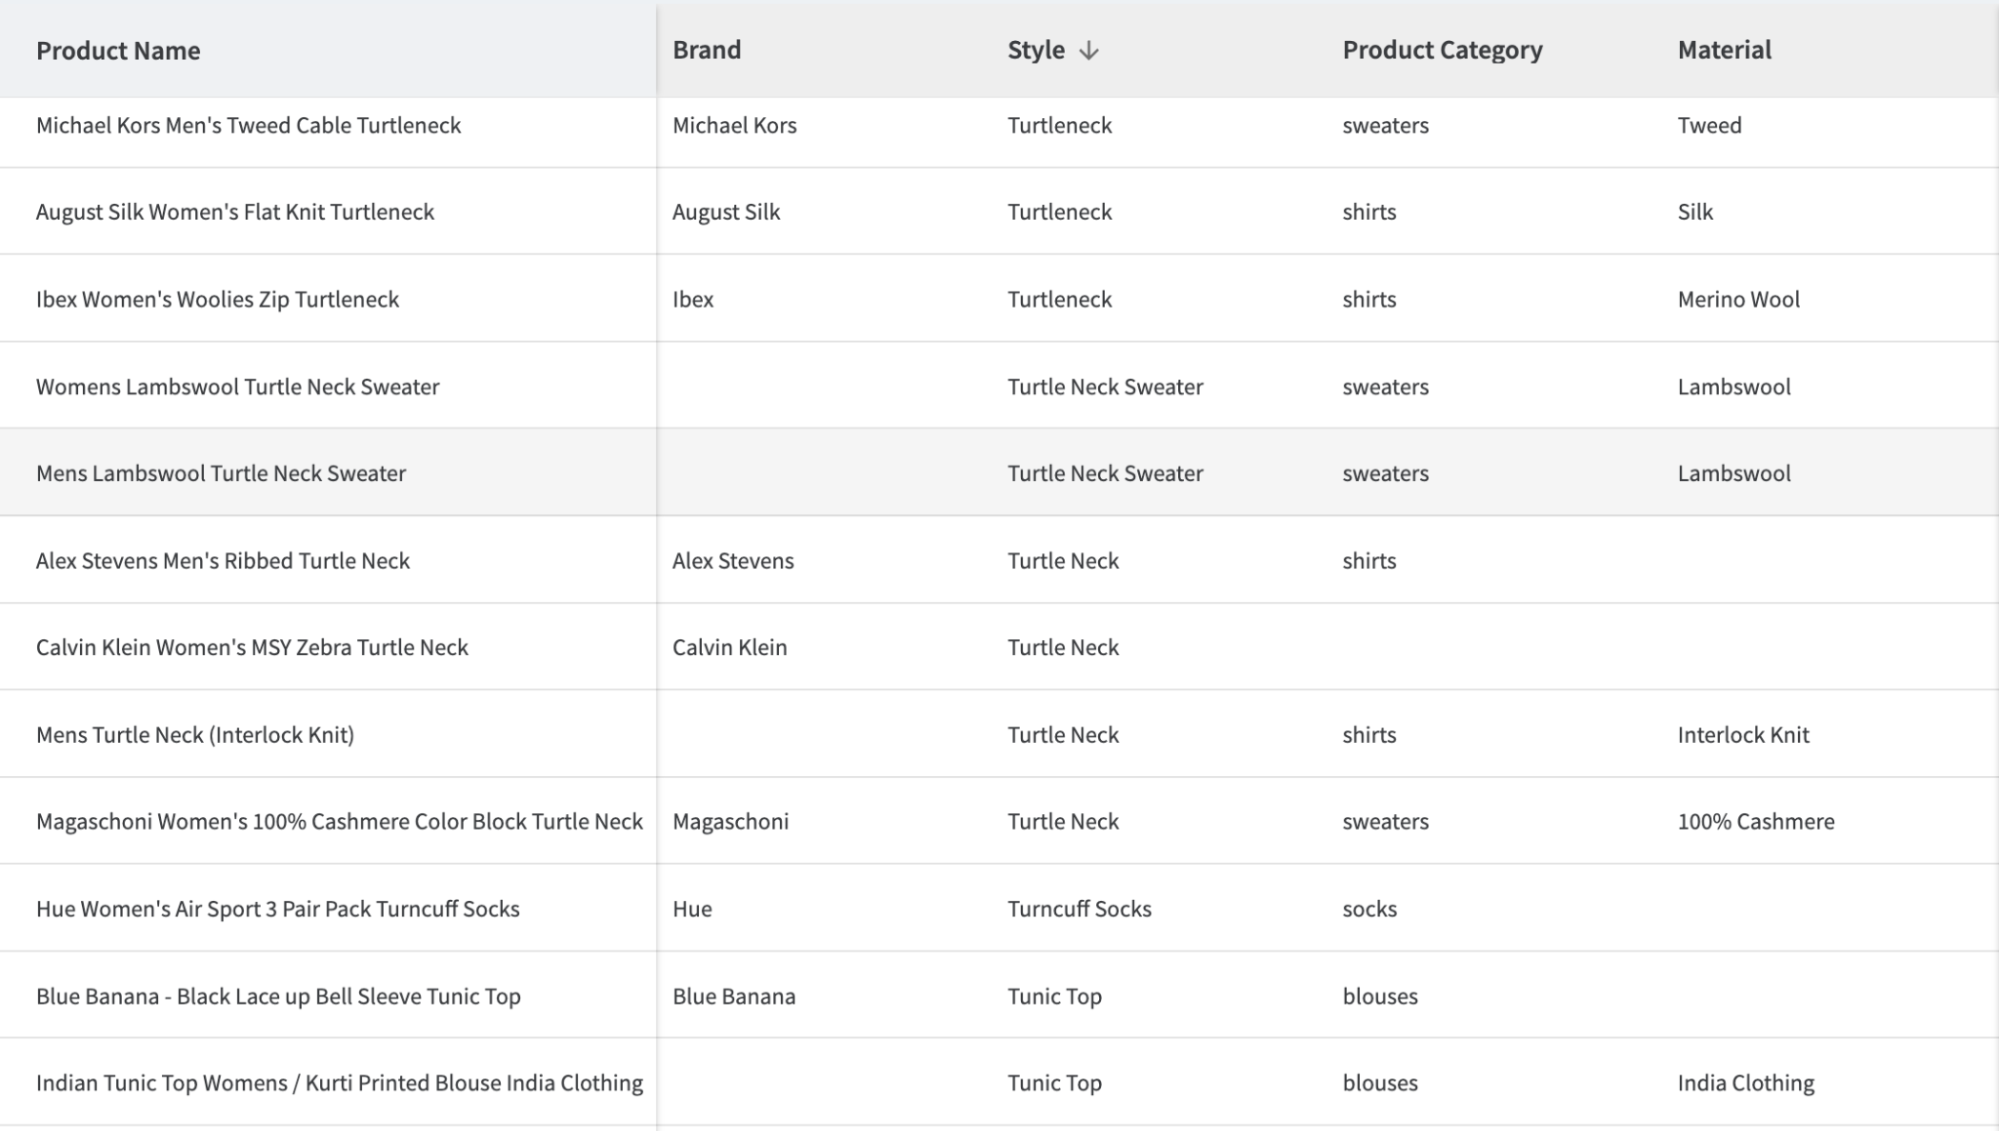
たった 1 つの入力属性から、使用できる構造化データが大幅に増加しました。
ユースケース 2: 柔軟な分類
重要な決定を行うために必要なデータは、ソースデータ内に直接存在していなくても、他の属性のコンテキストで推測できる場合があります。多くの場合、この情報はデータに精通したユーザーにとっては明白ですが、組織での幅広い賛同と大規模なデータ エンジニアリング プロジェクトがなければ、バックフィルは困難です。
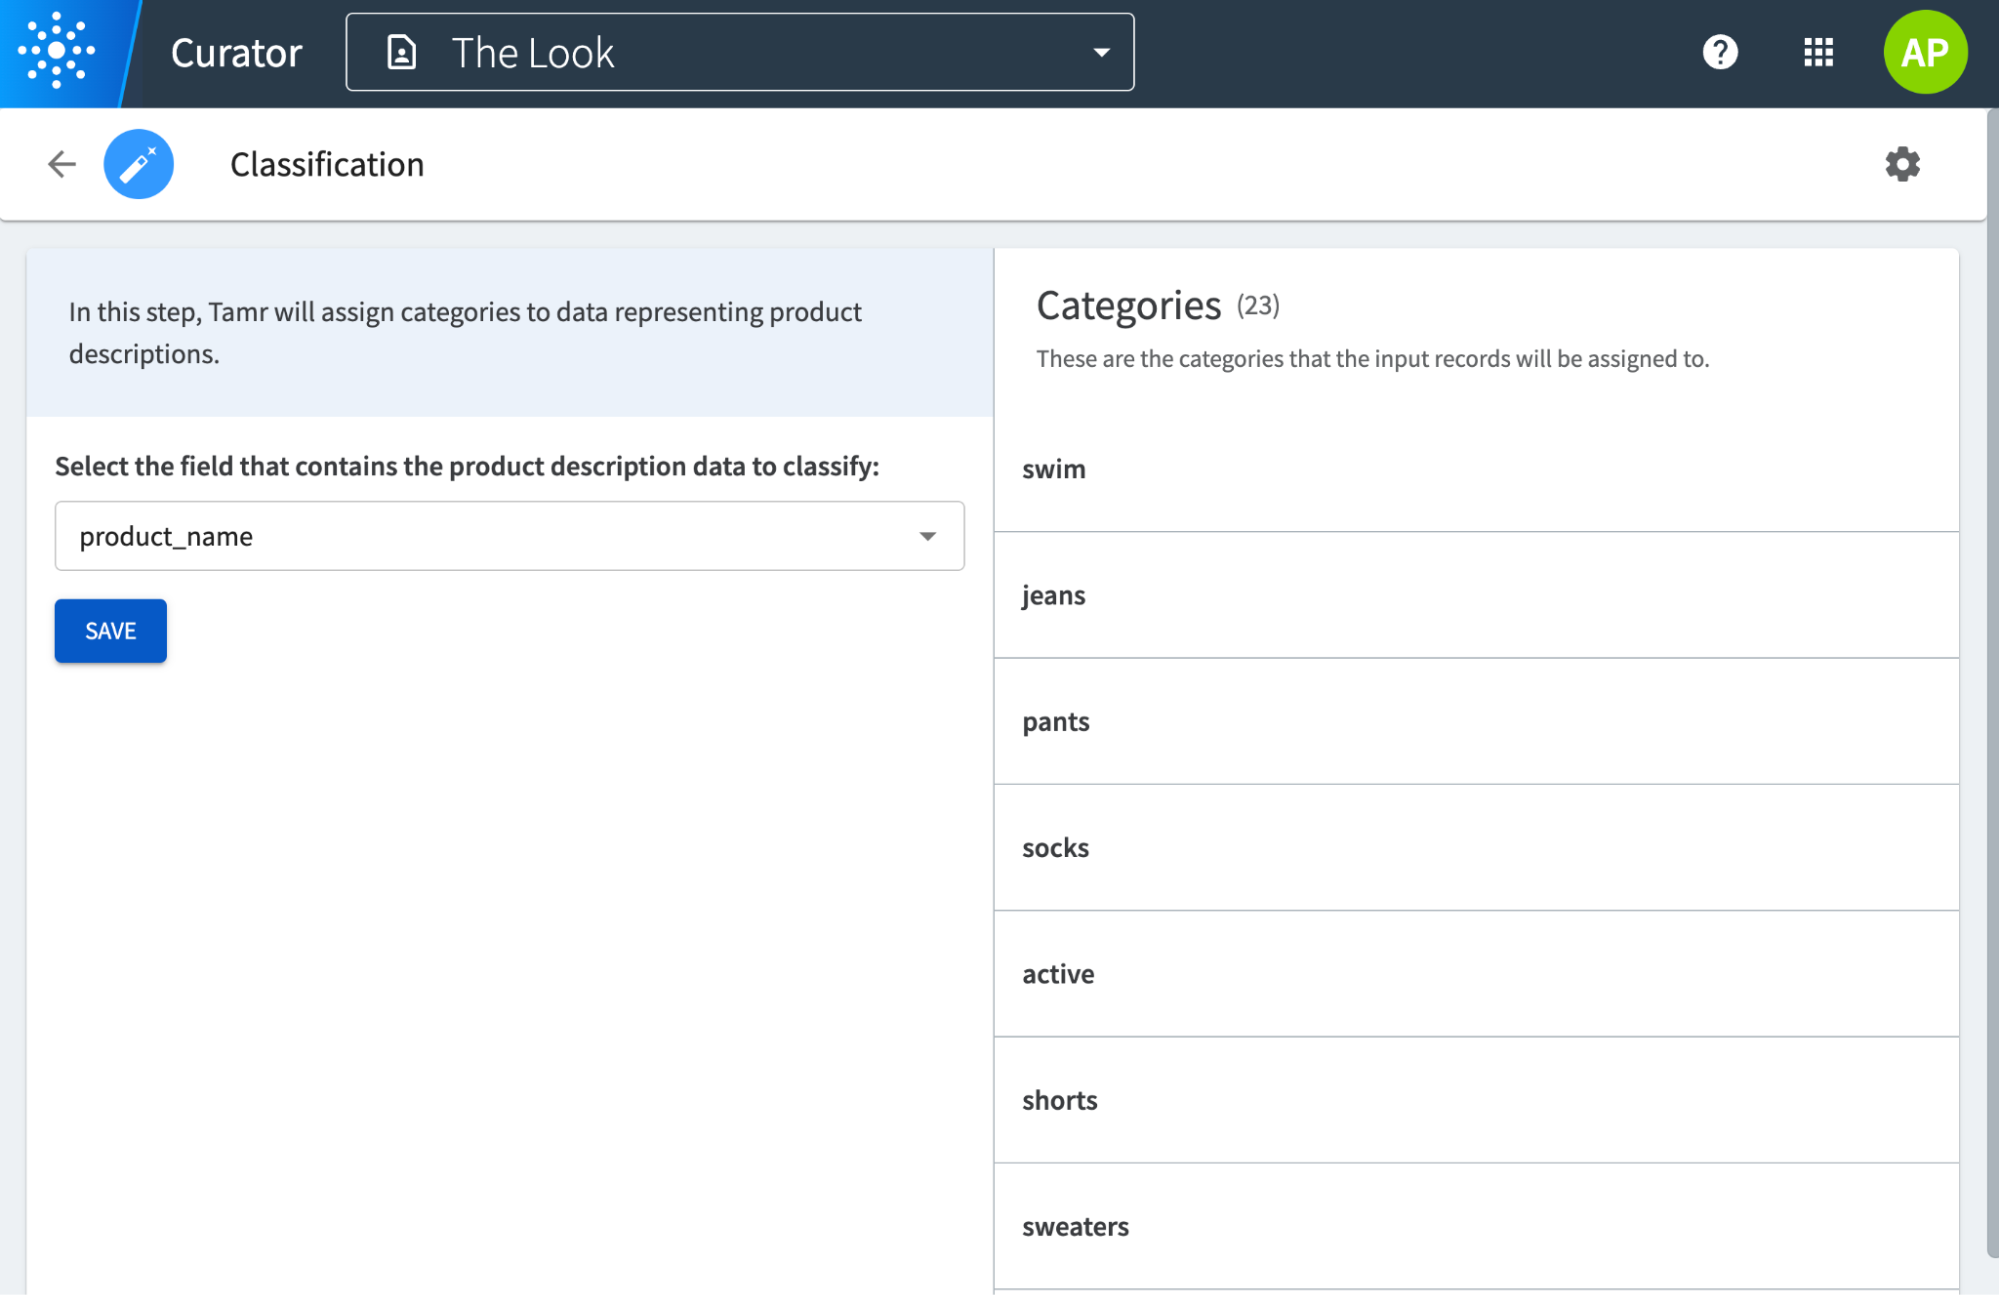
上の例に戻ると、theLook eCommerce のデータには商品カテゴリに関する情報が含まれていますが、ここでは目的に応じ、分析の要件に合わせて分類法を調整します。Tamr の Data Product を使用すると、特定のニーズに応じてすべての商品のラベルを手動で変更するのではなく、ユーザーが分類法を宣言するだけで、Data Product のパイプラインを実行してラベルを動的に更新できます。
このユースケースを可能にするため、Data Product では Gemini を活用してさまざまなドメインの分類タスクが実行されるようになりました。基盤モデルは、追加のトレーニングをまったく、またはほとんど行わずに、新しい分類タスクに効果的に適応できます。また、Gemini は高度な推論能力を必要とするタスクを解決できます。
事前にトレーニングされたベースモデルを使用しているため、商品をマッピングする分類法を定義すれば、あとは商品の説明情報が含まれるフィールドを構成するだけです。
Tamr の Data Product は、下流の分析のためにデータを分類法にマッピングするだけでなく、Google の基盤モデルを活用してデータに関する以下のような多くの問題を解決できます。
-
顧客レコードが個人を表すのか、企業を表すのかの特定。これは下流の要件によって大きく異なる可能性がある
-
無効な値やフィラー値(「NONE」、「null」、「00000000」など)を含むレコードへのフラグ付け
-
ヒューリスティックに基づく追加レビューのためのレコードへのフラグ付け(例: 同一人物を表す全レコードの生年月日が一致している必要がある)
Tamr は、Google 生成 AI を従来の ML 手法と組み合わせて使用することで、高い品質とシンプルなデプロイモデルを維持しながら、分類ユースケースのロングテールに適応しています。エンドユーザーは ML、特徴量エンジニアリング、MLOps ライフサイクルの専門家である必要はなく、Data Product パイプラインを実行して、下流で高品質の出力データを利用できます。
同様に、Google の生成 AI モデルと Tamr の Data Product テンプレートの機能の進歩に伴い、ライフ サイエンスやハイテク製造など、これまでは自動化に多額の研究開発投資が必要であった問題領域における複雑で詳細な分類タスクに取り組むことが可能になります。
ソリューション
Tamr Cloud は、Google Cloud にデプロイされる SaaS サービスです。そのため、(BigQuery、CloudSQL、Dataproc、BigTable での)データの保存と処理、ウェブサービスの実行には、すでに Google Cloud インフラストラクチャが幅広く使用されています。Tamr と Google 生成 AI のインテグレーションにより、Vertex AI のインフラストラクチャを使用してモデルの推論を大規模に実行できるようになりました。
Tamr の Data Product は、Data Product テンプレートのパイプラインの一部として Tamr によってオーケストレーションされる Gemini API を使用して、構造化テキストの抽出と分類を実行します。Data Product は、特定のユースケースに対してプロンプトを構築する方法や、モデルの結果を下流で使用するために処理する方法など、基盤モデルの使用方法に関する構成の詳細を抽象化します。これにより、ユーザーは運用データ パイプラインの一部として、結果の確認と使用に専念できるようになります。
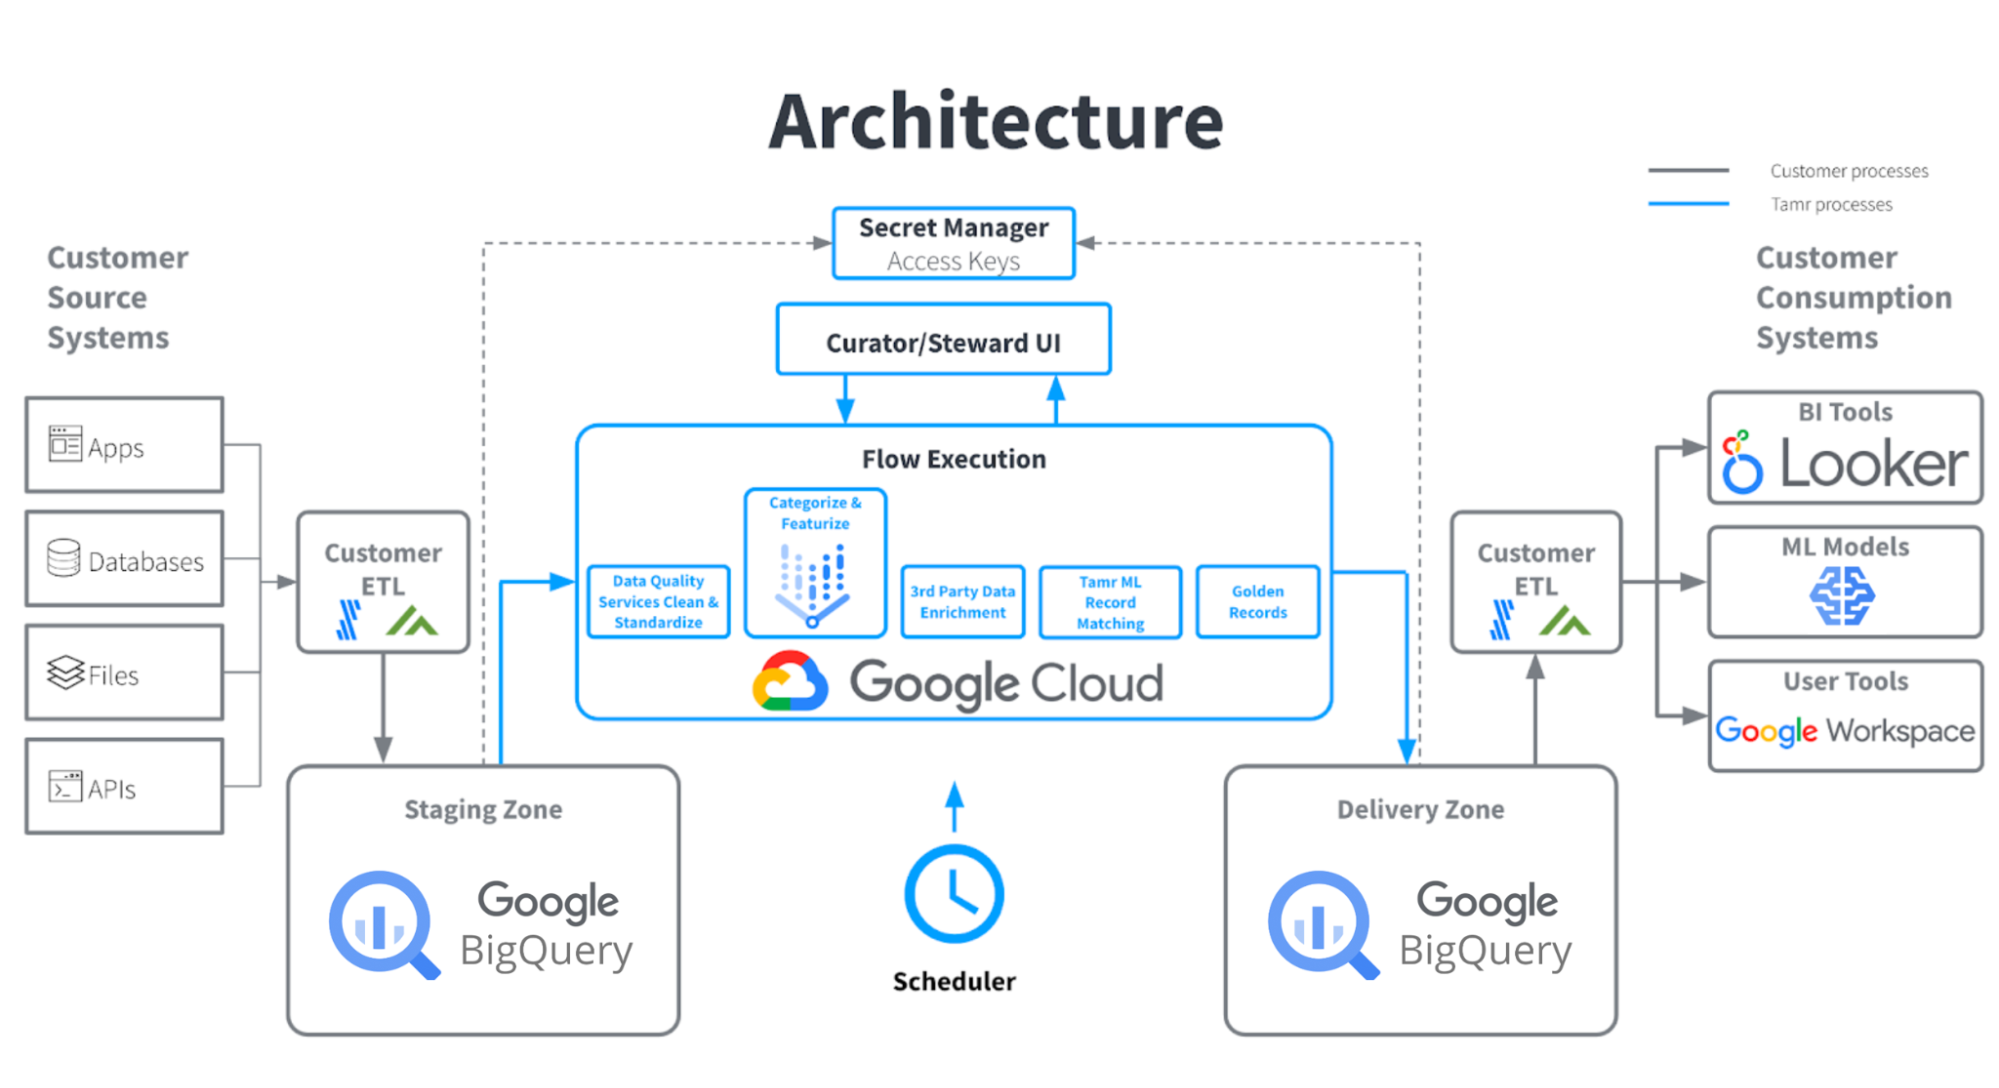
Data Product が実行されると、Tamr の Data Product テンプレートと拡張フレームワークで以下が処理されます。
-
Data Product の宣言的な構成からの適切なプロンプトの構築
-
Vertex AI を使用したモデルの推論 API へのリクエストの構築と実行
-
API リクエストのバッチ処理、キャッシュ保存、検証、(必要に応じた)再試行
-
結果が不変条件を考慮し、想定されるスキーマに準拠するようにするための API レスポンスの後処理
テキストの抽出と分類の手順によって生成された属性は、Data Product で Tamr の ML レコード マッチングを使用してエンティティをクラスタ化する機能として内部で使用することも、エンドユーザーが使用できるよう下流のシステムにエクスポートすることもできます。
考慮事項とトレードオフ
Google 生成 AI で提供されるような AI モデルの機能は間違いなく素晴らしいものですが、新しいテクノロジーを導入する際には、それが実際にどのように使用されるかを慎重に検討する必要があります。
たとえば、一部の分類ユースケースでは、特定のタスクに対して基盤モデルではなく、勾配ブースティング ツリーなどの従来の ML モデルを実行する方が計算上効率的である場合があります。ただし、長期的なモデルのトレーニングと変更は、高度な ML の知識を必要とする困難な運用タスクです。一方、Gemini のような基盤モデルは効果的な少数ショット学習が可能であり、多くの問題では少数の代表的なサンプルを提供するだけで高いパフォーマンスを達成できます。この場合、パイプラインを変更してフィードバックに適応させるコストが従来の手法よりも小さいため、データ パイプライン評価の実行時間の増加は許容できる可能性があります。
もう 1 つの重要な考慮事項は、エンドユーザーにどの程度きめ細かい制御を提供するかということです。基盤モデルでは自然言語で記述された指示を使用できるため、エンドユーザーが独自の変更によっていつでもプロンプトを直接強化できるはずだと考えるかもしれません。しかし、この段階で特定の問題領域に対して適切に機能するプロンプトを考案することは微妙で、ときには直感的に理解しにくいタスクになります。
Tamr の Data Product を使用すると、プロンプト エンジニアでないユーザーでも生成 AI の力を活用してデータ中心のフィードバックによって意図を宣言し、特定の問題領域やデータドメイン向けに Tamr で慎重に作成されたプロンプトを活用できます。
ML ベースのあらゆるソリューションと同様に、基盤モデルでも結果を検証するためにレビューとフィードバックが必要です。Tamr は ML に対して常に人間主導のアプローチを採用しており、基盤モデルも例外ではありません。場合によっては、ベースモデルではエンドユーザーの期待に応えられないことがあります。幸いなことに、Google は人間のフィードバックによる強化学習(RLHF)を利用してモデルの動作を調整する機能を提供しています。これにより、Tamr は Data Product のコンテキスト内で特定のタスクとデータドメインでのモデルのパフォーマンスを向上させることができます。
生成 AI のインテグレーションによるデータ マネジメントの改善
Google と Tamr のパートナーシップは、データ マネジメントとデータ分析を大きく前進させます。Tamr の Data Product と Gemini のような Google の最先端の生成 AI を組み合わせることで、企業はさまざまな種類のデータソースからのレコードを解釈するという課題を克服し、データを簡単に変換できるようになります。
すぐに使用できる Tamr の Data Product は、ML ベースのマスタリング モデル、データ クリーニング、標準化サービス、参照データセットを活用し、一切のコード構成が不要、もしくはほとんど必要ありません。このシンプルさはホストされた SaaS 環境によってさらに強化され、お客様にとっての使いやすさが高まります。
Google の生成 AI のインテグレーションによって、これまでにない機能が実現します。非構造化テキスト フィールドから構造化データを自動的に抽出できるため、ユーザーは柔軟な分類タスクを効率的に実行可能になります。ソースシステムからのセマンティック情報を活用することで、複雑な ETL パイプラインや広範な ML モデルを開発することなく、データを実世界のエンティティとして正確に解釈できます。
Google と Tamr は、データ マネジメントの簡素化、価値実現までの時間短縮、データに基づく分析情報の強化によって、より大きな価値を共同で提供します。企業は、データの品質と完全性を維持しながらデータの潜在能力を最大限に引き出し、データ処理の合理化とより的確な情報に基づく意思決定を行うことができます。
Google と Tamr のパートナーシップにより、データ マネジメントとデータ分析が新たなレベルに到達することで、データに大きく依存し、複雑化と競争の激化が進む環境における組織の成功が促されます。Google Cloud のオープンで革新的な生成 AI のパートナー エコシステムの詳細をご覧ください。Tamr のプロダクトの使用を開始するには、Partner Advantage リストをご確認ください。
-Google Cloud、AI / ML パートナー エンジニアリング担当ディレクター、Dr. Ali Arsanjani
-Tamr、共同設立者兼プリンシパル エンジニア Alex Pagan 氏