Dataflow ストリーミング パイプラインの自動スケーリングを微調整
Google Cloud Japan Team
※この投稿は米国時間 2023 年 9 月 14 日に、Google Cloud blog に投稿されたものの抄訳です。
ストリーム処理により、ユーザーは分析情報をタイムリーに受け取り、データの生成後すぐに対応できます。この処理は不正行為の検出、おすすめシステム、IoT などのアプリケーションに使用されています。しかし、入力負荷の変化に応じてライブ ストリーミングのパイプラインをスケールするのは複雑なタスクとなります。低レイテンシを保証し、費用を抑える必要がある場合は特にそうです。このため、Dataflow は数年間にわたり、ジョブに合わせてコンピューティング容量を自動調整できるよう、自動スケーリング機能の改善に重点的に取り組んできました。こうした機能には、次のものがあります。
- 水平自動スケーリング: Dataflow サービスがジョブに必要なワーカー インスタンス数を自動的に選択できるようにします。
- Streaming Engine: 着信データ量の変動に対応して、よりスムーズな水平自動スケーリングを提供します。
- 垂直自動スケーリング(Dataflow Prime の機能): 各ワーカーに割り当てられたコンピューティング容量を、使用率に応じて動的に調整します。
場合によっては、お客様が自動スケーリング アルゴリズムのパラメータのカスタマイズを希望されることがあります。具体的には、お客様が実行中のストリーミング ジョブのワーカーの最小数 / 最大数を更新されたい場合、一般に以下の 3 つのユースケースが見られます。
- レイテンシが急増するときの費用を削減する: レイテンシが急増すると、入力の負荷を処理するために過度のアップスケーリングが発生し、結果的に費用が増加する場合があります。この場合、お客様は費用を削減するために、ワーカー数の上限を下げたい可能性があります。
- トラフィックの増加が予想されるときのレイテンシを低く抑える: たとえば、あるストリームは 1 時間間隔でトラフィックが急増することがわかっているとします。オートスケーラーがこのような急増に対応するには数分かかることがあります。この場合、ユーザーは 1 時間ごとに事前にワーカー数を増やすことができます。
- トラフィックの離脱時にレイテンシを低く抑える: デフォルトの自動スケーリング アルゴリズムでは、バースト トラフィック中にワーカーの最適な数を選択するのが難しいことがあり、これがレイテンシの増加につながる場合があります。お客様は、この時間中に自動スケーリングが影響を受けにくいように、ワーカーの最小数 / 最大数の幅を狭めたい可能性があります。
ユーザーが調整する自動スケーリングに対する処理中ストリーミング ジョブ更新
Dataflow には、ジョブの更新により、長時間実行されるストリーミング ジョブの自動スケーリング パラメータを更新する方法がすでに存在します。しかし、この更新オペレーションではデータ処理が一時停止します。これは数分間に及ぶことがあり、レイテンシ保証が厳しいパイプラインには適していません。
そこで、このたびご紹介するのが処理中のジョブ オプション更新機能です。この機能を使用すると、Streaming Engine のユーザーがワーカーの最小数 / 最大数を実行時に調整できます。現在のワーカー数が新しい最小数 / 最大数の範囲内にある場合、この更新で処理の遅れは発生しません。それ以外の場合、短時間でパイプラインのスケールアップまたはスケールダウンが開始されます。
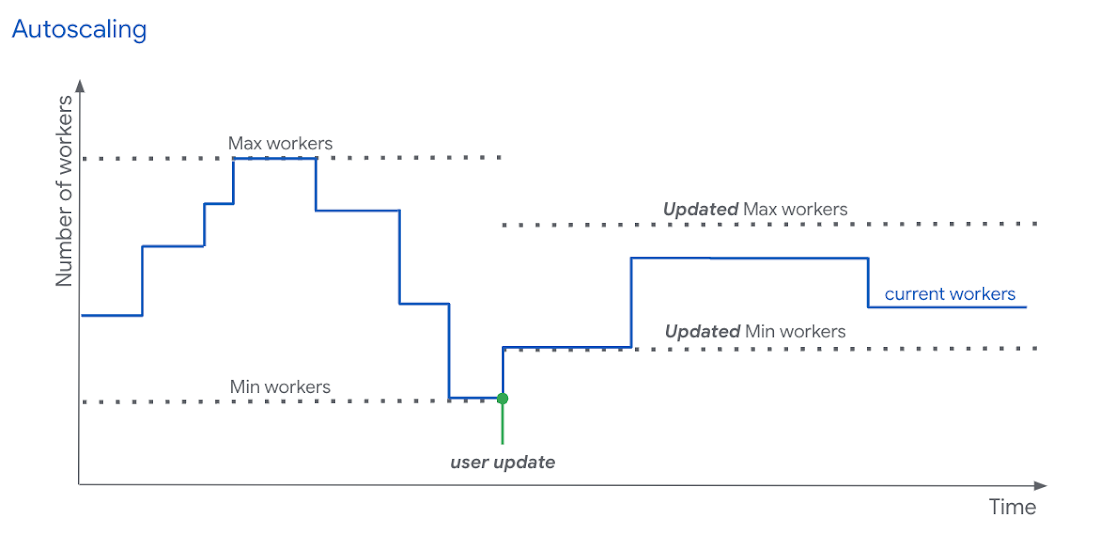
ユーザーは次の方法でこの機能を利用できます。
- Google Cloud コンソールのコマンド:
- Dataflow Update API
処理中のジョブの更新機能は、Streaming Engine を使用するパイプラインでのみ利用可能です。
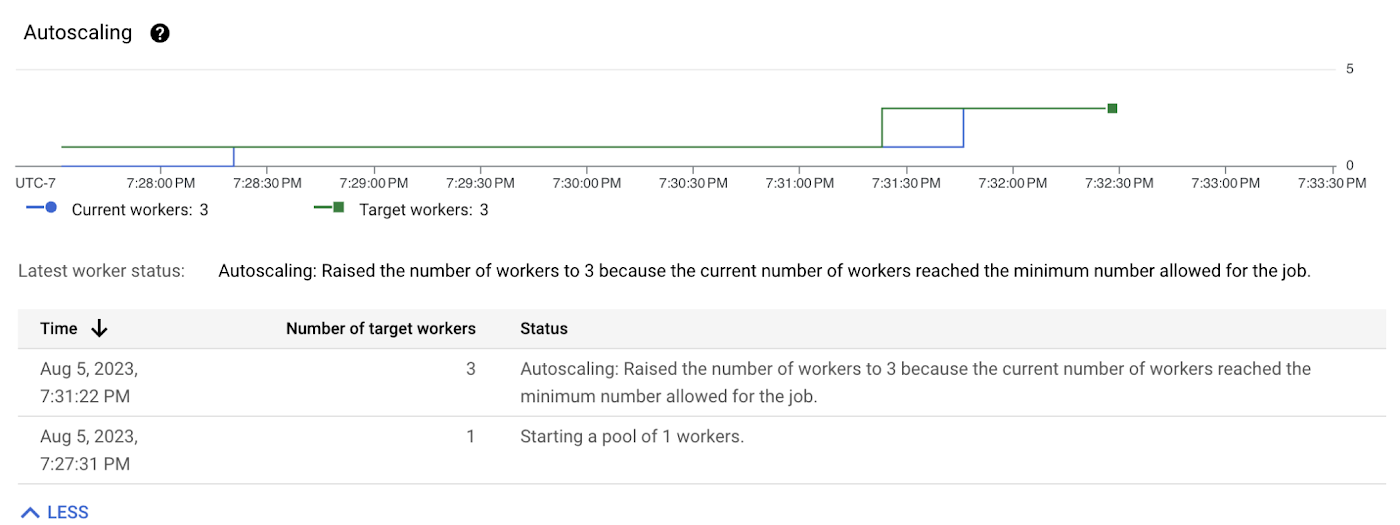
更新が適用されると、自動スケーリングのモニタリング UI でその効果を確認できます。
- ソリューション アーキテクト Sergei Lilichenko
- oogle Cloud、シニア プロダクト マネージャー Yuriy Zhovtobryukh
[ジョブ情報] パネルの [パイプライン オプション] セクションに、「minNumberOfWorkers」と「maxNumberOfWorkers」の新しい値が表示されます。
事例紹介: Yahoo による機能の活用例
Yahoo は、Google の Pub/Sub メッセージを処理するストリーミング パイプラインを頻繁に更新する必要があります。また、エンドツーエンドの処理 SLA が非常に厳しいため、パイプラインがドレインされ、置換されるまで待つ余裕がありません。一般的なプロセスに沿って操作した場合、SLA を守れなくなります。
そこで Google Cloud は、新しい処理中の更新オプションを使った別のアプローチを提案しました。現在のパイプラインのドレインが開始される前に、新たな API を使用して、ワーカーの最大数を現在のワーカー数に設定します。その後、置換パイプラインが起動します。このときのワーカーの最大数も、既存のパイプラインの現在のワーカー数と等しくなります。新しいパイプラインは既存のパイプラインと同じ Pub/Sub サブスクリプションで起動されます(注: 通常、複数のパイプラインに同じサブスクリプションを使用することは推奨されません。別個のパイプラインを対象とする重複除去がないため、重複が発生する可能性があるためです。この方法は、更新中の重複を許容できる場合にのみ有効です)。新しいパイプラインでメッセージの処理が開始されると、既存のパイプラインはドレインされます。最後に新しい本番環境パイプラインが更新され、ワーカーの適切な最小数 / 最大数が反映されます。
通常は、複数の Dataflow パイプラインを同じ Pub/Sub サブスクリプションで実行することはおすすめしません。パイプライン内の Pub/Sub メッセージ数は予測が難しく、パイプラインが過度にスケールアップする可能性があるためです。この新しい API を使用すると、置換中の自動スケーリングを無効にできます。この方法がこのお客様では功を奏し、レイテンシの SLA の維持に有効であることが示されました。
「Yahoo メールを Google Cloud Platform に移行し、Google のデータサービスと分析サービスの規模と能力を最大限に活用しています。数億個のメールボックスにわたるリアルタイムのストリーミング データ分析は、Yahoo にとって重要です。Google の Dataflow のシンプルさとパフォーマンスを活かしてこれを実現できました。」 - Yahoo、シニア バイス プレジデント兼最高情報責任者 Aaron Lake 氏
レイテンシのないパイプライン交換のオーケストレーションを行うサンプル スクリプトのソースコードと、簡単なテスト パイプラインをこちらの GitHub リポジトリでご確認いただけます。
次のステップ
低レイテンシの保証を守り、費用の要件を満たすためには、ライブ ストリーミング パイプラインの自動スケーリングが重要です。しかし、これを適切に行うのは難しい場合があります。このような場合に役立つのが Dataflow Streaming Engine です。
現在、Streaming Engine のすべてのユーザーに、多くの自動スケーリング機能が提供されています。処理中のジョブを更新することにより、ユーザーはそれぞれの要件に合わせて自動スケーリングを微調整する新たなツールを手に入れることになります。
今後の最新情報にもご注目ください。詳しくは、Google Cloud セールスチームにお問い合わせください。
- ソリューション アーキテクト Sergei Lilichenko
- Google Cloud、シニア プロダクト マネージャー Yuriy Zhovtobryukh