R とキャレットを使用して Vertex AI でハイパーパラメータを調整
Google Cloud Japan Team
※この投稿は米国時間 2022 年 12 月 20 日に、Google Cloud blog に投稿されたものの抄訳です。
十分に正確な機械学習モデルを作成するには、プロセスでパラメータとハイパーパラメータを調整する必要があります。モデルのパラメータは、損失を最小限に抑えるためのニューラル ネットワークの重みなど、選択された機械学習手法をデータに適応させるために使用される変数です。ハイパーパラメータは、トレーニング プロセス自体を制御する変数です。たとえば、多層パーセプトロンでは、隠れ層の数とサイズを変更すると、モデルのパフォーマンスに大きな影響を与える可能性があります。ディシジョン ツリーのノードごとの最大深度や最小観測値も同様です。
ハイパーパラメータの調整は、特に手動で行う場合や、網羅的なグリッド検索を使用してより大きなハイパーパラメータ領域を検索する場合に、コストのかかる作業になる可能性があります。
Google は 2017 年に Vizier を導入しました。これは、ブラックボックス最適化を実行するために Google が使用している手法です。Vizier は、Google 独自の機械学習モデルの多くを最適化するために使用されており、Google Cloud の機械学習プラットフォームである Vertex AI でも利用できます。Vertex AI のカスタム トレーニング用ハイパーパラメータ調整は、トレーニング ジョブに Vertex AI Vizier を使用する組み込み機能です。ML モデルに最適なハイパーパラメータ設定を決定します。
概要
このブログ投稿では、カスタム R モデルのハイパーパラメータを Vertex AI を使用して調整する方法について詳しく説明します。
一般的に、R ユーザーは RStudio からプログラムで Vertex AI を操作することを好み、reticulate パッケージを使用して、Vertex AI SDK を介して Vertex AI を操作します。
Vertex AI でカスタム R モデルを調整するプロセスは、次の手順で構成されます。
Google Cloud Platform(GCP)API を有効にして、ローカル環境を設定する
特定のハイパーパラメータを使用してモデルをトレーニングするカスタム R スクリプトを作成する
Cloud Build と Container Registry を使用した R モデルのトレーニングをサポートする Docker コンテナを作成する
Vertex AI Training のハイパーパラメータ調整ジョブを使用してモデルをトレーニングおよび調整する
データセット
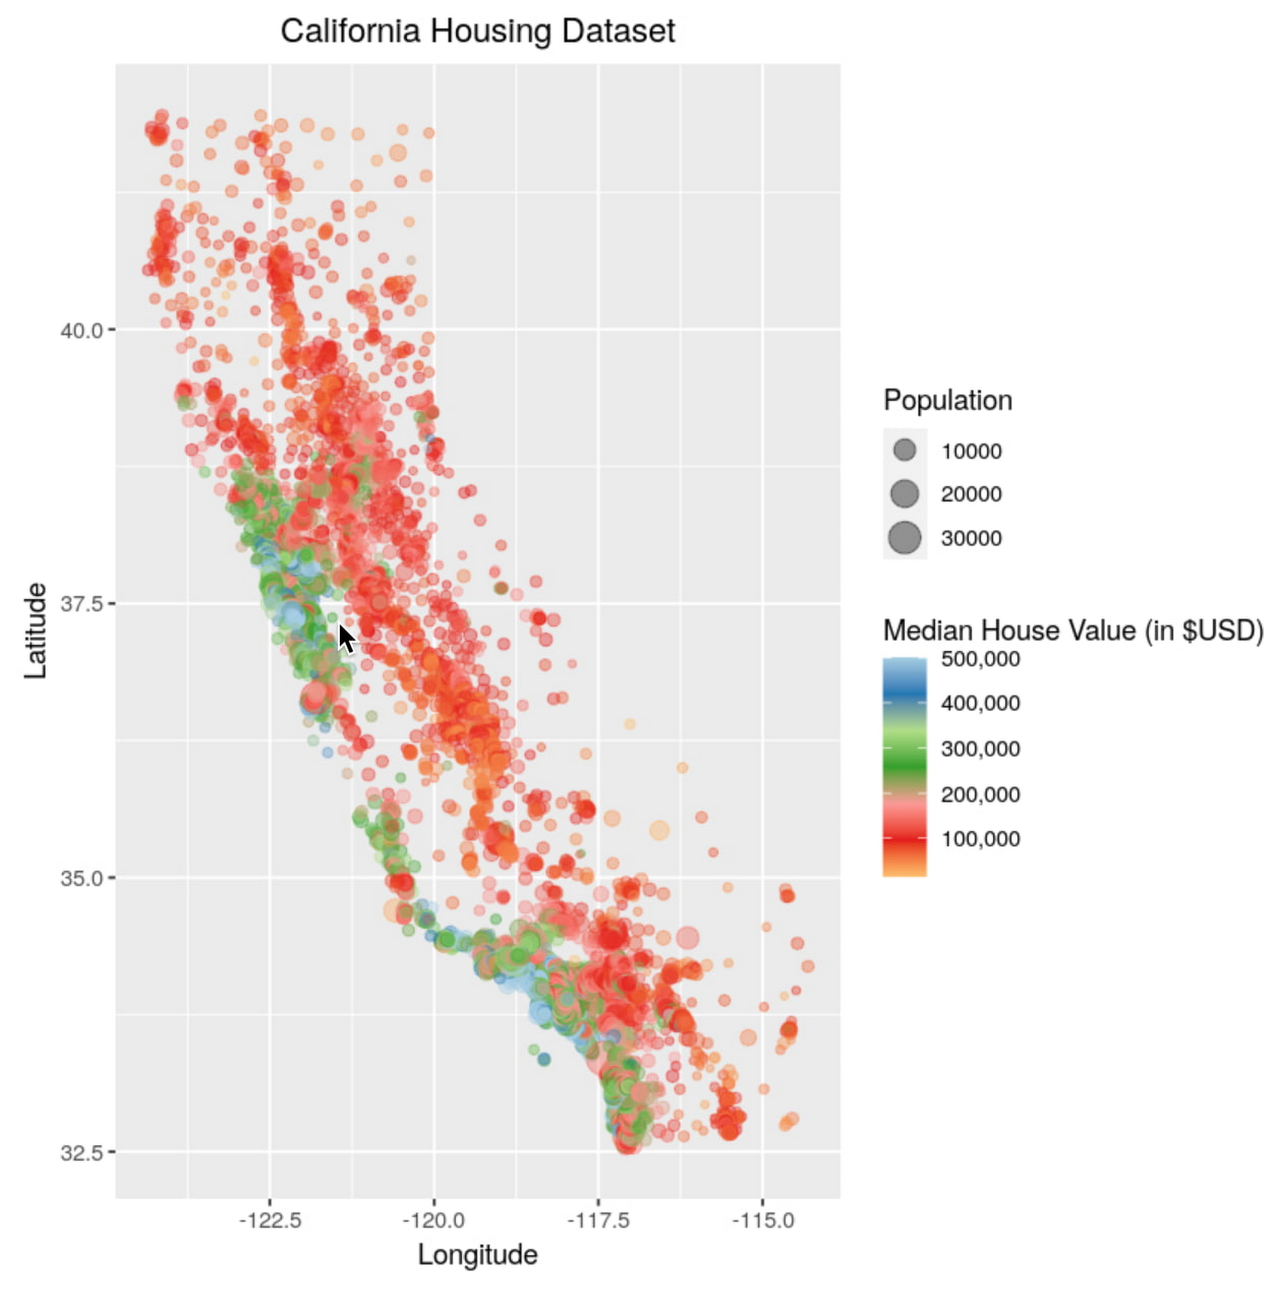
このプロセスの実例として、カリフォルニア州の住宅に関するデータセットを使用して住宅価格を予測する単純なブーストツリー モデルをトレーニングします。データには、1990 年のカリフォルニア州国勢調査の情報が含まれています。データセットは Google Cloud Storage で公表されています(gs://cloud-samples-data/ai-platform-unified/datasets/tabular/california-housing-tabular-regression.csv)。
このツリーモデルでは、特定の経度および緯度と、対応する国勢調査ブロック グループからのデータに基づいて、住宅価格の中央値を予測します。ブロック グループとは、米国の国勢調査局がサンプルデータを発表する最小の地理的単位です(通常、1 つのブロック グループには 600 人から 3,000 人の人口が含まれます)。
環境の設定
このブログ投稿では、Vertex AI Workbench と R カーネル、または RStudio を使用していることを前提としています。環境では、次の要件を満たしている必要があります。
Google Cloud SDK
Git
R
Python 3
Virtualenv
シェルコマンドを実行するために、ヘルパー関数を定義します。
また、いくつかの R パッケージをインストールして Vertex AI 向け SDK をアップデートします。
次に、トレーニングとデプロイのプロセスをサポートするために次の変数を定義します。
PROJECT_ID: Google Cloud Platform のプロジェクト IDREGION: 現時点で、Vertex AI でサポートされているリージョンは us-central1、europe-west4、asia-east1 です。最も近いリージョンを選択することをおすすめします。BUCKET_URI: データセットとモデルのリソースに関連付けられているすべてのデータが保存される、ステージング バケットDOCKER_REPO: コンテナ アーティファクトを保存する、Docker リポジトリ名IMAGE_NAME: コンテナ イメージの名前IMAGE_TAG: Vertex AI が使用するイメージタグIMAGE_URI: コンテナ イメージの完全な URI
Vertex AI SDK for Python を初期化する際に、Cloud Storage のステージング バケットを指定します。ステージング バケットは、データセットとモデルのリソースに関連付けられているすべてのデータが、セッションをまたいで保持される場所です。
最後に、Vertex AI SDK のインターフェースとして Python で作成された reticulate R パッケージをインポートして初期化します。
モデルのトレーニングおよび調整用のコンテナ イメージを作成する
カスタム コンテナのための Dockerfile は、Vertex AI Workbench で使用されるのと同じコンテナである Deep Learning Containers の上に構築されます。R スクリプトを追加するだけで、モデルのトレーニングおよび調整を行うことができます。
このコンテナを作成する前に、ご利用のリージョンで Artifact Registry を有効にして、リクエストを認証するように Docker を構成します。
次に、Dockerfile を作成します。
次に、R モデルのトレーニングに使用するファイル train.R を作成します。このスクリプトでは、カリフォルニア州の住宅に関するデータセットで gbm モデル(一般化されたブースト回帰モデル)をトレーニングします。Vertex AI は利用可能な環境変数を設定し、各トライアルのハイパーパラメータはコマンドライン引数として渡されます。その後、トレーニング済みモデルのアーティファクトは Cloud Storage バケットに保存されます。トレーニング スクリプトの結果は、/tmp/hypertune/output.metrics に JSON ファイルを保存する hypertune パッケージを使用して Vertex AI に返されます。Vertex AI は、この情報を使用して、次回のトライアルに使用するハイパーパラメータ構成を準備するとともに、どのトライアルが全体的な結果のうち最善のものをもたらしたかを評価します。
最後に、サーバレス CI / CD プラットフォームの Cloud Build で Docker コンテナ イメージを構築します。 Docker コンテナ イメージの構築には、10~15 分ほどかかります。
カスタム R モデルを調整する
トレーニング アプリケーションがコンテナ化されたら、調整ジョブのマシン仕様を定義します。この例では、n1-standard-4 インスタンスを使用します。この仕様は、次に CustomJob で使用されます。
ハイパーパラメータ調整ジョブで、ハイパーパラメータを最適化し、指標を最適化します。ハイパーパラメータ調整ジョブでは、異なるハイパーパラメータ セットを使用して、トレーニング アプリケーションのトライアルを複数回実行します。
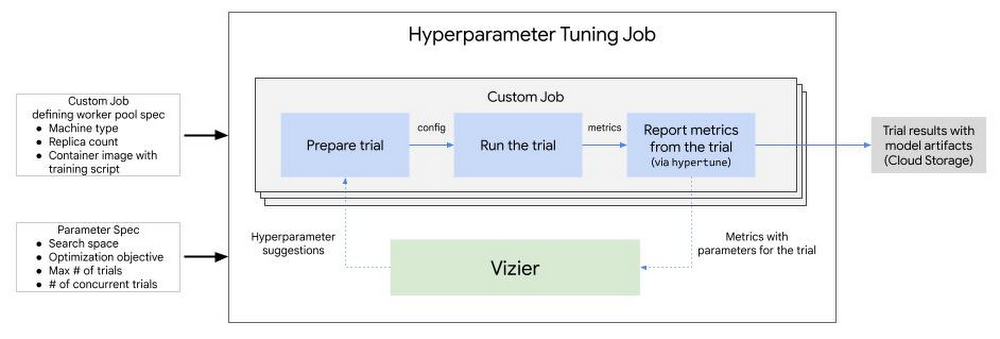
次の方法でジョブを制御できます。
max_trial_count: サービスに実行を許可するトライアルの数を決定します。トライアル数を増やすと一般には結果が向上しますが、常に向上するとは限りません。通常、返されるポイントが減った場合、追加のトライアルが精度に与える影響はほとんどありません。多数のトライアルでジョブを開始する前に、少数のトライアルから開始して、選択したハイパーパラメータがモデルの精度に与える効果を測定することをおすすめします。ハイパーパラメータ調整を最大限に活用するには、設定する最大値がハイパーパラメータの数の 10 倍を下回らないようにしてください。parallel_trial_count: 同時に実行できるトライアルの数を指定できます。トライアルの並列実行には、トレーニング ジョブの所要時間を短縮できるというメリットがあります(リアルタイムの時間という意味であり、所要処理時間の合計は特に変わりません)。ただし、並列で実行すると、調整ジョブ全体の効果が減じることがあります。なぜなら、ハイパーパラメータ調整は、前のトライアルの結果を使用して、後続のトライアルのハイパーパラメータに割り当てる値を通知するからです。並列実行の場合、まだ実行中のトライアルの結果を利用できないままに開始するトライアルもでてくることになります。
さらに、調整するハイパーパラメータを指定する必要もあります。調整するハイパーパラメータを選択する方法については、すべてのケースに当てはまるアドバイスというのはほとんどありません。使用している機械学習技術に経験があるデベロッパーならば、ハイパーパラメータの動作について把握している情報を選択に役立てることができます。機械学習コミュニティでアドバイスが見つかる可能性もあります。
どのように選択するにしても、その選択が内包する意味を理解しておくことが重要です。調整対象にどのハイパーパラメータを選択しても、調整ジョブが成功するまでに必要なトライアル数が増加する可能性があります。Vertex AI でハイパーパラメータ調整ジョブを実行する場合、課金額は、ハイパーパラメータ調整ジョブで開始したトライアルの継続期間に基づいて計算されます。調整するハイパーパラメータを慎重に選択することで、ハイパーパラメータ調整ジョブの時間と費用を抑えることができます。
Vertex AI は、ハイパーパラメータ調整ジョブ用のいくつかのデータ型をサポートしています。
モデルを調整するには、run() メソッドを呼び出します。
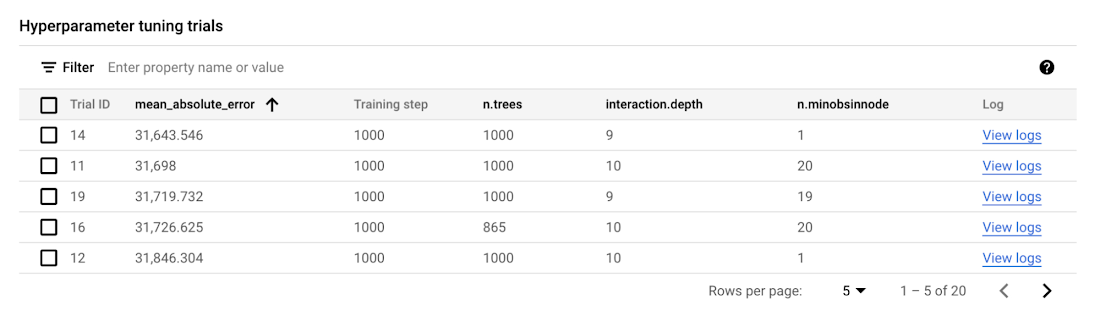
最後に、すべてのトライアルとそれぞれの結果を一覧表示するために、hpt_job$trials を調べることができます。
そして、誤差が最小のトライアルを見つけます。
この調整ジョブの結果は、Vertex AI コンソールからも調べることができます。
まとめ
このブログ投稿では、Vertex AI を使用してカスタム R モデルを調整するために必要な手順について学びました。もう一度行うには、GitHub にあるこの Notebook が役立ちます。こちらの記事に従って、Vertex AI Prediction の最適なトライアルから得られたモデルをデプロイできます。
- 機械学習スペシャリスト Fabian Hirschmann
- 機械学習ソリューション アーキテクト Rajesh Thallam