AlloyDB 및 Cloud SQL의 네이티브 BM25 순위 지정 발표
Darshana Sivakumar
Group Product Manager
Nisa Meshal
Customer Engineer
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
벡터 검색은 생성형 AI, 검색 증강 생성 (RAG), 데이터 에이전트 아키텍처의 중요한 구성요소이지만, 때로는 벡터 검색만으로는 충분하지 않습니다. 벡터 임베딩은 개념적 의미를 이해하는 데 탁월하지만 특정 영숫자 ID와 정확한 제품 SKU 번호에는 어려움을 겪습니다. 진정으로 강력한 검색 및 AI 애플리케이션을 빌드하려면 시맨틱 벡터 검색과 기존의 정확한 키워드 전체 텍스트 검색을 결합해야 할 수 있습니다. 이를 하이브리드 검색이라고 합니다.
검색에서 BM25(Best Matching 25)는 문서가 주어진 쿼리와 얼마나 관련이 있는지 추정하는 데 사용되는 핵심 알고리즘입니다. 지금까지 AlloyDB 또는 Cloud SQL에서 BM25 순위를 지정하려면 추가적인 전체 텍스트 검색 백엔드를 추가해야 했습니다. 이로 인해 데이터 사일로, 동기화 지연, 운영 복잡성이 발생했습니다. 오늘 Google Cloud는 Tiger Data에서 만든 오픈소스 pg_textsearch 확장 프로그램을 통해 AlloyDB 및 PostgreSQL용 Cloud SQL 17+에서 기본 BM25 색인을 미리보기로 제공하여 별도의 전체 텍스트 검색 백엔드를 유지관리하는 데 드는 부담을 완전히 없애드립니다.
이제 통합된 하이브리드 검색 백엔드를 사용하면 최첨단 전체 텍스트 검색을 위해 별도의 시스템을 프로비저닝, 관리하거나 비용을 지불할 필요가 없습니다. 이 모든 작업은 운영 데이터가 저장된 데이터베이스 내에서 직접 이루어지며 다음과 같은 이점을 제공합니다.
-
업계 표준 키워드 순위: Tiger Data의
pg_textsearch를 기반으로 C에 최적화된 BM25 점수를 Postgres 테이블에 바로 제공합니다. -
복잡성 해소, 완전한 일관성: 벡터 및 전체 텍스트 검색을 위해 여러 백엔드를 유지보수할 때 발생하는 데이터 중복, ETL 파이프라인, 동기화 지연을 제거합니다.
-
강화된 시맨틱 검색(AlloyDB 전용): ScaNN 및 HNSW 색인 유형을 사용하여 표준 PostgreSQL에 비해 최대 6배 및 10배 더 빠른 벡터 검색 쿼리를 얻을 수 있습니다.
pg_textsearch를 사용해야 하는 이유
의미 있는 규모로 전체 텍스트 검색을 위해 PostgreSQL의 기본 제공 ts_rank 를 사용해 본 적이 있다면 이미 그 한계를 알고 있을 것입니다. 코퍼스가 커질수록 순위 품질이 저하됩니다. 역문서 빈도에 대한 지원이 없으므로 일반적인 단어와 드문 단어의 가중치가 동일합니다. 용어 빈도 포화가 없으므로 '데이터베이스'를 50번 언급하는 문서가 한 번 언급하는 문서보다 순위가 높습니다.
BM25는 정보 검색의 표준으로, 역문서 빈도 (더 희귀한 용어가 더 중요함), 용어 빈도 포화 (반복이 지배하지 않음), 문서 길이 정규화를 제공합니다. Tiger Data가 PostgreSQL 페이지에서 BM25 검색 엔진을 빌드한 방법에 대한 자세한 내용은 이 블로그 게시물을 참고하세요.
전체 텍스트 검색 예시
AlloyDB와 Cloud SQL에서 BM25 전체 텍스트 검색을 시작하는 방법은 다음과 같습니다. 고유 식별자 uniq_id, product_name 열, 각 제품의 텍스트 설명을 포함하는 product_description 열, 생성된 product_embedding 열을 포함하는 샘플 테이블 cymbal_products를 고려해 보겠습니다. cymbal_products 에는 실내 및 실외 식물을 포함한 다양한 소매 제품에 대한 정보가 포함되어 있습니다.
색인 생성
BM25를 사용하려면 pg_textsearch 확장 프로그램을 사용 설정합니다.
cymbal_products 테이블의 product_description열에 색인을 만듭니다.
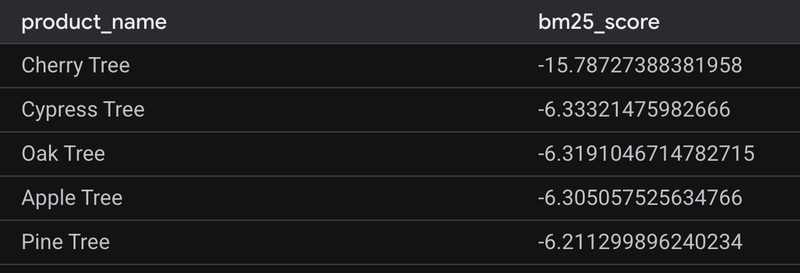
<@> 특수 연산자를 사용하여 BM25 전체 텍스트 검색 쿼리를 실행할 수 있습니다. 아래 스니펫에서는 'cherry tree'를 검색합니다.
샘플 출력은 아래와 같습니다. 점수가 더 음수일수록 관련성이 더 높습니다.
AlloyDB 하이브리드 검색 예시
AlloyDB에서 하이브리드 검색 시스템을 설정하는 것은 간단합니다. 동일한 테이블에서 벡터 색인과 키워드 색인을 모두 생성하고 하이브리드 검색 사용자 정의 함수 (UDF)를 사용하여 결과를 원활하게 병합할 수 있습니다.
벡터 색인 생성
ScaNN 벡터 검색 색인을 만드는 방법은 다음과 같습니다.
하이브리드 검색
AlloyDB는 하이브리드 검색 쿼리를 매우 간단하게 실행할 수 있는 기본 제공 하이브리드 검색 UDF를 제공합니다. UDF는 RRF (Reciprocal Rank Fusion) 알고리즘을 사용하여 각 검색 구성요소의 순위가 지정된 결과를 단일 통합 목록으로 병합합니다. 이 쿼리는 UDF를 활용하여 제품 설명에서 '집보다 키가 큰 나무'에 대한 벡터 검색과 '캘리포니아'에 대한 키워드 검색을 수행합니다.
아래 샘플 출력에서 볼 수 있듯이 결과는 RRF 점수의 내림차순으로 순위가 매겨집니다.
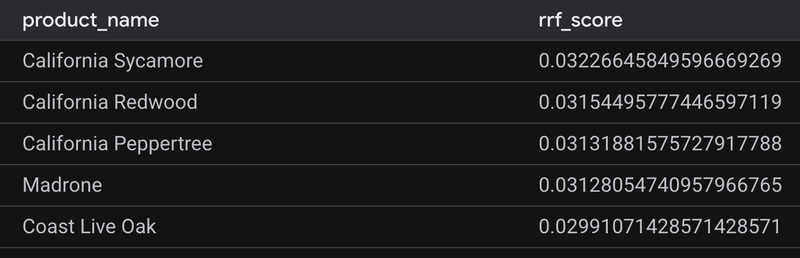
여기서 하이브리드 검색은 시맨틱 직관과 정확한 키워드 매칭 사이의 간극을 메웁니다. 벡터 임베딩은 '집보다 큰 나무'와 같은 개념적 쿼리를 파악하는 데 탁월하지만, 기존의 전체 텍스트 검색은 '캘리포니아'와 같은 엄격한 식별자에 필요한 정확한 정밀도를 제공합니다. AlloyDB는 이 두 가지를 융합하여 애플리케이션이 '캘리포니아 시카모어'와 같이 지역과 관련성이 높은 매우 구체적인 결과를 목록의 맨 위에 표시하도록 보장합니다.
Cloud SQL 하이브리드 검색 예시
Cloud SQL에서는 아래와 같이 동일한 테이블에 벡터 색인과 키워드 색인을 모두 만들고 공통 테이블 표현식 (CTE)을 사용하여 결과를 원활하게 병합하고 RRF 점수를 병합할 수 있습니다.
벡터 색인 생성
Cloud SQL에서 HNSW 색인을 만드는 방법은 다음과 같습니다.
하이브리드 검색
하이브리드 검색 쿼리는 다음과 같습니다.
결과 출력은 위에 표시된 AlloyDB 하이브리드 검색 결과와 동일합니다.
실제 사례 확인
데모 동영상에서 이 모든 것이 어떻게 결합되는지 확인해 보세요.
관련 리소스
Tiger Data와의 협업을 통해 고객이 기본 BM25 지원을 활용하여 더 빠르고 스마트하며 간단한 AI 애플리케이션을 빌드할 수 있게 되어 매우 기쁩니다. 지금 바로 pg_textsearch 확장 프로그램을 사용 설정하고 AlloyDB 및 Cloud SQL로 최고의 하이브리드 검색 엔진 환경을 경험해 보세요.
시작할 준비가 되셨나요? 확인해 보세요”
-
AlloyDB 리소스
-
AlloyDB 사용이 처음이신가요? 30일 무료 체험판 으로 AlloyDB를 살펴보세요.
-
Cloud SQL 리소스