Memorystore for Valkey 9.1로 마이크로초 단위의 지연 시간에 3배의 QPS 실현
Ankit Sud
Senior Product Manager, Google
Jacob Murphy
Software Engineer, Google
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
Google Cloud는 오픈소스 소프트웨어를 기반으로 최고의 관리형 환경을 제공하기 위해 노력하고 있습니다. 오늘 Google Cloud는 Memorystore for Redis Cluster와 비교하여 마이크로초 단위의 지연 시간에 최대 3배의 초당 쿼리 수(QPS)를 구현하는 Memorystore for Valkey 9.1의 정식 버전을 발표합니다.
Redis Inc.가 허용적인 오픈소스 BSD 라이선스에서 이중 라이선스 모델로 라이선스를 전환했던 2024년부터 Google Cloud의 Valkey 지원이 시작되었습니다. Google Cloud는 이러한 전환에 대응하여 다른 기술 리더들과 함께 Linux Foundation에서 관리하는 오픈소스 대안인 Valkey 개발을 지원하게 되었습니다.
Valkey는 그 이후로 놀라운 발전을 거듭하며 주요 성능 및 기능 업데이트를 통해 원래 포크를 훨씬 뛰어넘어 한계를 확장했습니다. Valkey는 수백만 명의 동시 사용자를 처리하기 위해 AI와 마이크로서비스를 확장하는 조직에 특히 매력적입니다. 이러한 상황에서 백엔드 개발자와 설계자는 대규모 처리량을 제공하는 동시에 마이크로초 단위의 지연 시간을 유지해야 합니다.
이 블로그에서는 Valkey 9.1이 성능을 구현하는 방법, 새로운 개발자 기능, 시작하는 방법, 고객이 사용하는 방법을 살펴보겠습니다.
자세히 살펴보기: 스레드 통신 재고
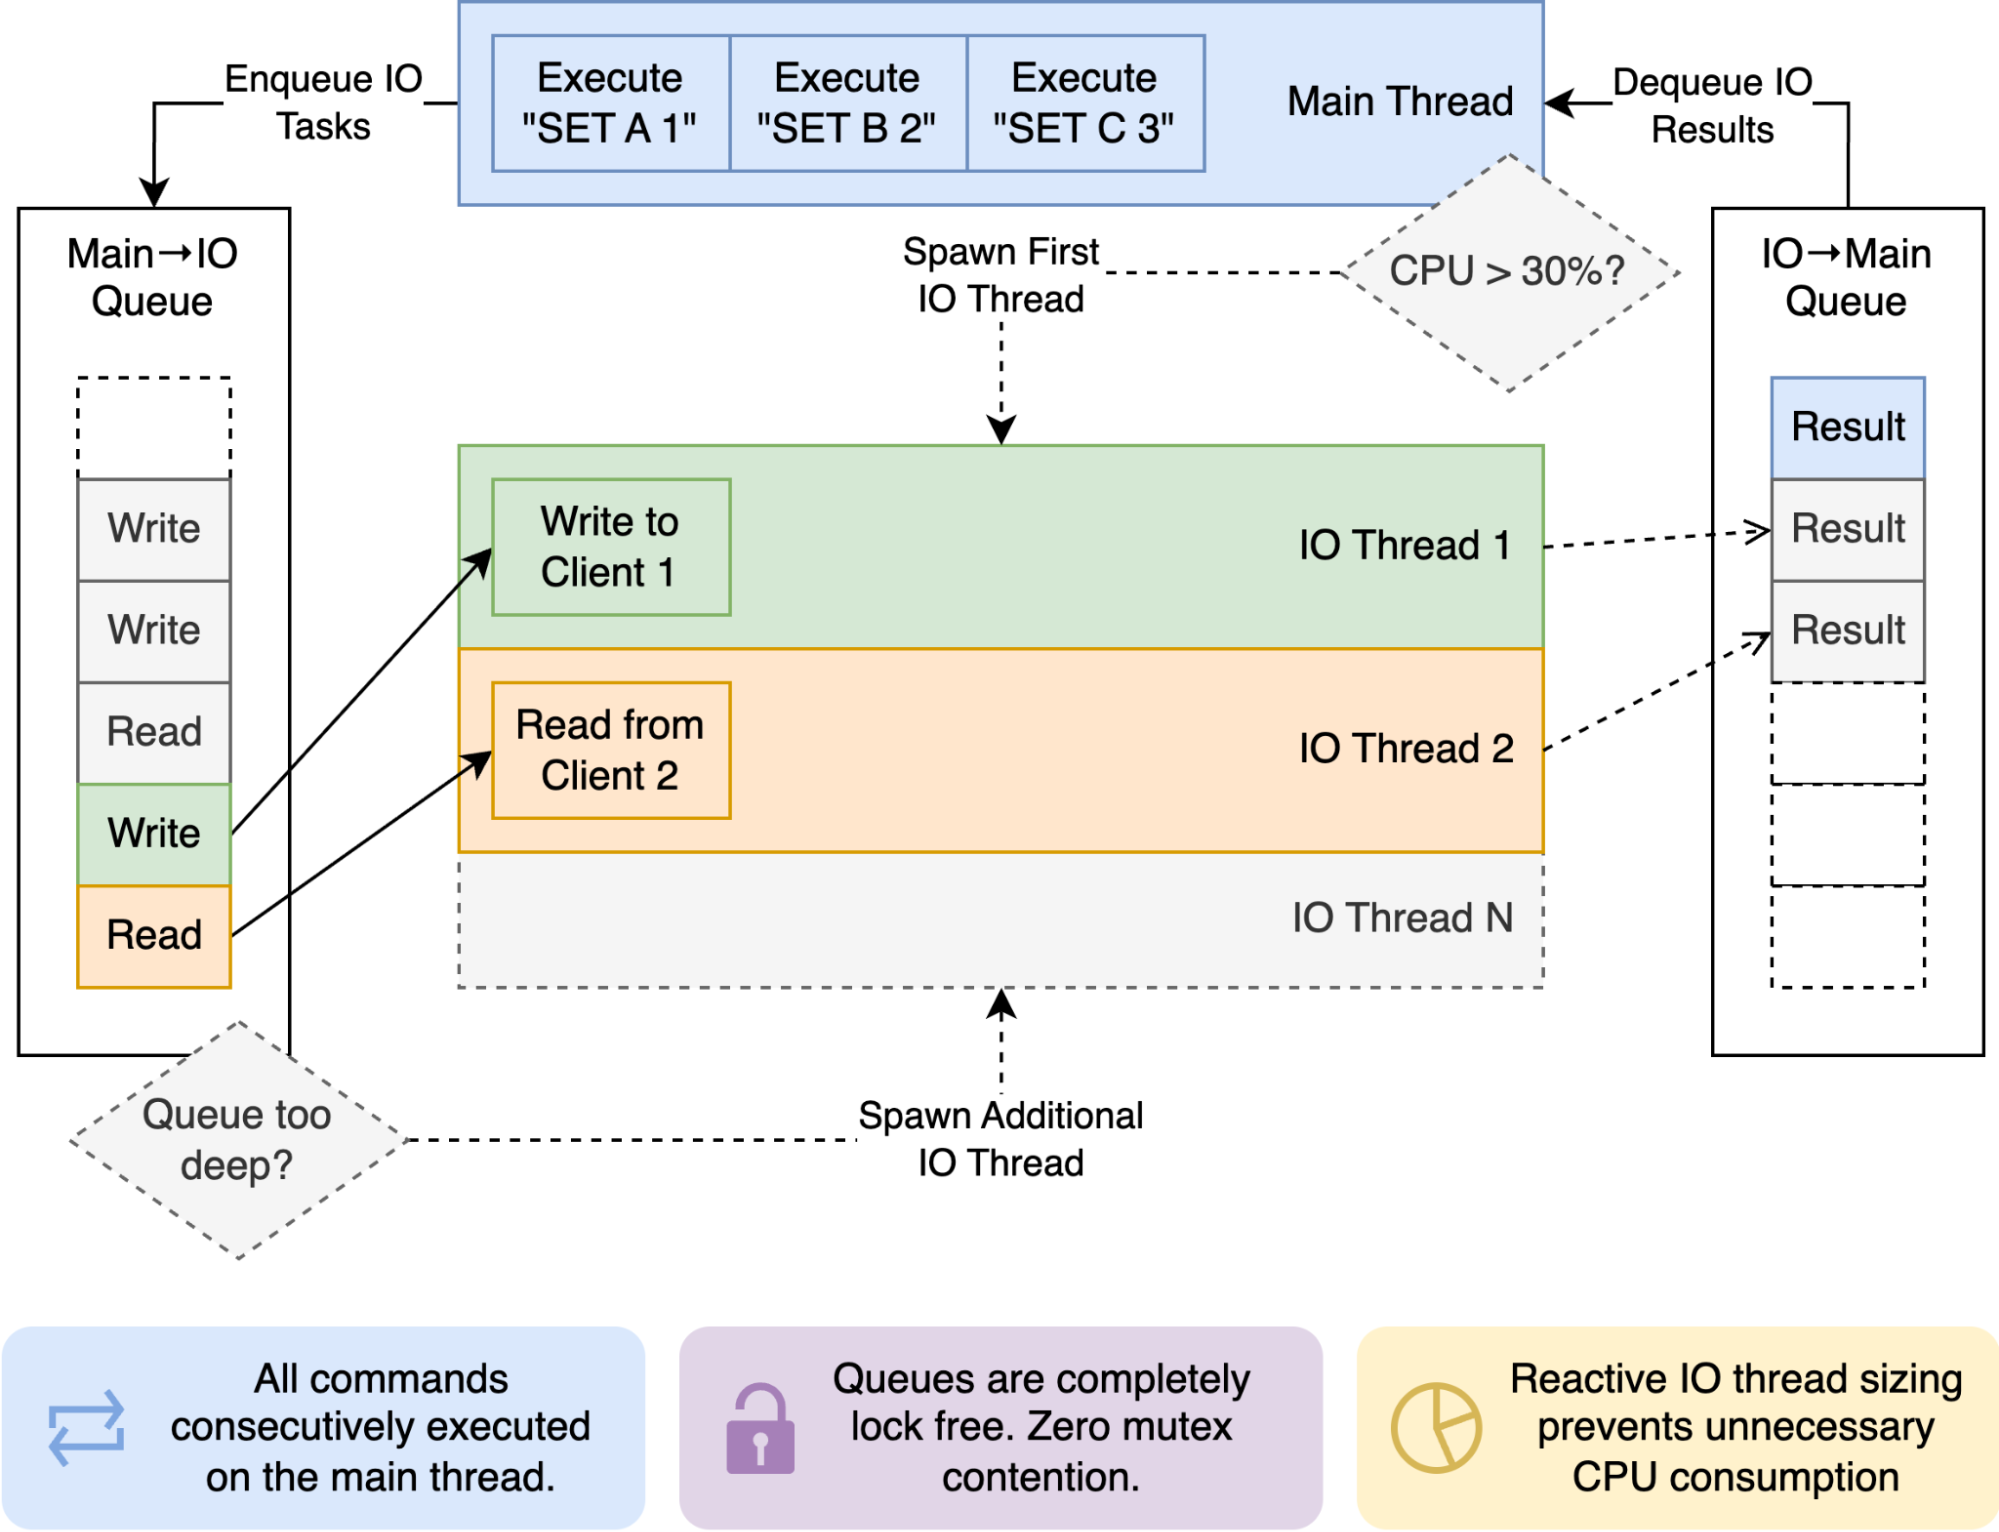
처리량이 높은 인메모리 데이터 스토어에서 기본 실행 루프가 차단되지 않도록 하려면 효율적인 I/O 오프로드가 중요합니다. 이전에는 Valkey가 클라이언트 소켓을 라운드 로빈 방식으로 I/O 스레드에 정적으로 할당했기 때문에 기본 스레드가 대기 중인 클라이언트 목록을 지속적으로 폴링하여 완료된 작업을 감지해야 했습니다.
Valkey 9.1은 목록 폴링을 잠금 없는 멀티 큐 메시징 아키텍처로 대체하여 스레드 간 CPU 낭비를 없애고 동적 작업 분산을 지원합니다. 이 아키텍처는 보완적인 다음 세 가지 큐로 구성되어 있습니다.
-
기본 스레드에서 I/O 스레드 큐: 읽기 및 쓰기 작업을 단일 생산자 다중 소비자(SPMC) 큐로 전달합니다. 여유 있는 작업자 스레드가 필요에 따라 태스크를 가져오므로 동적 작업 가로채기가 가능하여 스레드 부족이나 핫스팟 문제를 방지합니다.
-
I/O 스레드에서 기본 스레드 큐: 작업자 스레드가 완료된 태스크를 다중 생산자 단일 소비자(MPSC) 큐로 내보냅니다. 기본 스레드는 완료된 작업을 즉시 팝하여 바쁜 대기 목록 반복을 제거합니다.
-
I/O 스레드별 큐: 전용 단일 생산자 단일 소비자(SPSC) 큐는 스레드 선호 메모리 정리와 대용량 epoll 오프로드를 처리합니다.
또한 Valkey 9.1은 정적 스레드 기준점을 2단계 동적 확장 엔진으로 대체합니다.
-
CPU 기반 '가동': 기본 스레드 CPU 사용량이 30%를 넘으면 엔진이 자동으로 첫 번째 백그라운드 I/O 스레드를 활성화하여 큐 병목 현상이 발생하기 전에 수신 트래픽을 흡수합니다.
-
큐 깊이 자동 확장: 가동된 후에는 Valkey가 실시간 SPMC 큐 백로그를 기반으로 활성 I/O 작업자 스레드 수를 동적으로 확장하거나 축소하여 추가 코어가 필요할 때만 사용되고 유휴 상태일 때는 파킹되도록 합니다.
Valkey 9.1의 새로운 개발자 기능
Valkey 9.1은 원시 성능을 넘어 강력한 새 명령어와 향상된 보안 제어를 통해 엔지니어링팀의 주요 기능 요청을 해결합니다. 이러한 새로운 기능으로 할 수 있는 작업은 다음과 같습니다.
1. 세분화된 데이터베이스 수준 액세스 제어(ACL)
Google Cloud는 최근 Memorystore for Valkey에 대한 액세스 제어 목록(ACL) 지원을 시작했으며 IAM을 사용해 더 세분화된 키 수준 및 명령어 수준 승인을 제공합니다. 이 기본 보안 메커니즘은 추가 비용 없이 제공되며 다음과 같은 기능이 포함되어 있습니다.
-
중앙 집중식 관리: 1:N 매핑 방식을 사용하면 단일 ACL 정책을 정의하고 여러 클러스터에 연결할 수 있습니다.
-
안전한 멀티 테넌시: 조직은 데이터베이스 Fleet 전반에서 최소 권한과 안전한 멀티 테넌시를 쉽게 적용할 수 있습니다.
-
향상된 모니터링 가능성: 이 기능에는 버전이 지정된 정책 버전과 포괄적인 감사 로깅이 포함됩니다.
이전에는 ACL 규칙이 인스턴스 전체에 전역적으로 적용되었습니다. Valkey 9.1을 사용하면 관리자가 ACL 프레임워크 내에서 특정 숫자 데이터베이스 수준에서 사용자 액세스를 제한할 수 있습니다.
실제 사례: 스테이징 또는 서비스별 사용자를 구성하고 비프로덕션 데이터베이스에 대한 액세스를 엄격하게 격리할 수 있습니다.
-
production사용자:@all ~* db=0 -
staging사용자:@all ~* db=1 -
dev사용자:@all ~* db=2
키에 접두사를 지정할 필요 없이 여러 데이터베이스에서 데이터베이스 수준 액세스 제어를 활용하여 무단 데이터 액세스 및 애플리케이션 버그를 방지합니다.

2. CLUSTERSCAN: 효율적인 클러스터 전체 키 스캔
이전에는 대규모 클러스터에서 키를 스캔하려면 노드를 개별적으로 쿼리해야 했습니다. 이 접근 방식은 클러스터 또는 장애 조치를 인식하지 못했습니다. 따라서 프로세스 중에 슬롯 마이그레이션 또는 노드 장애 조치가 발생하면 스캔에서 키를 놓치거나 중복을 반환하거나 실패할 수 있습니다.
CLUSTERSCAN 명령어는 토폴로지 인식 커서를 도입하여 이러한 제한사항을 해결합니다. 이 커서는 현재 슬롯, 로컬 해시 테이블의 지문, 로컬 커서를 인코딩합니다. 이 추가 인코딩 정보를 사용하면 클라이언트가 토폴로지 변경 및 리디렉션을 원활하게 처리하면서 전체 클러스터에서 키를 스캔할 수 있습니다.
CLUSTERSCAN은 다음 두 가지 기본 스캔 전략을 지원합니다.
사용 사례 1: 순차적 전체 클러스터 스캔(단일 작업자)
이 전략은 속도보다 단순성을 우선시하는 간단한 스크립트나 백그라운드 작업에 적합합니다. 클라이언트는 커서 0에서 시작하여 클러스터의 모든 슬롯을 순차적으로 순회합니다.
스캔을 계속하려면 반환된 커서를 다음 호출에 전달합니다. 현재 슬롯이 완전히 스캔되면 커서가 자동으로 다음 슬롯으로 이동합니다.
명령어가 '0' 커서를 반환하면 스캔이 완료됩니다.
사용 사례 2: 병렬화된 클러스터 스캔(여러 작업자)
이 전략은 처리량이 높은 스캔에 적합합니다. SLOT 인수를 사용하면 스캔이 특정 슬롯으로 제한되므로 16,384개의 슬롯을 여러 병렬 작업자에 분할할 수 있습니다.
작업자 1(슬롯 0을 스캔):
작업자 2(슬롯 1000을 병렬로 스캔):
여기에서 작업자 1은 계속해서 SLOT 0을 전달하고 작업자 2는 계속해서 SLOT 1000을 전달합니다. 슬롯과 커서가 일치하지 않으면 오류가 반환됩니다. 16,384개의 슬롯이 모두 스캔되면 클러스터 스캔이 완료된 것으로 간주됩니다.

3. 원자성 및 만료를 위한 추가 명령어
HGETDEL: 원자적 가져오기 및 삭제
일반적인 애플리케이션 패턴에서는 해시 필드를 읽고 즉시 삭제합니다(예: 일회용 인증 토큰 또는 단기 세션 상태 사용). Valkey 9.1에는 단일 네트워크 왕복에서 해시 필드의 값을 검색하고 원자적으로 삭제하는 HGETDEL이 도입되었습니다.
실제 사례:HSET user:1001 temp_token "abcde"(integer) 1HGETDEL user:1001 FIELDS 1 temp_token 1. "abcde"HGET user:1001 temp_token(nil)
MSETEX: 여러 키의 공유 만료 시간
새로운 MSETEX 명령어는 여러 키를 동시에 단일 공유 만료 시간으로 설정할 수 있어 다중 명령어 파이프라인 오버헤드를 제거합니다.
실제 사례: 서로 다른 여러 키가 300초 후에 함께 만료되도록 임시 세션 상태 설정:MSETEX 2 session:auth "ok" session:user_id "1001" EX 300(integer) 1TTL session:auth(integer) 300
조건부 플래그로 향상된 HSETEX
HSETEX는 이제 NX(필드가 없는 경우에만 설정) 및 XX(필드가 있는 경우에만 설정) 조건부 플래그를 지원합니다.
실제 사례: 1시간 TTL로 비율 제한 기준점 필드를 초기화하여 기존 활성 제한을 덮어쓰지 않도록 설정:HSETEX config:123 NX EX 3600 FIELDS 1 "rate_limit" "100"(integer) 1
Memorystore for Valkey 9.0 기반
Valkey 9.1은 Google Cloud Next '26에서 Memorystore for Valkey에 대해 발표한 주요 업데이트를 기반으로 출시되었습니다.
-
AI 및 벡터 워크로드를 위한 기본 제공 모듈: 기본 JSON 지원 및 블룸 필터를 통해 빠른 문서 쿼리 및 멤버십 검사가 가능합니다.
-
6가지 새로운 노드 크기: 비용과 규모를 관리하는 데 도움이 되도록 6가지 새로운 노드 크기를 추가했습니다.
-
소형 노드: 경량 마이크로서비스 및 개발/테스트 환경을 위한 Custom-Pico(1.25GB), Custom-Micro(2.5GB), Custom-Mini(3.5GB)를 지원합니다. 클러스터 모드가 사용 중지된 환경에서만 사용할 수 있습니다.
-
높은 CPU 및 대형 SKU: CPU 사용량이 많은 애플리케이션에 최적화된 HighCPU-Medium(8 vCPU/13GB) 및 Standard-Large(8 vCPU/26GB)를 지원합니다.
-
XXL SKU: 노드당 110GB RAM과 16개의 vCPU를 갖춘 Highmem-XXLarge로, 대규모 클러스터 통합을 통해 가장 까다로운 워크로드를 지원합니다.
(참고: 위 수치는 오픈소스 벤치마크를 기반으로 하며, 실제 성능 개선은 워크로드에 따라 달라질 수 있습니다.)
완전 관리형 Memorystore for Valkey로 마이그레이션
Redis OSS/Valkey 캐싱 레이어를 직접 관리해야 하는 경우 귀중한 엔지니어링 대역폭이 소모되고 확장 중에 운영상의 마찰이 발생합니다. 이번에 Memorystore for Valkey로 마이그레이션하는 새로운 워크플로도 발표하게 되어 기쁘게 생각합니다.
이번 출시를 통해 인프라 마이그레이션이 간단한 완전 관리형 방식으로 제공됩니다. 데이터가 마이그레이션되면 애플리케이션에서 Memorystore for Valkey를 가리키도록 간단한 구성만 변경하면 됩니다. 이 워크플로는 정식 버전으로 제공됩니다. 직접 관리하는 Redis 또는 Valkey에서 완전 관리형 Memorystore for Valkey로 전환하려면 다음 4단계를 따르세요.
1. 대상 인스턴스 프로비저닝: 필요한 샤드 수, 노드 크기, 클러스터링된 데이터베이스 옵션으로 구성된 Memorystore for Valkey 인스턴스를 배포합니다.
2. 온라인 복제 설정: 소스 데이터베이스에서 Memorystore로 직접 지속적인 이중 동기화 온라인 마이그레이션을 시작합니다.
3. 데이터 동기화 검증: 복제 측정항목을 실시간으로 모니터링하여 전체 데이터 세트 정렬과 짧은 지연 시간의 복제 상태를 확인합니다.
4. 컷오버 실행: 애플리케이션 연결 엔드포인트를 Memorystore for Valkey로 전환하여 새 캐시 사용을 시작합니다.
Memorystore for Valkey 고객 사례
이미 Google Cloud 상위 100대 고객 중 95% 이상이 Google Cloud Memorystore를 사용하여 까다롭고 처리량이 많은 워크로드를 지원하고 있으며, Memorystore for Valkey 사용자 수가 증가함에 따라 이러한 추세는 더욱 강화되고 있습니다.
빠르게 변화하는 라이브 스포츠 세계에서는 완벽한 디지털 경험을 제공하는 것이 무엇보다 중요합니다. 경기의 흐름을 바꾸는 플레이가 나오면 수백만 명의 팬이 즉시 자신들의 기기를 꺼내 실시간 통계를 확인하고, 하이라이트를 시청하고, 대화형 기능을 사용합니다. 이러한 대규모의 예측 불가능한 트래픽 급증을 처리하려면 엄청난 규모를 감당할 수 있는 기본 아키텍처가 필요합니다. Valkey의 초기부터 파트너였던 Major League Baseball(MLB)과 같은 조직의 경우 성능 저하 없이 예측할 수 없는 트래픽 급증을 관리하는 것이 필수적입니다.
"MLB는 Memorystore for Valkey를 신뢰하여 이를 통해 대규모 라이브 야구 경기를 지원하고 수백만 명의 팬에게 실시간 통계와 중단 없는 디지털 경험을 제공하고 있습니다. 앞으로 있을 Memorystore for Valkey 9.1의 출시도 매우 기대하고 있습니다. 엔진 최적화와 지연 시간 개선을 통해 가장 예측하기 어려운 경기 당일의 트래픽 급증을 처리할 수 있는 더 높은 성능을 확보하여 팬들에게 기술이 지원할 수 있는 최고의 경험을 제공할 수 있도록 할 것입니다." - Rob Engel, Major League Baseball 소프트웨어 엔지니어링 부문 SVP
경기장 밖에서도 리테일 업종은 특히 주요 쇼핑 시즌이나 반짝 세일 기간에 자체적으로 엄청난 확장 과제에 직면합니다. 현대적인 이커머스 플랫폼은 실시간 맞춤설정, 유동 가격, 즉각적인 인벤토리 업데이트를 통해 쇼핑객의 참여를 유도합니다. 단 몇 밀리초의 지연만으로도 고객 여정이 중단되고 수익에 영향을 미칠 수 있습니다. 경쟁력을 유지하기 위해 Target과 같은 선도적인 리테일러는 가장 중요한 고객 대상 플랫폼을 지원하는 초고속 응답 캐싱 레이어를 필요로 합니다.
"Target은 Google Cloud Memorystore for Valkey를 활용하여 지연 시간이 매우 짧고 복원력이 뛰어난 맞춤설정 서비스용 캐싱을 제공합니다. Valkey 9.1의 향상된 성능을 활용하여 수요가 많은 기간 동안 맞춤설정 플랫폼을 더욱 빠르고 확장 가능하며 복원력 있게 만들 수 있기를 기대합니다." - Scott Weide와 Sumanth Huddar, Target 선임 엔지니어링 관리자
이러한 지연 시간이 매우 짧은 아키텍처에 대한 수요는 스포츠와 리테일 업종을 넘어 다양한 분야로 확대되고 있습니다. 디지털 환경 전반에서 은행, AI 기반 개발, 디지털 스트리밍, 통신 분야의 조직은 모두 매우 빠르고 가용성이 높은 캐시가 필요하다는 공통된 요구사항을 가지고 있습니다. 고빈도 금융 거래 처리, 실시간 복잡한 머신러닝 추론 제공, 원활한 글로벌 동영상 스트림 전송, 방대한 양의 통신 데이터 라우팅 등 어떤 경우든 마이크로초 단위의 지연 시간은 성공을 위한 새로운 기준입니다.
Valkey로 전환
캐시 병목 현상으로 가장 까다로운 애플리케이션의 속도가 느려지는 문제를 방지할 수 있습니다. 지금 바로 Memorystore for Valkey 9.1의 성능, 동적 확장성, 향상된 보안을 경험해 보세요.
-
빌드 시작: Google Cloud 콘솔에서 Memorystore for Valkey 9.1 인스턴스를 만드세요.
-
자세히 알아보기: 기술 문서를 읽고 지원되는 명령어, ACL 구성, Memorystore for Valkey의 세부 기능에 대한 전체 목록을 확인하세요.