Dataflow による TFX 推論を大規模な ML 推論パターンに使用する
Google Cloud Japan Team
※この投稿は米国時間 2021 年 4 月 30 日に、Google Cloud blog に投稿されたものの抄訳です。
このブログシリーズのパート I では、Google Cloud Dataflow による推論に機械学習モデルを効率的にデプロイするためのベスト プラクティスとパターンについて説明しました。特に、入力を効率的にバッチ処理する方法と、shared.py を使用した効率的なモデル使用を取り上げました。
この記事では、TensorFlow Extended(TFX)からのユーティリティ変換である tfx-bsl の RunInference API の使用について確認します。これにより、パート I で説明したパターンを手動で実装しなくても済むようになります。RunInference を使用すると、バッチモードまたはストリーム モードで本番環境の推論パイプラインを構築する際に、パイプラインを簡素化して技術的負担を減らすことが可能になります。
次の 4 つのパターンを取り上げます。
RunInference を使用して ML 予測呼び出しを行う。
RunInference の結果を後処理する。ビジネス プロセスにおけるマルチステップ フローは、多くの場合、予測を立てることから始まります。ここでは、結果を処理して、ダウンストリームで使用できる形式に変換します。
鍵をアタッチする。多くの場合、モデルに渡されるデータと一緒に、たとえば IoT デバイス ID または顧客 ID などの識別子が必要になります。これは、たとえモデル自体では使用されなくても、プロセス内の後の段階で使用されます。これを実現する方法について説明します。
同じパイプライン内の複数のモデルによる推論。同じパイプラインで複数のモデルの実行が必要になることもあります。並列で実行する場合もあれば、一連の予測プロセス(予測呼び出し)として実行する場合もあります。シンプルな例で説明します。
シンプルなモデルを作成する
これらのパターンを説明するために、シンプルで単純なモデルを使って、パイプラインの入出力に必要なデータ エンジニアリングを集中的に取り上げます。このモデルは、5 の乗算に近似するようトレーニングされます。
次のコード スニペットは、ノートブック環境内のセルとして実行できます。
ステップ 1 - ライブラリとインポートを設定する
%pip install tfx_bsl==0.29.0 --quiet
ステップ 2 - サンプルデータを作成する
このステップでは、0~99 の範囲の値を含む小さなデータセットと、それぞれの値に 5 を掛けた値に相当するラベルを作成します。
ステップ 3 - シンプルなモデルを作成してコンパイルし、適合させる
5 の乗算をモデルに学習させます。
次に、テストデータを使用してモデルがうまく動作するか確認します。
以下の結果を見ると、このシンプルなモデルは、今回の要望に十分に近い 5 倍値のテーブルを学習したようです。
ステップ 4 - 入力を tf.example に変換する
今構築したモデルでは、シンプルなリストを使用してデータを生成し、モデルに渡しました。次のステップでは、モデル トレーニングに tf.exampleIn オブジェクトを使用することで、モデルをさらに強化します。
tf.example は、名前をテンソルに変換するシリアル化可能な辞書(あるいはマッピング)です。これにより、ベースのサンプルに新しい機能が追加された場合でも、モデルが引き続き機能します。また、tf.example を使用すると、シリアル化された効率的な形式でモデル間データ移植が可能になるメリットも生まれます。
このサンプルに tf.example を使用するには、最初にヘルパークラス ExampleProcessor を作成する必要があります。これはデータポイントのシリアル化に使用されます。
ExampleProcess クラスを使用して、インメモリ リストをディスクに移動できるようになりました。
機能仕様が整ったので、前と同じようにモデルをトレーニングできます。
このような手作業ではなく、TFX パイプラインを使用してモデルを構築した場合、これらのステップは自動的に実施されます。
ステップ 5 - モデルを保存する
モデルが完成したので、それを保存して RunInference 変換で使用できるようにします。RunInference は、TensorFlow 保存モデル pb ファイルを設定の一部として受け入れます。保存モデルファイルは、RunInference 変換によってアクセス可能な場所に保存する必要があります。ノートブックではこれをローカルのファイル システムにすることができます。ただし、Dataflow でパイプラインを実行するには、すべての作業者がファイルにアクセスできるようにする必要があります。そこで、ここでは GCP バケットを使用します。
gs:// スキーマは、tf.keras.models.save_model api によって直接サポートされています。
開発中に、保存モデルファイルの内容を検査できるようにしておくと便利です。それには、TensorFlow に付属の saved_model_cli を使用します。このコマンドはセルから実行できます。
保存モデルファイルからの出力の要約を以下に示します。「serving_default」というシグネチャに注目してください。これは float 型のテンソルを受け入れます。次のセクションでは、これを変更して別のタイプを受け入れるようにします。
RunInference は、シリアル化された tf.example を、現在のシグネチャに見られるような float 型のテンソルではなくモデルに渡します。これを実現するには、モデルを準備するステップがもう 1 つ必要です。それは、特定のシグネチャを作成することです。
シグネチャは、呼び出し元プログラムとモデルとのインタラクションを制御できる、強力な機能です。TensorFlow のドキュメントでは次のように説明されています。
「オプションのシグネチャ引数によって、たとえば API を処理する SavedModel を使用するプログラムが obj 内のどのメソッドを利用できるかが決まります。Python 関数は、@tf.function(input_signature=...) を付けてシグネチャとして直接渡すか、@tf.function を付けたメソッドで get_concrete_function への呼び出しによって遅れて渡すことができます」
ここでは、次のコードによって、examples という名前の tf.string データ型を受け入れるシグネチャを作成します。その後、このシグネチャはモデルとともに保存され、前に保存されたモデルと入れ替わります。
再度 saved_model_cli コマンドを実行すると、入力シグネチャが DT_STRING に変わるのを確認できます。
パターン 1: 予測のための RunInference
ステップ 1 - パイプライン内で RunInference を使用する
モデルが準備できたので、RunInference 変換を Apache Beam パイプラインに組み入れます。以下のパイプラインでは TFXIO TFExampleRecord を使用しています。これは、RawRecordBeamSource() によって変換にコンバージョンされます。保存モデルの場所とシグネチャは、SavedModelSpec 設定オブジェクトとして RunInference API に渡されます。
注: RunInference を使用すると、次の 2 つのタイプの推論を実行できます。
SavedModel インスタンスからのインプロセス推論。saved_model_spec フィールドが inference_spec_type 内に設定されているときに使用します。
サービス エンドポイントを使用したリモート推論。ai_platform_prediction_model_spec フィールドが inference_spec_type 内に設定されているときに使用します。
出力のスニペットを以下に示します。ここに出てくる値は、未処理の形式であるため、少しわかりづらくなっています。次のセクションで、未処理の結果の後処理を実施します。
パターン 2: RunInference の結果を後処理する
RunInference API は、PredictionLog オブジェクトを返します。これには、シリアル化された入力と呼び出しからモデルへの出力が含まれます。入力と出力の両方にアクセスすることにより、後処理中に、パイプラインのダウンストリームで使用するシンプルなタプルを作成できるようになります。注目すべき点がもう 1 つあります。RunInference では、モデルのバッチ処理準拠機能が透過的に考慮されます(また、パフォーマンス目的でバッチ推論が実施されます)。
PredictionProcessor beam.DoFn は、RunInference の出力から、質問と回答を出力とする書式付きテキストを生成します。もちろん、本番環境システムでは、出力は Tuple[input, output] となるのが一般的です。ユースケースによっては、出力のみになることがあります。
この時点での出力には、元の入力値とモデルの出力値の両方が含まれます。
パターン 3: 鍵をアタッチする
入力とともに情報(多くの場合、一意の識別子)をモデルに渡して、出力からこの識別子にアクセスできるようにするパターンがあると便利です。たとえば IOT のユースケースでは、デバイス ID を、モデルに渡される入力データと関連付けることができます。多くの場合、このタイプの鍵はモデル自体には有用ではありません。そのため、最初のレイヤに渡すべきではありません。
これは、RunInference が Tuple[key, value] を受け入れ、Tuple[key, PredictLog] を出力することによって処理します。
ステップ 1 - アタッチされた鍵付きのソースを作成する
予測のため送信するデータとともに鍵が必要なので、このステップでは、BigQuery 内にテーブルを作成します。これには 2 つのコラムがあり、1 つには鍵が保持され、もう 1 つにはテスト値が保持されます。
ステップ 2 - ポスト プロセッサとパイプラインを変更する
このステップでは次のことを行います。
新しい BigQuery ソーステーブルから読み取るようパイプラインを変更する。
マップ変換を追加する。これによってテーブル行が Tuple[ bytes, Example] に変換されます。
鍵とともに結果を出力するようポスト推論プロセッサを変更する。
パターン 4: 同じパイプライン内の複数のモデルによる推論
本シリーズのパート I では、複数のモデルを通したデータ実行を可能にするさまざまな Apache Beam の分岐手法を、「複数のモデルからの結果の結合」パターンでカバーしました。
これらの手法は RunInference API に適用可能です。これは、モデルが同じ場合でも異なる場合でも、1 つのパイプライン内の複数のブランチで簡単に使用できます。これは機能的にはカスケード アンサンブルと似ていますが、ここではデータが単一の Apache Beam DAG 内の複数のモデルを通ります。
並列の複数モデルによる推論
この例では、異なる 2 つのモデルで同一データを実行します。1 つは、これまで使用してきた 5 を掛けるモデルで、もう 1 つは、10 を掛けるよう学習する新しいモデルです。
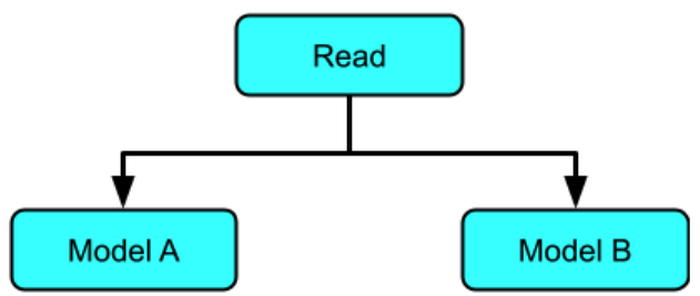
2 つのモデルをソースデータに適用します。
連続した複数のモデルによる推論
連続パターンでは、1 つ以上の連続したモデルにデータが送られます。この場合、各モデルの出力がその次のモデルにチェーンしていきます。
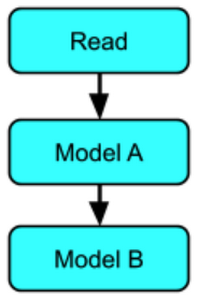
手順は次のとおりです。
1.BigQuery からデータを読み取る
2.データをマッピングする
3.5 の乗算モデルによる RunInference
4.結果を処理する
5.10 の乗算モデルによる RunInference
6.結果を処理する
Dataflow でパイプラインを実行する
ここまでは、ダイレクト ランナーを使用してパイプラインをローカルで実行してきました。これは、パイプラインをデフォルト設定で実行するときに暗黙的に使用されます。--runner などの設定パラメータを渡すことにより、製品版の Dataflow ランナーでも同じサンプルを実行できます。詳細とサンプルについては、こちらを参照してください。
Dataflow サービスで実行されるマルチモデル パイプライン グラフの例を以下に示します。
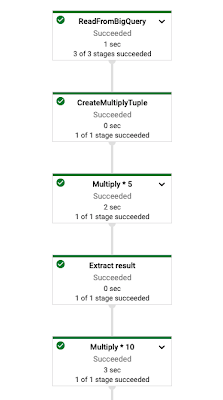
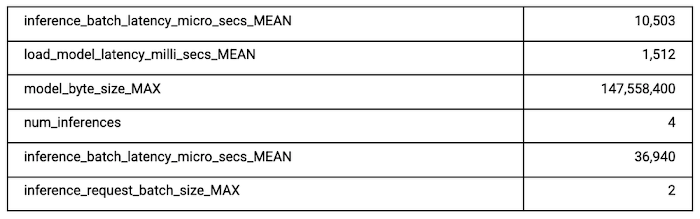
Dataflow ランナーでは、パイプライン モニタリングや、RunInference 変換から出力された指標にもアクセスできます。ライブラリから入手できる広範なリストの指標の一部を、以下の表に示します。
まとめ
本シリーズのパート II であるこのブログでは、標準的な推論から後処理までの一般的なシナリオにおける tfx-bsl RunInference の使用と、パイプライン内の複数の場所での RunInference API の使用について確認しました。
知識をさらに深めるには、Dataflow と TFX のドキュメントを参考にしてください。また、Google Cloud AI Platform Pipelines で TFX を試すこともできます。
謝辞
Dataflow TFX チームと TF チームの大勢のメンバーの並々ならぬ努力がなければ、これを実現させることはできませんでした。TFX および TF チームでは、Konstantinos Katsiapis 氏、Zohar Yahav 氏、Vilobh Meshram 氏、Jiayi Zhao 氏、Zhitao Li 氏、Robert Crowe 氏に特に感謝します。Dataflow チームでは、終始サポートと意見を提供してくれた Ahmet Altay 氏に感謝します。
-シニア スタッフ デベロッパー アドボケイト Reza Rokni