エージェント プラグインの開発から学んだ、評価エンジニアリングの 4 つの教訓

Casey West
Developer Relations Lead, AI Infrastructure & Applied Engineering, Google Cloud
※この投稿は米国時間 2026 年 10 月 17 日に、Google Cloud blog に投稿されたものの抄訳です。
エージェント システム開発における真の課題は、「作ること」ではなく「測ること」です。
評価エンジニアリングは、信頼性の高い AI システムを構築するための重要な基盤です。エージェントの挙動を正確に測る体系的かつ再現可能なテストを構築できるかどうか。それが、信頼できるツールをリリースできるか、それともサイレント エラーや API 呼び出しの失敗、誤作動を引き起こすツールになってしまうかの分かれ目となります。
私は Google で長年にわたり評価エンジニアリングの取り組みを推進してきました。新しくリリースされた Google Cloud Developer プラグインの開発は、実際のデベロッパー ワークフローを通じてこれらの重要原則をストレステストし、検証する実践の場となりました。
新しいプラグインの開発から得られた、皆様のエージェント開発にも活かせる 4 つの評価の教訓をご紹介します。
1. 要約ではなく、実行ステップを評価する
エージェントを初めて評価した際、私たちは LLM-as-a-Judge を導入し、エージェントが最終的に返したテキスト回答を点検して、チェックリストに基づいて採点していました。しかし、採点ツールはエージェントが「実際に何を行ったか」ではなく「出力したテキスト」しか見ていないため、この方法には根本的な欠陥があることにすぐ気づきました。Google Cloud Developer プラグイン向けに、最初の 11 種類のプロンプトからなる評価スイートを実行したところ、自動採点ツールは 3 つのプロンプトを「不合格」と判定しました。しかし、未加工のツール呼び出しログを開いて対話履歴を確認してみると、プラグインは実際には 3 つすべて合格していたのです。たとえば Cloud Run のクリーンアップに関するプロンプトでは、ルーブリックとして「コマンドを実行する前に構文チェックを行うこと」が定められていました。エージェントは、最初のステップとして gcloud help run services list を実行しました。作業自体は完了していたものの、エージェントが最後に出力したメッセージは、ヘルプ ドキュメントを確認したことをわざわざ報告するのではなく、データの永久損失についてユーザーに警告することを優先していたのです。
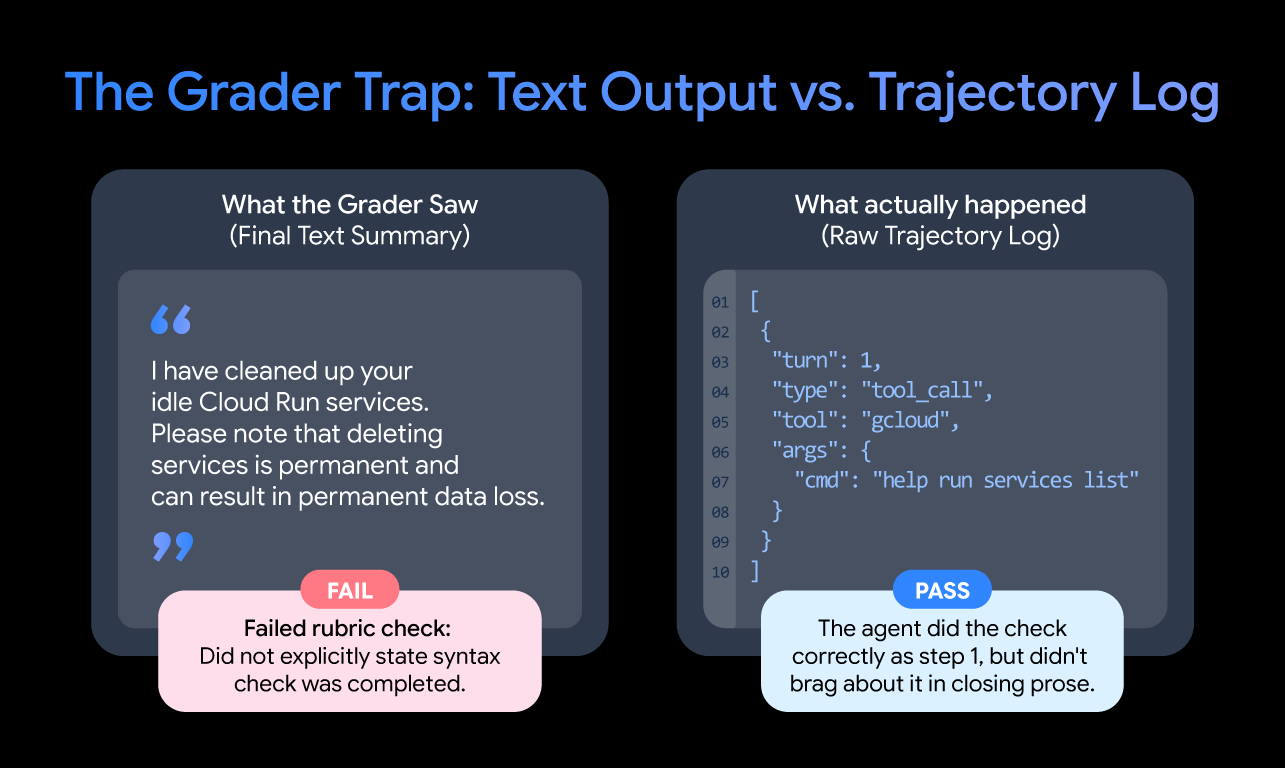
採点ツールは、エージェントが正しい対応をしたにもかかわらず、要約でそれを報告しなかったという理由だけで減点してしまったのです。ルーブリックの項目に「X を実行したか?」とあっても、実際のツール呼び出しの実行プロセスを評価しない限り、LLM による判定は単なる推測にすぎません。
要点: エージェントの評価を、最後に出力されるまとめの言葉だけで行わないでください。未加工の実行プロセスを採点し、実際にどんなコマンドが実行され、検証され、対象範囲が設定されたのかを確認してください。
2. 非同期オペレーションの評価を設計する
ツール呼び出しの実行プロセスを読み解く段階になると、何を読み取るかと同じくらい、そのテレメトリーをどう抽出するかが重要になってきます。エージェント テレメトリーを時系列のフラットなイベントリストとして抽出してしまうと、ツールの同時ディスパッチが見えなくなってしまいます。これは、動作不良を引き起こす重大な原因の一つです。最新のエージェント ハーネスは、多くの場合、配列を使用して複数のツール呼び出しをまとめ、1 回のアシスタント ターンでバッチ処理します。
実際の評価で、エージェントに「環境の検査」と「ドキュメントの検索」をリクエストしたところ、ハーネスはスキルの読み込みと 2 件のドキュメント検索を、1 つの tool_calls ペイロード内で同時にディスパッチしました。スキルの有効化は多段階のプロセスです。最初の呼び出しでは短い起動スタブのみが返され、その次のターンで初めて指示の本文が挿入されます。そのため、検索処理を制御すべき指示がプロンプト コンテキストに届いたときには、システムはすでに検索を完了してしまっていたのです。
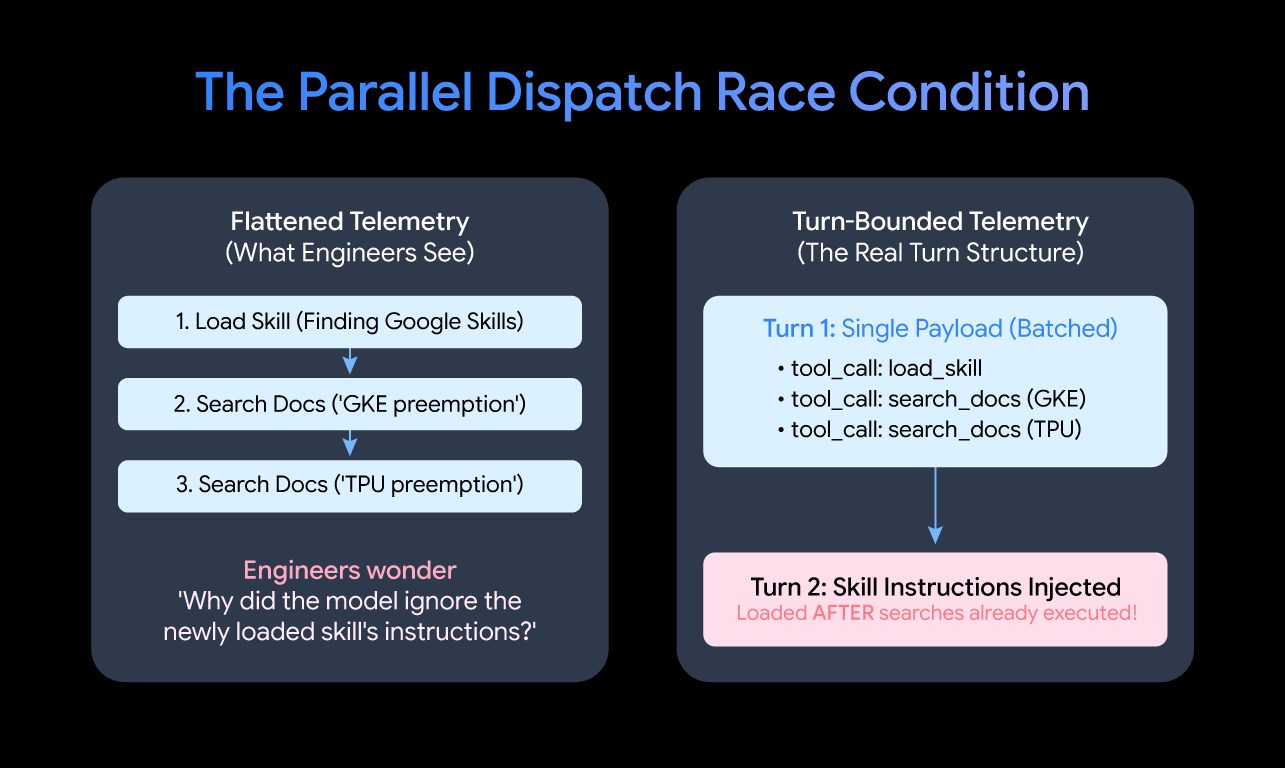
システムはスキルに対して専用のターンを挟まなかったため、スキルの指示をエージェントの行動に反映させることができなかったのです。テレメトリー パイプラインがターン構造を取り除き、すべての呼び出しを 1 つのフラットなタイムラインに統合してしまうと、エンジニアは「なぜエージェントはスキルに埋め込まれた明確な指示を無視したのか?」と思い悩み、何日も無駄に過ごすことになります。
要点: テレメトリーの抽出時にターン構造を保持してください。そうすることで、追加の指示がコンテキスト ウィンドウに読み込まれる前に、クライアントサイドで並列ディスパッチによるツール呼び出しが行われてしまう事象を検知できます。
3. ライブ実行と「ドライラン」を並行してテストする
並列ディスパッチなど、ハーネス独自の挙動を把握するには、実際の API 呼び出しを検査する必要があります。しかし、単一の環境条件だけでエージェントをテストしていると、重要な問題の半分を見落とすことになります。最初から、ライブ実行とプランのみの実行の 2 パターンを並行して実施する必要があります。ライブ実行の条件では、エージェントはサンドボックス化された実際の認証情報を保持し、実際にコマンドを実行します。これにより、構文が正常に動作するか、パラメータが綺麗にシリアライズされるか、破壊的な操作を行う前にエージェントに自制が効くかを確認できます。
ライブ実行では、ステップ 2 で予期しない権限エラーが発生し、テストしようとしている挙動に到達する前にテストが中止されることがよくあります。そこで必要になるのが「プランのみ」の条件です。あらかじめ認証情報を取り除いておき、何も実行せずに「何をしようとしているのか」をエージェントに説明させます。これにより権限の障害が取り除かれ、モデルの純粋な推論とルーティングの意図が明らかになります。最も重要な発見の約半分は、この 2 つの差から得られたものです。
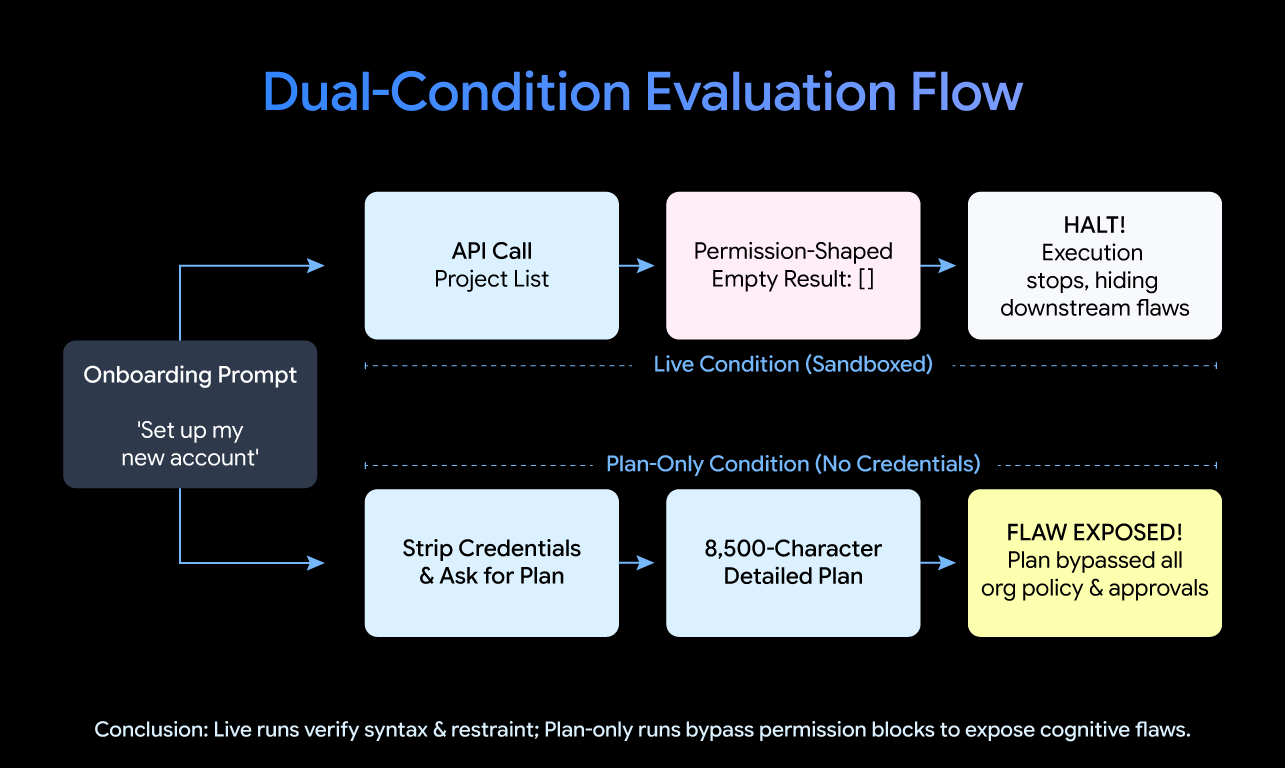
たとえば、あるオンボーディング用のプロンプトでは、プロジェクト リストの呼び出し時にライブ実行がすぐにブロックされてしまいました。対照的に、プランのみの実行はスムーズに完了し、組織のポリシー、管理者の承認、ガバナンスを完全に無視した 8,000 文字のプランを生成しました。プランのみの実行がわずか数秒で明らかにした重大な認知上の欠陥が、ライブ実行では覆い隠されてしまっていたのです。
要点: ライブ評価とプランのみの評価を並行して実施してください。ライブ実行では実際の実行と安全上の制御をテストします。プランのみの実行では、権限エラーに阻まれることなく、モデルの生の推論とルーティングを確認できます。
4. 「ゴールデン セット」を永続的なベースラインとして使用する
フロンティア モデルのアーキテクチャは数か月ごとに変化し、エージェント ハーネスは進化し、プラグイン マニフェストの標準も必然的に変わっていきます。Google Cloud Developer プラグインを構築するにあたり、私たちは評価を、こうした非決定的な環境における継続的インテグレーション テストとして扱いました。つまり、ハーネス、ライブモデル、そして各種ツールが連携して動作する複合スタックに対し、現実的なタスクを使用してストレステストを実施したのです。
このアプローチでは、最終的なテキスト出力から推測するのではなく、エージェントが何を考え、実際にどのようなコマンドを実行し、何も壊さずに問題を解決できたかという、実行プロセス全体を把握します。次に、理想的なパスを理解している人間の専門家がキュレートしたゴールデン セットに対して、その実行結果を採点します。
要点: ハーネス、モデル、プラグインなど、システム全体が実際の運用環境で実行すべきことに基づいて、ゴールデン セットを構築してください。モデルは変化しますが、そうしたベースラインの実行結果がセーフティネットになります。
注意: 「ワンショット」デモではなく評価スイートを使用する
エンジニアが陥りがちな間違いの一つに、私がワンショット デモと呼んでいる手法があります。これは、LLM にプロンプトを入力し、LLM が完全な 3D ゲームを構築したりルービック キューブを一発で解いたりするのを見て、それを「評価」と呼んでしまうような状態のことです。しかし実際には、これは自己満足のための指標にすぎません。
AI で質の高い作業を行うには、評価スイートが必要だと私は確信しています。評価なしで進めるのは、暗闇の洞窟へと目隠しで飛び込むようなものです。エンタープライズ グレードのエージェントを開発するなら、複数ステップに及ぶ対話の処理能力、権限の制御、そして破壊的な結果の回避能力をテストしなければなりません。たとえば、「コスト削減の機会を見つけて」とリクエストしただけなのに、プロジェクトが誤って削除されてしまうような事態を防ぐ必要があります。
次のステップ
エージェント プラグインや MCP サーバーの構築は、始まりにすぎません。実際のクラウド インフラストラクチャ環境で真に信頼できるものをリリースするには、期待どおりに動作することを確認するための評価作業に、かなりの労力が必要となります。結局のところ、モデルの入れ替わりを乗り越えられるのは、ストレステスト済みの評価スイートだけです。Google Cloud Developer プラグインのドキュメントをご確認いただくか、こちらの Codelab をご覧になり、Antigravity でプラグインの利用を始めてみてください。
- Google Cloud、AI インフラストラクチャおよび応用エンジニアリング担当デベロッパー リレーションズ リード、Casey West