Data Agent Kit の一般提供を開始: Google のデータクラウドがあらゆるコーディング エージェントで利用可能に

Arun Nair
Product Manager, Google
Jeff Nelson
Developer Relations Engineer, Google
※この投稿は米国時間 2026 年 10 月 1 日に、Google Cloud blog に投稿されたものの抄訳です。
このたび、Google Cloud Data Agent Kit の一般提供を開始しました。Data Agent Kit は、Model Context Protocol(MCP)ツールとエージェント スキルの無料セットです。Antigravity や Claude Code、Codex、その他の一般的なツールなど、すでに使用しているコーディング エージェントを Google Cloud データ プロダクトと直接連携させることができます。
一般提供では、オープン レイクハウスに対する BigQuery Graph、Bigtable、Managed Service for Apache Spark からのアクセスがサポートされるほか、日常業務をより迅速かつスムーズにするためのさまざまな機能強化が追加されています。
Data Agent Kit とは
コーディング エージェントは、SQL、PySpark、パイプライン コードの作成に非常に優れています。デフォルトで欠けているのは、開発環境に関するコンテキストです。たとえば、どのテーブルが存在するか、どのようにパーティション分割されているか、チームが信頼しているのはどれか、昨夜のジョブが失敗したのはなぜか、といった情報です。これらがないと、優れたエージェントであっても、推測に基づいて作業せざるを得ず、最終的にはスキーマやエラーログをチャットに貼り付けて不足している情報を補うことになります。
Data Agent Kit は、次の 2 つの要素でその不足を埋めます。
-
MCP ツール: 15 以上の Google データクラウド サービスに接続できるため、エージェントはスキーマの検査、クエリの実行、ジョブ ログの読み取り、本番環境でのリソース管理を行うことができます。
-
Google が作成したスキル: Google Cloud エンジニアが提供するオープンソースの指示書により、エージェントは BigQuery SQL の最適化、Bigtable 行キーの設計、dbt(データビルド ツール)パイプラインの構築といった、データのベスト プラクティスを学習できます。
Data Agent Kit は、VS Code、Antigravity IDE、Cursor、その他の VS Code 互換エディタの IDE 拡張機能として、または Antigravity 2.0、Antigravity CLI、Claude Code、Codex のプラグインとして、あるいは Cloud Shell や Cloud Workstations にプリインストールされた状態で、既存の作業環境でそのまま使用できます。また、IDE 拡張機能により、Google Cloud コンソールの軽量版がエディタに組み込まれるため、ウィンドウを切り替えることなく、データの閲覧、クエリの実行、エージェントの作業の確認を行うことができます。
仕組み
たとえば、エージェントに「ベストセラー商品の来月の需要を予測し、それに対応できる十分な在庫があるかどうかを確認して」と指示したとします。Data Agent Kit が関連するスキルを読み込むため、エージェントはタスクに関する Google のベスト プラクティスに従います。Knowledge Catalog を検索して、チームが信頼している販売テーブルと在庫テーブルを見つけます。次に、MCP ツールを使用して BigQuery で予測を実行し、AlloyDB for PostgreSQL で現在の在庫レベルを確認して、統合された回答をエディタまたはターミナルに返します。すべてのステップが独自の IAM 権限で実行されます。
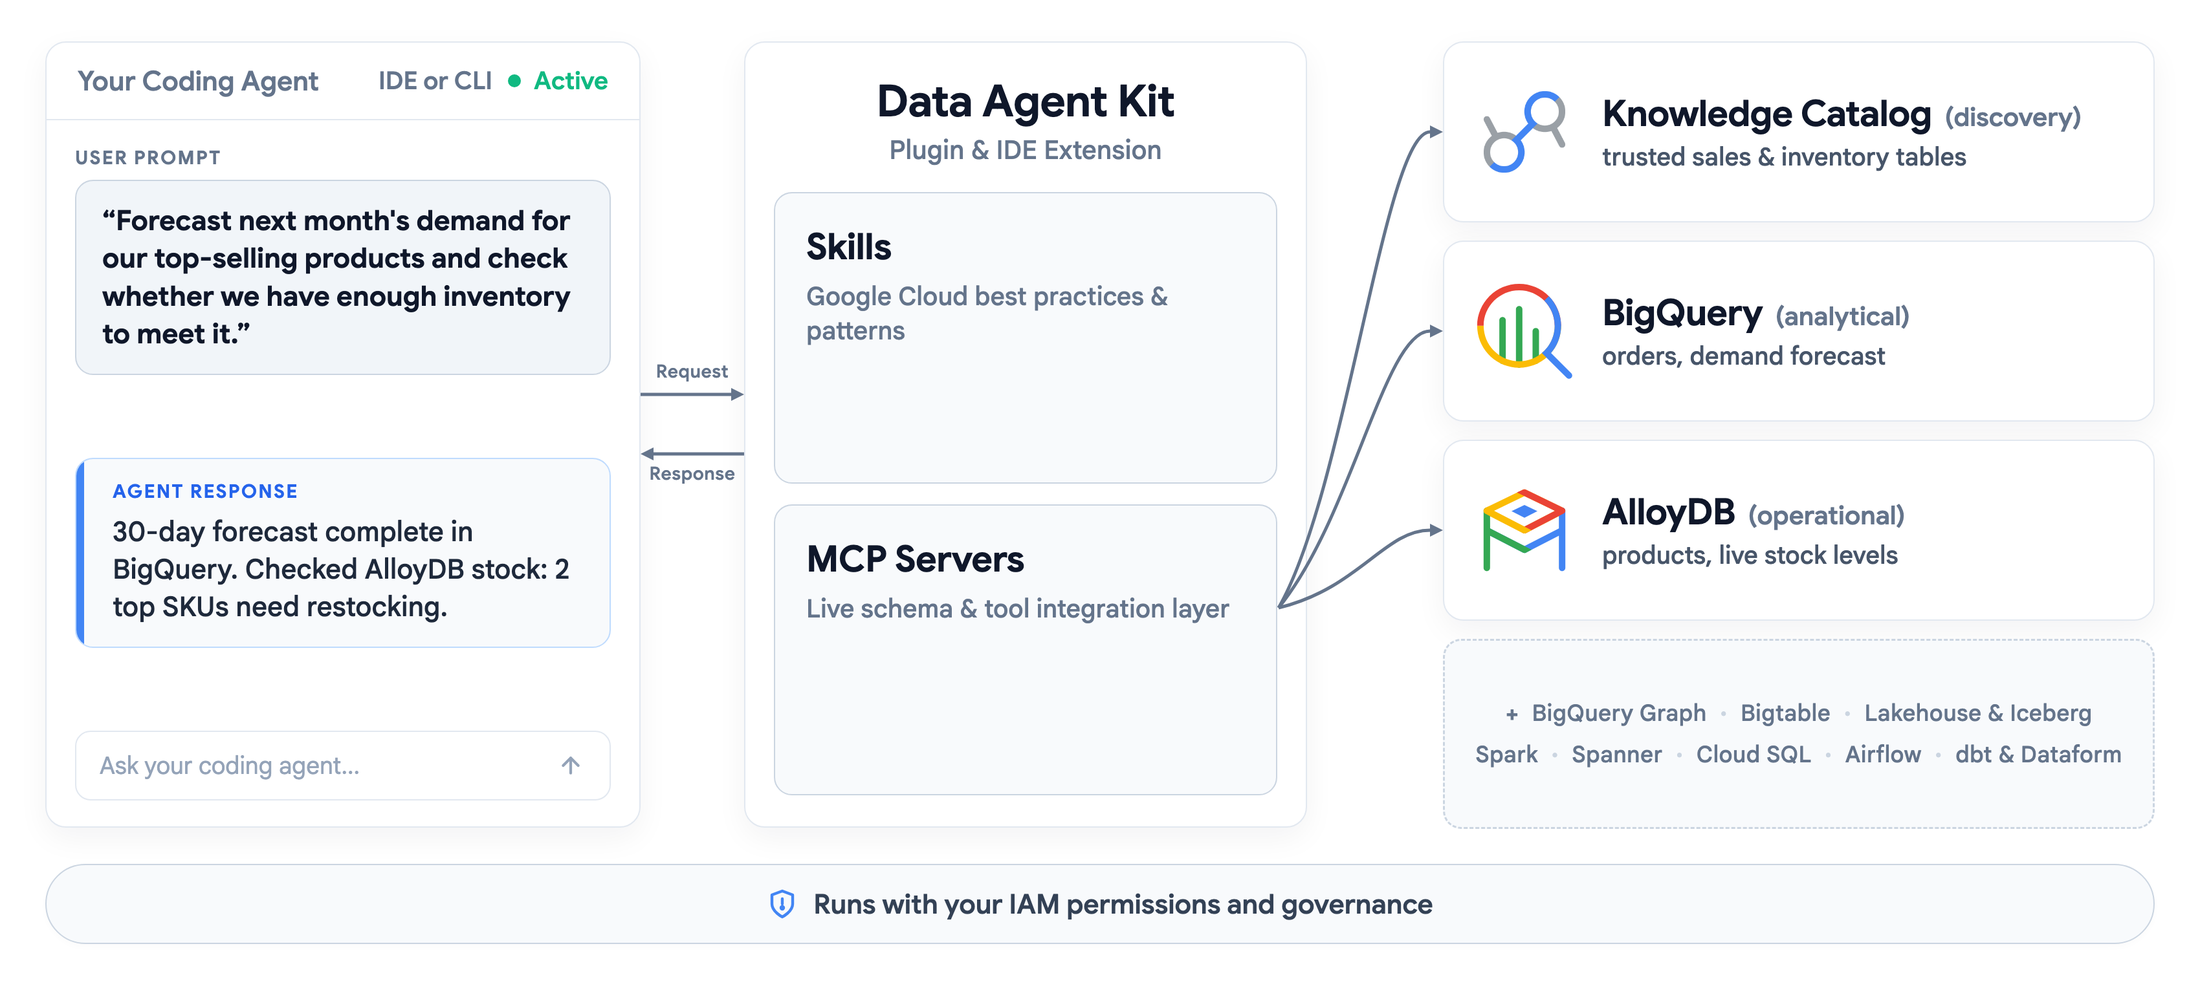
Data Agent Kit がデータに接続する仕組み。
構築できるもの
Data Agent Kit は、分析、オペレーショナル データベース、レイクハウス、パイプラインに対応しています。具体的にどのように機能するのか、まずは一般提供の新機能から見ていきましょう。
分析とグラフ: BigQuery と BigQuery Graph(一般提供の新機能)
グラフは、ユーザーが一緒に購入する商品や、サプライヤーが在庫にどのように接続しているかなど、関係性を自然に探索する方法です。通常、グラフを構築するには、CREATE PROPERTY GRAPH DDL を手動で記述し、GQL を学習して、どのキーが実際にエッジを形成するかを把握する必要があります。
代わりに、必要なグラフを指示するだけで、エージェントがグラフを構築してくれます。bigquery-graph-author スキルは、テーブルをノードとエッジにマッピングし、提案された各関係を実際のデータと照合したうえで、実際に作成する前に承認を求めるプランを表示します。既存の ER 図やデータモデルから始めることもできます。bigquery-graph-query スキルが GQL を記述し、IDE のグラフ ビジュアライザで結果をクリックして確認できます。
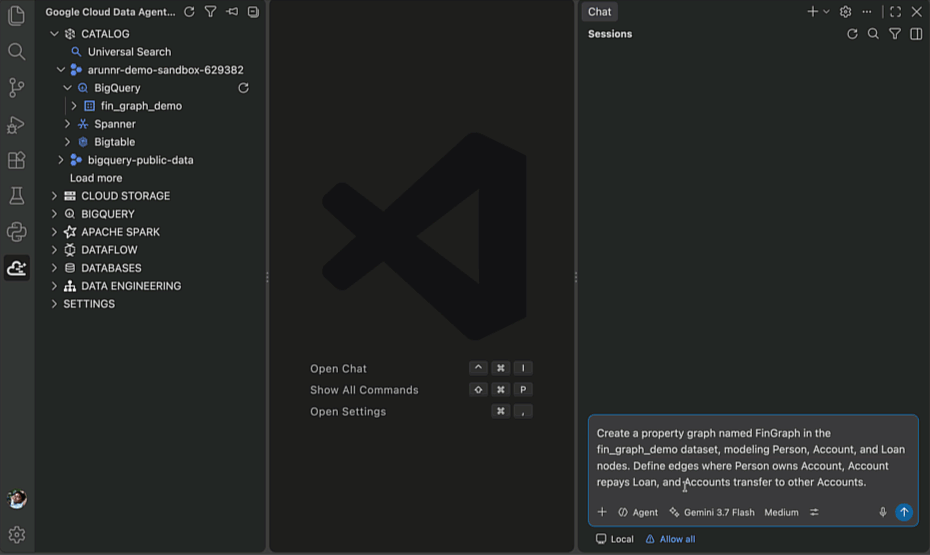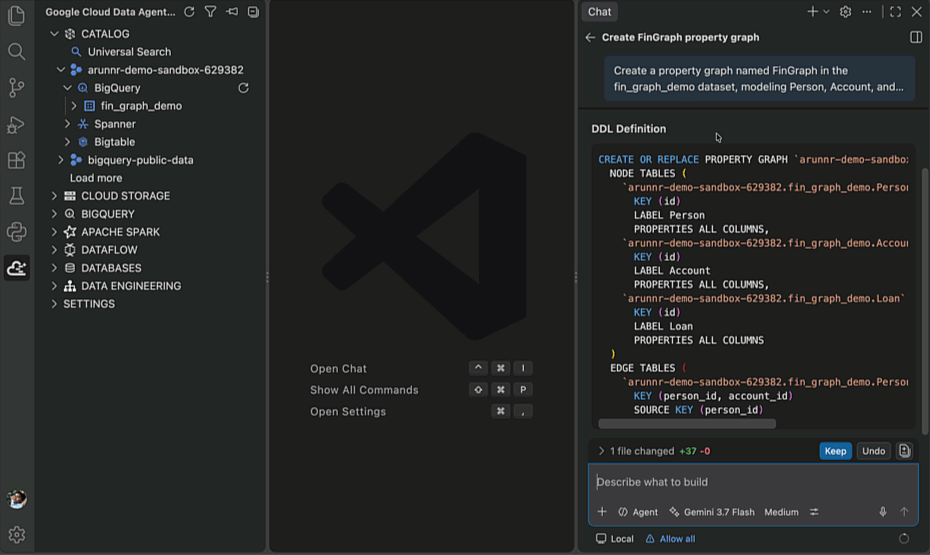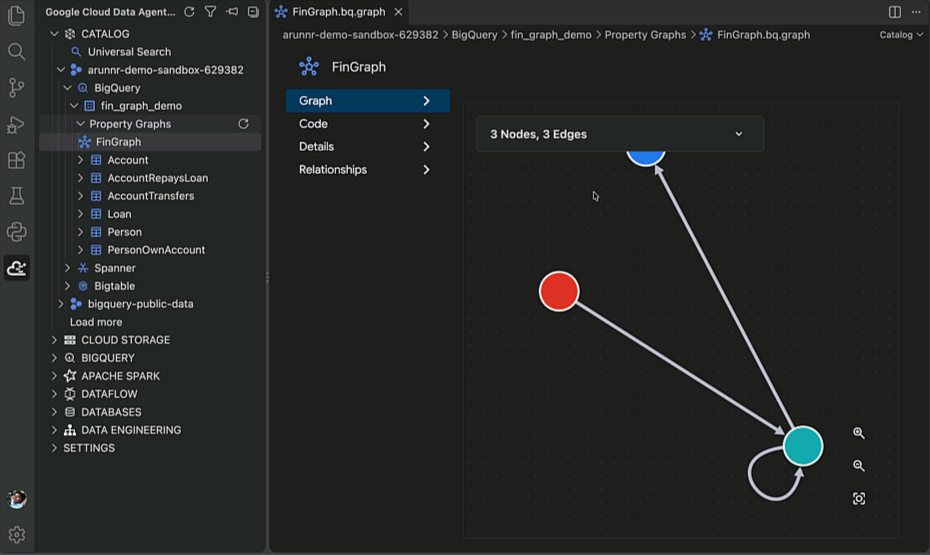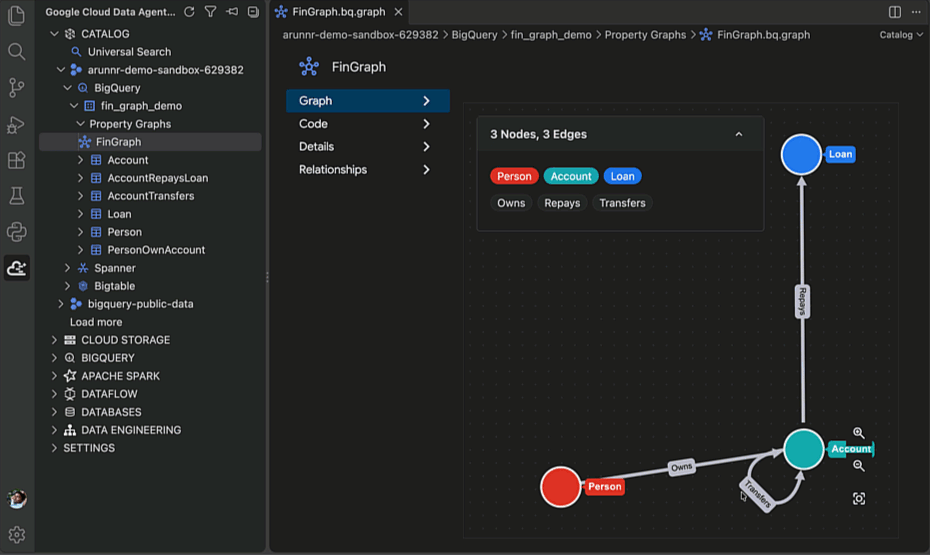
BigQuery プロパティ グラフを構築して可視化する。
オペレーショナル データベースとリアルタイム データベース: Spanner、AlloyDB、Cloud SQL、Bigtable(一般提供版の新機能)
パーソナライズされたフィード、ライブ カウンタ、ストアフロントの「最近閲覧した商品」レールなど、一部の機能は即座に読み込む必要があります。Bigtable はまさにそのために構築されており、行キーを適切に設計することで、その恩恵を最大限に得られます。
一般提供により、Bigtable は Spanner、AlloyDB、Cloud SQL とともに、Data Agent Kit で完全にサポートされるデータベースとなりました。新しい bigtable-basics スキルは、データの読み取り方法に基づいてスキーマを設計し、作成する前に、ホットスポットとフルテーブル スキャンにフラグを立てます。エージェントはテーブルを作成し、GoogleSQL でクエリを実行して、列ファミリーを読み取り可能な列にフラット化できます。IDE では、カタログ エクスプローラで Bigtable インスタンスとテーブルをブラウジングし、SQL エディタからクエリを実行できます。
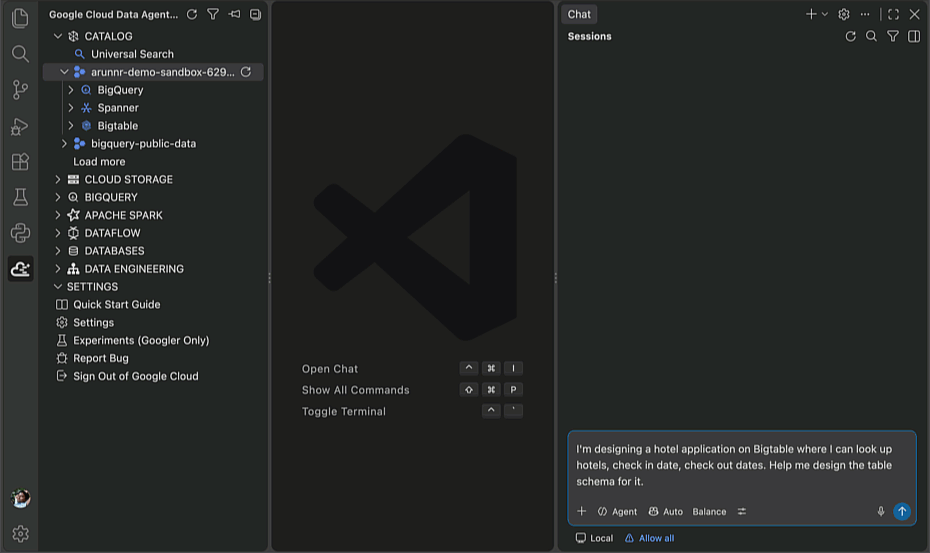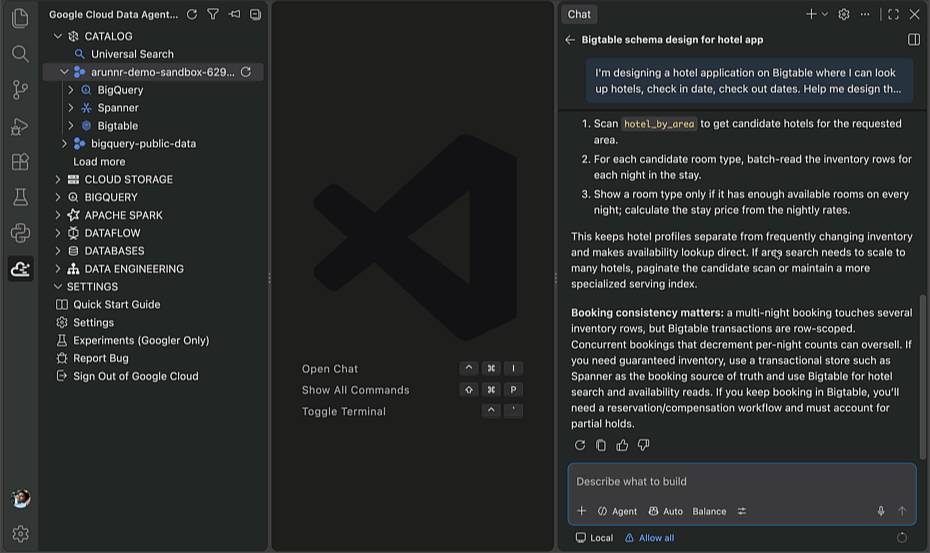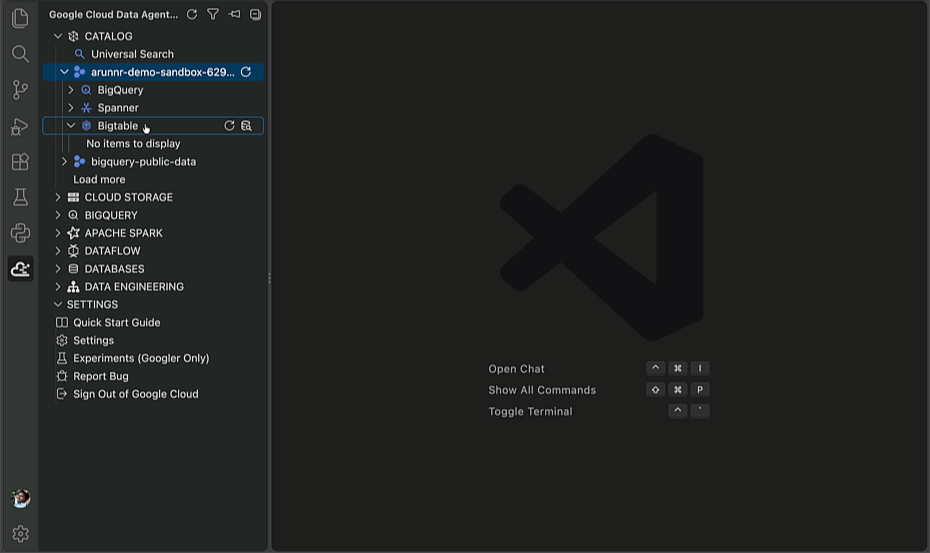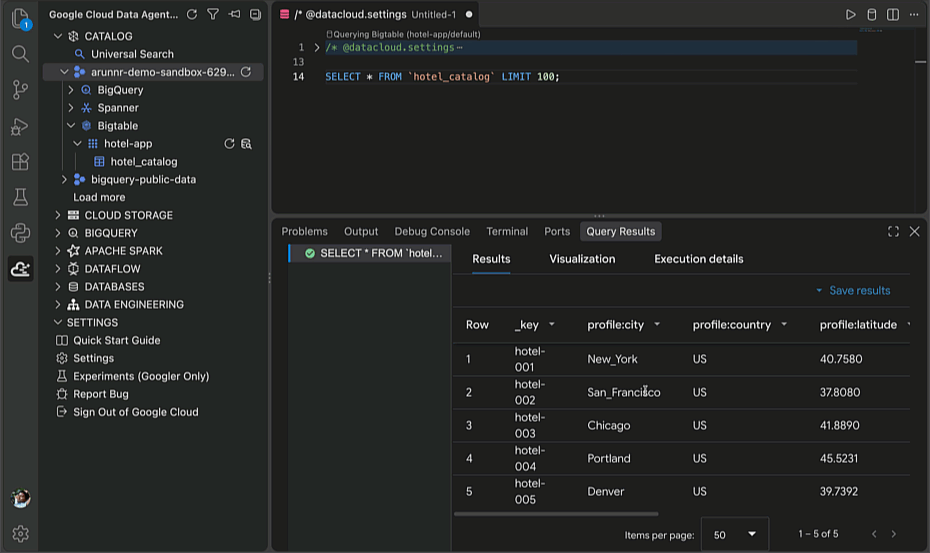
エージェントのガイドによる Bigtable スキーマの設計とクエリ。
レイクハウスと Spark: Managed Service for Apache Spark と Lakehouse for Apache Iceberg(一般提供の新機能)
エージェントは、これまでも BigQuery を介して Lakehouse 内の Apache Iceberg テーブルにクエリを実行することができました。さらに今度は、Managed Service for Apache Spark 上のサーバーレス Spark を使用して、同じテーブルを操作できるようになります。クラスタの管理は不要です。各セッションは状態を保持するため、一時ビューがステートメント間で引き継がれ、ブランチ、タイムトラベル、スキーマの進化など、Iceberg の全機能を利用できます。
また、すべてのテーブルを Google Cloud 上に配置する必要もありません。federate-lakehouse-catalog スキルは、Lakehouse を AWS Glue と Databricks Unity Catalog に接続します。これにより、エージェントは最初に取り込みパイプラインを構築することなく、そのデータを移動させずにその場でクエリできます。
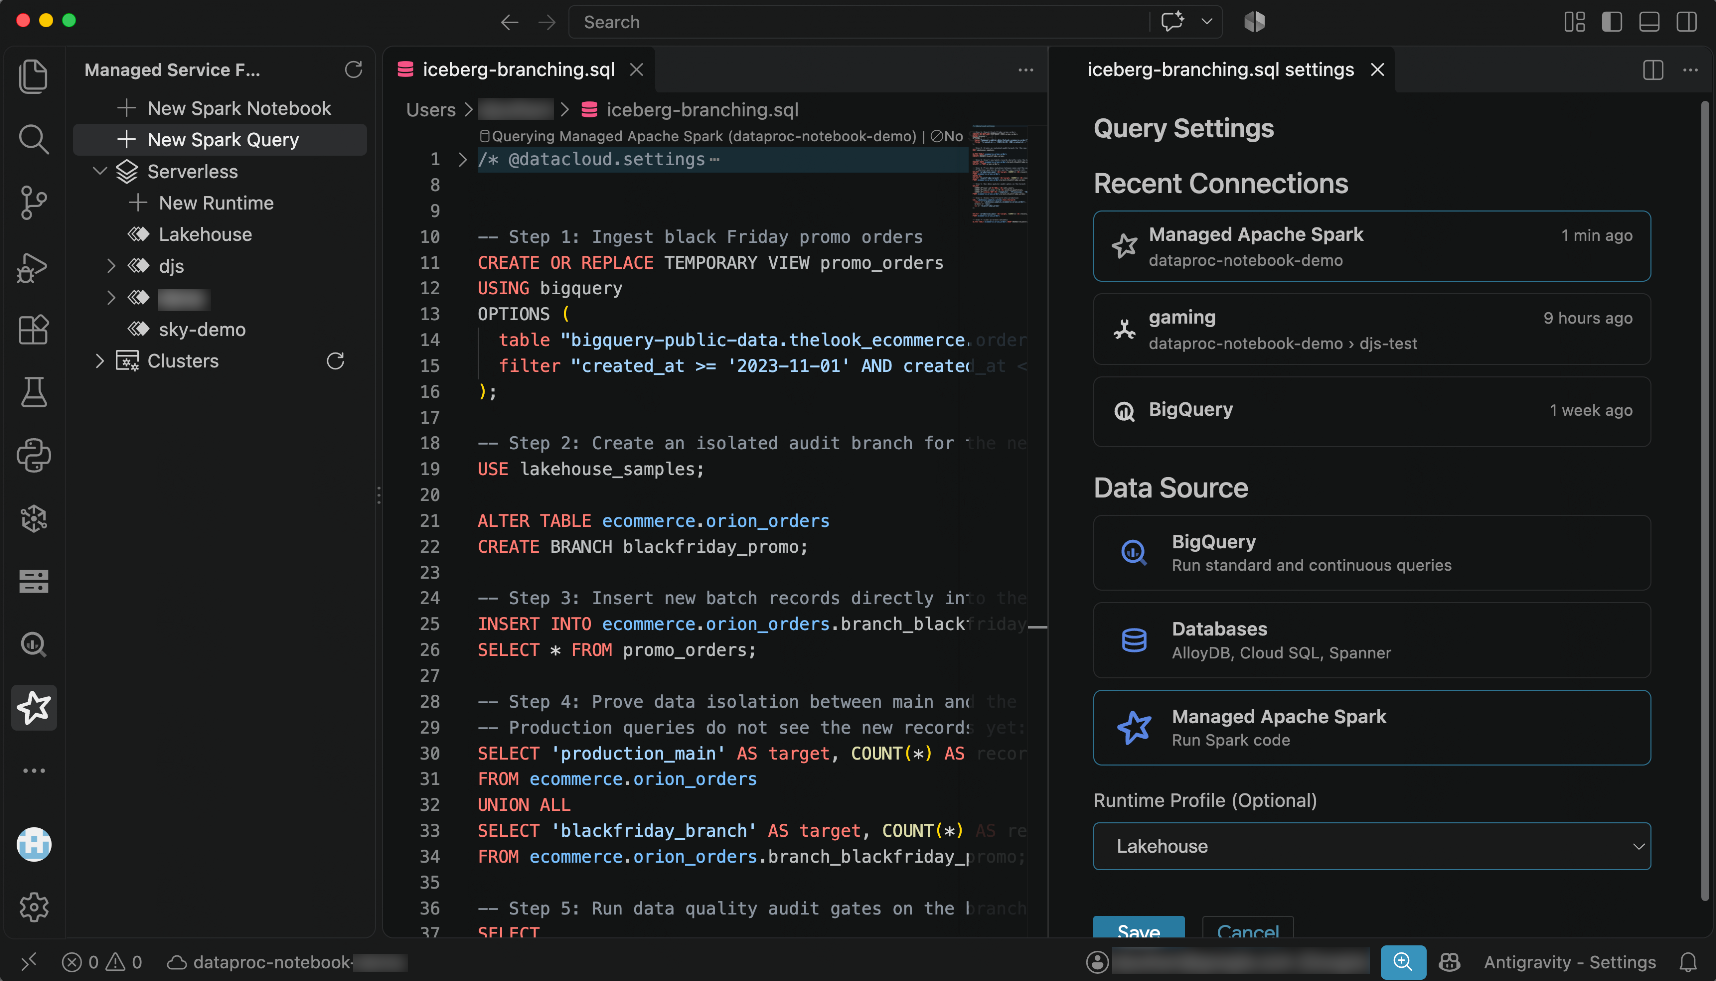
Managed Service for Apache Spark を使用した Iceberg テーブルのブランチとクエリ。
パイプラインとオーケストレーション: dbt、Dataform、Managed Service for Apache Airflow
ロジックが機能するようになったら、エージェントはそれを独自に実行されるパイプラインに変換できます。エージェントが dbt または Dataform モデルを作成すると、gcp-pipeline-orchestration スキルがそれらをノートブックとともにまとめ、Managed Service for Apache Airflow 上のオーケストレーション パイプラインとしてスケジュールします。パイプラインには、モデルのアップロードやバッチ推論の実行など、Gemini Enterprise Agent Platform のステップを含めることもできます。
IDE では、ビジュアル パイプライン キャンバスで各実行を追跡できます。タスクに対応が必要な場合は、[診断] をクリックしてログをエージェントに渡します。Airflow と Spark のトラブルシューティング スキルが根本原因を特定し、ユーザーが承認するだけの修正案を提案します。
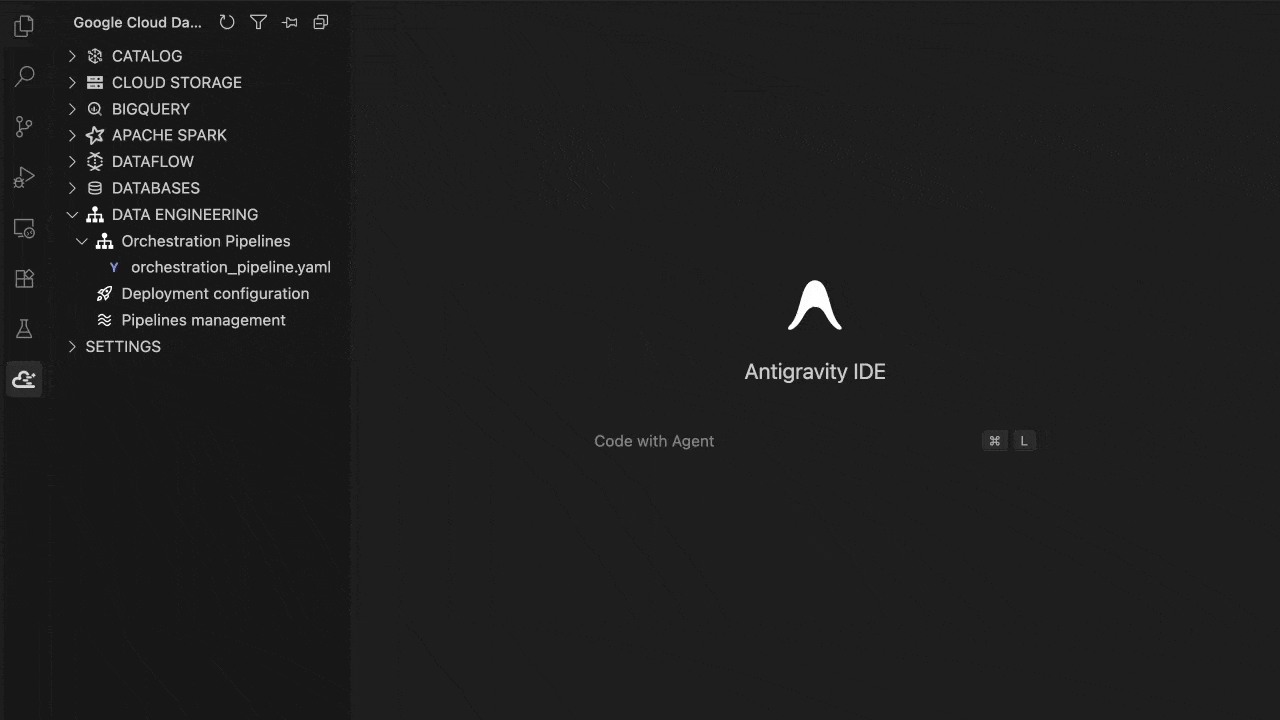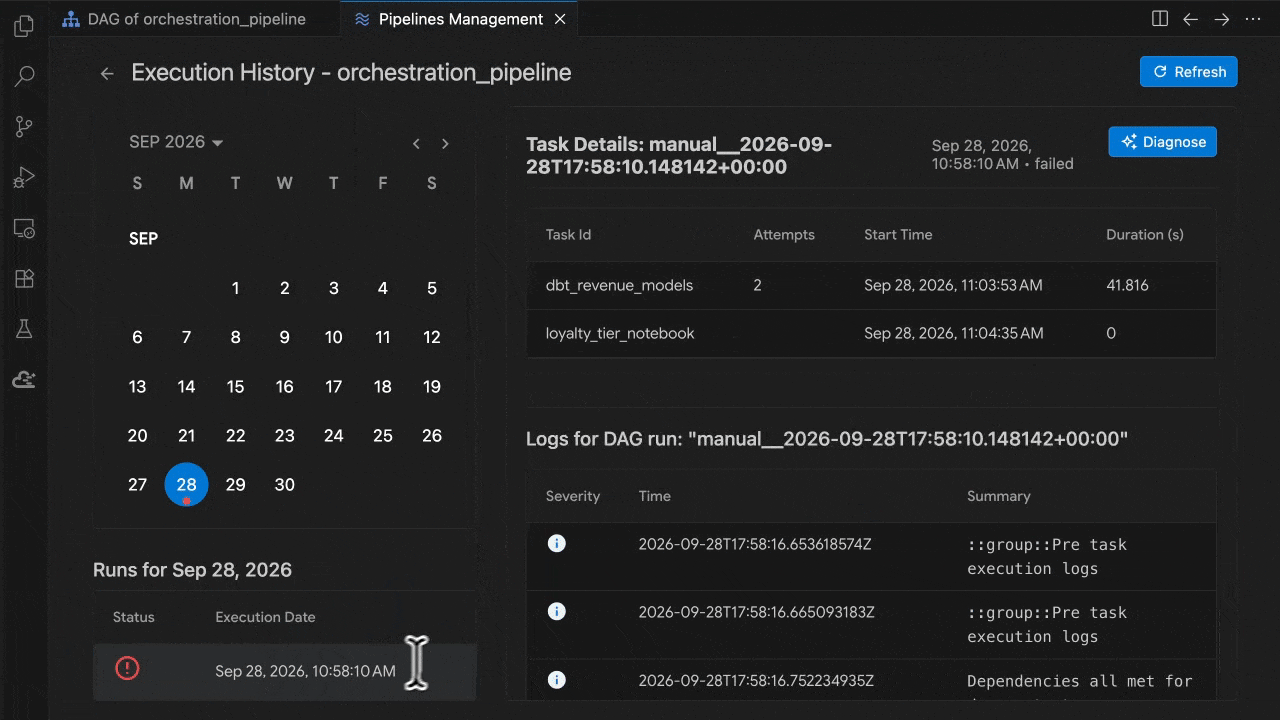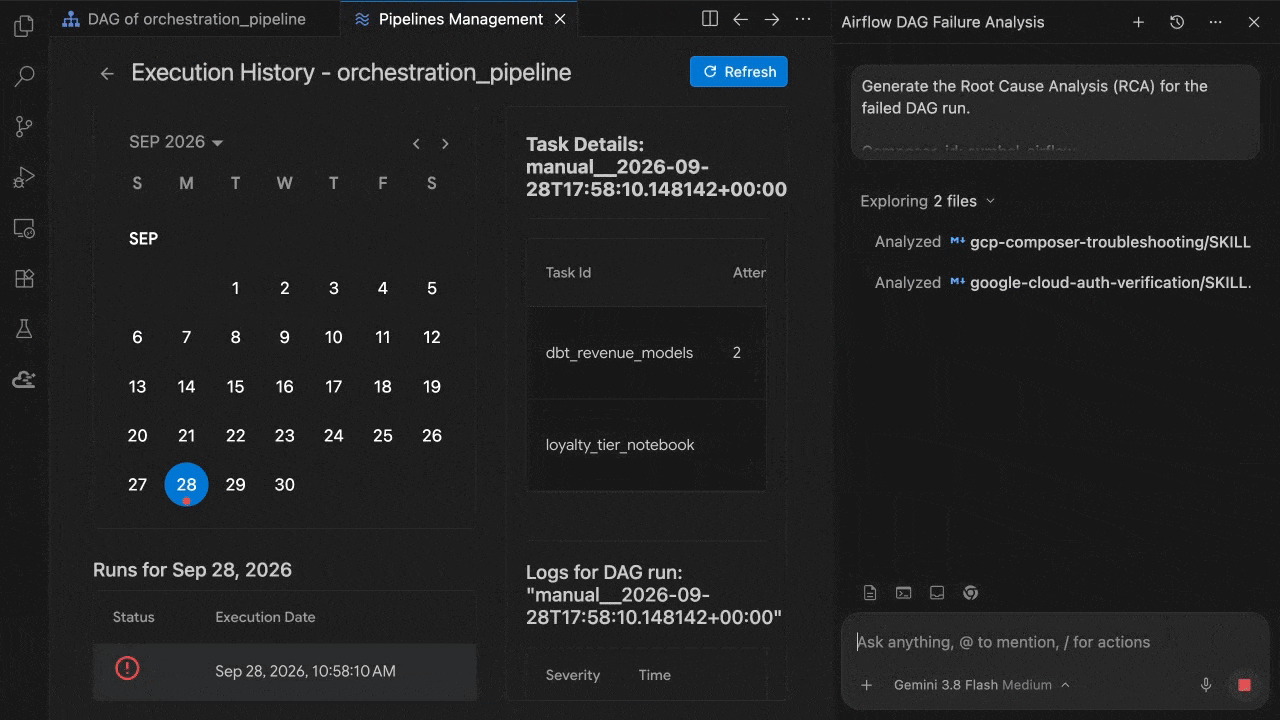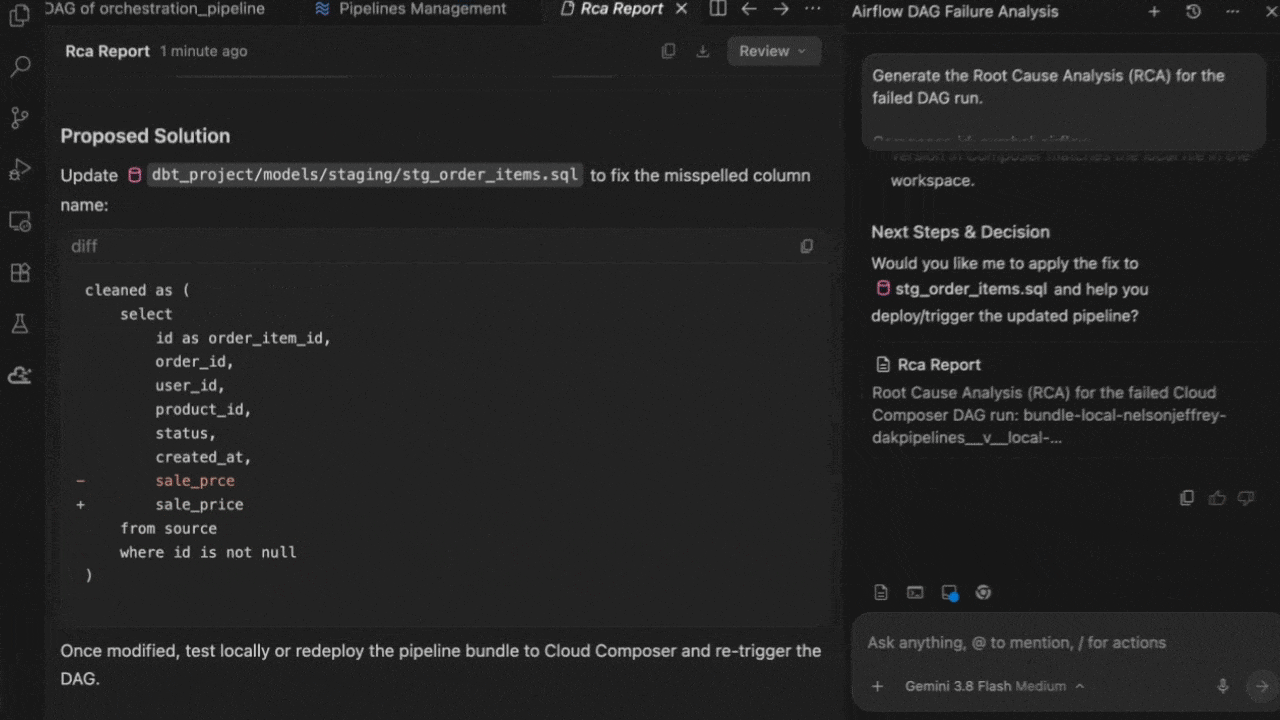
エージェントを使用して失敗した Airflow DAG をトラブルシューティングする。
デベロッパー エクスペリエンスの向上
一般提供では、セットアップや日常のワークフローも簡素化されます。利用を開始するには、1 回ログインして、使用する Google Cloud サービスを選択するだけです。Data Agent Kit は、必要な API を自動的に有効にし、対応するスキルをインストールして、手動で設定ファイルを作成することなく MCP サーバーを構成します。IDE では、SQL エディタとノートブックで、インライン コード生成、テーブルへの @ 参照、提案された変更の差分表示がサポートされるようになりました。この拡張機能は、アクティブなプロジェクト、開いているファイル、実行したばかりのクエリのエラーもエージェントと共有するため、「このクエリを修正して」と依頼するだけで機能します。
また、コアツールの高速化と応答性の向上も実現しました。新しい Spark ノートブックでは、Spark Connect ランタイムが自動的に作成、選択され、エディタ内の Spark SQL クエリは、組み込みの実行指標を使用して分離されたセッションで実行されます。カタログ エクスプローラの読み込みが速くなり、サイドバーに BigQuery の一般公開データセットが表示されるようになりました。チューニングされたノートブック スキルにより、エージェントはより少ないトークンでノートブック タスクをより迅速に完了できます。
エンタープライズに対応
Data Agent Kit は追加料金なしでご利用いただけます。エージェントが使用する Google Cloud サービスの標準料金のみをお支払いいただきます。また、スキルはエージェントをコスト効率の良いクエリパターンへと誘導します。たとえば、BigQuery クエリの実行前に、誤ったフルテーブル スキャンを避けるためにパーティション キーを確認したり、ドライランを実行したりするように促します。また、スキルは GitHub でオープンソースとして公開されているため、チームはスキルを監査したり、フォークしたり、社内基準に合わせたカスタムスキルを独自に作成したりできます。
アクセス制御については、エージェントはユーザーまたはユーザーが権限を借用するサービス アカウントとして接続するため、行レベルおよび列レベルのセキュリティ ポリシーが自動的に適用されます。管理者は、Identity and Access Management(IAM)で MCP アクセスを管理し、Model Armor で MCP トラフィックをスクリーニングし、VPC Service Controls とプリンシパル アクセス境界ポリシーでエージェントのスコープを設定することもできます。
インストールして使ってみる
Data Agent Kit は、IDE またはターミナルで 1 分以内に設定できます。
オプション 1: IDE 拡張機能をインストールする
-
IDE 拡張機能: VS Code、Antigravity IDE、Cursor、または VS Code 互換エディタの拡張機能パネルで「Google Cloud Data Agent Kit」を検索します。VS Code Marketplace または Open VSX からインストールすることもできます。
-
Antigravity 2.0: [設定] > [カスタマイズ] > [Build with Google Plugins] に移動し、Data Agent Kit をダウンロードします。
-
Cloud Shell と Cloud Workstations: デフォルトですでにインストールされています。エディタを開いてログインするだけです。
オプション 2: CLI プラグインをインストールする
公式の GoogleCloudPlatform/data-agent-kit-plugin リポジトリを使用して、お好みのコーディング エージェントのコマンドを実行します。
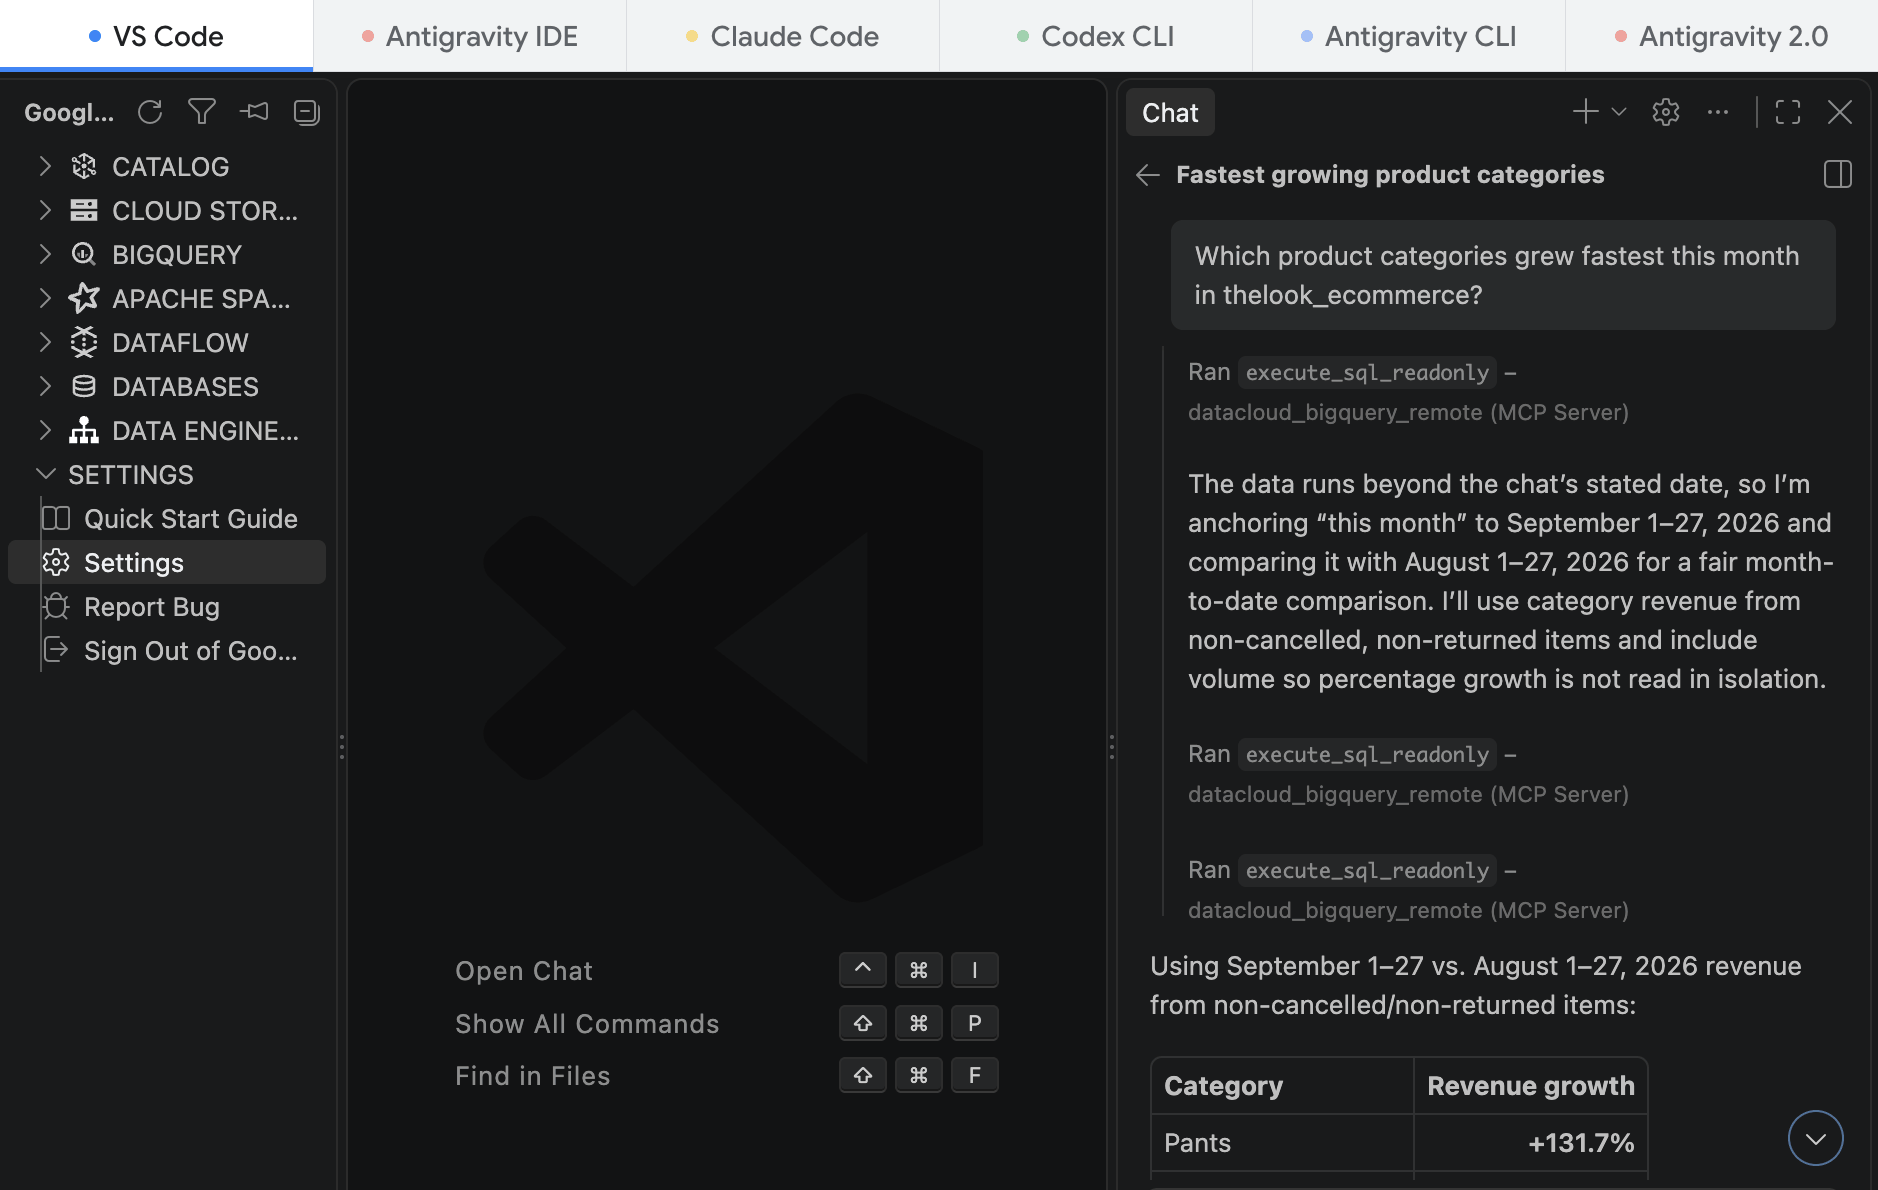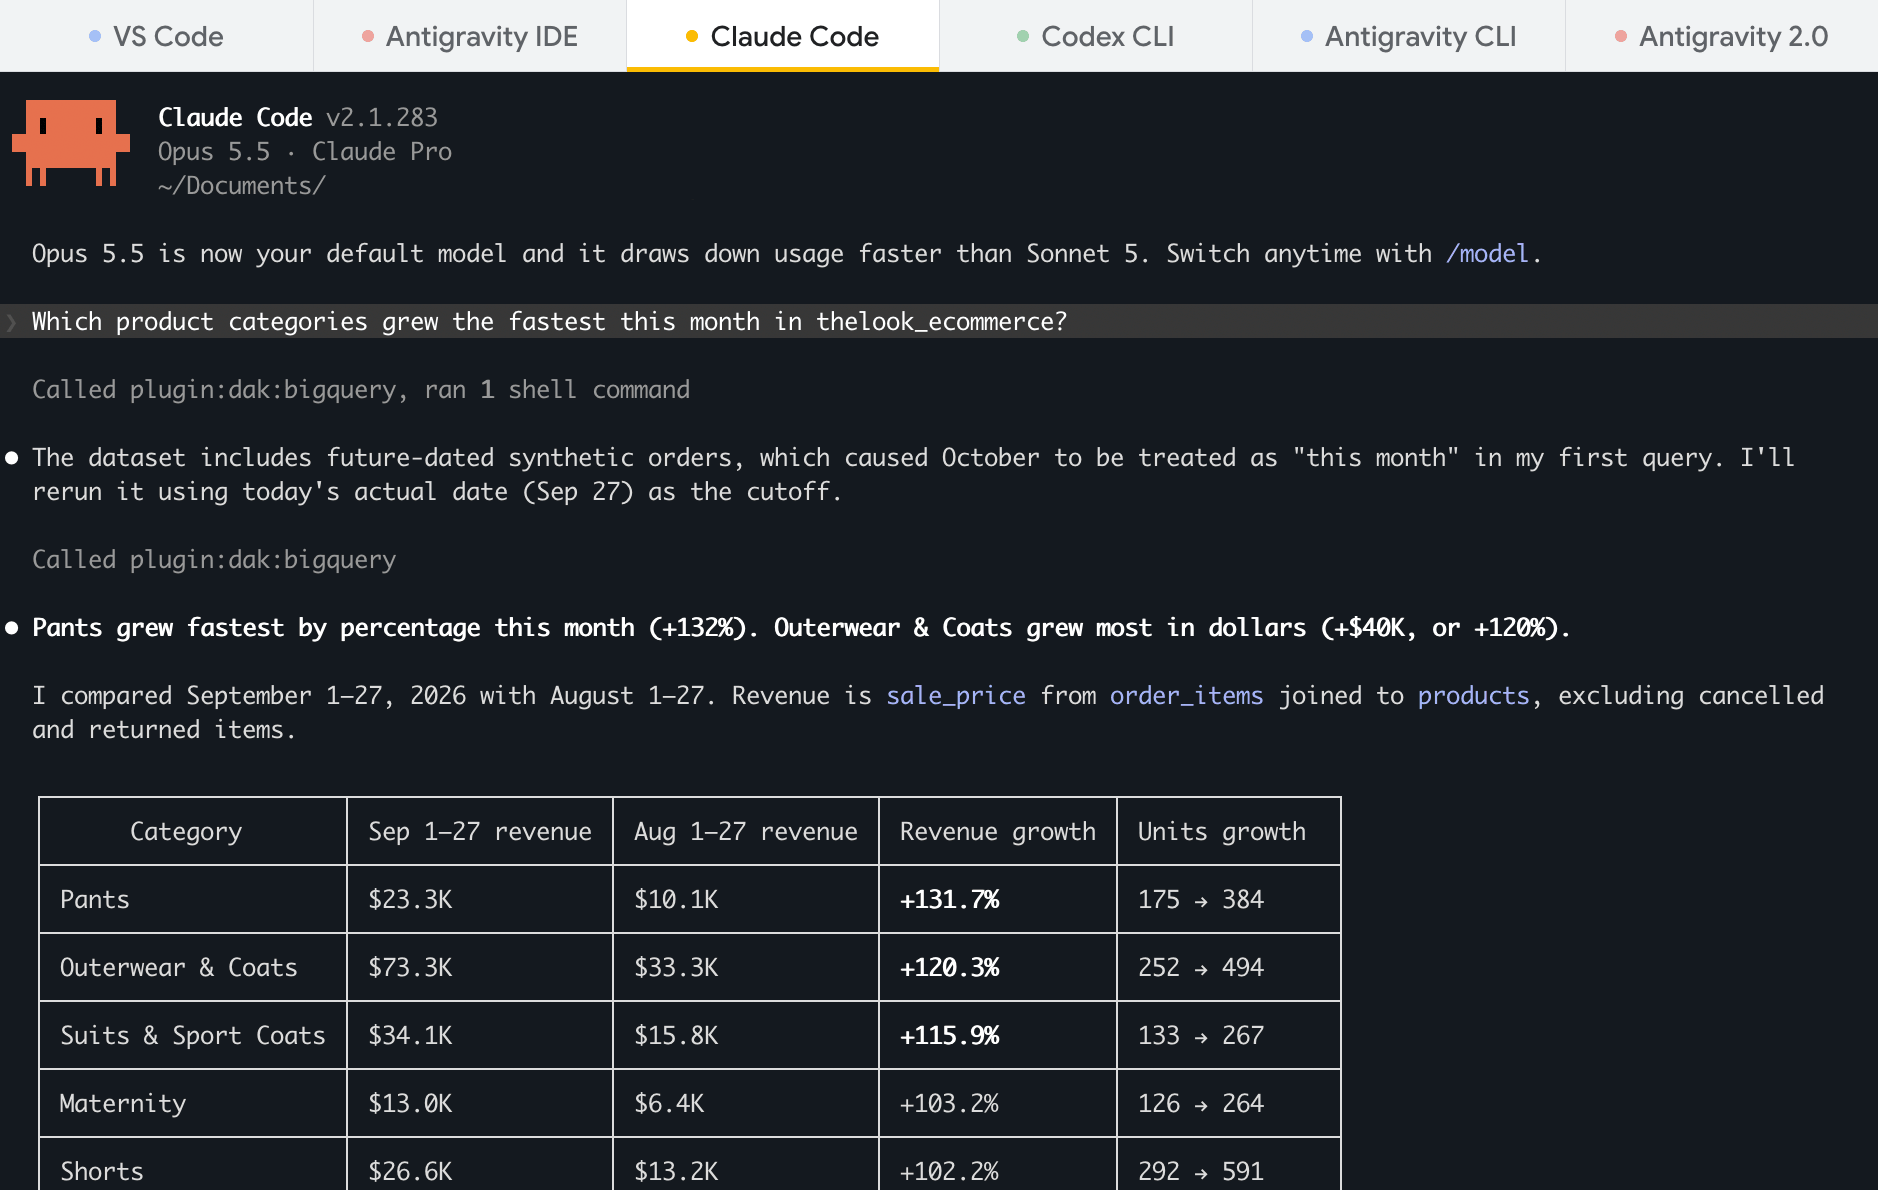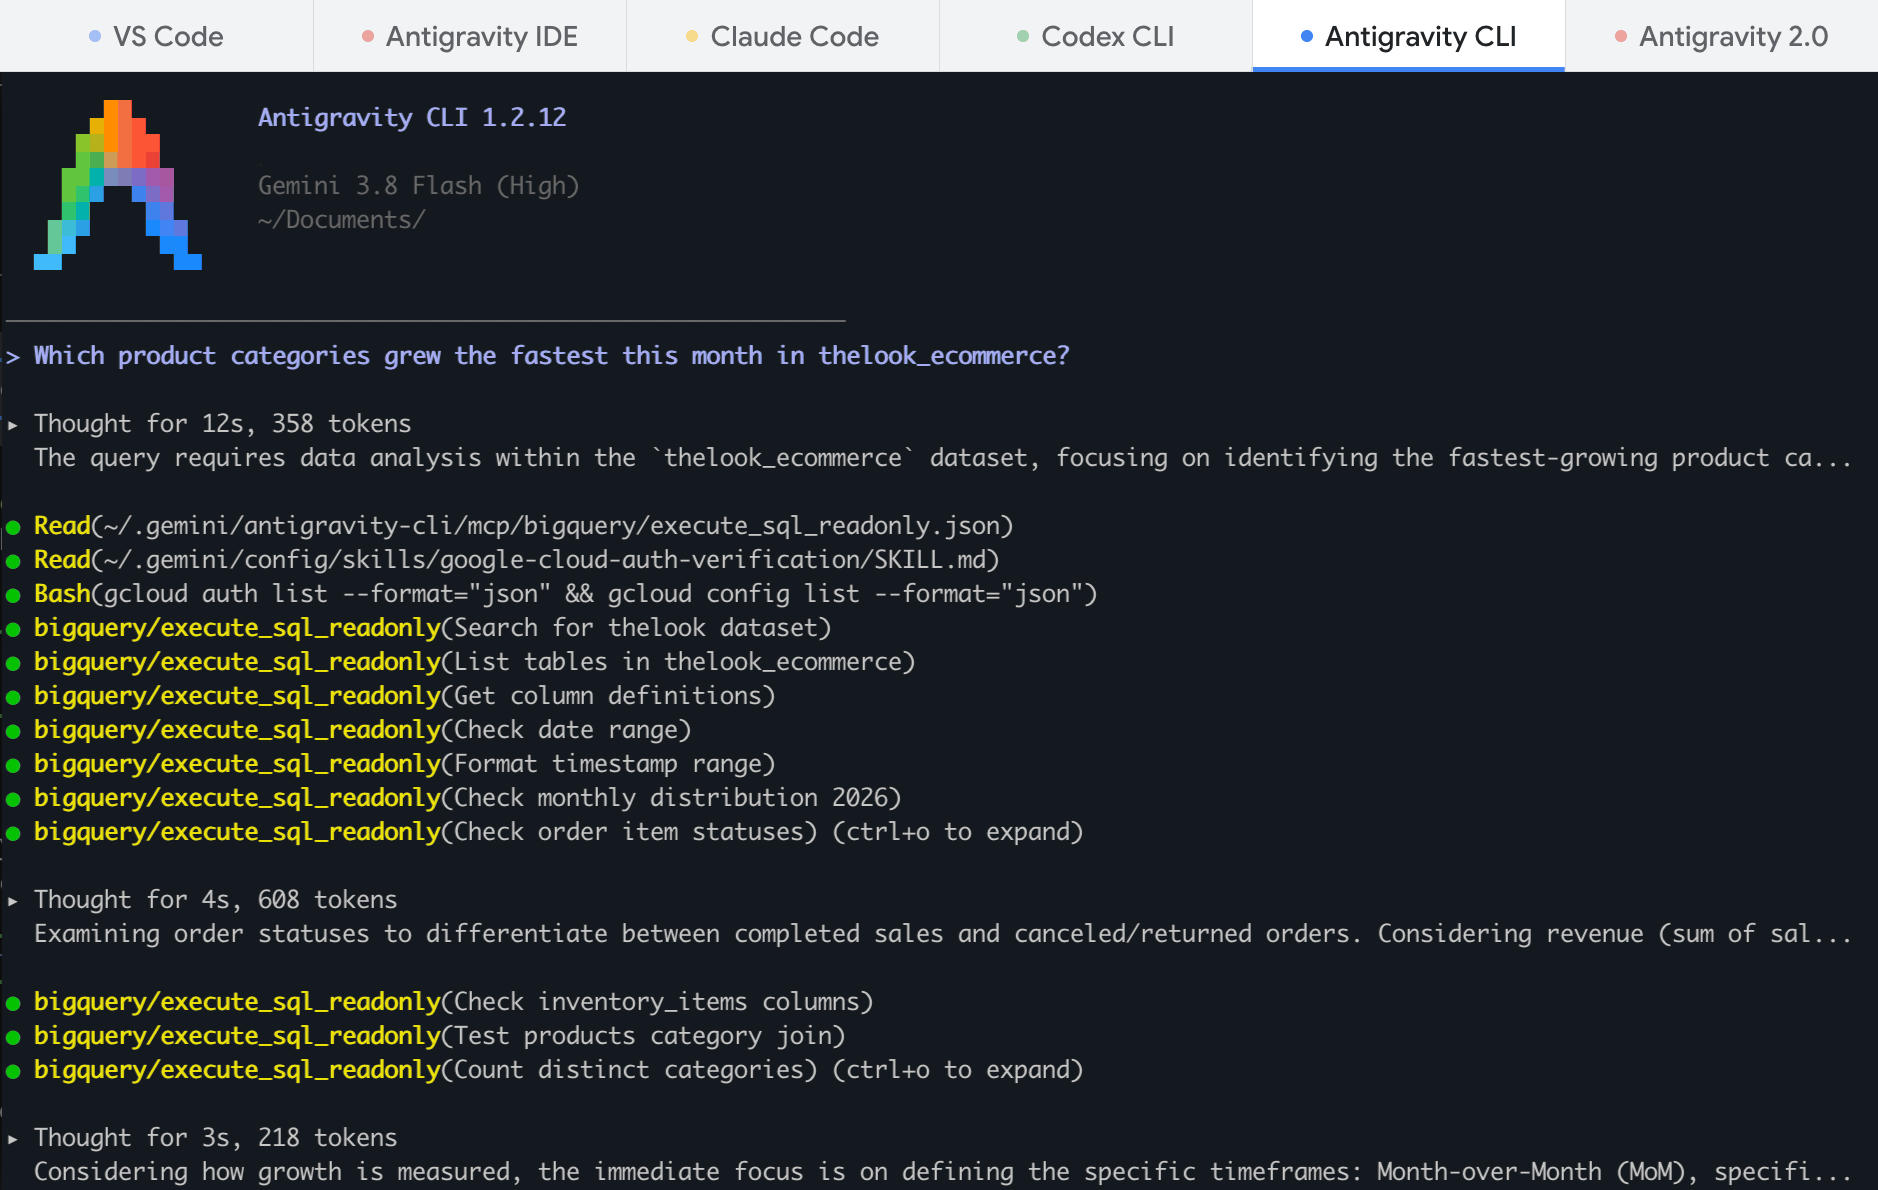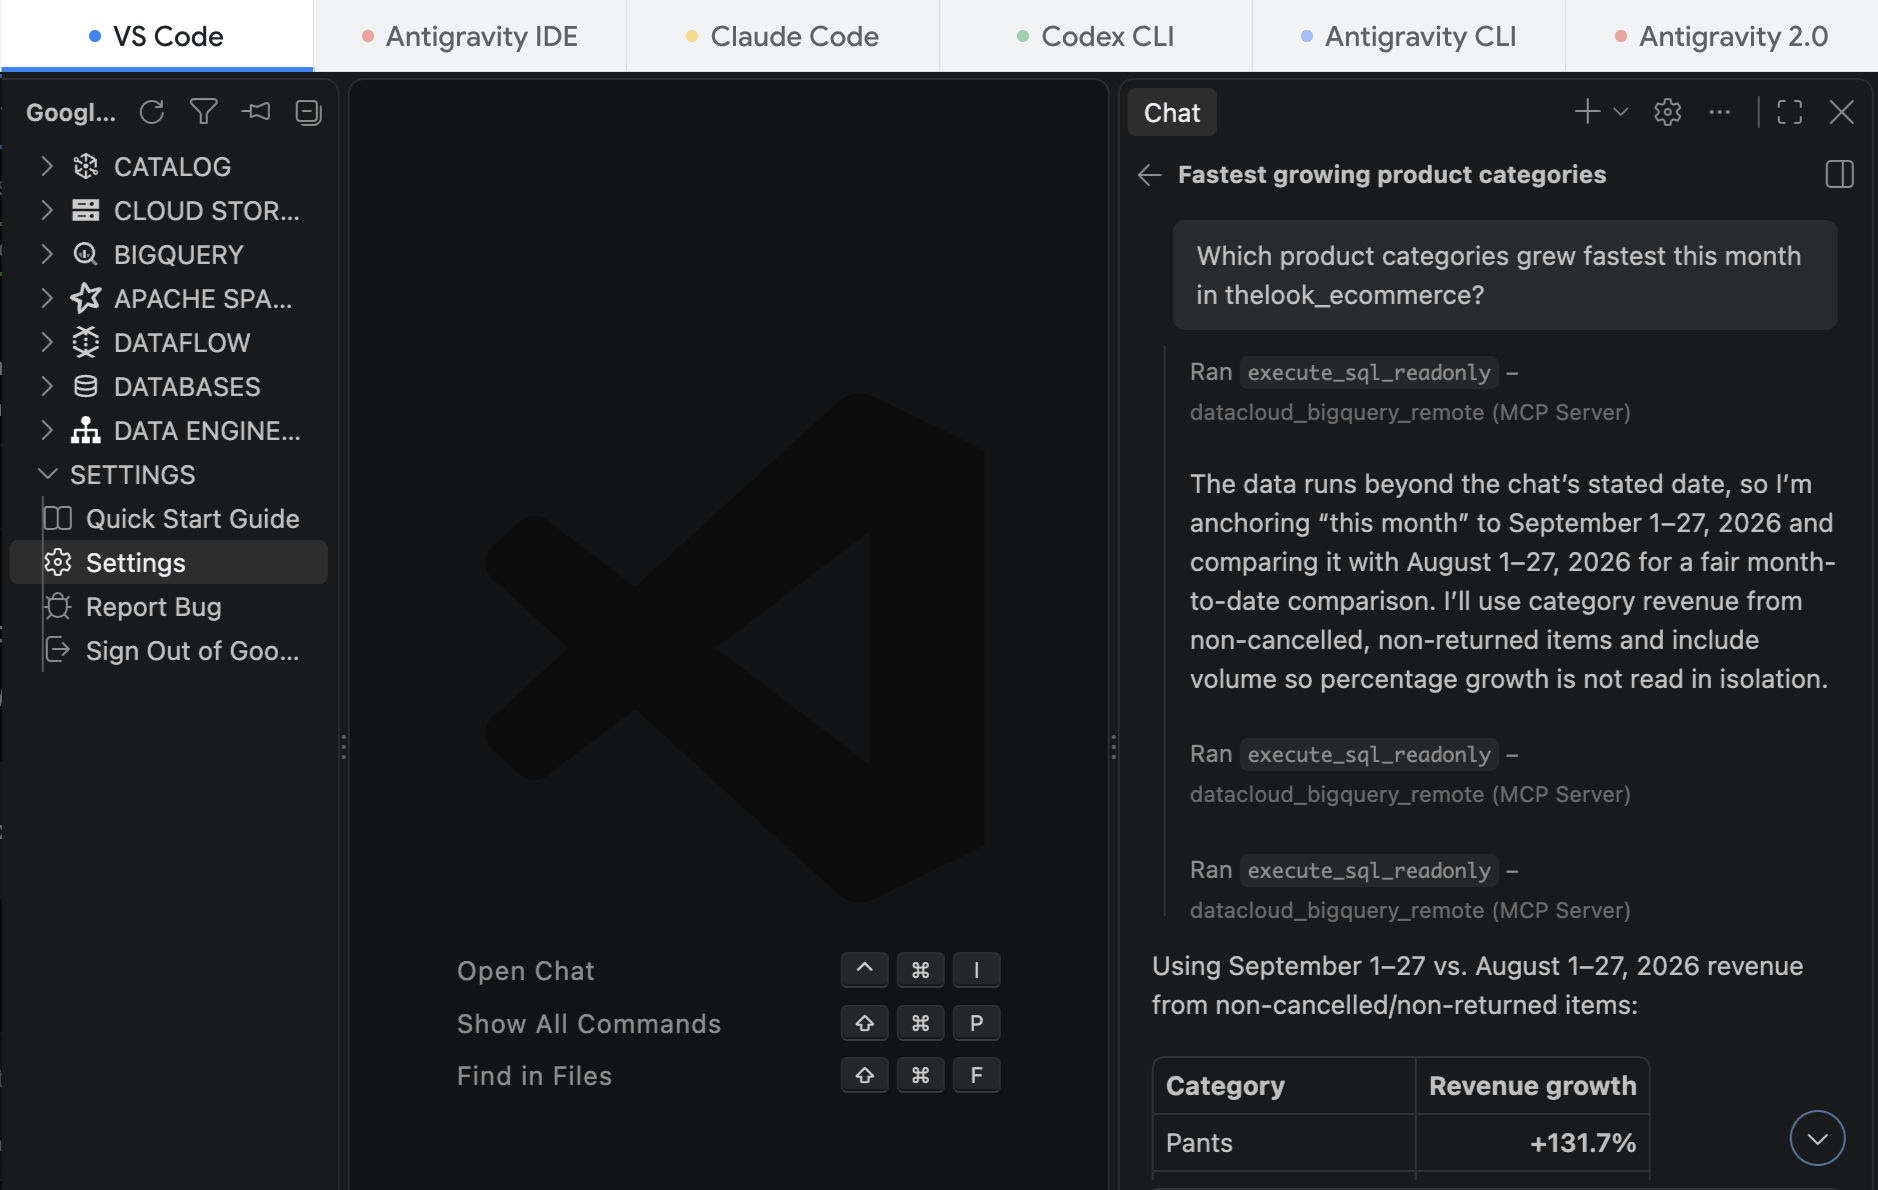
そして最初のプロンプトとして、次を入力します:
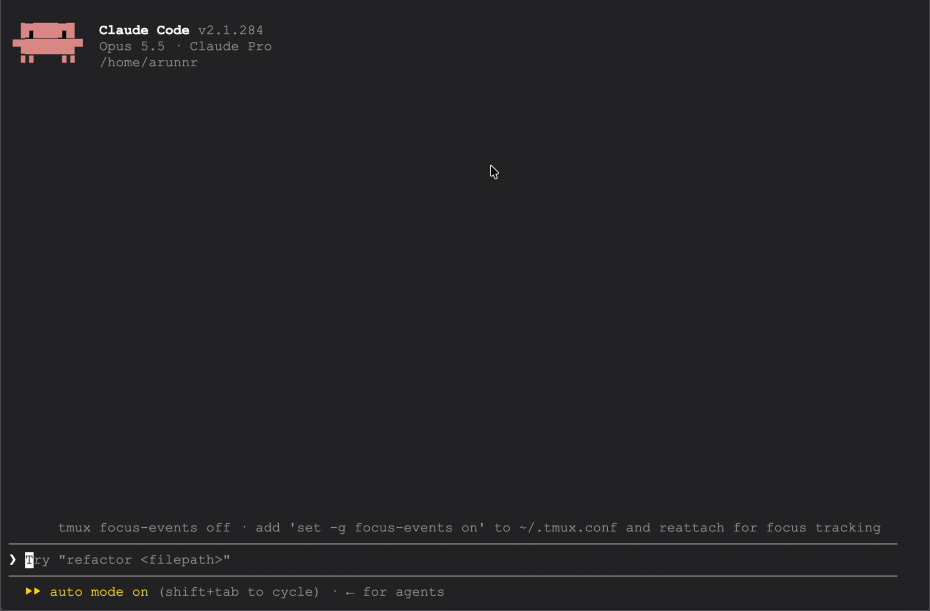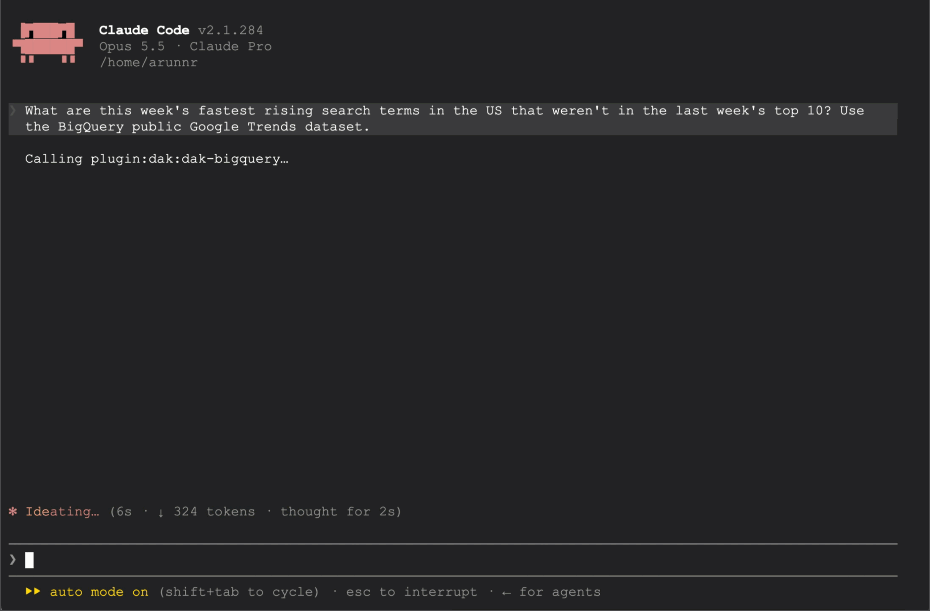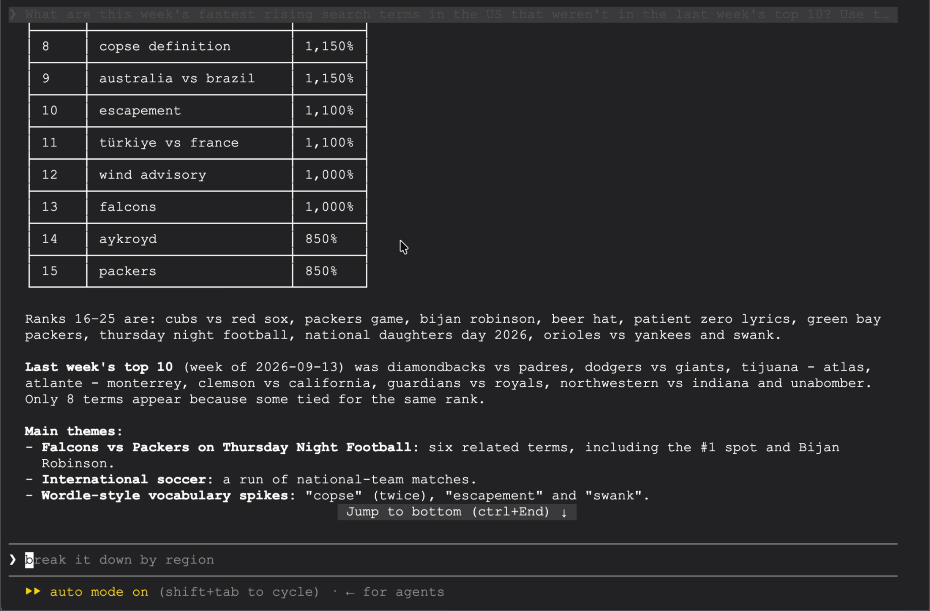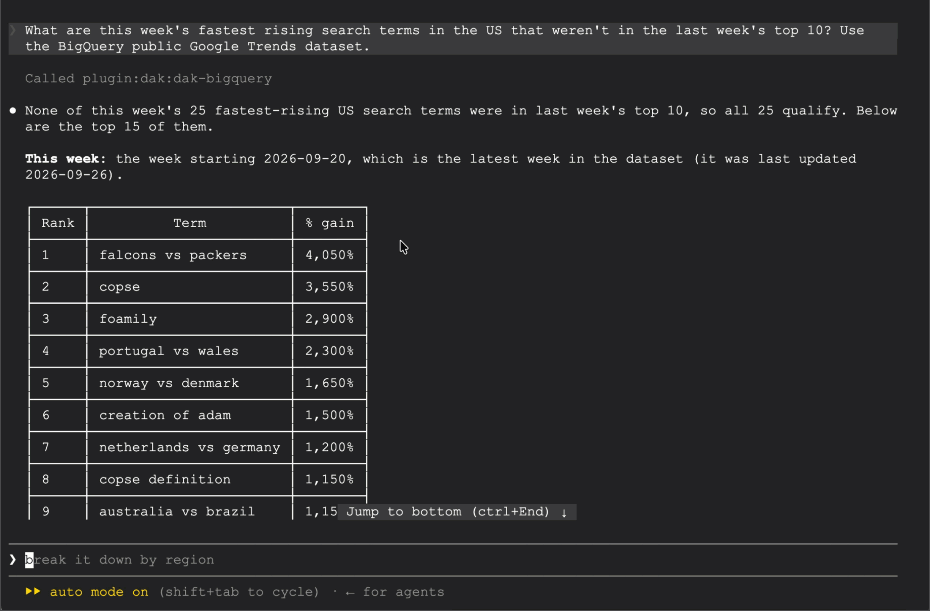
Claude Code で実行されている Data Agent Kit プラグイン。
次のステップとハンズオン リソース
-
ドキュメントを読む: Data Agent Kit のドキュメントとプロダクトの概要ページをご覧ください。
-
スキルを試す: GitHub でスキルを閲覧、スター付け、貢献する。
-
分析ワークフローを構築する: Data Agent Kit と Antigravity IDE を使用した分析の Codelab をお試しください。また、関連ブログ記事 Data Agent Kit でエージェントを駆使した問題分析もご覧ください。
-
データ サイエンス パイプラインを構築する: Data Agent Kit と Antigravity IDE を使用した不正行為検出パイプラインの Codelab をお試しください。
- Google、プロダクト マネージャー Arun Nair
- Google、デベロッパー アドボケイト、Jeff Nelson