強化学習(RL)による Gemini モデルのカスタマイズに関するベスト プラクティス ガイド
Jiaqi Pan
Senior Software Engineer, Google
Kunal Jha
Senior Product Manager, Google
※この投稿は米国時間 2026 年 9 月 26 日に、Google Cloud blog に投稿されたものの抄訳です。
強化学習(RL)は、最新の LLM の事後学習の重要な要素となっていますが、大規模なトレーニング クラスタと、Gemini のような独自モデルでは外部の顧客がアクセスできないモデル内部へのアクセスを必要とします。そこで、Google Cloud は、これをマネージド RL ファインチューニング サービス(RLFT サービス) としてパッケージ化しました。お客様はプロンプトと報酬関数を用意するだけで、インフラストラクチャと独自モデルの内部は Google が処理します。
このサービスを使用すると、固定されたラベル付き回答セットではなく、定義した報酬シグナルに基づいてモデルに学習させることで、Gemini をサービスに適応させることができます。これにより、教師ありファインチューニング(SFT)では対応が難しい問題、つまり、実証は難しいものの、スコア付けは容易なタスクを解決できるようになります。
このガイドでは、RL ファインチューニング サービスを使用するための実践的なベスト プラクティスについて説明します。まず、RL トレーニング ループの概要、RL を使用するかどうか、いつ使用するかを判断する方法、このアプローチから最大限の価値を引き出す方法について説明します。
RLFT とは
RLFT は、ラベル付きの回答ではなく、定義した報酬シグナルに基づいて Gemini を調整します。大量のゴールド サンプルを作成する代わりに、回答をスコア付けするプログラムを 1 つ作成し、サービスがそれに基づいてモデルを改善します。これにより、実証は難しいが検証は容易なタスクを解決できるようになります。たとえば、すべてのスキーマに対して理想的な SQL を手動で記述することはできませんが、クエリを実行して結果を確認することはできます。
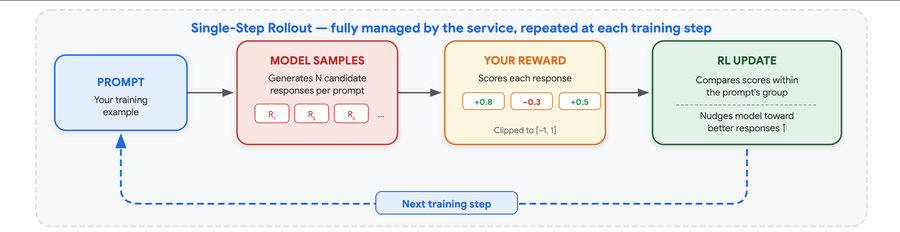
各トレーニング ステップで、サービスはプロンプトに対して複数の回答候補を生成し、報酬でスコアを付け、元の Gemini に近い状態を維持しながら、スコアの高い回答が生成される可能性が高くなるようにモデルを改善します。これを可能にする強化学習はフルマネージドであるため、構成する必要はありません。あなたがコントロールし、結果を最も左右するものは、報酬です。
RLFT でできることとできないことは、次の 3 つの特性で定義されます。
-
モデル自体の出力から学習する: 外部のターゲットをコピーするのではなく、モデルがすでに生成したものを改良するため、SFT よりも無関係な機能を損なう可能性が低くなります。
-
経路ではなく結果に報酬を与える: 良い結果に到達した回答には報酬が与えられます。これは、有効な解決策が多数ある自由回答形式のタスクに適しています。
-
既存の能力を増幅する: たまにしか起きない成功を確実に再現できるようにしますが、モデルが一度も実証したことのないスキルを教えることはできません。
RLFT を使用する状況
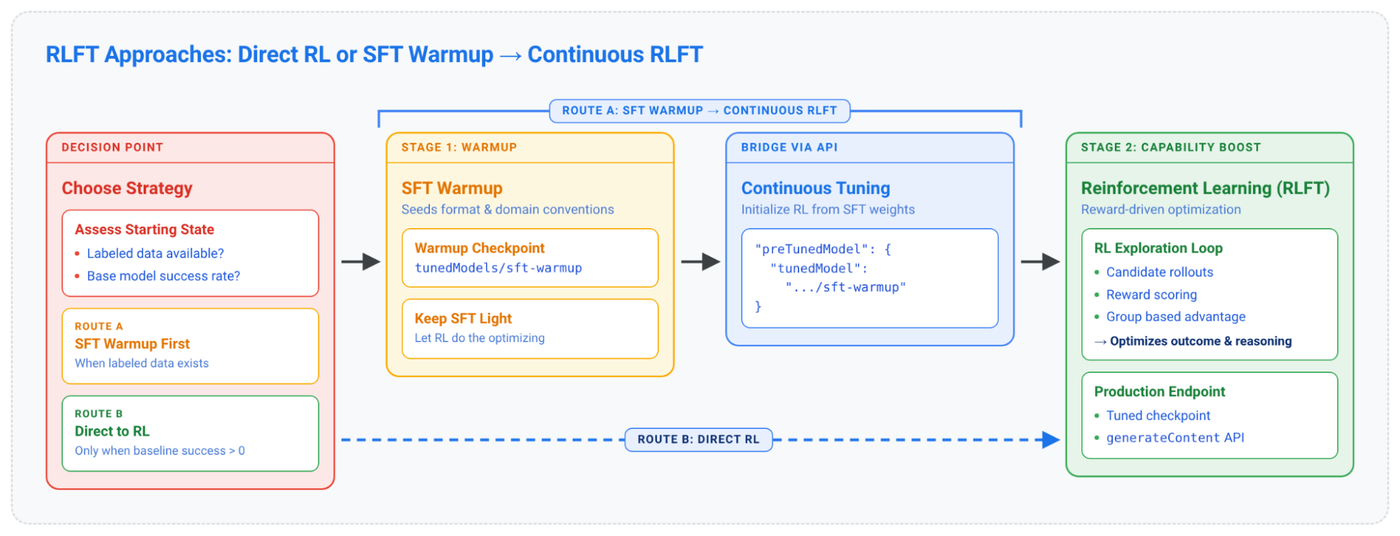
プロンプトと SFT でほとんどの適応に対処できるため、まずはこれらを試してください。RLFT がその価値を発揮するのは、回答を評価できるが、安価に作成できない場合、重要な指標(忠実性、スキーマの有効性、トーン)で SFT が頭打ちになった場合、またはタスクに等しく有効な回答が多数あり、単一の参照ターゲットでは誤ってペナルティが課される場合です。
SFT と RLFT は競合するものではなく、補完的なものです。
-
直接 RLFT: ベースモデルがすでに時々成功している場合(報酬によってより良い回答とより悪い回答が区別される程度)。
-
SFT → RLFT の 2 段階: SFT データがある場合、またはベースの成功率が低すぎて RL が軌道に乗らない場合。SFT を短時間の安価なウォーム スタートとして使用します。デモンストレーションを過学習させると RL による改善の余地が少なくなるため、SFT は軽めにとどめておきます。その後、SFT チェックポイントから RL を初期化する継続的チューニングを介して RL に移行します。
先行ユーザーの間では、これらのパターンは RLFT が最も価値を発揮する領域であることが示されています。いずれのパターンでも、企業が重視するものの、安価に実証できなかった成果を RLFT でスコア付けしています。
RLFT のユースケース
ゲーム内の AI を活用した NPC
-
内容: 多言語対応でマルチターンの長い会話で、キャラクターやブランドにふさわしい対話が展開される。
-
問題: 既製のモデルでは、言語の誤り、ハルシネーションにより生じたアイテム、プレーヤーの無視、繰り返しのループなどにより、没入感が損なわれる。
-
目標と報酬: Gemini 自動評価ツール(LLM-as-a-judge)が、ペルソナ、フロー、ゲーム状態のシンタックスに基づいて各ターンをスコア付けし、形式や言語のエラーにペナルティを課す。
-
結果: ループと言語のドリフトが解消され、状態のシンタックスが維持されたことで、ゲーム内のキャラクターを大規模にリリースすることが現実的なものになりました。
構造化されたエンティティの抽出
-
内容: サプライヤーの請求書や出荷明細書などの非構造化ドキュメントから一連の項目を抽出し、構造化レコードに自動的に変換する。
-
問題: SFT が頭打ちになるロングテール。必要なフィールドが見落とされている(再現率)か、存在しないフィールドが捏造されている(適合率)。
-
目標と報酬: ルールベースの適合率 / 再現率の報酬を使用して、各フィールドがソーステキストにグラウンディングされるようにして、1 つの正解から模倣されないようにする。
-
結果: チューニングが停滞していたノイズの多い実社会のドキュメントに対して、フィールド レベルの精度が向上し、手動によるレビュー手順を自動化できました。
コンテンツ管理
-
内容: 複雑なポリシーとディシジョン ツリーを大規模に適用する。
-
問題: モデルのハルシネーションによる偽陽性や、無効な形式で評価を避けようとする報酬ハッキング。
-
目標と報酬: Cloud Run の報酬を使用して、形式の検証と決定論的な採点ツールを組み合わせて、複数ステップのポリシー遵守を強制する。
-
結果: モデルが複雑な免除措置を処理し、偽陽性を大幅に削減し、報酬ハッキングを阻止したことで、管理費用を増加させる人間へのエスカレーションの量が減少しました。
実行によって測定されるコード
-
内容: 顧客データに対して実際に実行されるかどうかに基づいて評価される SQL または API 呼び出し。
-
問題: SFT が 1 つの参照クエリを模倣し、未知の独自スキーマに対して機能しない。
-
目的と報酬: コード実行の報酬を使用して、安全なサンドボックスでコードを実行し、コンパイル、実行を経て、正しい結果が返された場合にのみ報酬を与える。
-
結果: モデルは、クローズド フロンティア品質の実行可能なクエリを最初の試行で生成し、推論コストを削減しました。これにより、技術者以外のユーザーも自然言語で独自のデータをクエリできるようになりました。
HTML によるプレゼンテーション スライドの生成
-
内容: HTML / CSS で作成された複数スライドの資料。
-
問題: テキストのみでトレーニングすると、視覚的な品質が無視されるため、オーバーフロー、要素のクリッピング、一貫性のないスタイル設定などが見過ごされる。
-
目標と報酬: コード実行の報酬を使用して、スライドをレンダリングし、ビジュアル デザイン、レイアウトの整合性、構造の完全性、評価基準の遵守をスコア付けする。
-
結果: モデルは、テーマに一貫性があり、レイアウトのオーバーフローがない、モジュール化された、適切なスタイルのスライドを出力しました。
どこから始めるべきか
-
データセット。最初の実行には、検証用として取り分けたデータを含む、多様なプロンプトのセットで十分です。ループが収束し、報酬が期待どおりに推移していることを確認してから、スケールします。トレーニングと評価は厳密に分けるようにしてください。評価が汚染されると、過学習が見落とされてしまいます。
-
報酬関数。コードまたは構成としてのタスク仕様であり、品質を左右する重要な要因。優れた報酬は、人間の好みに相関し、不正な出力に対して堅牢であり(解析の失敗をキャッチし、クラッシュすることなく、明確に否定的なスコアを返します)、報酬ハッキングに耐性があります。具体的には、複数の評価を組み合わせ、長さへのペナルティを課し、異常な出力への下限を設定し、モデルの意見よりも検証可能なチェックを優先します。リリース前にオフラインで検証してください。
残りはサービスが処理します。デフォルト設定から開始し、コンソールで報酬と評価の曲線を確認して、最後の段階ではなく、検証報酬が頭打ちになった時点のチェックポイントを使用します。
使ってみる
あなたは何を構築しますか?そのために必要なツールがここにあります。
- Google、シニア ソフトウェア エンジニア、Jiaqi Pan
- Google、シニア プロダクト マネージャー、Kunal Jha