KDDI のコンシューマー向け RAG アプリ「Buffmee」: 高速化と信頼性向上を実現した舞台裏
Junichi Kashino
Platform Business Strategy Department, KDDI
Miki Katsuragi
AI Consultant, Google Cloud Japan
※この投稿は米国時間 2026 年 9 月 9 日に、Google Cloud blog に投稿されたものの抄訳です。
消費者向けの生成 AI アプリケーションを構築する際、多様なメディアタイプにわたって高い生成品質と高速な応答時間を両立させることは困難な場合があります。日本の大手通信事業者である KDDI は、消費者向け検索拡張生成(RAG)アプリ「Buffmee」を開発する際、この課題に正面から取り組みました。
Buffmee は、「成長をサポートする AI」というコンセプトに基づいて構築されたインタラクティブな AI サービスです。書籍、雑誌、ウェブメディアなど 100 以上のソースに基づいて回答を生成することで、ユーザーが情報を検索したり、要点をまとめたり、パーソナライズされた学習や趣味の対象を探求したりするのを支援します。Buffmee は情報源を引用することで、情報の信頼性に関する懸念を軽減し、ユーザーが安全に知識を深められるようにしています。この問題に対して、KDDI は開発パートナーとして KDDIアイレット、Google Cloud Consulting および専門 AI チームと協業で取り組みました。
アプリのリリースの一環として、エンジニア チームは書籍や雑誌など、多種多様な独自コンテンツを、AI の回答根拠とする「グラウンディング」の準備を整える必要がありました。しかし同社は、レイテンシの問題により目標の応答時間を達成できなかったほか、ハルシネーションを排除した結果を確実に得るための信頼できる手法を必要としていました。
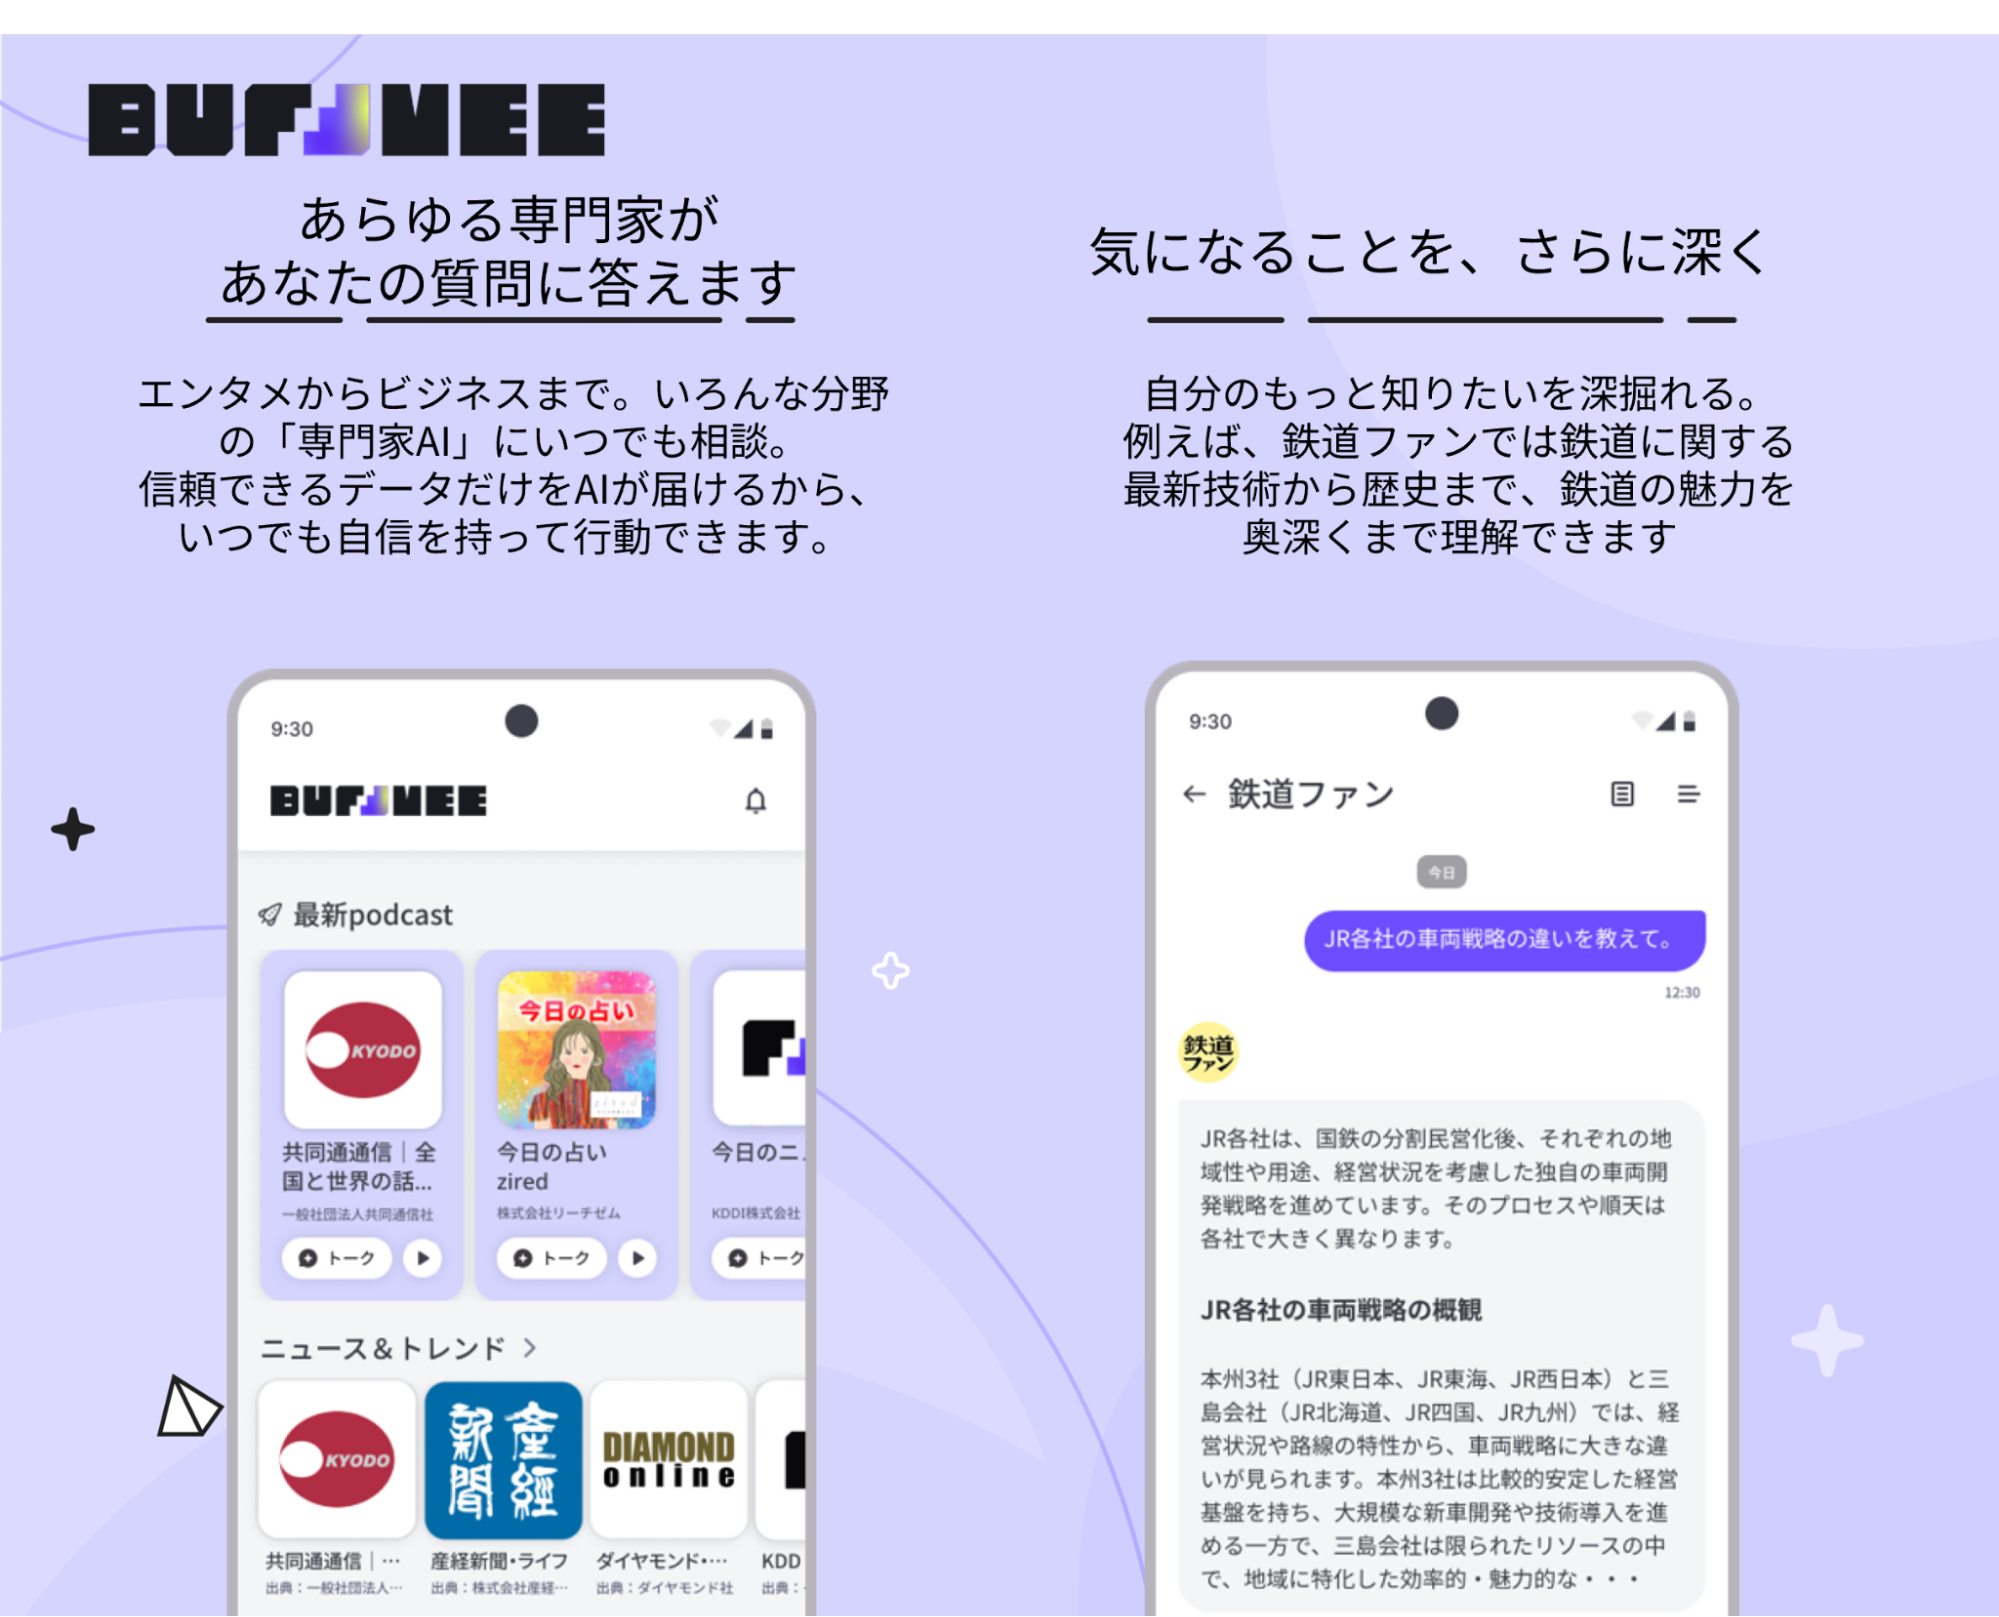
Buffmee アプリの説明と画像
こうしたパフォーマンス目標を達成するには、組織には AI 評価を実施してリアルタイムのボトルネックを特定するための体系的なアプローチが必要です。そこで、KDDI がこのアプリケーションをリリースするのに役立った自動評価フレームワークとパフォーマンス最適化手法をご紹介します。
これらは素晴らしい結果をもたらしました。KDDI はアプリケーションの合計レスポンス レイテンシを 38% 削減し、目標のレスポンス パフォーマンスを達成しました。また、TTFT も 18% 近く改善しました。
「私たちのビジョンは、コンテンツを取り込んですぐに RAG システムとして機能するプラットフォームを構築することでした。Google の丁寧かつ実践的なガイダンスのおかげで、それを実現できました。Google のサポートに心から感謝しています。」- KDDI、AI プロダクト部、小野田 隼也 氏
パフォーマンスと精度の向上により、Buffmee はユーザーがインタラクティブな Q&A や詳細な分析を通じてお気に入りのメディアを安全に探索できるようになりました。このように、コンテンツ プロバイダの信頼性とコンプライアンスを厳格に維持しながら、高度にパーソナライズされたエクスペリエンスを実現しています。
同社がどのようにこれらの成果を達成したのか、詳しく見ていきましょう。
多様なコンテンツの自動評価を確立する
従来の手動テストは多大な労力を必要とし、大規模なコンテンツ ライブラリに対応するよう拡張することはできませんでした。この問題を解決するため、開発チームは Gemini Enterprise Agent Platform Evaluation Service を使用して、体系的な AI 評価プロセスを設計しました。
LLM-as-a-Judge や Rule of Hundreds(100 の法則)などの自動評価フレームワークを実装することで、チームは手間のかかる手動テストをデータドリブンなプロセスに置き換えました。同社は、膨大なドキュメント コーパスを取り込み、数百の自動評価テストを構築し、各ユースケースの回答の信頼性を測定するための包括的なベンチマーク データセットを構築しました。チームはその結果、根拠性スコアを 25% 高め、高精度で信頼性の高い出力を提供できるようになりました。
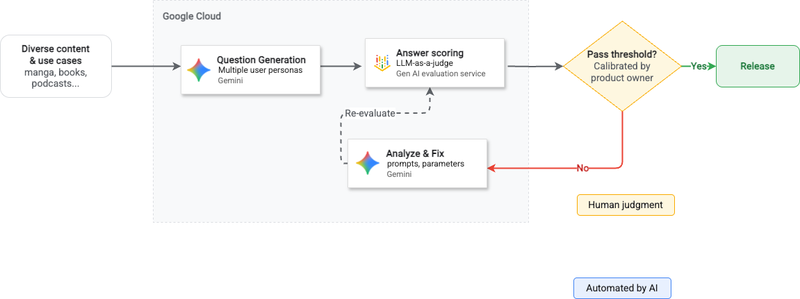
KDDI の自動評価ループ: 評価用 AI が回答をスコアリングし、人間が実際に生成結果を検証して合格ラインとなるしきい値の設定やエラー分析を実施。
エージェント ループでボトルネックを特定し、パフォーマンスを最適化する
応答速度を向上させるため、チームは BigQuery Agent Analytics と Agent Development Kit(ADK)ログ分析エージェントを実装しました。実際のプロダクション ログを分析することで、スキルの分割とプロンプトの肥大化(特に、非常に複雑な複数ページのシステム プロンプトの場合)が、最初のトークンまでの時間(TTFT)にどのように影響するかを可視化しました。
チームは、スキルのインライン統合を含むシステム プロンプトを最適化し、サブエージェントのルーティングを見直しました。これにより、回答の精度を維持したまま、複雑に組み合わさったシステムのボトルネックをリアルタイムで特定して解決できました。
信頼性の高い評価のための 4 つの基本原則
これらの結果を得るために、チームは 4 つの主要な技術的手法を実施しました。
-
バイナリ評価への移行: 重要な指標について、曖昧な 1~5 の評価からバイナリの「合格(1) / 不合格(0)」システムに選択的に移行することで、チームはばらつきとノイズを最小限に抑え、自動化の精度を向上させました。
-
戦略的なコンテンツ サンプリング: すべてのドキュメントを評価しようとするのではなく、チームはコーパス全体を 2 次元グリッドに沿って分類しました。それらの軸は、ファイル形式(ウェブ記事、EPUB、PDF、構造化データ)とメディア構成(テキスト中心、画像中心、混合)です。この難易度グリッドの各セルから代表サンプルを選択することで、包括的なテスト範囲を維持しながら、評価のワークロードを 75% 削減しました。
-
プロダクト判断に基づくしきい値: プロダクト オーナーは、デフォルトのツール パラメータのみに依存するのではなく、ランダムにサンプリングされた回答と自動スコアを突き合わせて検証しました。これにより、ユーザー エクスペリエンスの観点から「リリース基準を満たす品質とは何か」を具体的に定義し、評価のしきい値を調整および確立しました。
-
大規模なプロンプトを ADK スキルにモジュール分割: 800 行を超える大規模なシステム プロンプトは、LLM の指示の見落としやレイテンシの低下を引き起こす可能性があるため、チームはプロンプトを機能ごとに Agent Development Kit(ADK)スキルに分割し、必要なロジックのみを動的に読み込んでレスポンス時間を最適化しました。
使ってみる
スケーラブルで信頼性の高い生成 AI アプリケーションを構築するには、自動評価と詳細なパフォーマンス分析の両方が必要です。これらの手法を独自のアプリケーションに適用するには、次の手順を行います。
-
Gen AI Evaluation Service で品質を体系的に測定する
-
Agent Development Kit を使用してエージェントを構造化し、段階的な開示を慎重に適用する
-
エージェント検索でエージェントをグラウンディングし、検索クエリを検査する
- KDDI、プラットフォーム ビジネス企画部、樫野純一氏
- Google Cloud Japan、AI コンサルタント、葛木 美紀