Google TPU を Oracle Cloud Infrastructure に導入
Karan Batta
Senior Vice President, Oracle Cloud Infrastructure
Gurmeet Goindi
Sr. Director, Product Management
※この投稿は米国時間 2026 年 10 月 28 日に、Google Cloud blog に投稿されたものの抄訳です。
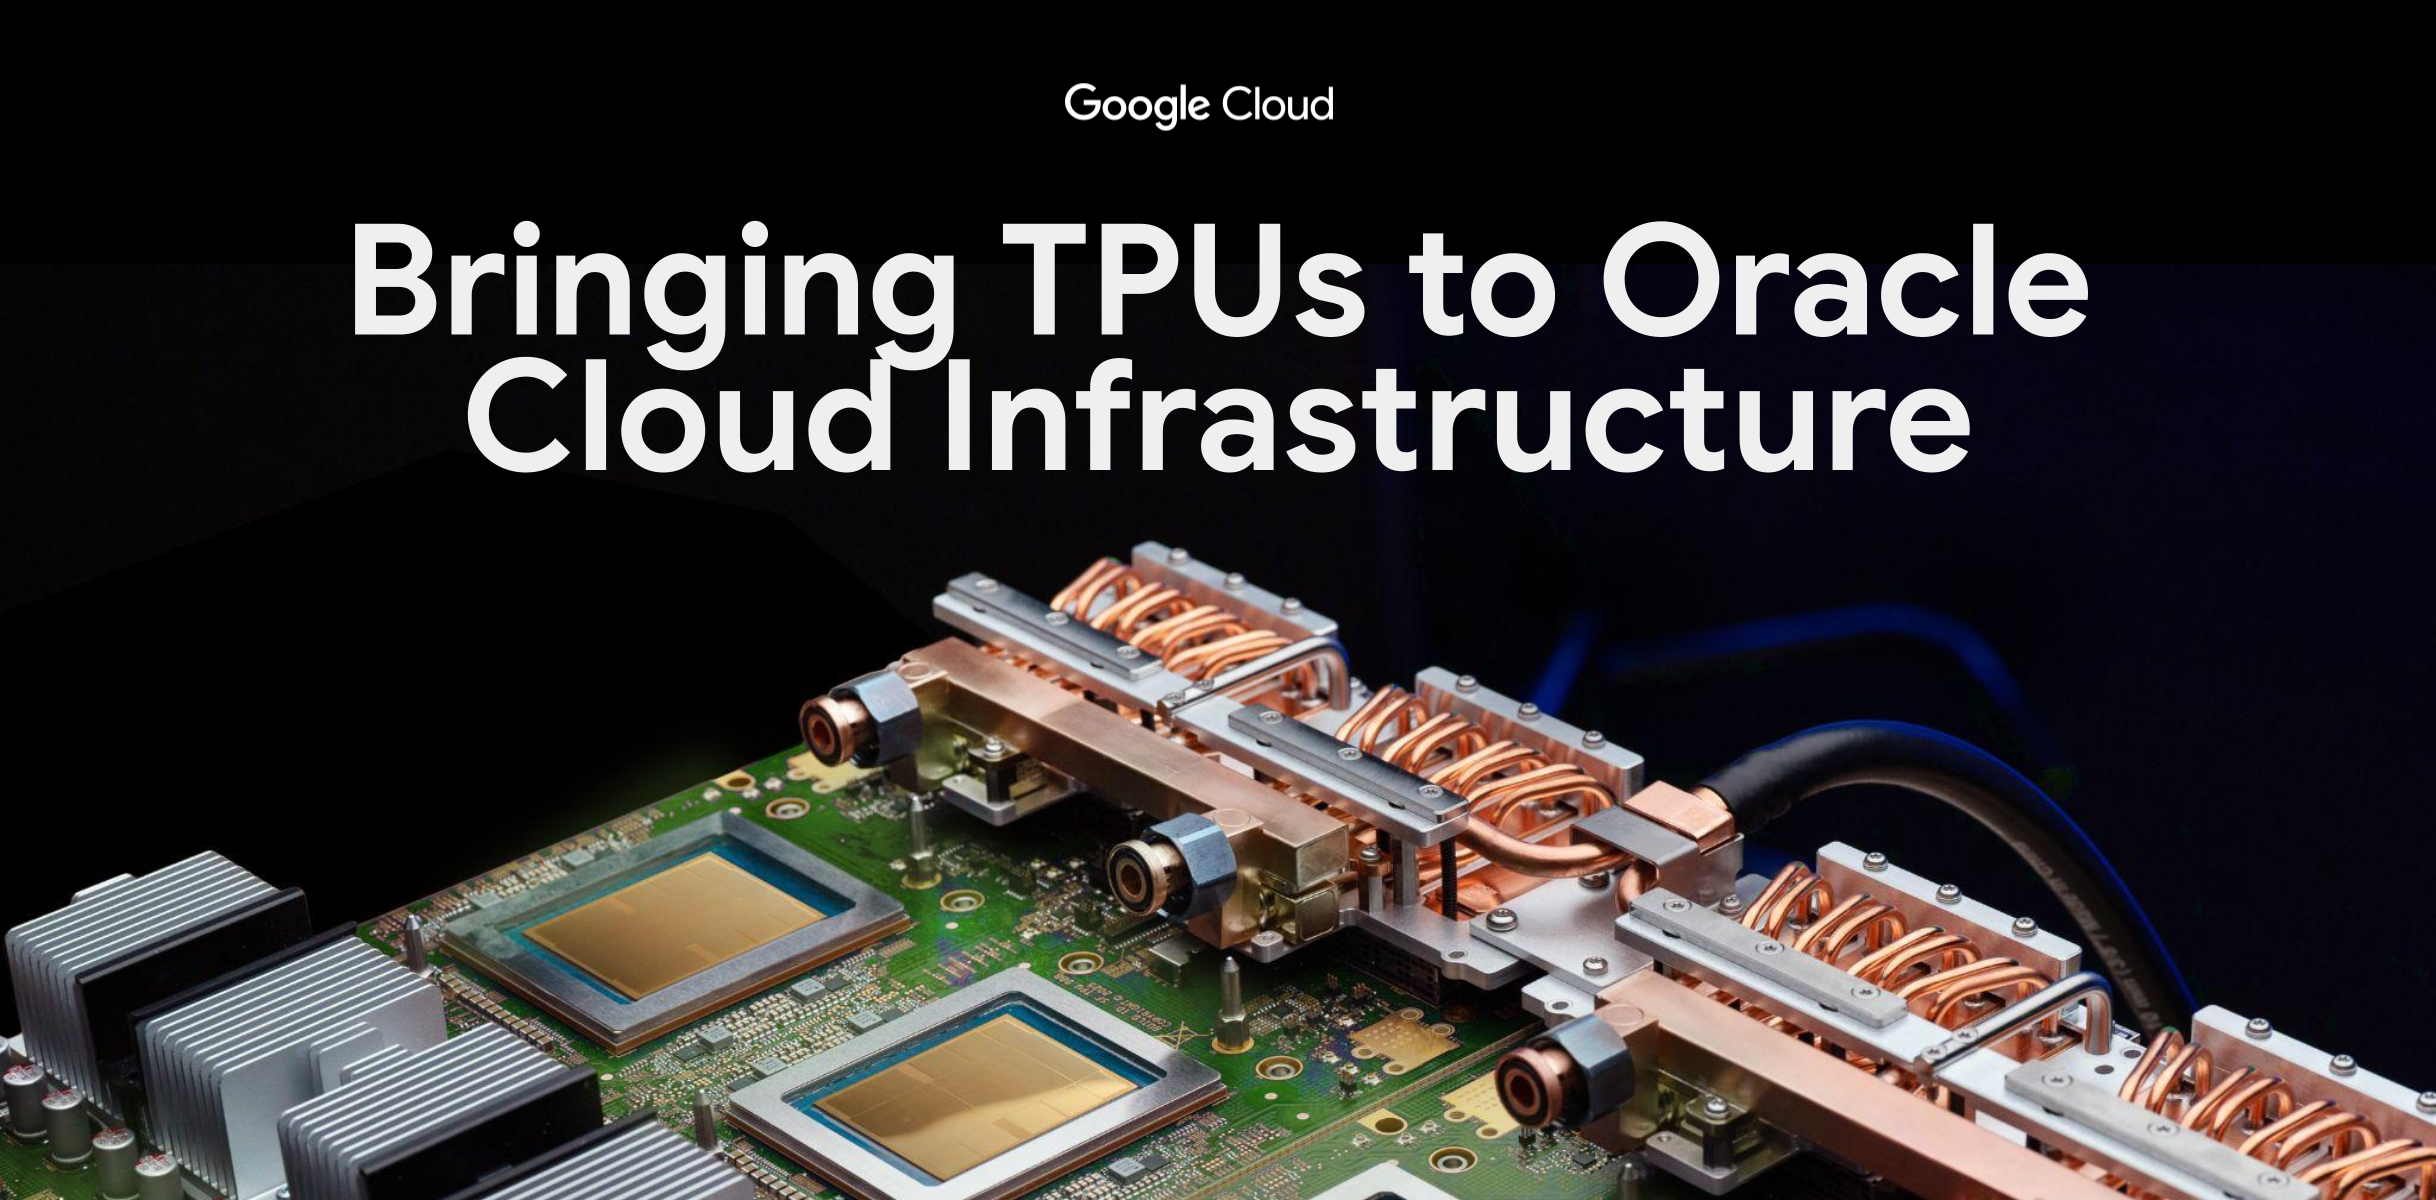
AI ワークロードがあらゆる業界で拡大するなか、企業や組織は AI ライフサイクル全体においてスループット、レイテンシ、ユニット エコノミクスを最適化するコンピュート オプションを必要としています。この需要に応えるため、Oracle と Google Cloud はパートナーシップを締結し、Google Tensor Processing Units(TPU)を Oracle Cloud Infrastructure(OCI)に導入します。これにより、OCI は Google 以外で TPU を提供する初のハイパースケーラーとなります。両社は、2027 年より OCI 上で TPU キャパシティのデプロイを開始する予定です。
TPU: シリコンからソフトウェアまでを統合設計
Google は 10 年以上前に、明確なプロダクト コンセプトに基づいて最初の TPU を開発しました。そのコンセプトとは、カスタム シリコンを光ネットワーキング、電力供給、液体冷却、コンパイラ ソフトウェアとともに統合設計することで、個別のコンポーネントでは実現できないワットあたりのパフォーマンス向上と総所有コストの削減をもたらすというものです。
TPU v1 は、当時のプロセッサと比較して 30 倍のワットあたりスループットを実現しました。現在、TPU は 10 億人規模のユーザーを抱える Google のサービス全体で Gemini のトレーニングとサービングを行っています。第 8 世代の TPU は、チップあたり最大 12.6 PFLOPS のネイティブ FP4 演算を実現し、前世代より最大 2 倍高いワットあたりパフォーマンスで、TPU v1(92 TFLOPS)の 100 倍以上となる性能を達成しています。ただし、トレーニングと推論におけるお客様の費用対効果を決定するのは、単なる FLOPS 数値だけではありません。トレーニングにおける主要な指標はグッドプットです。これは、クラスタが有効な演算に費やした時間の割合を指します。一方、推論における主要な指標は、レイテンシとトークンあたりのコストです。TPU は、システムレベルの統合設計によってこれら両方の課題を解決します。
オンダイの Inter-Chip Interconnect(ICI)ルーティングと光サーキット スイッチング(OCS)を組み合わせることで、コントロール プレーンがハードウェアやリンクの劣化を検出し、ジョブを再起動することなく、リアルタイムで障害を回避して光パスを動的にルーティングします。これにより、大規模なトレーニング実行では数千のチップにわたって 97% 以上のグッドプットを維持し、本番環境のサービングで高可用性を確保します。オンチップ SRAM の増加、HBM 容量の拡大、ネットワーク ホップを 50% 以上削減する新しい低直径インターコネクト トポロジにより、最新世代の TPU は低レイテンシのサービングにおいて 1 ドルあたりのパフォーマンスを最大 80% 向上させます。
デベロッパーがこのハードウェア効率をスムーズに活用できる環境があってこそ、それがプロダクトの開発速度へと還元されます。PyTorch Conference での最近の発表は、Google TPU ソフトウェア エコシステムを PyTorch コミュニティ向けのオープンでデベロッパー フレンドリーな環境へと発展させる、Google のコミットメントをさらに強化するものです。特に、Google TPU 向けのネイティブ PyTorch スタックである TorchTPU が、GitHub でオープンソースとして利用可能になりました。vLLM、SGLang、llm-d、TorchTitan、Ray、TorchRec、Hugging Face、LiteRT など、すでに導入しているツールを使用して、TPU でモデルをトレーニング、サービング、デプロイできるようになりました。
このポータビリティにより、チームはモデルコードを書き直すことなく、トークンあたりのコストが最も低いアクセラレータや最も短時間でトレーニングできるアクセラレータに各ワークロードを自由に割り当てられるようになります。今回の発表を経て、まもなくこれらのワークロードを Google Cloud または Oracle インフラストラクチャにある TPU に割り当てることが可能になります。
OCI による AI インフラストラクチャ エコシステムの拡大
Google Cloud での TPU の採用が進む一方で、AI コンピューティングに対する世界的な需要は、単一のクラウド プロバイダの規模を上回っています。TPU を OCI に導入することで、お客様は 4 つの明確なメリットを得ることができます。
-
AI 密度に最適化されたデータセンター: Google の TPU システムは、ラック規模での直接液冷を想定して設計されており、OCI の次世代データセンターはまさにその仕様に合わせて構築されています。Oracle は、お客様の需要の変化に合わせて、フロンティア モデルのトレーニングと本番環境の推論を柔軟に切り替えられる、信頼性の高いキャパシティを提供します。TPU の効率性と Oracle の革新的な電力および冷却アプローチを組み合わせることで、エネルギー効率に優れた AI コンピュート キャパシティを、世界規模で迅速に稼働できるようになります。
-
Oracle Acceleron による安全で高性能なネットワーキング: TPU は ICI と OCS を介してチップ間のトラフィックを転送しますが、Oracle Acceleron は TPU キャパシティを OCI の他の部分に接続するネットワーキング基盤を提供します。Acceleron の SmartNIC は、ハードウェア レベルのテナント分離、高パフォーマンス ファブリック、ゼロトラスト パケット ルーティングを備えており、ホスト コンピュートの負荷を高めたり、セキュリティ境界を損なったりすることなく、Oracle データベース、ストレージ、TPU クラスタ間で高スループットかつ低レイテンシなデータ転送を実現します。
-
エンタープライズ データとの近接性: Oracle データベースは、多くの企業においてシステム オブ レコードの役割を果たしています。OCI 内で TPU を直接提供することで、組織は費用のかかるクロスクラウド転送を行うことなく、既存のエンタープライズ データの近くでファインチューニングと推論を行うことができます。
-
マルチアーキテクチャの選択肢: OCI 内で GPU とともに TPU を提供することで、チームは各 AI ワークロード ステージを費用対効果の面で最適なアクセラレータに柔軟に割り当てることができます。
Google TPU を Oracle Cloud Infrastructure に導入することで、Google Cloud と Oracle は、10 年以上にわたり培ってきた AI 専用システム エンジニアリングの成果を、より広範な開発者のエコシステムへ開放します。お客様がより多くのクラウドで専用コンピュートの選択肢を広げられるようになれば、業界全体で開発スピードが加速し、より効率的な運用が可能になります。皆様がどのようなものを構築されるのか楽しみにしています。
- Oracle Cloud Infrastructure、シニア バイス プレジデント、Karan Batta 氏
- プロダクト管理担当シニア ディレクター、Gurmeet Goindi