Google Cloud의 Lakehouse 런타임 카탈로그를 사용하여 Apache Hive를 현대화하는 방법
Vinod Ramachandran
Product Manager
Pratibha Suryadevara
Vice President
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
10년 넘게 Apache Hive Metastore (HMS)는 빅데이터 분석의 사실상 메타데이터 권한으로 사용되어 왔습니다. Hadoop 클러스터에 배포되었든 MySQL 또는 PostgreSQL을 기반으로 하는 자체 관리형 Compute Engine VM에 배포되었든 HMS는 Apache Spark, Presto, Hive가 원시 .parquet 및 .orc 파일을 쿼리할 수 있도록 하는 중앙 스키마 레지스트리를 제공했습니다.
그러나 엔터프라이즈 데이터 아키텍처가 페타바이트 규모로 확장되고 Google Cloud Managed Service for Apache Spark, BigQuery, Trino와 같은 여러 쿼리 엔진에 걸쳐 확장됨에 따라 기존 Hive Metastore는 종종 중요한 운영 병목 현상이 됩니다.
이 블로그에서는 기존 metastore가 에이전트 규모의 최신 클라우드 환경에서 어려움을 겪는 이유를 살펴보고, Google Cloud Lakehouse 서버리스 런타임 카탈로그가 어떻게 도움이 되는지 보여줍니다. 이 카탈로그는 작년에 소개되었으며, 개방형 Apache Iceberg REST 카탈로그 사양을 기반으로 빌드되어 실행 가능한 제로 데이터 복사 마이그레이션 솔루션으로, 프로덕션 Hive 테이블을 몇 분 만에 전환할 수 있도록 도와줍니다.
기존 Hive Metastore의 문제점
대규모 프로덕션 분석을 실행하는 데이터 엔지니어 및 인프라 리더와 대화할 때마다 독립형 Hive 메타스토어에서 다음과 같은 세 가지 핵심적인 문제점이 지속적으로 나타납니다.
아키텍처 및 확장 병목 현상
독립형 HMS 배포는 테이블 스키마, 파티션, 스토리지 위치를 추적하기 위해 관계형 데이터베이스 백엔드 (예: MySQL 또는 Postgres)에 의존합니다. 데이터 레이크가 수십만 개의 파티션을 나눈 테이블로 확장됨에 따라 파티션 가지치기 및 대량 나열 작업으로 인해 관계형 데이터베이스의 핵심 성능 병목 현상이 발생합니다. 파티션 메타데이터를 요청하는 복잡한 Spark 작업은 메타스토어 CPU를 100%까지 급증시켜 클러스터 전체의 쿼리 지연 또는 메모리 부족 (OOM) 오류를 유발할 수 있습니다.
사일로화된 ID 및 보안 거버넌스
기존 메타스토어는 경계 기반 Hadoop 보안 모델을 중심으로 설계되었습니다. Apache Spark 컴퓨팅 작업과 BigQuery와 같은 엔터프라이즈 SQL 엔진 모두에서 테이블 수준 ACL (액세스 제어 목록)과 같은 세분화된 최신 데이터 거버넌스를 적용하려면 두 개의 서로 다른 제어 평면에서 분산되고 중복된 보안 정책을 유지해야 합니다.
운영 오버헤드 및 총소유비용 (TCO)
고가용성 MySQL/Postgres 인스턴스 관리, HMS 데몬 패치, JDBC 연결 풀 조정, 유휴 인스턴스 기반 메타스토어 서버 비용 지불은 데이터 플랫폼팀에 불필요한 운영 부담을 야기하며, 이 팀은 에이전트를 위한 고효율 데이터 제품을 빌드하는 데 시간을 할애하는 것이 더 좋습니다.
해결책: Lakehouse 런타임 카탈로그
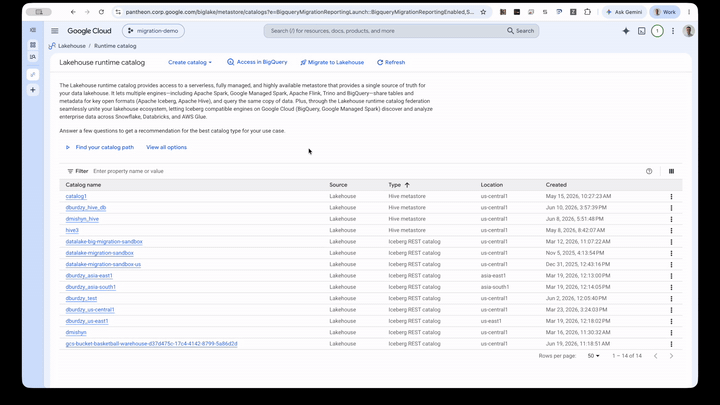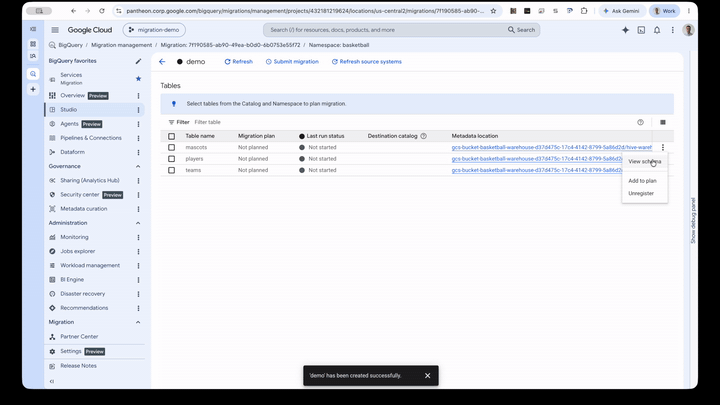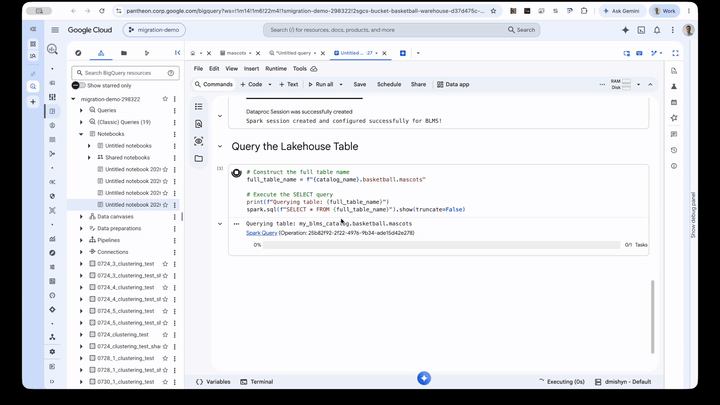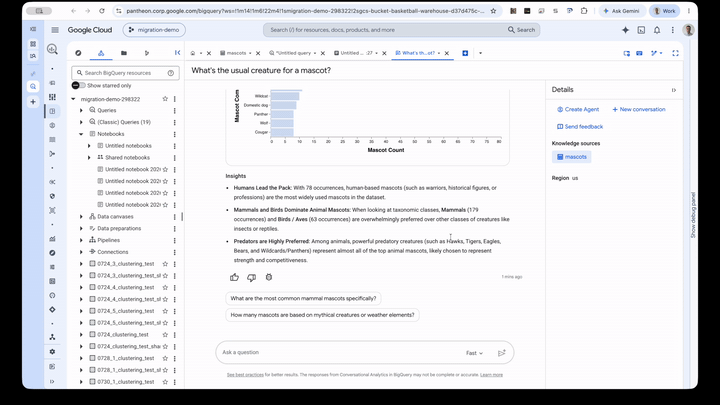
데이터 엔지니어가 페타바이트 규모의 기존 스토리지 페이로드를 다시 작성하지 않고도 이러한 아키텍처 병목 현상을 해결할 수 있도록 Iceberg REST 카탈로그와 Hive 카탈로그를 지원하는 Lakehouse 런타임 카탈로그를 빌드했습니다.
Lakehouse 런타임 카탈로그는 완전한 서버리스, 고가용성, 통합 메타데이터 레지스트리로, 기존 Hive/Parquet 테이블과 Apache Iceberg 같은 최신 개방형 테이블 형식을 모두 지원하도록 처음부터 설계되었습니다. Lakehouse 런타임 카탈로그는 Apache Iceberg REST 카탈로그 사양을 기본적으로 구현하여 메타데이터 검색을 컴퓨팅 엔진에서 분리합니다. 카탈로그와 컴퓨팅 엔진의 이러한 분리를 통해 여러 Iceberg 호환 엔진이 동일한 데이터에 제로 카피 방식으로 액세스할 수 있으므로 고객이 데이터의 여러 사본을 유지할 필요성이 줄어들고 워크로드를 더 빨리 프로덕션에 적용할 수 있습니다.
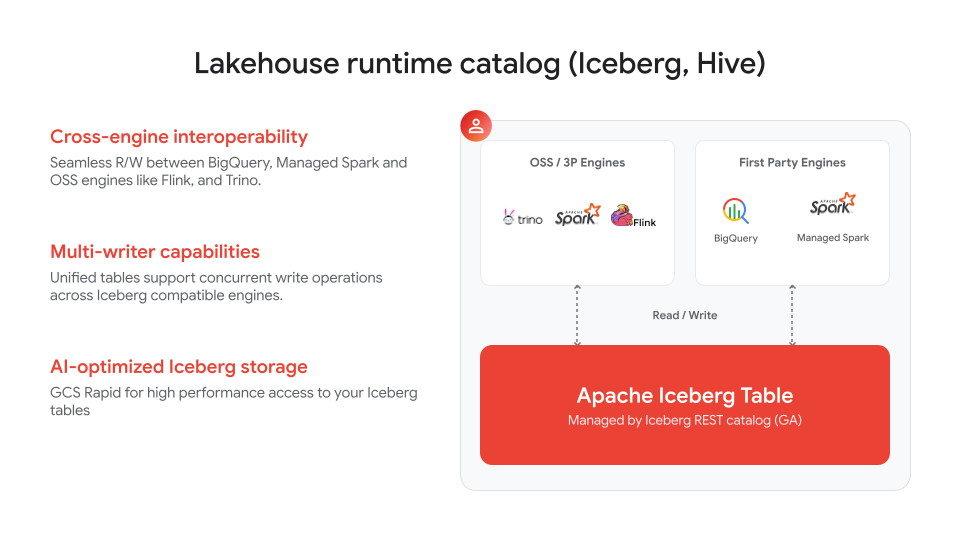
이 접근방식은 다음과 같은 여러 가지 아키텍처 이점을 제공합니다.
-
다중 엔진 상호 운용성: 등록된 테이블은 표준 REST 인터페이스를 통해 Google Cloud Managed Spark, BigQuery, 오픈소스 엔진에서 즉시 검색하고 쿼리할 수 있습니다.
-
개방형 API: Iceberg Rest Catalog와 Hive Catalog를 지원하므로 여러 팀이 단일 통합 데이터 세트에서 선호하는 분석 도구를 사용할 수 있습니다.
-
데이터 복사 없음: 테이블 정의가 Google Cloud Storage의 기존 데이터를 직접 가리킵니다. 기본 데이터를 이동, 재작성 또는 복제하지 않습니다.
-
AI 기반 거버넌스, 보안, 신뢰할 수 있는 컨텍스트: Lakehouse 런타임 카탈로그는 Knowledge Catalog 및 Cloud IAM과 직접 통합되므로 모든 컴퓨팅 엔진에 일관되게 적용되는 에이전트 및 테이블 수준 보안에 대한 신뢰할 수 있는 컨텍스트를 정의할 수 있습니다. 또한 사용자 인증 정보 제공과 같은 주요 승인 메커니즘을 지원합니다. 즉, 기본 Cloud Storage 버킷의 파일에 직접 액세스할 필요 없이 테이블에 액세스할 수 있습니다.
-
엔터프라이즈 지원, 확장성, TCO 절감: Google의 전 세계 규모 인프라와 Spanner를 기반으로 메타데이터를 데이터에 맞게 확장할 수 있습니다. Cloud Storage 이중 리전 및 멀티 리전 버킷을 지원하여 장애 조치 사용 사례를 지원합니다. 또한 서버리스 및 노옵스(no-ops) 환경으로 인해 TCO가 절감되고 모든 워크로드 규모에 맞게 확장할 수 있습니다.
기존 Hive Metastore에서 제로 카피 마이그레이션 실행
실제로 얼마나 원활하게 전환되는지 보여드리기 위해 기존의 자체 관리형 Hive Metastore를 Google Cloud Lakehouse로 현대화할 수 있는 기능을 제공합니다. 이 기능을 사용하면 기존 Hive Metastore에 직접 연결하여 외부 테이블 정의와 파티션 맵을 추출하고 서버리스 Lakehouse 카탈로그에 깔끔하게 등록한 다음 Google Managed Spark, BigQuery, Gemini 기반 대화형 분석 에이전트에서 데이터를 사용할 수 있습니다.
레이크하우스로 현대화하고 주요 에이전트 여정에서 즉시 데이터 활용
데이터 아키텍처를 현대화할 준비가 되셨나요?
기존 Hive 메타스토어에서 Google Cloud의 레이크하우스로 현대화하면 분석 엔진과 에이전트 전반에서 데이터 사일로를 최소화하고, 멀티 엔진 거버넌스를 통합하며, 에이전트에 신뢰할 수 있는 컨텍스트를 제공하고, 운영 TCO를 절감할 수 있습니다. 즉, 최신 클라우드 환경이 에이전트 규모로 운영될 수 있도록 준비하는 데 도움이 됩니다.
지금 바로 시작하여 Apache Hive Metastore 테이블을 Google Cloud로 마이그레이션하고 에이전트형 시대에 대비하세요. Google Cloud Lakehouse에 대해 여기에서 자세히 알아보세요.